

Qué hacemos · Storage y cómputo: Servidores GPU e infraestructura de IA privada
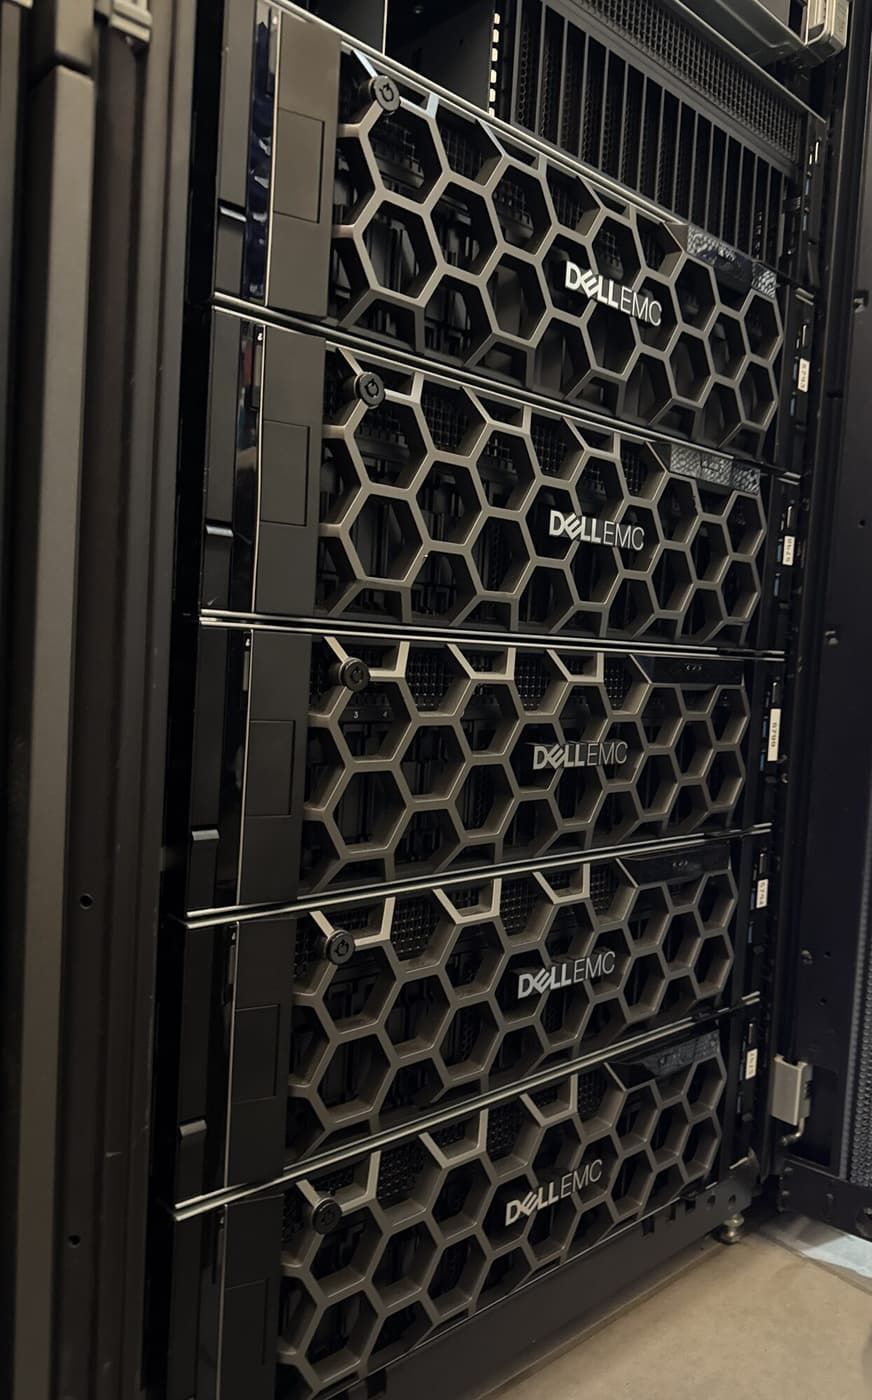
La GPU que necesita, en nuestro datacenter, en 48 horas: NVIDIA L4, L40, L40S, A100, H100 y más. Ejecute modelos open-weight para chat, búsqueda, extracción y análisis en hardware de uso exclusivo suyo, de modo que los datos confidenciales nunca se acerquen a un servicio de IA público.
Qué es
Dos cosas, vendidas por separado o juntas. Servidores GPU: máquinas dedicadas con los aceleradores NVIDIA que su carga de trabajo requiere, sobre plataformas enterprise HPE y Dell en nuestros datacenters, entregadas con un plazo de 48 horas. IA privada: la pila completa construida encima, desde el servicio de modelos y los embeddings hasta la búsqueda vectorial y la recuperación con citas, operada por nuestros ingenieros, accesible solo desde su red privada.
Cómo lo construimos
Cualquier GPU NVIDIA de data center actual. L4, L40, L40S, A100, H100 y el resto de la gama actual. Dimensionamos la tarjeta al modelo y a la carga de trabajo, no a un catálogo: un modelo grande cuantizado en una sola tarjeta para inferencia, varias tarjetas para entrenamiento o alto rendimiento, una tarjeta más pequeña para embeddings al lado.
Construido a la manera del Linux enterprise. Módulos de kernel firmados por el fabricante, Podman con el NVIDIA container toolkit, SELinux en modo enforcing.
APIs estándar, endpoints privados. Los modelos se sirven a través de endpoints compatibles con OpenAI en un segmento de red aislado, de modo que sus aplicaciones cambian una URL base para pasar de una API pública a sus propios modelos. Nada en la ruta del contenido llama a un servicio de IA externo.
Recuperación que cita sus fuentes. Para cargas de documentos y correo emparejamos un modelo de embeddings con una base de datos vectorial y un índice de texto completo, de modo que las respuestas se apoyan en sus propios documentos y enlazan a ellos. Los pipelines de documentos largos ejecutan la extracción página a página y después contrastan la salida con sus propias citas.
Storage que sigue el ritmo. Los pesos de los modelos, los conjuntos de datos y los archivos se sitúan en nuestra SAN all-flash o en NVMe local rápido, elegido por medición.
De qué le protege
- Que datos confidenciales (médicos, legales, financieros, de personal) salgan del edificio o de la jurisdicción.
- Una factura por token que crece con cada mes de éxito.
- Un proveedor de IA que cambia condiciones, límites de uso o precios en su mejor día.
- Esperar meses por capacidad GPU.
- Un endpoint de IA expuesto en la internet pública.
En la práctica
Historiales médicos analizados sin salir de Atenas. Construimos una plataforma de IA privada para un cliente que necesitaba analizar historiales médicos: entran carpetas de pacientes, sale un informe estructurado y con citas, y cada paso corre en modelos locales dentro de Digital Realty Athens. Los datos nunca tocan un cloud público.
Una carga de IA comercial, replicada en GPU privadas. Para una plataforma de coaching reprodujimos su pipeline de IA de extremo a extremo en nuestro propio hardware: siete pasadas analíticas sobre la transcripción real de una sesión, docenas de conclusiones estructuradas extraídas en menos de un minuto, con una salida muy próxima a la del servicio comercial con el que se comparó, y sin coste por llamada.
Por qué EuroVPS
- Cualquier GPU NVIDIA de data center actual, entregada en 48 horas.
- Servidores GPU e IA privada en nuestros datacenters de Atenas y Ámsterdam, dentro de la UE.
- Endpoints compatibles con OpenAI, de modo que dejar una API pública es una línea de código.
- Ingenieros que construyen la pila de modelos, el storage y la red, no que solo le alquilan una tarjeta.
- Costes fijos, sin contador por token.
Preguntas frecuentes
- ¿Qué GPU puedo conseguir? La que su carga de trabajo necesite: L4, L40, L40S, A100, H100 y otras. Díganos el modelo y el rendimiento que necesita y la dimensionaremos.
- ¿Cuánto tarda? 48 horas.
- ¿Dónde están los servidores GPU? En nuestros datacenters de Atenas y Ámsterdam.
- ¿Pueden ejecutar los modelos por nosotros, no solo proporcionar el hardware? Sí. Desplegamos, servimos y operamos modelos open-weight y la pila de recuperación a su alrededor.
- ¿Se usarán nuestros datos para entrenar algo? No. Sus datos se quedan en su hardware en nuestro datacenter. Nada se envía a un modelo externo.
- ¿Podemos seguir usando nuestro código actual? Normalmente sí. Nuestros endpoints hablan el mismo formato de API que la mayoría de las aplicaciones ya usan.
- closing line: Sus datos, sus modelos, nuestro datacenter. Hable con un ingeniero sobre la GPU y la pila de IA que necesita.
- CTA: Hable con un ingeniero
Su próximo socio de infraestructura
Veamos su infraestructura.
Cuéntenos qué ejecuta hoy y qué necesita mejorar. Un ingeniero revisará su solicitud y le ayudará a planificar el siguiente paso.
+357 222 32280
Empecemos por su infraestructura.
Un poco de contexto nos ayuda a empezar la conversación adecuada.