

Що ми робимо · Storage та обчислювальні ресурси: GPU servers та інфраструктура приватного AI
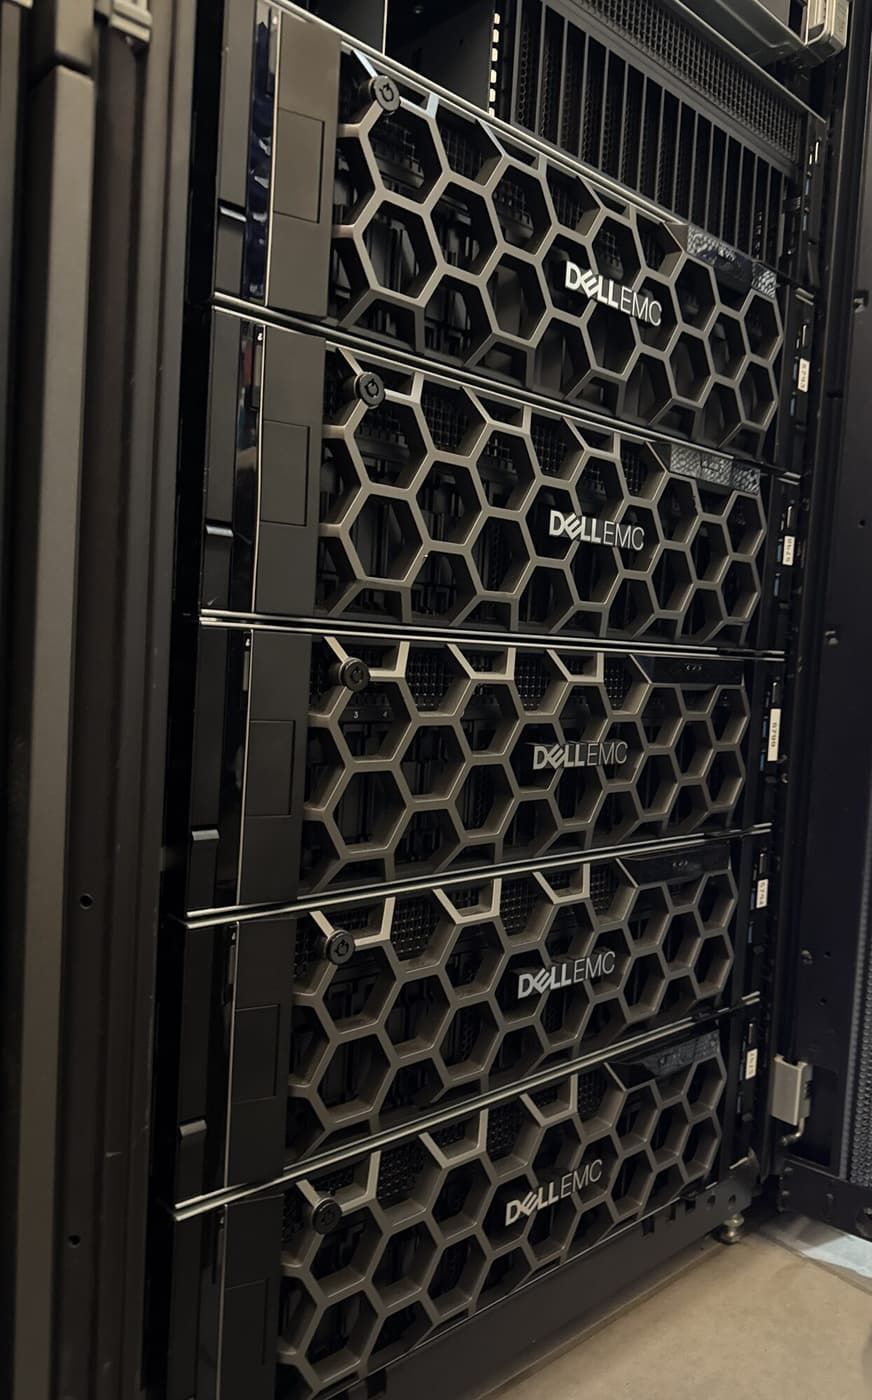
Потрібний вам GPU, у нашому дата-центрі, протягом 48 годин: NVIDIA L4, L40, L40S, A100, H100 та інші. Запускайте моделі з відкритими вагами для чату, пошуку, видобування та аналізу даних на обладнанні, яке у вашому розпорядженні, тож конфіденційні дані ніколи не наближаються до публічного AI-сервісу.
Що це
Дві речі, що продаються окремо або разом. GPU servers: виділені машини з прискорювачами NVIDIA, яких потребує ваше навантаження, на enterprise-платформах HPE і Dell у наших дата-центрах, із терміном постачання 48 годин. Приватний AI: повний стек, побудований поверх них, від обслуговування моделей та embeddings до векторного пошуку й retrieval із цитуванням, який експлуатують наші інженери і який доступний лише з вашої приватної мережі.
Як ми це будуємо
Будь-який сучасний data center GPU від NVIDIA. L4, L40, L40S, A100, H100 та решта поточного ряду. Ми підбираємо карту під модель і навантаження, а не під каталог: квантована велика модель на одній карті для inference, кілька карт для навчання або високої пропускної здатності, менша карта для embeddings поруч.
Побудовано за правилами enterprise Linux. Модулі ядра, підписані вендором, Podman із NVIDIA container toolkit, SELinux у режимі enforcing.
Стандартні API, приватні endpoint. Моделі обслуговуються через OpenAI-сумісні endpoint в ізольованому мережевому сегменті, тож ваші застосунки змінюють одну базову URL-адресу, щоб перейти з публічного API на ваші власні моделі. Ніщо на шляху вмісту не звертається до зовнішнього AI-сервісу.
Retrieval, що цитує джерела. Для документних і поштових навантажень ми поєднуємо модель embeddings із векторною базою даних та повнотекстовим індексом, тож відповіді спираються на ваші власні документи і посилаються на них. Конвеєри для довгих документів виконують видобування сторінка за сторінкою, а потім перевіряють результат за його ж цитатами.
Сховище, що встигає. Ваги моделей, набори даних та архіви розміщуються на нашому all-flash SAN або на швидкому локальному NVMe, вибір за вимірюванням.
Від чого це вас захищає
- Від виходу конфіденційних даних (медичних, юридичних, фінансових, кадрових) за межі будівлі чи юрисдикції.
- Від рахунку за токени, який зростає з кожним успішним місяцем.
- Від AI-вендора, що змінює умови, ліміти чи ціни у ваш найкращий день.
- Від місяців очікування на потужності GPU.
- Від AI endpoint, відкритого в публічний інтернет.
На практиці
Медичні записи, проаналізовані, не виходячи з Афін. Ми побудували платформу приватного AI для клієнта, якому потрібно було аналізувати медичні записи: на вхід подаються папки пацієнтів, на виході структурований звіт із цитуванням, і кожен крок виконується на локальних моделях усередині Digital Realty Athens. Дані ніколи не торкаються публічної хмари.
Комерційне AI-навантаження, відтворене на приватних GPU. Для коучингової платформи ми відтворили її AI-конвеєр від початку до кінця на нашому власному обладнанні: сім аналітичних проходів по реальній стенограмі сесії, десятки структурованих висновків, видобутих менш ніж за хвилину, із результатом, близьким до комерційного сервісу, з яким його порівнювали, і без плати за виклик.
Чому EuroVPS
- Будь-який сучасний data center GPU від NVIDIA, постачання за 48 годин.
- GPU servers і приватний AI у наших дата-центрах в Афінах і Амстердамі, в межах ЄС.
- OpenAI-сумісні endpoint, тож відхід від публічного API є одним рядком коду.
- Інженери, які будують стек моделей, сховище та мережу, а не просто здають вам карту в оренду.
- Фіксовані витрати, без лічильника токенів.
Часті запитання
- Які GPU я можу отримати? Будь-які, яких потребує ваше навантаження: L4, L40, L40S, A100, H100 та інші. Скажіть нам модель і потрібну пропускну здатність, і ми підберемо розмір.
- Скільки часу це займає? 48 годин.
- Де розташовані GPU servers? У наших дата-центрах в Афінах і Амстердамі.
- Чи можете ви запускати моделі для нас, а не лише надавати обладнання? Так. Ми розгортаємо, обслуговуємо та експлуатуємо моделі з відкритими вагами і стек retrieval навколо них.
- Чи будуть наші дані використані для навчання чогось? Ні. Ваші дані залишаються на вашому обладнанні в нашому дата-центрі. Ніщо не надсилається до зовнішньої моделі.
- Чи можемо ми й надалі використовувати наш наявний код? Зазвичай так. Наші endpoint використовують той самий формат API, який уже використовує більшість застосунків.
- closing line: Ваші дані, ваші моделі, наш дата-центр. Поговоріть з інженером про GPU та AI-стек, які вам потрібні.
- CTA: Поговоріть з інженером
Ваш наступний партнер з інфраструктури
Погляньмо на вашу інфраструктуру.
Розкажіть, що ви запускаєте сьогодні і що потребує покращення. Інженер розгляне ваш запит і допоможе спланувати наступний крок.
+357 222 32280
Почнімо з вашої інфраструктури.
Трохи контексту допомагає нам почати правильну розмову.