El blog de EuroVPS
Notas de campo.
Desde la sala de máquinas.
Decisiones, investigaciones y lecciones de operar infraestructura de producción. Escritas por las personas que la cuidan.
El archivo
Más del equipo.
Una migración es un proyecto, no un ticket.
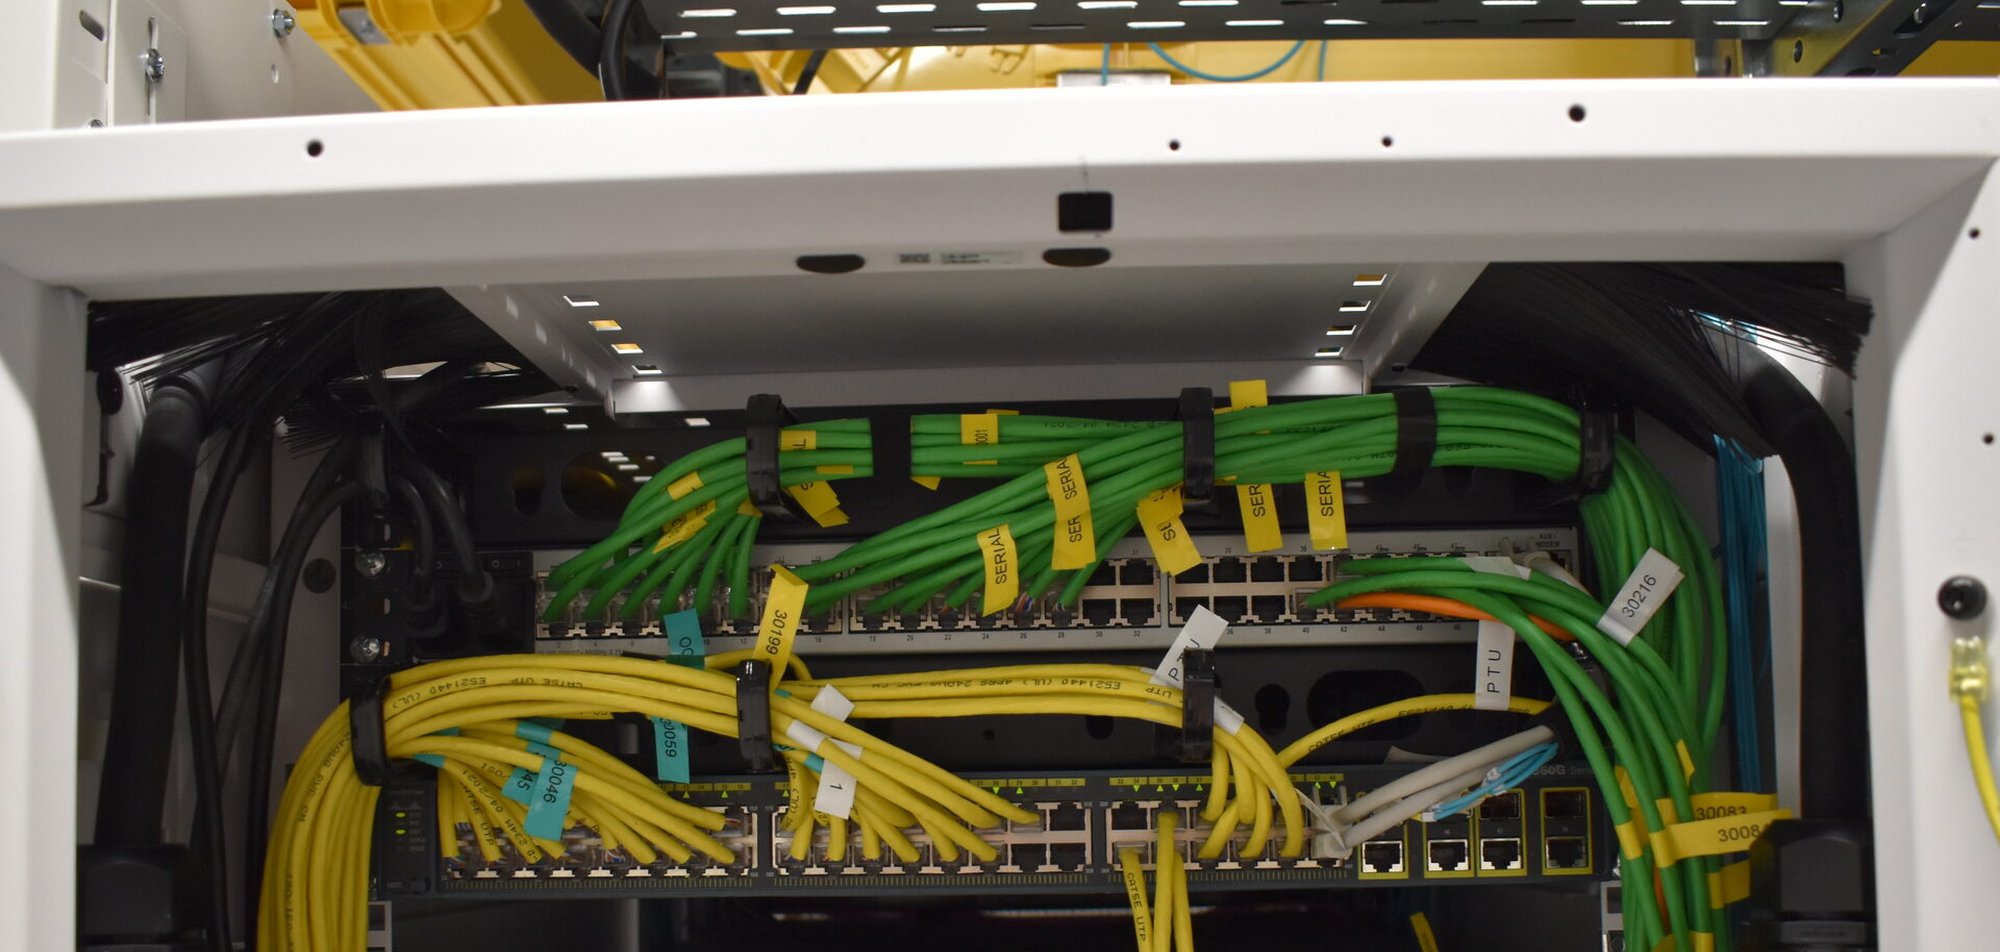
El grupo de sitios de noticias de alto tráfico de un gran editor tenía que cambiar de datacenter, rediseñado para escalar en el camino hacia nuestro bare metal. Diseñamos la plataforma, la probamos bajo carga y ejecutamos el cutover en una operación de dos horas con una ventana visible de unos cinco minutos y una ruta de rollback en cada fase.
Consistencia read-after-write en un clúster Galera
Un clúster Galera o Percona XtraDB certifica una escritura en el commit y la aplica en los demás nodos un instante después, y una lectura enrutada dentro de ese hueco ve el pasado.
Dejaron de llamarnos cuando algo se rompe.
Los clientes dejaron de llamarnos cuando algo se rompe y empezaron a llamarnos para construir lo siguiente: release engineering, entornos de staging, acceso seguro y migraciones como proyectos llenan ahora nuestra cola de ingeniería. La prueba no es un testimonio. Es el propio trabajo.
Exports y mounts NFS que fallan con seguridad
Los valores por defecto de NFS que dañan el contenido compartido: exports abiertos, acceso root, soft mounts y cuelgues al arrancar, más los ajustes y las comprobaciones que los corrigen.
Un backup de GitLab que no puede restaurar es solo un fichero grande
El archivo de backup de GitLab omite los ficheros que lo hacen restaurable. Qué copiar junto a él, cómo extraerlo con seguridad y cómo demostrar que una restauración funciona.
503 o 403 instantáneo: mire primero por encima de la aplicación
Una página de error que llega sin latencia alguna se sirvió antes de que su aplicación llegara a ejecutarse, así que la lista de comprobación empieza en el edge y baja al código al final.
Cómo se comprometen realmente los sitios, y cómo no ser la víctima fácil.
En seguridad, la causa supuesta del cliente suele ser «no pasa nada». Así es como se comprometen realmente los sitios, por qué lo alto de la lista es evitable, y cómo demostramos que una puerta está cerrada antes de declararla cerrada.
Un switch puede morir y su storage sigue sirviendo
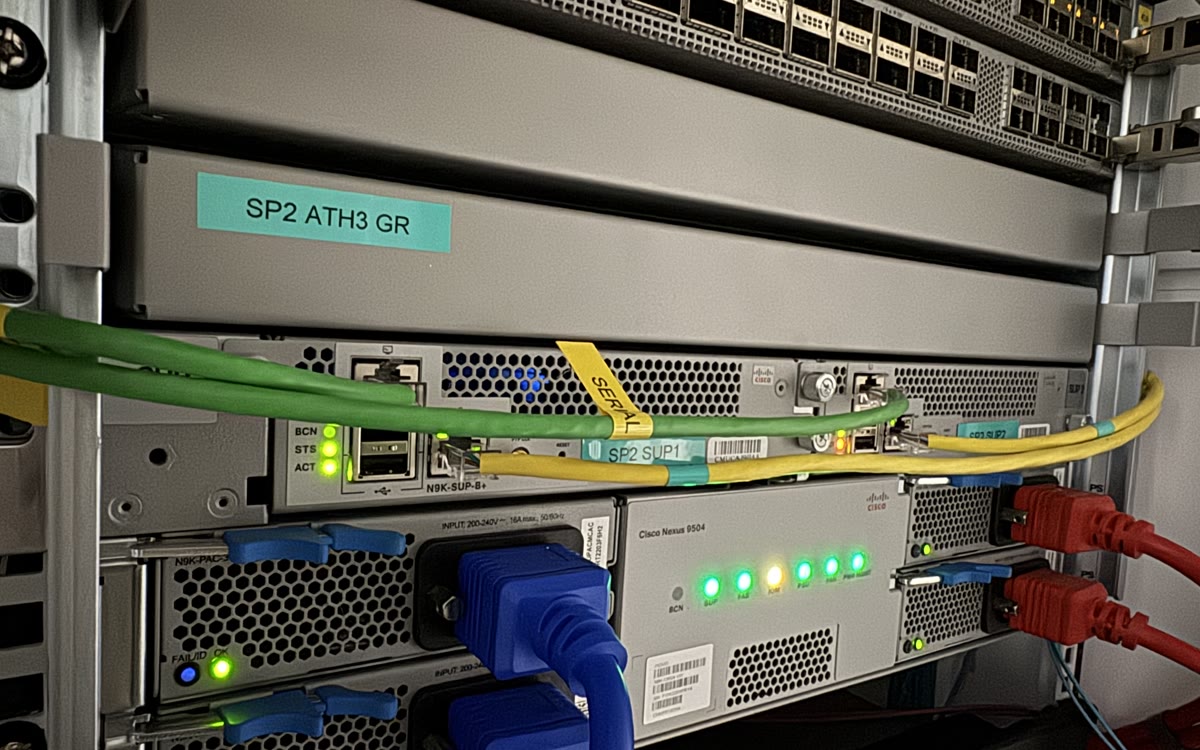
Qué le aporta el multipath sobre dos fabrics Fibre Channel independientes, por qué el RAID dentro de un servidor protege mucho menos de lo que suena, y por qué el mantenimiento de un fabric no es un acontecimiento para la carga de trabajo.
Su proveedor debería abrir el ticket primero.
En nuestro desk, muchos tickets los abrimos nosotros, desde la monitorización y la detección de seguridad, antes de que el cliente presente nada. Los cuatro movimientos de un equipo que actúa por delante, y el límite que convierte «fully managed» en un modelo descrito en lugar de un adjetivo.
Dos circuitos, un router: DMVPN de doble nube que usa ambos enlaces
Monte una segunda nube DMVPN con tunnel keys, ejecute BGP multipath sobre los dos circuitos WAN y dimensione la capacidad cifrada a partir del motor criptográfico, no de la licencia.
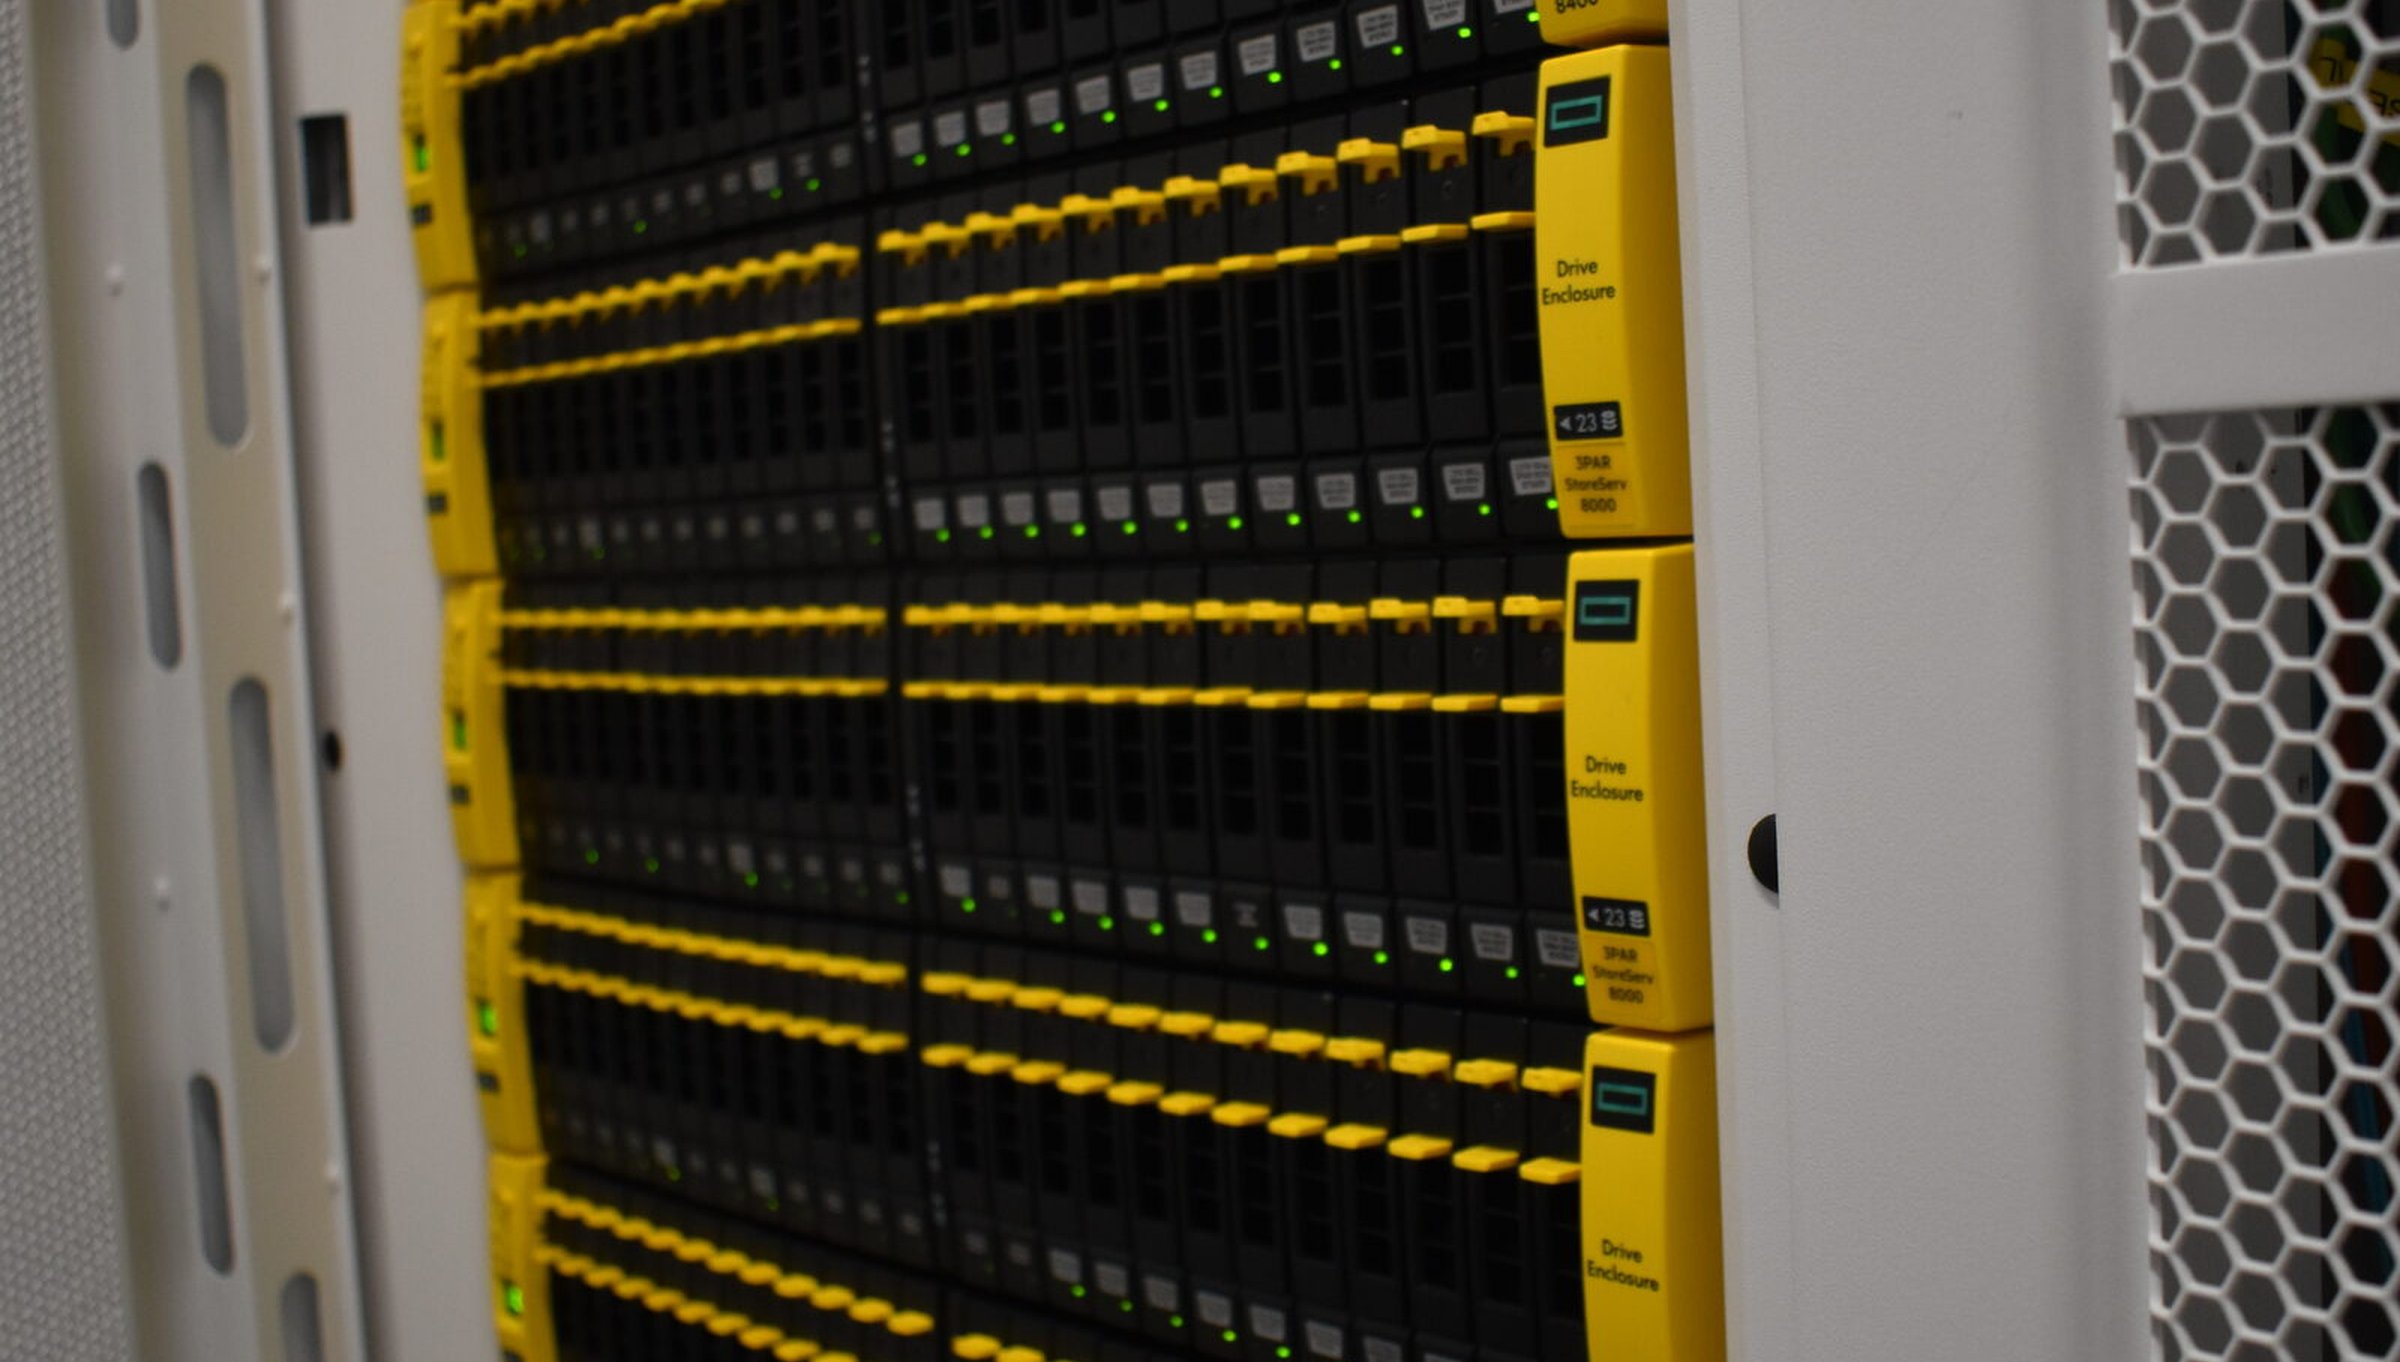
Por qué estandarizamos en HPE 3PAR all-flash
Una familia de cabinas, elegida y dominada, gana a un menú de fabricantes con niveles de storage. El argumento de la estandarización aplicado al storage, con la arquitectura, tomada del registro público, como prueba.
Buscar en décadas de correo: primero las palabras clave, después el significado
La búsqueda por IA sobre correo falla con datos sucios. Cómo limpiar, agrupar en hilos e indexar un archivo para que palabras clave y semántica trabajen juntas.
Ventanas de mantenimiento: lo que se hace bajo carga en su lugar
La mayoría del trabajo planificado en infraestructura redundante se hace mientras esta sigue sirviendo. Los cambios que necesitan una ventana se diseñan, se acotan y se acuerdan primero con usted.
La aritmética de la tabla de estados: dimensionar un firewall para floods, no para medias
Por qué un firewall stateful agota el estado antes que el ancho de banda, cómo dimensionar la tabla y los timeouts, y cuándo ir sin estado para UDP.
ERR_TOO_MANY_REDIRECTS tras una CDN: los dos ajustes que hacen bucle juntos.
El bucle de redirecciones que no deja nada en el access log: un modo SSL de la CDN que llega al origen por HTTP, y una redirección en el origen que no sabe que hay un proxy. Reprodúzcalo con una petición y corrija los dos extremos.
Cómo probar un restore, no solo un backup
Un backup en verde demuestra que la tarea se ejecutó. Una prueba de restore demuestra que puede recuperarse: comprobaciones de cobertura, tres niveles de restore, un laboratorio aislado, tiempos.
Limite la ruta cara, no al crawler
Encuentre las URL que cuestan trabajo real a su sitio y limite allí a los crawlers con stick tables de HAProxy y un 429, sin dañar el posicionamiento ni a los visitantes.
Por qué una cuenta root comprometida significa reconstruir el servidor, no limpiarlo.
En Unix, root es un número, no un nombre. Una cuenta UID 0 sin registro de creación no se hizo con ninguna herramienta, se escribió a mano en el fichero de usuarios. Cómo encontrarla, por qué una sola comprobación superada no es una prueba, y por qué root durante cualquier intervalo significa reconstruir, no limpiar.
Nuestro precio no cambia cuando cambia su tráfico.
Egress por gigabyte, soporte por tier, burst que se cobra solo después de ocurrir. Así se lee su factura cuando la máquina que hay debajo es suya.
No se detenga en el primer fallo.
El modo de fallo que este artículo elimina: su sitio se cae, alguien encuentra un fallo plausible, lo corrige, canta victoria, y el sitio sigue caído. En los peores días hay cuatro fallos más detrás del primero. Aquí está el método para desenredarlo, una regla cada vez, con la pista que delata cada tipo de fallo.
Toda integración de tickets entrega dos veces. Constrúyala para eso.
Los webhooks reintentan, los partners reenvían, las redes pierden respuestas. Cómo construir un puente de tickets firmado, idempotente, sin bucles y acotado, con código que puede reutilizar.
Lo más leído
Las guías a las que vuelven los lectores- 0110 motivos por los que su sitio web carga lento (y cómo arreglarlos)
- 02Los archivos de registro de Linux que debe vigilar en RHEL 9 y 10
- 03Configurar WordPress Multisite con nginx y PHP-FPM en RHEL 9 y 10
- 04Arquímedes y el polipasto: cómo un hombre movió un barco
- 05Guía completa de los códigos de estado HTTP: serie 300
- 06Guía completa de los códigos de estado HTTP: serie 400
- 07¿Cuánta RAM, CPU, disco e IOPS necesita realmente su VPS?
Ponga la lectura a trabajar
¿Tiene una carga de trabajo en mente?
Empiece por los números.
Las herramientas de dimensionamiento convierten sus requisitos en una configuración propuesta y un rango de precio indicativo. Un ingeniero puede ayudarle a revisar qué encaja.