

Ce que nous faisons · Stockage et compute: Serveurs GPU et infrastructure d'IA privée
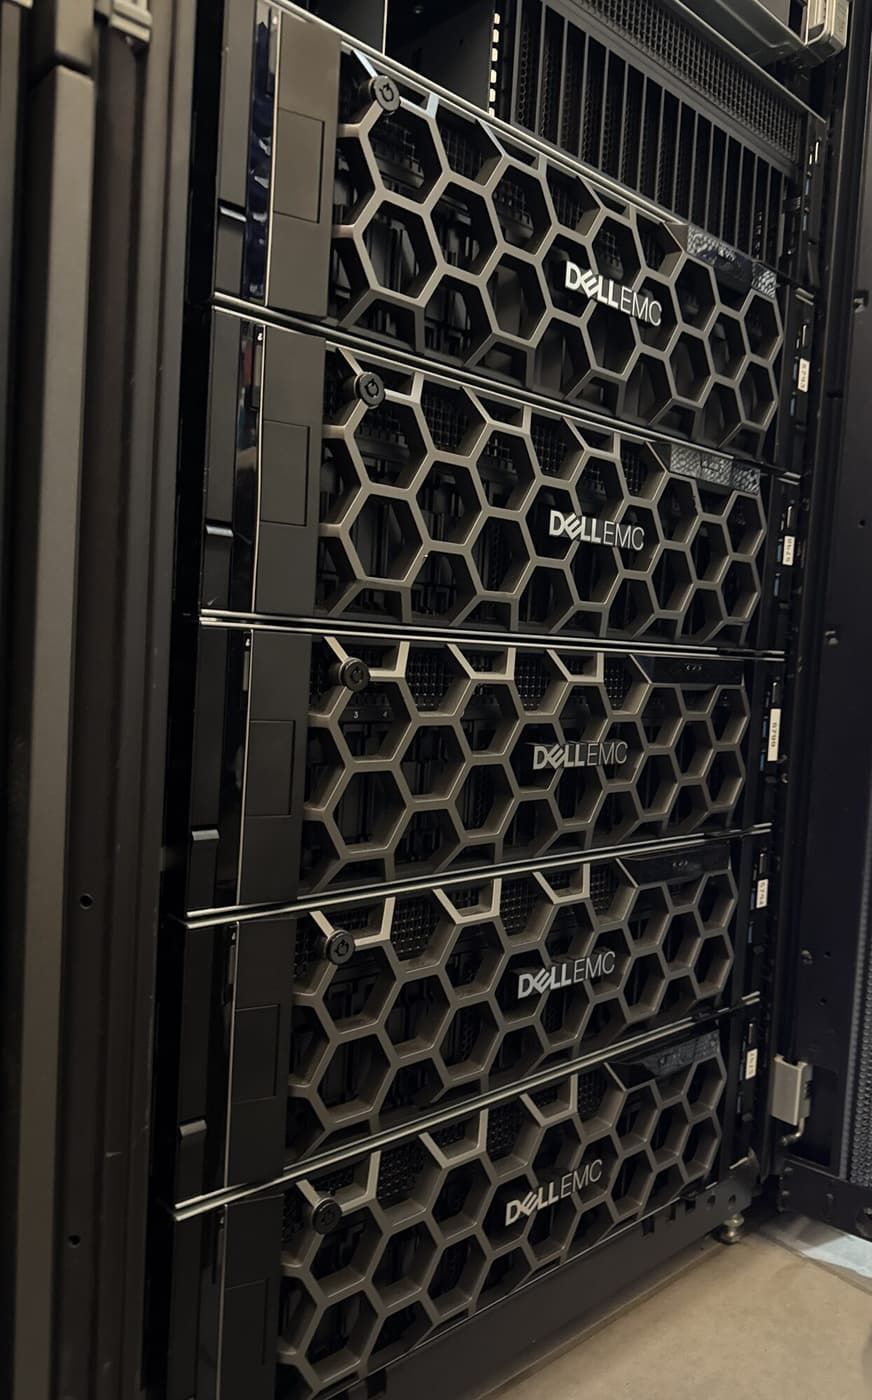
Le GPU dont vous avez besoin, dans notre datacenter, sous 48 heures : NVIDIA L4, L40, L40S, A100, H100 et plus. Faites tourner des modèles à poids ouverts pour la conversation, la recherche, l'extraction et l'analyse sur du matériel réservé à votre usage, pour que les données confidentielles n'approchent jamais un service d'IA public.
De quoi il s'agit
Deux choses, vendues séparément ou ensemble. Des serveurs GPU : des machines dédiées avec les accélérateurs NVIDIA que votre charge réclame, sur des plateformes entreprise HPE et Dell dans nos datacenters, livrées sous 48 heures. De l'IA privée : la pile complète construite par-dessus, du service des modèles et des embeddings à la recherche vectorielle et à la récupération avec citations, exploitée par nos ingénieurs, accessible uniquement depuis votre réseau privé.
Comment nous le construisons
N'importe quel GPU NVIDIA actuel pour datacenter. L4, L40, L40S, A100, H100 et le reste de la gamme actuelle. Nous dimensionnons la carte au modèle et à la charge, pas à un catalogue : un grand modèle quantifié sur une seule carte pour l'inférence, plusieurs cartes pour l'entraînement ou le haut débit, une carte plus petite pour les embeddings à côté.
Construit à la manière du Linux entreprise. Modules noyau signés par l'éditeur, Podman avec le NVIDIA container toolkit, SELinux en mode enforcing.
Des API standard, des endpoints privés. Les modèles sont servis par des endpoints compatibles OpenAI sur un segment réseau isolé, de sorte que vos applications ne changent qu'une URL de base pour passer d'une API publique à vos propres modèles. Rien dans le chemin du contenu n'appelle un service d'IA extérieur.
Une récupération qui cite ses sources. Pour les charges documentaires et de messagerie, nous associons un modèle d'embedding à une base vectorielle et à un index plein texte, pour que les réponses s'ancrent dans vos propres documents et renvoient vers eux. Les pipelines de documents longs font l'extraction page par page, puis recoupent le résultat avec ses propres citations.
Un stockage qui suit. Les poids des modèles, les jeux de données et les archives résident sur notre SAN all-flash ou sur du NVMe local rapide, choisi par la mesure.
Ce dont il vous protège
- Des données confidentielles (médicales, juridiques, financières, de personnel) qui quittent le bâtiment ou la juridiction.
- Une facture au token qui grossit à chaque mois réussi.
- Un fournisseur d'IA qui change ses conditions, ses limites de débit ou ses prix votre meilleur jour.
- Attendre des mois de la capacité GPU.
- Un endpoint d'IA exposé sur l'Internet public.
En pratique
Des dossiers médicaux analysés sans quitter Athènes. Nous avons construit une plateforme d'IA privée pour un client qui devait analyser des dossiers médicaux : les dossiers patients entrent, un rapport structuré et cité sort, et chaque étape tourne sur des modèles locaux à l'intérieur de Digital Realty Athens. Les données ne touchent jamais un cloud public.
Une charge d'IA commerciale, reproduite sur des GPU privés. Pour une plateforme de coaching, nous avons reproduit son pipeline d'IA de bout en bout sur notre propre matériel : sept passes analytiques sur la transcription réelle d'une séance, des dizaines d'observations structurées extraites en moins d'une minute, avec un résultat très proche du service commercial auquel il était comparé, et sans coût par appel.
Pourquoi EuroVPS
- N'importe quel GPU NVIDIA actuel pour datacenter, livré en 48 heures.
- Des serveurs GPU et de l'IA privée dans nos datacenters d'Athènes et d'Amsterdam, dans l'UE.
- Des endpoints compatibles OpenAI : quitter une API publique tient en une ligne de code.
- Des ingénieurs qui construisent la pile de modèles, le stockage et le réseau, et ne se contentent pas de vous louer une carte.
- Des coûts fixes, pas de compteur au token.
Questions fréquentes
- Quels GPU puis-je obtenir ? Ce dont votre charge a besoin : L4, L40, L40S, A100, H100 et d'autres. Dites-nous le modèle et le débit dont vous avez besoin, et nous le dimensionnerons.
- Combien de temps cela prend-il ? 48 heures.
- Où se trouvent les serveurs GPU ? Dans nos datacenters d'Athènes et d'Amsterdam.
- Pouvez-vous faire tourner les modèles pour nous, et pas seulement fournir le matériel ? Oui. Nous déployons, servons et exploitons des modèles à poids ouverts et la pile de récupération qui les entoure.
- Nos données serviront-elles à entraîner quoi que ce soit ? Non. Vos données restent sur votre matériel dans notre datacenter. Rien n'est envoyé à un modèle extérieur.
- Pouvons-nous garder notre code existant ? En général, oui. Nos endpoints parlent le même format d'API que la plupart des applications utilisent déjà.
- closing line: Vos données, vos modèles, notre datacenter. Parlez à un ingénieur du GPU et de la pile d'IA dont vous avez besoin.
- CTA: Parler à un ingénieur
Votre prochain partenaire d'infrastructure
Examinons votre environnement.
Dites-nous ce que vous faites tourner aujourd'hui et ce qui doit s'améliorer. Un ingénieur examinera votre demande et vous aidera à planifier la suite.
+357 222 32280
Commençons par votre environnement.
Un peu de contexte nous aide à démarrer la bonne conversation.