

Cosa facciamo · Storage e compute: GPU server e infrastruttura AI privata
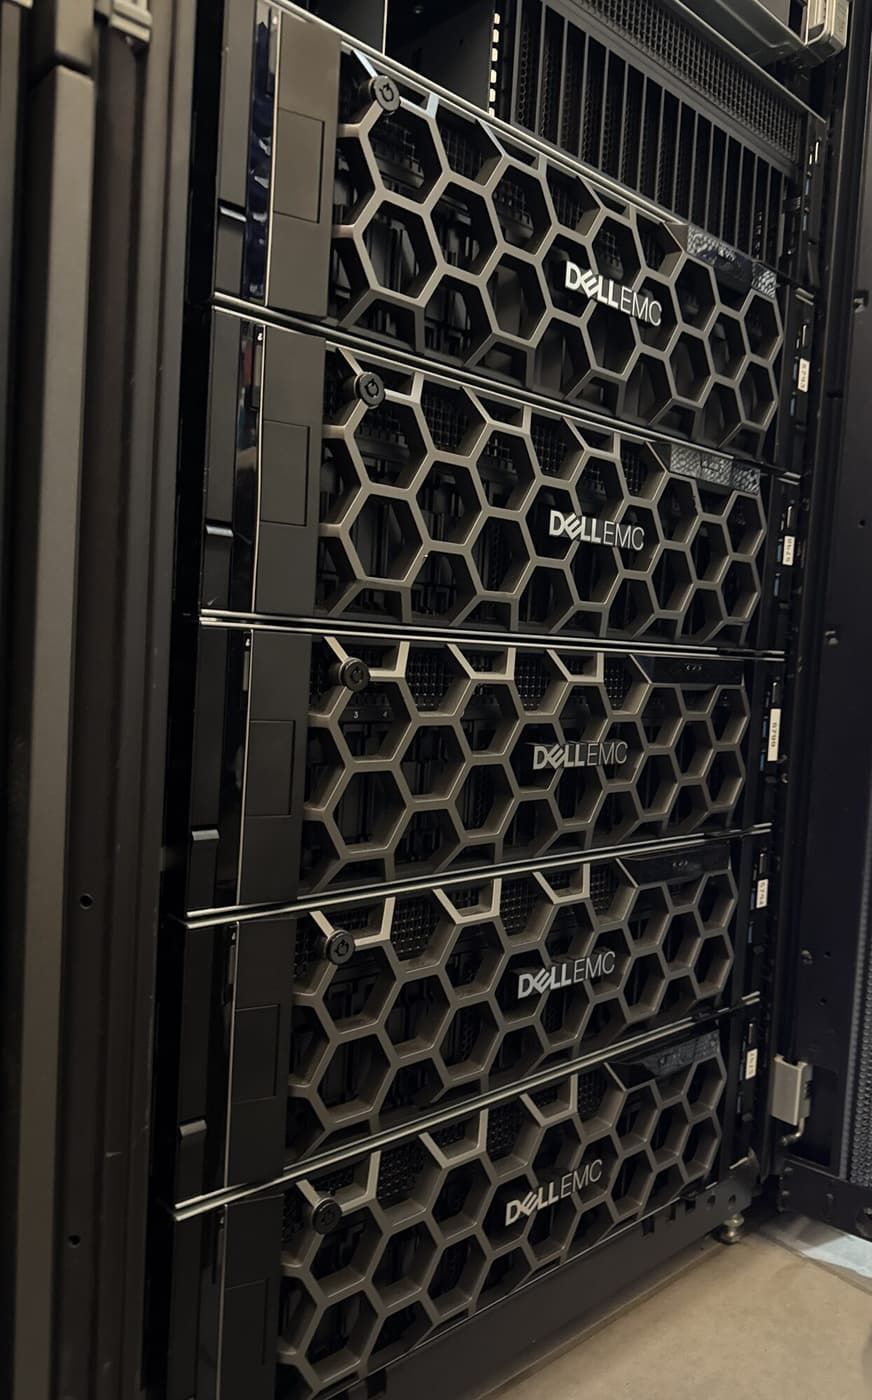
La GPU di cui avete bisogno, nel nostro datacenter, entro 48 ore: NVIDIA L4, L40, L40S, A100, H100 e altre. Fate girare modelli open-weight per chat, ricerca, estrazione e analisi su hardware che è vostro da usare, così i dati riservati non si avvicinano mai a un servizio AI pubblico.
Cos'è
Due cose, vendute separatamente o insieme. GPU server: macchine dedicate con gli acceleratori NVIDIA che il vostro carico di lavoro richiede, su piattaforme enterprise HPE e Dell nei nostri datacenter, consegnate con un tempo di approvvigionamento di 48 ore. AI privata: l'intero stack costruito sopra di esse, dal model serving e dagli embedding alla ricerca vettoriale e al retrieval con citazioni, gestito dai nostri ingegneri, raggiungibile solo dalla vostra rete privata.
Come lo costruiamo
Qualsiasi GPU NVIDIA data center di generazione corrente. L4, L40, L40S, A100, H100 e il resto della gamma attuale. Dimensioniamo la scheda sul modello e sul carico di lavoro, non su un catalogo: un modello grande quantizzato su una singola scheda per l'inferenza, più schede per il training o l'alta produttività, una scheda più piccola per gli embedding a fianco.
Costruito alla maniera del Linux enterprise. Moduli kernel firmati dal vendor, Podman con il toolkit container NVIDIA, SELinux in enforcing.
API standard, endpoint privati. I modelli sono serviti tramite endpoint compatibili OpenAI su un segmento di rete isolato, così le vostre applicazioni cambiano un solo base URL per passare da un'API pubblica ai vostri modelli. Nulla nel percorso dei contenuti chiama un servizio AI esterno.
Retrieval che cita le fonti. Per i carichi documentali e di posta abbiniamo un modello di embedding a un database vettoriale e a un indice full-text, così le risposte sono ancorate ai vostri documenti e rimandano a essi. Le pipeline per documenti lunghi eseguono l'estrazione pagina per pagina, poi verificano l'output rispetto alle proprie citazioni.
Storage che tiene il passo. Pesi dei modelli, dataset e archivi risiedono sulla nostra SAN all-flash o su NVMe locale veloce, scelti in base alle misurazioni.
Da cosa vi protegge
- Dati riservati (medici, legali, finanziari, del personale) che escono dall'edificio o dalla giurisdizione.
- Una fattura a token che cresce a ogni mese di successo.
- Un fornitore AI che cambia condizioni, limiti di frequenza o prezzi nel vostro giorno migliore.
- Mesi di attesa per la capacità GPU.
- Un endpoint AI esposto su internet pubblica.
In pratica
Cartelle cliniche analizzate senza lasciare Atene. Abbiamo costruito una piattaforma AI privata per un cliente che doveva analizzare cartelle cliniche: entrano i fascicoli dei pazienti, esce un referto strutturato e con citazioni, e ogni passaggio gira su modelli locali dentro Digital Realty Athens. I dati non toccano mai un cloud pubblico.
Un carico AI commerciale, replicato su GPU private. Per una piattaforma di coaching abbiamo riprodotto la sua pipeline AI da un capo all'altro sul nostro hardware: sette passaggi analitici su una trascrizione reale di sessione, decine di insight strutturati estratti in meno di un minuto, con un output molto vicino a quello del servizio commerciale con cui è stato confrontato, e nessun costo per chiamata.
Perché EuroVPS
- Qualsiasi GPU NVIDIA data center di generazione corrente, consegnata in 48 ore.
- GPU server e AI privata nei nostri datacenter di Atene e Amsterdam, dentro l'UE.
- Endpoint compatibili OpenAI, così lasciare un'API pubblica è una riga di codice.
- Ingegneri che costruiscono lo stack dei modelli, lo storage e la rete, non che vi affittano soltanto una scheda.
- Costi fissi, nessun contatore a token.
Domande frequenti
- Quali GPU posso avere? Quelle di cui il vostro carico di lavoro ha bisogno: L4, L40, L40S, A100, H100 e altre. Diteci il modello e la produttività che vi servono e le dimensioneremo.
- Quanto tempo ci vuole? 48 ore.
- Dove sono i GPU server? Nei nostri datacenter di Atene e Amsterdam.
- Potete far girare i modelli per noi, non solo fornire l'hardware? Sì. Distribuiamo, serviamo e gestiamo modelli open-weight e lo stack di retrieval intorno a essi.
- I nostri dati saranno usati per addestrare qualcosa? No. I vostri dati restano sul vostro hardware nel nostro datacenter. Nulla viene inviato a un modello esterno.
- Possiamo continuare a usare il nostro codice attuale? Di solito sì. I nostri endpoint parlano lo stesso formato API che la maggior parte delle applicazioni già usa.
- closing line: I vostri dati, i vostri modelli, il nostro datacenter. Parlate con un ingegnere della GPU e dello stack AI di cui avete bisogno.
- CTA: Parla con un ingegnere
Il vostro prossimo partner per l'infrastruttura
Guardiamo la vostra infrastruttura.
Raccontateci cosa fate girare oggi e cosa deve migliorare. Un ingegnere esaminerà la vostra richiesta e vi aiuterà a pianificare il passo successivo.
+357 222 32280
Partiamo dalla vostra infrastruttura.
Un po' di contesto ci aiuta a iniziare la conversazione giusta.