

O que fazemos · Storage e computação: GPU servers e infraestrutura de IA privada
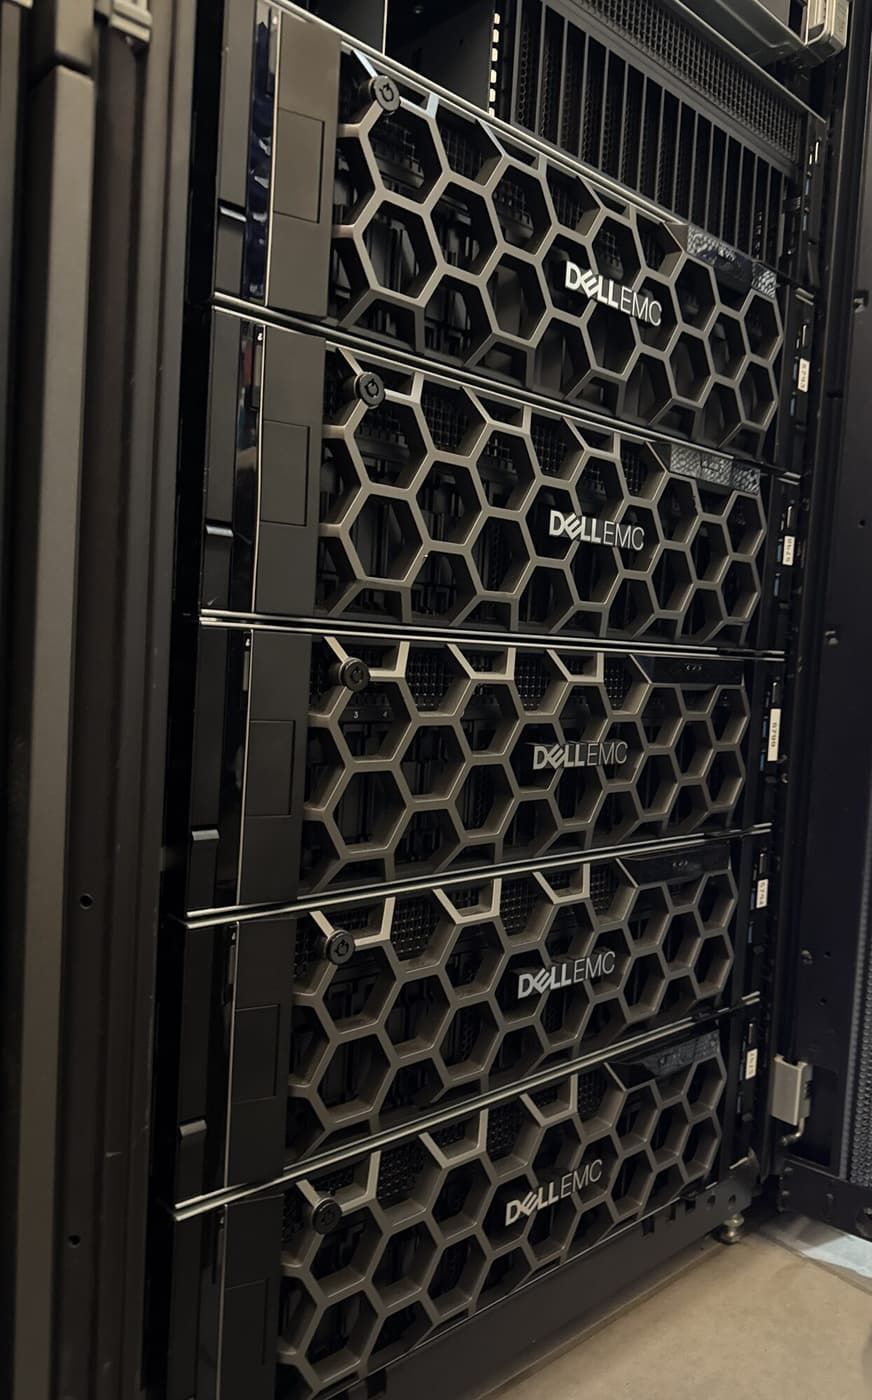
A GPU de que precisa, no nosso datacenter, em 48 horas: NVIDIA L4, L40, L40S, A100, H100 e mais. Execute modelos open-weight para chat, pesquisa, extração e análise em hardware que é seu para usar, para que os dados confidenciais nunca se aproximem de um serviço de IA público.
O que é
Duas coisas, vendidas em separado ou em conjunto. GPU servers: máquinas dedicadas com os aceleradores NVIDIA que a sua carga de trabalho pede, em plataformas enterprise HPE e Dell nos nossos datacenters, entregues com um prazo de 48 horas. IA privada: a stack completa construída em cima deles, do model serving e dos embeddings à pesquisa vetorial e ao retrieval com citações, operada pelos nossos engenheiros, acessível apenas a partir da sua rede privada.
Como o construímos
Qualquer GPU NVIDIA de data center atual. L4, L40, L40S, A100, H100 e o resto da gama atual. Dimensionamos a placa ao modelo e à carga de trabalho, não a um catálogo: um modelo grande quantizado numa única placa para inferência, várias placas para treino ou alto throughput, uma placa mais pequena para embeddings ao lado.
Construído à maneira do Linux enterprise. Módulos de kernel assinados pelo fabricante, Podman com o NVIDIA container toolkit, SELinux em enforcing.
APIs padrão, endpoints privados. Os modelos são servidos através de endpoints OpenAI-compatible num segmento de rede isolado, para que as suas aplicações mudem um base URL para passar de uma API pública para os seus próprios modelos. Nada no caminho do conteúdo chama um serviço de IA externo.
Retrieval que cita as suas fontes. Para cargas de documentos e de e-mail, juntamos um modelo de embeddings a uma base de dados vetorial e a um índice full-text, para que as respostas assentem nos seus próprios documentos e apontem de volta para eles. Os pipelines de documentos longos fazem a extração página a página, e depois cruzam o resultado com as suas próprias citações.
Storage que acompanha. Os pesos dos modelos, os datasets e os arquivos ficam no nosso SAN all-flash ou em NVMe local rápido, escolhido por medição.
Do que o protege
- Dados confidenciais (médicos, jurídicos, financeiros, de pessoal) saírem do edifício ou da jurisdição.
- Uma fatura por token que cresce com cada mês de sucesso.
- Um fornecedor de IA a mudar termos, rate limits ou preços no seu melhor dia.
- Esperar meses por capacidade GPU.
- Um endpoint de IA exposto na internet pública.
Na prática
Registos médicos analisados sem sair de Atenas. Construímos uma plataforma de IA privada para um cliente que precisava de analisar registos médicos: as pastas dos doentes entram, sai um relatório estruturado e com citações, e cada passo corre em modelos locais dentro do Digital Realty Athens. Os dados nunca tocam numa public cloud.
Uma carga de trabalho de IA comercial, replicada em GPU privadas. Para uma plataforma de coaching, reproduzimos o seu pipeline de IA de ponta a ponta no nosso próprio hardware: sete passagens analíticas sobre a transcrição real de uma sessão, dezenas de insights estruturados extraídos em menos de um minuto, com um resultado muito próximo do serviço comercial com que foi comparado, e sem custo por chamada.
Porquê a EuroVPS
- Qualquer GPU NVIDIA de data center atual, entregue em 48 horas.
- GPU servers e IA privada nos nossos datacenters de Atenas e Amesterdão, dentro da UE.
- Endpoints OpenAI-compatible, para que sair de uma API pública seja uma linha de código.
- Engenheiros que constroem a stack de modelos, o storage e a rede, e não apenas lhe alugam uma placa.
- Custos fixos, sem contador por token.
Perguntas frequentes
- Que GPU posso obter? O que a sua carga de trabalho precisar: L4, L40, L40S, A100, H100 e outras. Diga-nos o modelo e o throughput de que precisa e nós dimensionamos.
- Quanto tempo demora? 48 horas.
- Onde estão os GPU servers? Nos nossos datacenters de Atenas e Amesterdão.
- Podem executar os modelos por nós, e não apenas fornecer o hardware? Sim. Implementamos, servimos e operamos modelos open-weight e a stack de retrieval à sua volta.
- Os nossos dados vão ser usados para treinar alguma coisa? Não. Os seus dados ficam no seu hardware no nosso datacenter. Nada é enviado para um modelo externo.
- Podemos continuar a usar o nosso código existente? Normalmente sim. Os nossos endpoints falam o mesmo formato de API que a maioria das aplicações já usa.
- closing line: Os seus dados, os seus modelos, o nosso datacenter. Fale com um engenheiro sobre a GPU e a stack de IA de que precisa.
- CTA: Fale com um engenheiro
O seu próximo parceiro de infraestrutura
Vamos analisar a sua infraestrutura.
Diga-nos o que executa hoje e o que precisa de melhorar. Um engenheiro vai analisar o seu pedido e ajudar a planear o passo seguinte.
+357 222 32280
Comecemos pela sua infraestrutura.
Um pouco de contexto ajuda-nos a começar a conversa certa.