

Was wir tun · Storage und Compute: GPU-Server und private KI-Infrastruktur
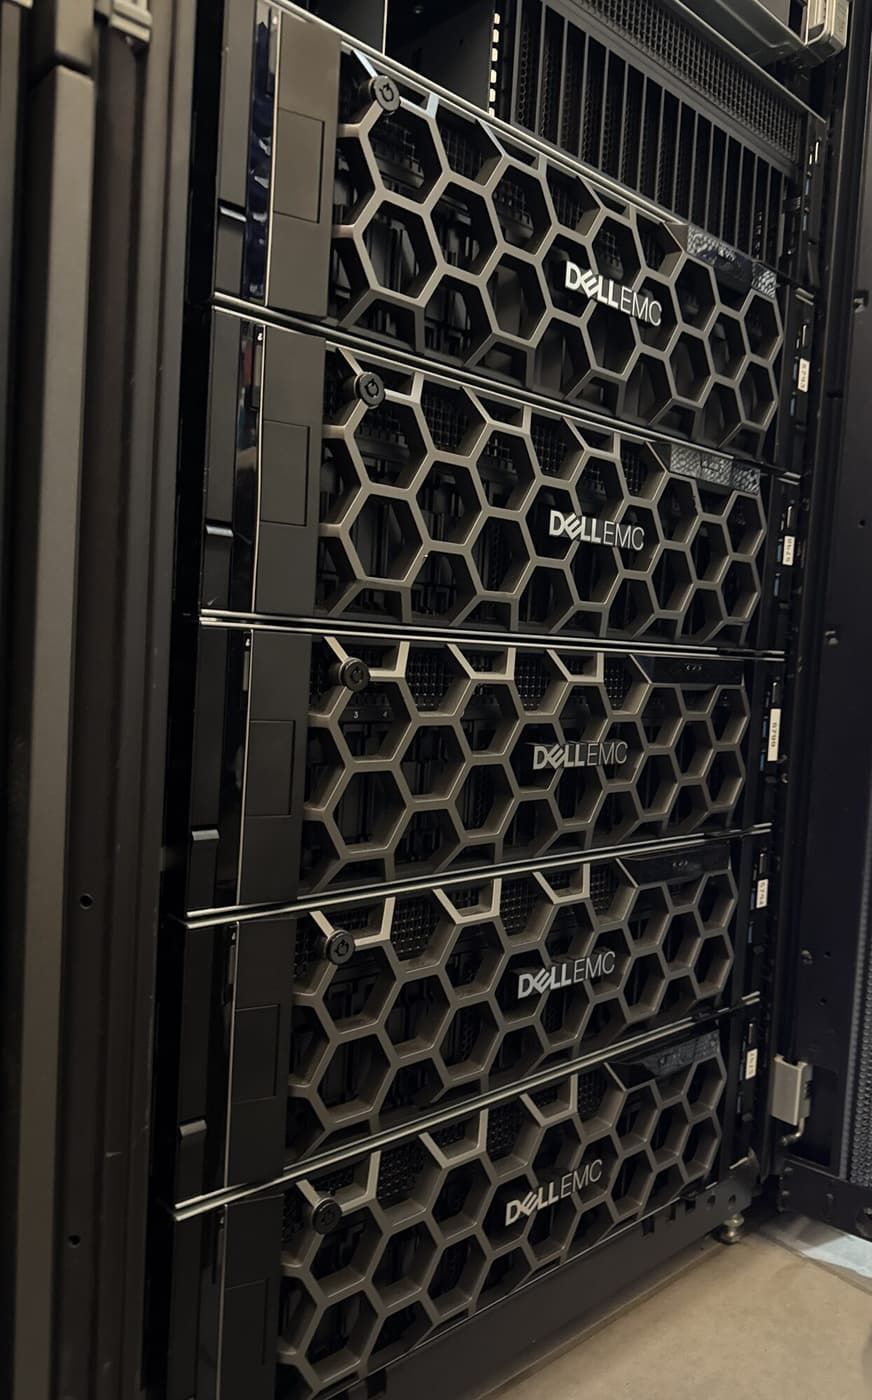
Die GPU, die Sie brauchen, in unserem Rechenzentrum, innerhalb von 48 Stunden: NVIDIA L4, L40, L40S, A100, H100 und mehr. Betreiben Sie Open-Weight-Modelle für Chat, Suche, Extraktion und Analyse auf Hardware, die Ihnen zur Verfügung steht, damit vertrauliche Daten nie in die Nähe eines öffentlichen KI-Dienstes kommen.
Was es ist
Zwei Dinge, einzeln oder zusammen erhältlich. GPU-Server: dedizierte Maschinen mit den NVIDIA-Beschleunigern, die Ihre Workload verlangt, auf Enterprise-Plattformen von HPE und Dell in unseren Rechenzentren, geliefert mit 48 Stunden Vorlaufzeit. Private KI: der vollständige Stack darauf, von Model Serving und Embeddings bis zu Vektorsuche und Retrieval mit Quellenangaben, betrieben von unseren Ingenieuren, erreichbar nur aus Ihrem privaten Netz.
Wie wir es bauen
Jede aktuelle NVIDIA Data-Center-GPU. L4, L40, L40S, A100, H100 und der Rest der aktuellen Palette. Wir dimensionieren die Karte nach Modell und Workload, nicht nach Katalog: ein quantisiertes großes Modell auf einer einzelnen Karte für Inferenz, mehrere Karten für Training oder hohen Durchsatz, eine kleinere Karte für Embeddings daneben.
Gebaut nach Art von Enterprise-Linux. Vom Hersteller signierte Kernel-Module, Podman mit dem NVIDIA Container Toolkit, SELinux im Enforcing-Modus.
Standard-APIs, private Endpunkte. Modelle werden über OpenAI-kompatible Endpunkte in einem isolierten Netzsegment bereitgestellt, sodass Ihre Anwendungen eine Basis-URL ändern, um von einer öffentlichen API auf Ihre eigenen Modelle zu wechseln. Nichts im Inhaltspfad ruft einen externen KI-Dienst auf.
Retrieval, das seine Quellen nennt. Für Dokument- und Mail-Workloads kombinieren wir ein Embedding-Modell mit einer Vektordatenbank und einem Volltextindex, sodass Antworten in Ihren eigenen Dokumenten verankert sind und auf sie zurückverweisen. Pipelines für lange Dokumente extrahieren Seite für Seite und gleichen die Ausgabe dann gegen ihre eigenen Quellenangaben ab.
Storage, der mithält. Modellgewichte, Datensätze und Archive liegen auf unserem All-Flash-SAN oder auf schnellem lokalem NVMe, nach Messung gewählt.
Wovor es Sie schützt
- Davor, dass vertrauliche Daten (medizinisch, juristisch, finanziell, personalbezogen) das Gebäude oder die Jurisdiktion verlassen.
- Vor einer Rechnung pro Token, die mit jedem erfolgreichen Monat wächst.
- Vor einem KI-Anbieter, der an Ihrem besten Tag Bedingungen, Limits oder Preise ändert.
- Vor monatelangem Warten auf GPU-Kapazität.
- Vor einem KI-Endpunkt, der im öffentlichen Internet exponiert ist.
In der Praxis
Patientenakten analysiert, ohne Athen zu verlassen. Wir haben eine private KI-Plattform für einen Kunden gebaut, der Patientenakten analysieren musste: Patientenordner gehen hinein, ein strukturierter Bericht mit Quellenangaben kommt heraus, und jeder Schritt läuft auf lokalen Modellen innerhalb von Digital Realty Athens. Die Daten berühren nie eine Public Cloud.
Eine kommerzielle KI-Workload, auf privaten GPUs nachgebaut. Für eine Coaching-Plattform haben wir deren KI-Pipeline Ende zu Ende auf unserer eigenen Hardware nachgebildet: sieben analytische Durchgänge über ein echtes Sitzungstranskript, Dutzende strukturierter Erkenntnisse in unter einer Minute extrahiert, mit einer Ausgabe, die dem verglichenen kommerziellen Dienst sehr nahe kam, und ohne Kosten pro Aufruf.
Warum EuroVPS
- Jede aktuelle NVIDIA Data-Center-GPU, geliefert in 48 Stunden.
- GPU-Server und private KI in unseren Rechenzentren in Athen und Amsterdam, innerhalb der EU.
- OpenAI-kompatible Endpunkte, sodass der Wechsel weg von einer öffentlichen API eine Zeile Code ist.
- Ingenieure, die den Modell-Stack, den Storage und das Netz bauen und Ihnen nicht nur eine Karte vermieten.
- Feste Kosten, kein Zähler pro Token.
Häufige Fragen
- Welche GPUs kann ich bekommen? Was Ihre Workload braucht: L4, L40, L40S, A100, H100 und andere. Nennen Sie uns das Modell und den Durchsatz, den Sie brauchen, und wir dimensionieren es.
- Wie lange dauert es? 48 Stunden.
- Wo stehen die GPU-Server? In unseren Rechenzentren in Athen und Amsterdam.
- Können Sie die Modelle für uns betreiben, nicht nur die Hardware stellen? Ja. Wir stellen Open-Weight-Modelle und den Retrieval-Stack darum herum bereit, servieren sie und betreiben sie.
- Werden unsere Daten zum Trainieren von irgendetwas verwendet? Nein. Ihre Daten bleiben auf Ihrer Hardware in unserem Rechenzentrum. Nichts wird an ein externes Modell gesendet.
- Können wir unseren bestehenden Code weiter nutzen? In der Regel ja. Unsere Endpunkte sprechen dasselbe API-Format, das die meisten Anwendungen bereits verwenden.
- closing line: Ihre Daten, Ihre Modelle, unser Rechenzentrum. Sprechen Sie mit einem Ingenieur über die GPU und den KI-Stack, den Sie brauchen.
- CTA: Mit einem Ingenieur sprechen
Ihr nächster Infrastrukturpartner
Sehen wir uns Ihre Umgebung an.
Erzählen Sie uns, was Sie heute betreiben und was besser werden muss. Ein Ingenieur sieht Ihre Anfrage durch und hilft Ihnen, den nächsten Schritt zu planen.
+357 222 32280
Beginnen wir mit Ihrer Umgebung.
Ein wenig Kontext hilft uns, das richtige Gespräch zu beginnen.