

Infraestructura GPU gestionada: Su modelo.
Su máquina.
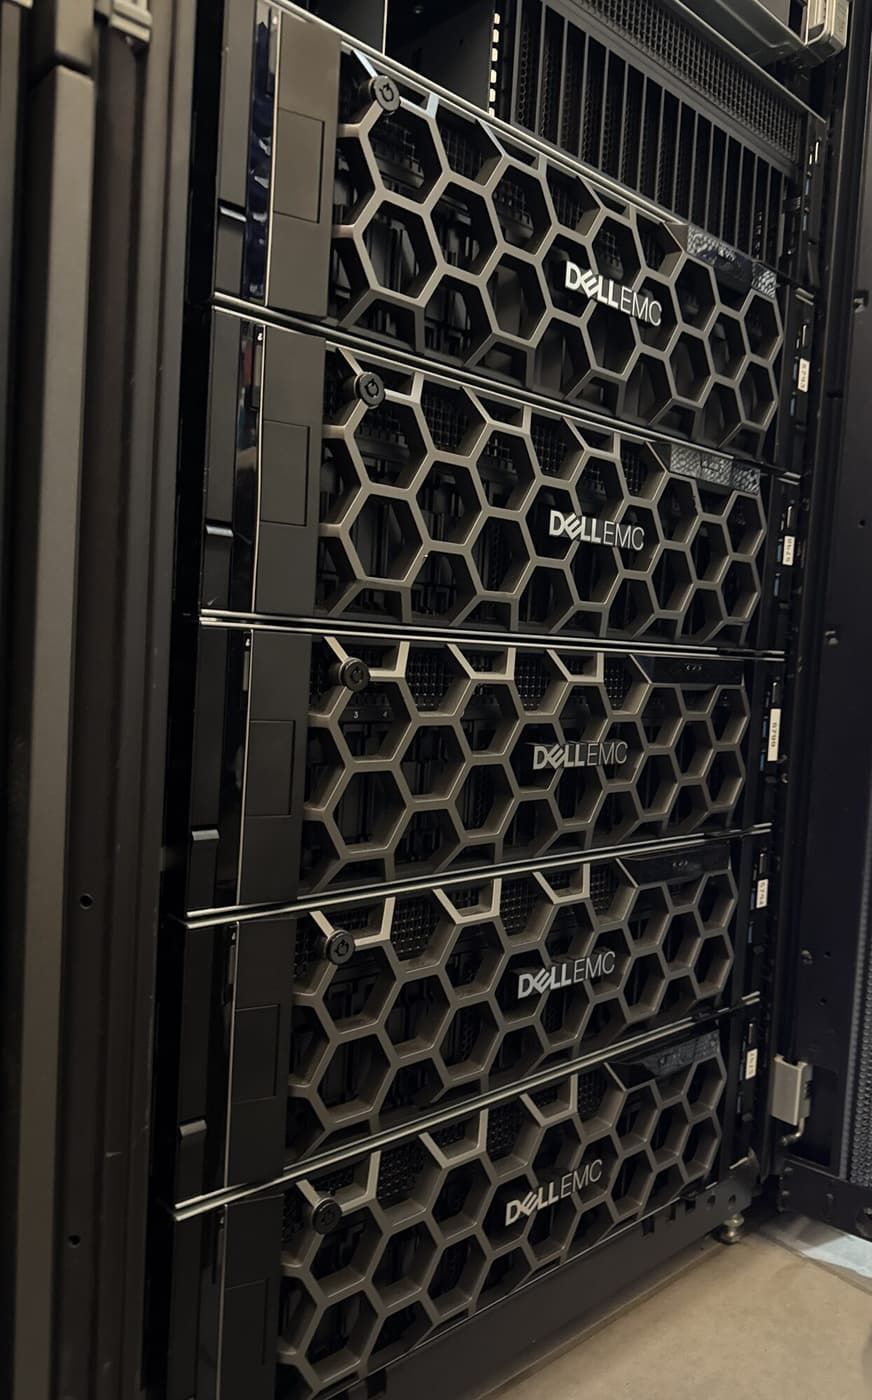
GPU dedicadasCapacidad reservada para usted
Un endpoint privadoAcceso diseñado en torno a su aplicación
Atenas y ÁmsterdamDigital Realty, dentro de la UE
Gestionado por ingenierosDel despliegue a la operación
El hardware
Cualquier GPU que podamos comprar.
En nuestro datacenter en 48 horas.
NVIDIA L4, L40, L40S, A100, H100 y el resto de la gama actual, dimensionadas para el modelo y la carga de trabajo. Sus propias GPU privadas, en nuestros datacenters de Digital Realty en Atenas y Ámsterdam, dentro de la UE.
Modelo y máquina, considerados juntos
Un modelo. Una máquina.
Un plan.
Explore algunos puntos de partida para un endpoint privado. Acordamos el modelo exacto, los requisitos de serving y el hardware en torno a lo que necesita ejecutar.
Una conexión privada al modelo sobre infraestructura dedicada.
Arquitectura ilustrativaUn punto de partida para la conversación
Llama
- El modelo
- Un modelo de texto de clase 70B, con la versión actual acordada con usted. Lo evaluamos frente a las necesidades de idioma, calidad y tiempo de respuesta de su aplicación.
- El dimensionamiento
- Probamos juntos la precisión, la longitud de contexto y las peticiones concurrentes antes de elegir la capacidad GPU y la configuración de serving.
- Versión y condiciones
- Llama se distribuye bajo la community license de Meta, que tiene sus propias condiciones de uso y escala; confirmamos que la versión exacta encaja con su uso antes del despliegue.
Un punto de partida para la conversación
Mistral
- El modelo
- Un modelo de tamaño medio, con la versión actual acordada con usted, es una opción a evaluar para un asistente privado o un endpoint de aplicación.
- El dimensionamiento
- Acordamos la precisión y el contexto que necesita, y después probamos la carga de serving. El tamaño del modelo por sí solo no garantiza que quepa en la GPU.
- Versión y condiciones
- Mistral publica algunos pesos bajo Apache 2.0 y otros bajo sus propias condiciones de investigación o comerciales; confirmamos cuáles aplican a la versión que elija.
Un punto de partida para la conversación
Qwen
- El modelo
- Una familia de modelos de distintos tamaños. Elegimos una versión concreta para probarla con su aplicación en lugar de dimensionar hardware para el nombre de la familia.
- El dimensionamiento
- Empezamos con el modelo seleccionado y sus propios prompts. El contexto, la precisión y los objetivos de tráfico guían la configuración final.
- Versión y condiciones
- Revise las condiciones del modelo y tamaño exactos. La model card del 72B enlazada es un ejemplo, no una licencia para toda la familia.
Diseñado con usted
DeepSeek
- El modelo
- Un modelo grande de tipo mixture-of-experts, con la versión actual acordada con usted. Exige una arquitectura de serving meditada y una evaluación de la carga de trabajo.
- El dimensionamiento
- Diseñado con usted. Evaluamos la memoria GPU, las interconexiones y las opciones de despliegue antes de acordar una configuración o un precio.
- Versión y condiciones
- Las condiciones del modelo son independientes de la licencia del código del repositorio. Revise la versión elegida antes del despliegue.
Un punto de partida para la conversación
Aún no lo sabemos
- El modelo
- Empiece por lo que la aplicación tiene que hacer. Le ayudamos a preseleccionar modelos para probarlos con sus propios prompts y documentos.
- El dimensionamiento
- Repasamos con usted la calidad de las respuestas, el tiempo de respuesta y el tráfico previsto, y después acordamos juntos el modelo y el hardware.
- Versión y condiciones
- La preselección incluye las versiones exactas de los modelos y sus condiciones, para que la decisión de despliegue se tome con todos los detalles a la vista.
La configuración final y el precio se acuerdan tras el dimensionamiento.
La ingeniería forma parte del servicio
Nosotros hacemos la ingeniería.
Usted llama a un endpoint.
Un solo equipo para el hardware, el stack de serving y la operación diaria. Usted trae la carga de trabajo; nosotros repasamos los detalles con usted.
Conozca a su equipo de soporteUn modelo y una máquina que encajan
Repasamos el modelo, la memoria y la concurrencia prevista, y después probamos la configuración propuesta con sus prompts.
El stack de serving, montado
Drivers de GPU, el runtime de inferencia y la configuración del endpoint. Nuestros ingenieros se encargan de la infraestructura alrededor de su modelo.
Acceso en sus términos
Un endpoint privado con acceso de red y logging configurados en torno a sus aplicaciones y sus requisitos de datos.
Gestionado más allá del despliegue
El equipo que monta la máquina sigue siendo responsable de la operación e investiga las incidencias en todo el host y el stack de serving.
Actualizaciones, con un plan
Mantenga una versión elegida del modelo; después validamos los cambios y acordamos la ventana de actualización antes de pasar a la siguiente.
Capacidad que sigue a la demanda
Revisamos con usted la memoria, la longitud de contexto y la concurrencia a medida que crece el uso, y añadimos GPU o un segundo host cuando los números lo indican.
¿Qué va a ejecutar?
Cuatro cargas de trabajo ilustrativas. Damos forma al modelo, al acceso privado y a la capacidad en torno a su aplicación.
RAG sobre documentos privados
Traiga la recuperación y la inferencia a una infraestructura gestionada. Construya respuestas a partir de documentos aprobados, con citas que remiten a la fuente.
- Modelo, embeddings y base de datos vectorial juntos
- Acceso a los documentos por VPN o red privada
Un asistente interno
Dé a su equipo un asistente sobre conocimiento interno aprobado, con el acceso y el registro de prompts configurados en torno a su organización.
- Inferencia dedicada para su equipo
- Registro y retención acordados con usted
Funciones de IA en su producto
Sirva respuestas del modelo a través de un endpoint al que llama su aplicación. Acordamos la versión del modelo y dimensionamos la capacidad con prompts reales y la demanda prevista.
- Inferencia en su infraestructura GPU gestionada
- Capacidad y concurrencia probadas para su aplicación
Asistencia de código sobre código fuente privado
Ejecute un modelo de código con contexto aprobado de sus repositorios y acceso privado. Mantenga la inferencia y el código fuente en infraestructura gestionada, con las compleciones devueltas a su equipo.
- Ficheros seleccionados y código recuperado como contexto
- Acceso a los repositorios limitado a usuarios autorizados
Un despliegue de IA privada
Historiales médicos analizados
sin salir de Atenas.
Un cliente necesitaba IA para analizar historiales médicos: entran los expedientes de los pacientes, sale un informe estructurado y con citas, y cada paso se ejecuta en modelos locales sobre las GPU privadas del propio cliente dentro de Digital Realty Athens. Los datos nunca tocan un cloud público.
Antes de desplegar
El modelo es
solo el principio.
Memoria, acceso, coste y operación continua. Repasemos lo que necesita su endpoint.
Pregunte a un ingenieroTrabajamos con modelos de pesos abiertos como Llama, Mistral, Qwen y DeepSeek. La versión exacta, el software de serving, las necesidades de hardware y las condiciones de licencia se revisan para su despliegue. Si no ha elegido un modelo, podemos preseleccionar opciones y probarlas con sus prompts.
Su próximo socio de infraestructura
Tráiganos el modelo
que quiere ejecutar.
Cuéntenos sobre su modelo, sus datos y la carga de trabajo prevista. Repasaremos con usted el hardware, el stack de serving y el despliegue.
+357 222 32280
Empecemos por su infraestructura.
Un poco de contexto nos ayuda a empezar la conversación adecuada.
Del equipo de ingeniería
El razonamiento detrás del endpoint.
AI Hosting · 8 min read
A 70B model really does fit on a 48GB card, once you count what quantization costs.
Read the articleAI Hosting · 6 min read
Your AI endpoint doesn't have to be on the internet.
Read the articleAI Hosting · 5 min read