

Desde 2004: Sin concesiones
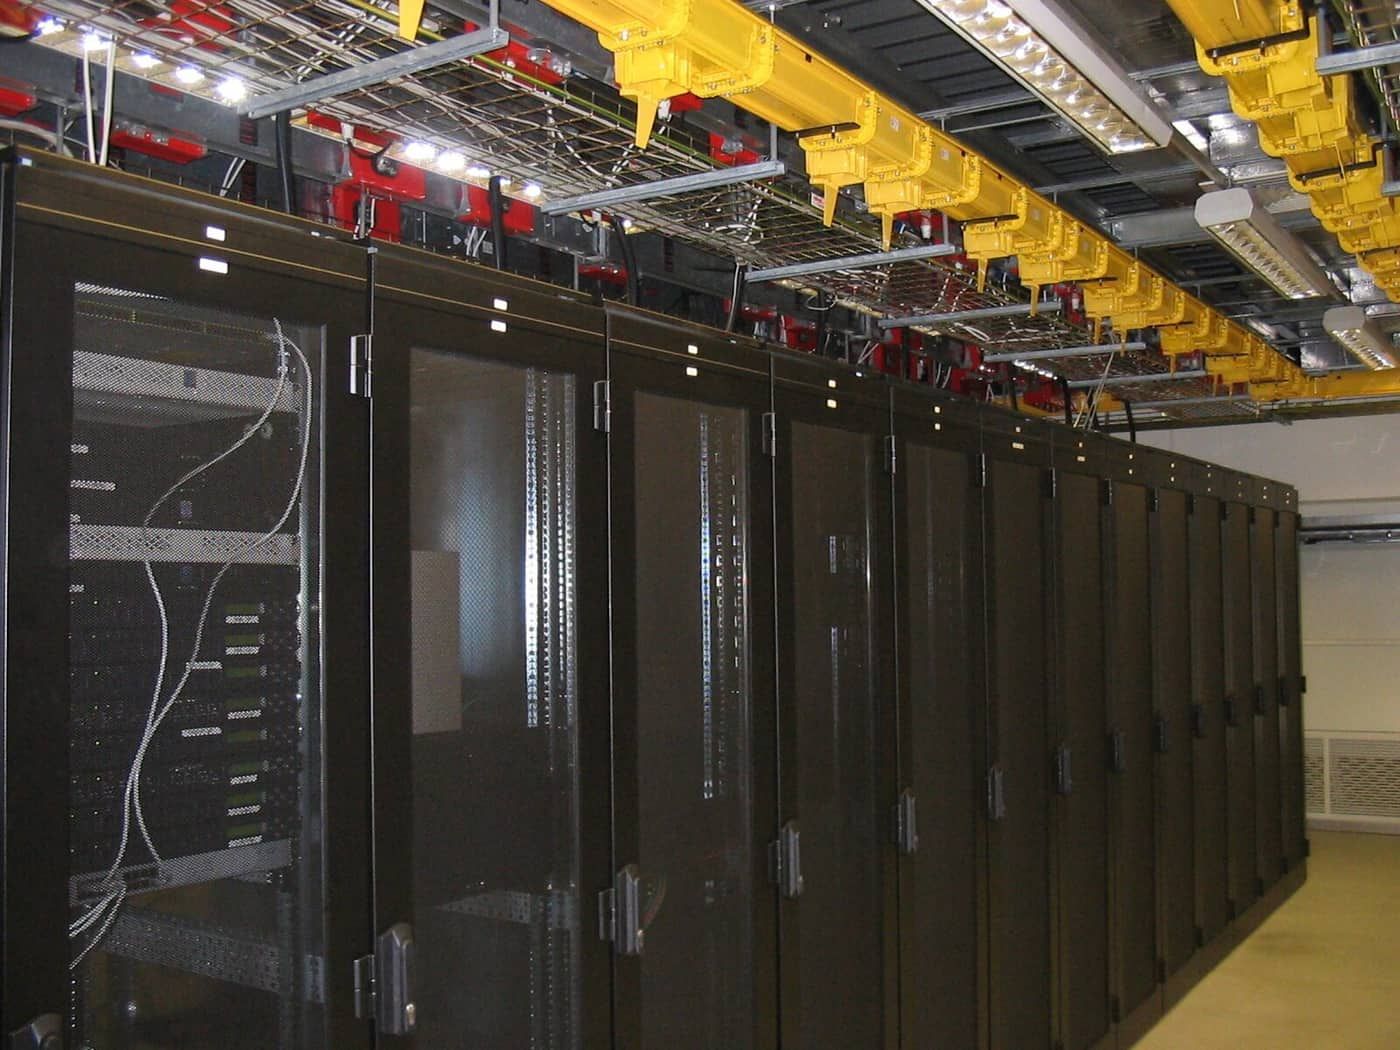
En 2004 EuroVPS era una máquina. No una barata.
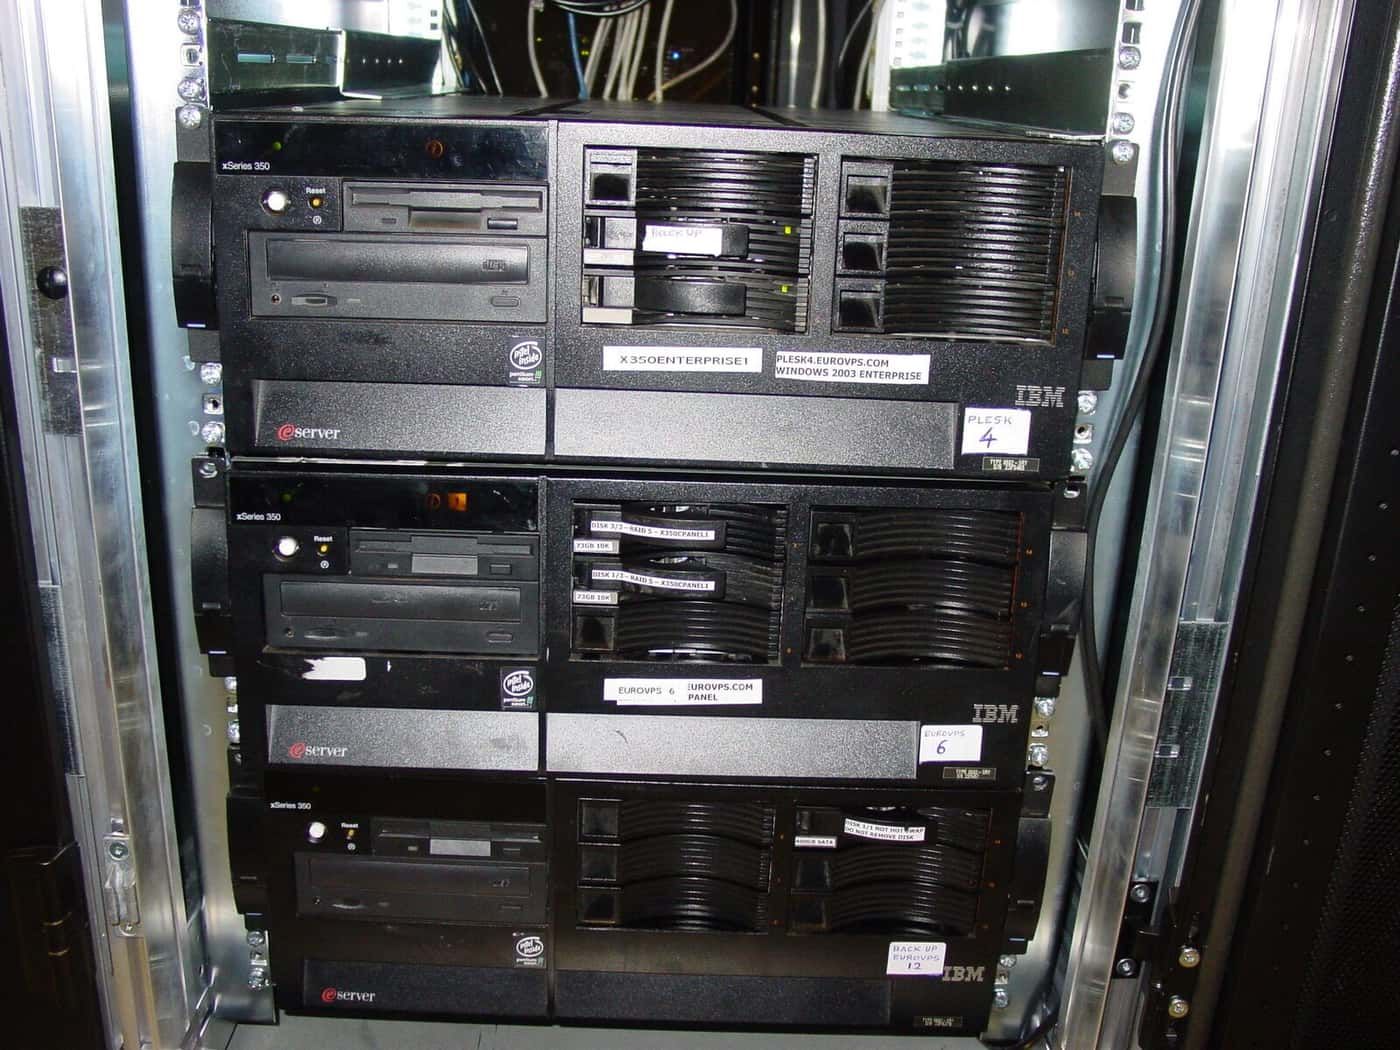
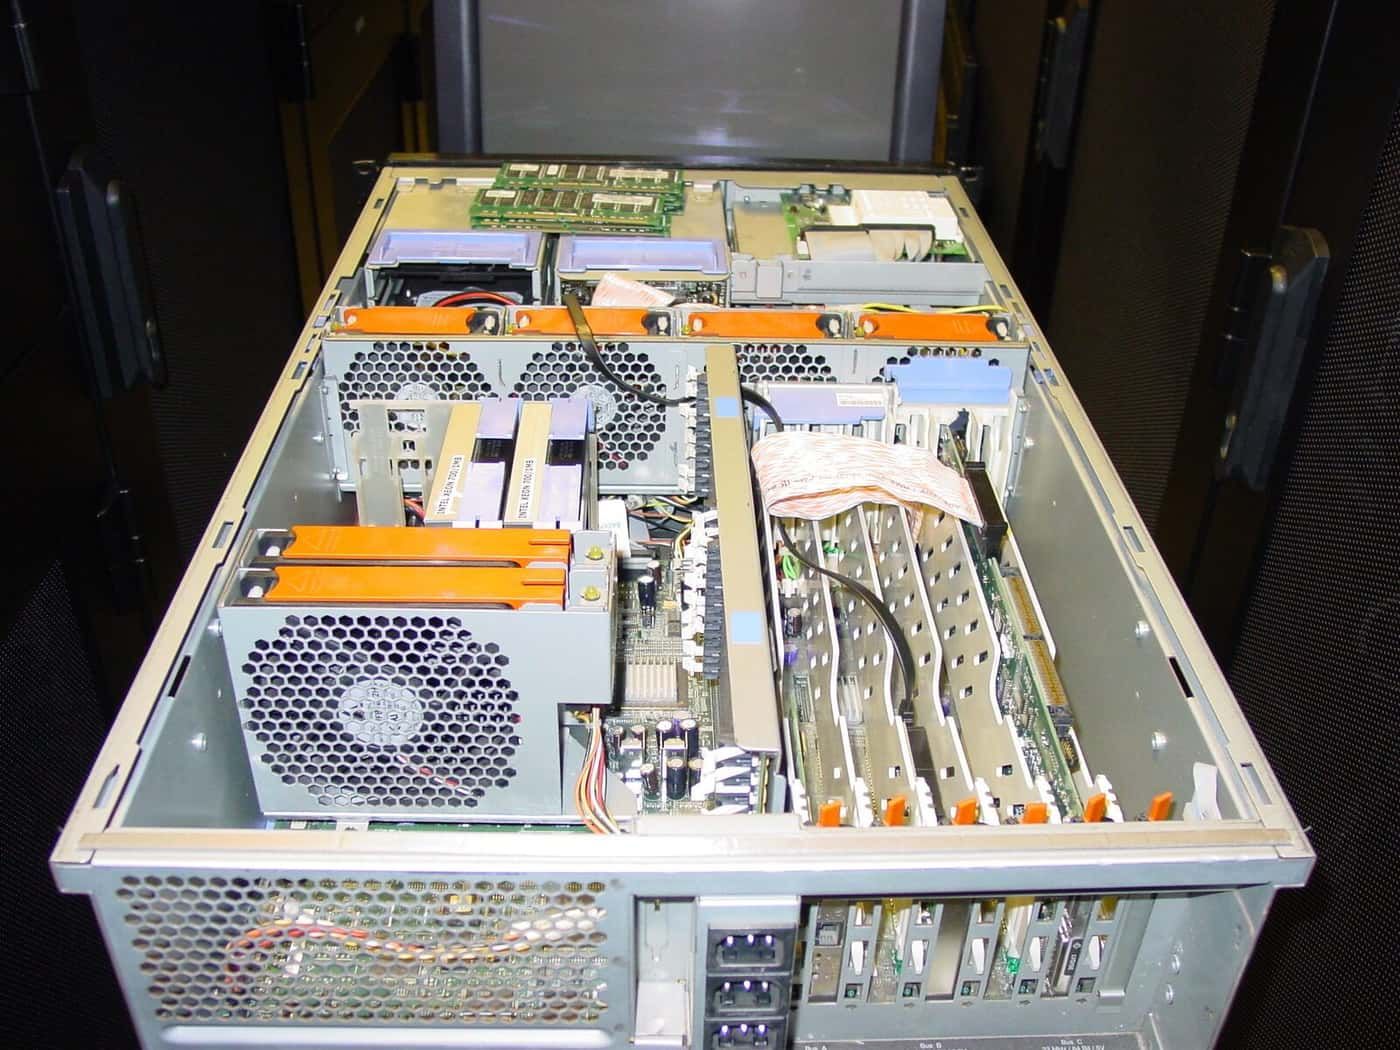
Era un IBM xSeries 350: un servidor de cuatro sockets, de clase enterprise, comprado al contado y llevado a mano a una sala de colocation en Ámsterdam. La máquina más barata que habría hecho el trabajo costaba una fracción de lo que pagamos. Compramos el xSeries de todos modos, y el motivo es la única política de empresa que hemos tenido jamás: se empieza con la mejor máquina que uno puede permitirse, no con la más barata que funciona.
Sobre él corría Plesk. Las etiquetas que imprimimos para el frontal de aquel primer stack todavía se leen en las fotografías: el hostname en cada máquina, la disposición RAID en las bahías de disco, y un chasis marcado BACK UP. Un servidor, ya etiquetado bahía por bahía, y una máquina aparte que ya hacía backups. Nada de nuestra forma de trabajar hoy es un invento posterior. Son los mismos hábitos, con más hardware.
Los años de Ámsterdam
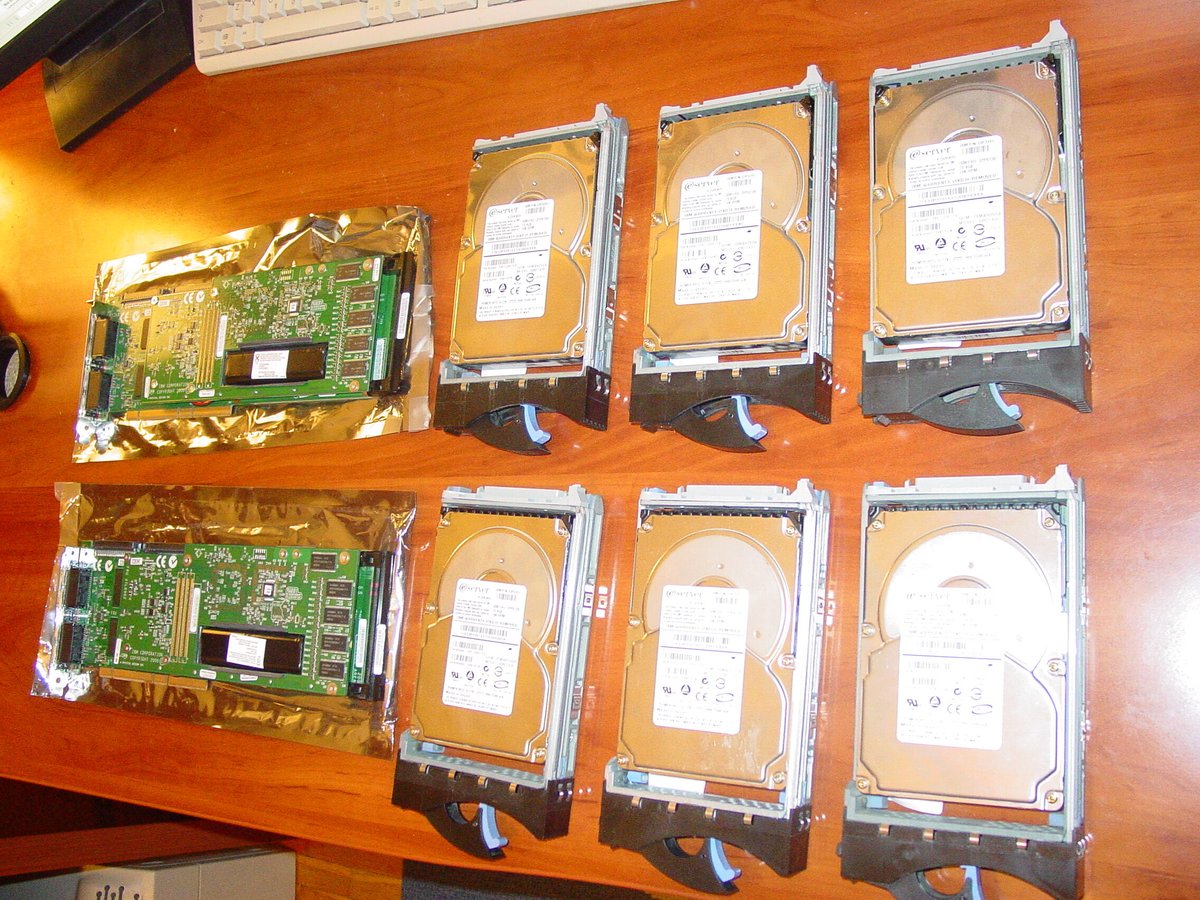
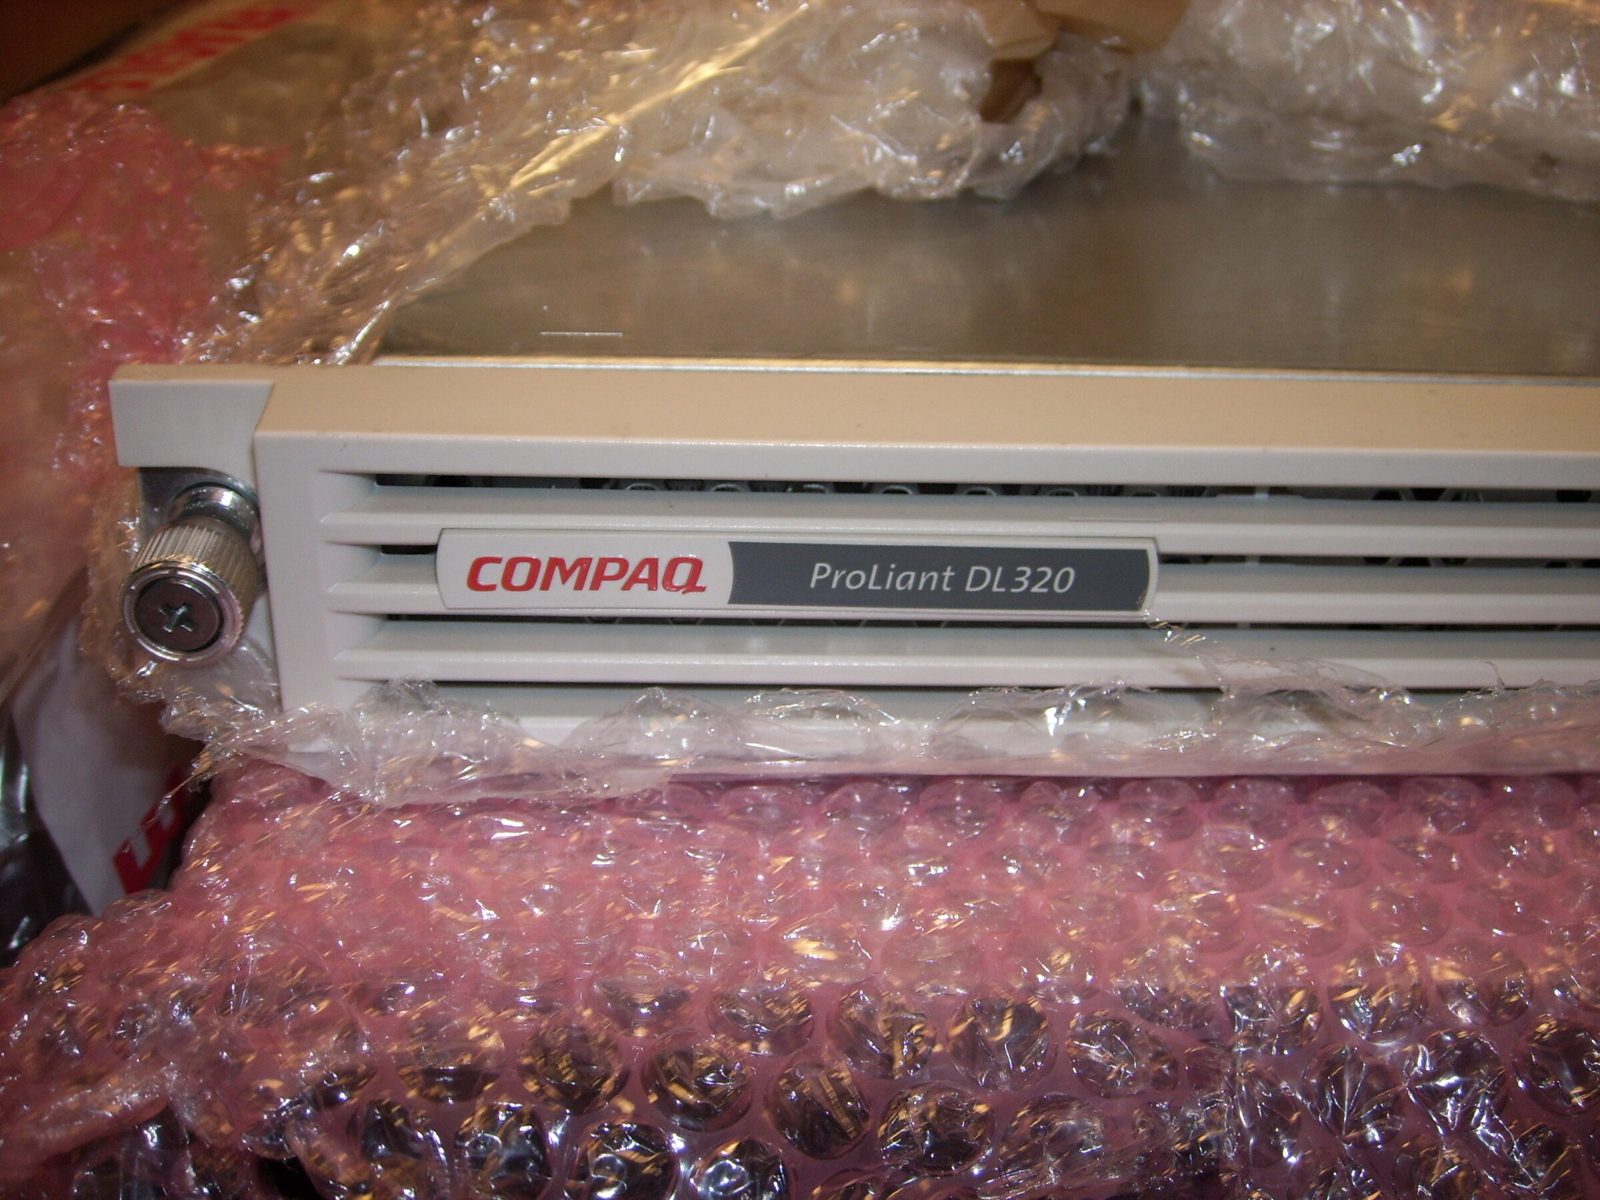
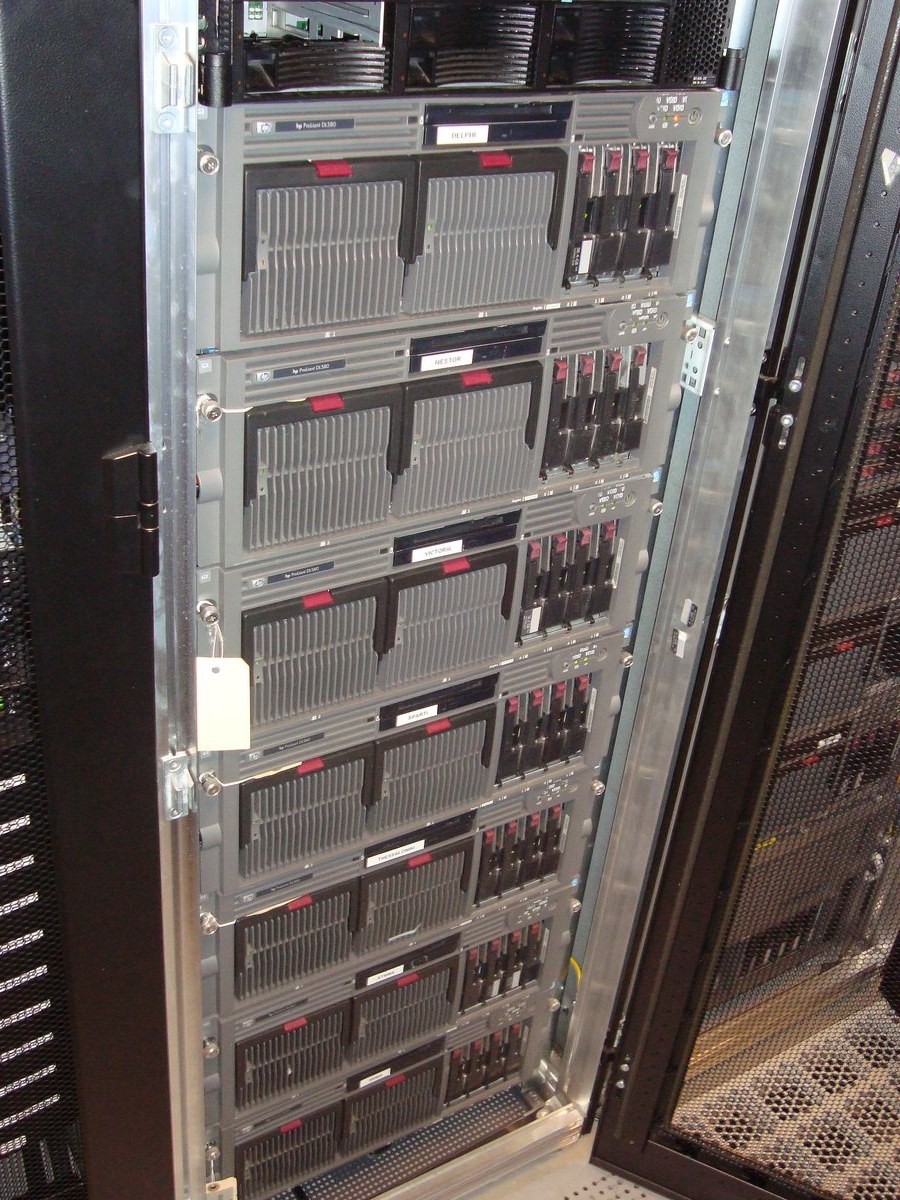
Los primeros años fueron un pasillo, un crash cart y un portátil en el suelo. IBM xSeries primero, luego Compaq y HP ProLiant codo con codo durante la mayor parte de la década, comprados nuevos y desembalados entre los armarios. El storage pasó pronto a cabinas enterprise, EMC CLARiiON sobre dobles fabrics Fibre Channel, con Cisco en el núcleo, porque preferimos pagar el segundo camino antes que explicar algún día por qué no lo había. Siguieron los chasis de blades, luego columnas enteras de ellos, y la instalación creció hasta ocupar nuestras propias jaulas en Iron Mountain.

Atenas, Ámsterdam, Toronto
El buque insignia hoy es nuestra propia jaula en Digital Realty Athens: nuestros propios routers, storage all-flash, fibra en cada puerto, construida como se construyó el primer rack, por nosotros. Ámsterdam continúa, unida a Atenas sobre Layer 2 privado, de modo que las dos se comportan como una sola red y puede moverse entre ellas sin cambiar una sola dirección. Toronto cubre Norteamérica desde Cogent. Nuestra sede central está en Chipre.

Un solo sistema operativo, todo el camino
Nuestro primer servidor ejecutaba Red Hat Enterprise Linux, y nos hemos mantenido en él en cada versión principal desde entonces. No porque estuviera de moda: un sistema operativo con un ciclo de vida publicado, paquetes firmados, SELinux en modo enforcing y un fabricante que responde por cada actualización es la decisión que nunca tenemos que revisar.
Dos décadas en una sola plataforma son una inversión en sí mismas. Cada build, cada regla de hardening y cada runbook de actualización que tenemos se escribió una vez y se ha mejorado desde entonces, en lugar de tirarse a la basura con cada distribución del mes.
También devolvimos algo. Desde 2005 mantuvimos un espejo público para el proyecto CentOS, gratuito, desde nuestra propia red, para que cualquiera en el mundo pudiera instalar y actualizar CentOS con ancho de banda de EuroVPS.
Sí, patrocinamos un escritorio. Actualmente donamos tres servidores HPE ProLiant al proyecto KDE. Nuestros ingenieros llevan usando KDE Plasma sobre Red Hat Enterprise Linux más tiempo del que algunos de nuestros clientes llevan en activo. Cuando las personas que eligen el hardware aprecian tanto una herramienta, la herramienta recibe servidores.
Calidad por encima del beneficio
Venimos de una época anterior a que maximizar el margen se convirtiera en el mantra.
EuroVPS no tiene capital riesgo, ni inversores externos, ni plan de salida. Nadie nos ha dicho nunca que recortemos un coste de una plataforma para que un trimestre luzca mejor, porque no hay trimestre que maquillar ni nadie para quien hacerlo. La empresa la dirigen las personas que la construyeron, servidor a servidor, con sus propias manos.
Eso no es sentimentalismo, es un proceso de decisión. Cada elección técnica aquí se resuelve por mérito de ingeniería y por lo que nos costará que nos despierten, no por lo que hace con un margen. Cuando una empresa de hosting acepta dinero externo, tarde o temprano tiene que devolver algo, y lo que se devuelve es casi siempre la parte que no se ve: la segunda acometida eléctrica, la óptica original, el repuesto en la estantería, el ingeniero senior a las tres de la madrugada. Nosotros conservamos las cuatro, porque las personas que deciden aquí son las que reciben la alarma.
Lo que nos negamos a comprar
Somos una empresa de hosting, así que el hardware no es una partida de coste que intentemos reducir. Es el producto. Casi todo lo que hace barato al hosting barato se reduce a una lista corta de componentes, y ninguno de ellos va debajo de una carga de trabajo de un cliente nuestro.
Discos SATA
Un puerto, un camino, una controladora: un punto único de fallo por construcción, y ninguna capa de software por encima puede inventarse una segunda ruta. SATA encola poco y se recupera mal de los errores, así que un disco de clase doméstica puede quedarse reintentando un sector débil mientras todo lo que hay encima espera. El SAS enterprise tiene doble puerto, informa de sus contadores de error con honestidad y devuelve el control lo bastante rápido para que la capa RAID haga su trabajo.
SSD SATA
El mismo puerto único, la misma cola corta, sobre una interfaz diseñada para discos giratorios. Poner flash detrás de SATA es pagar el medio y descartar la mayor parte de lo que ofrece. Ese mercado es además abrumadoramente de consumo: baja resistencia, sin segundo puerto, a menudo sin protección frente a cortes de alimentación.
Módulos NVMe M.2 de consumo
Los módulos de consumo no suelen llevar condensadores de protección frente a cortes de alimentación, así que una escritura en curso cuando se va la corriente es una escritura que quizá nunca vuelva a ver, y su resistencia está especificada para un escritorio, no para una base de datos que escribe todo el día. Usamos mucho NVMe, como unidades enterprise U.2 y U.3 con protección frente a cortes de alimentación en bandejas hot plug. Nunca como un módulo pegado a una placa que guarda la única copia.
Placas de un solo socket de clase doméstica
Un socket, una fuente, sin gestión fuera de banda digna de ese nombre, y demasiado pocas líneas PCIe para llevar a la vez un HBA Fibre Channel de doble puerto y red redundante. Tampoco hay backplane hot plug, así que cada fallo de un componente es un apagado. El diseño dice una cosa: si esto se rompe, el servicio sigue roto hasta que alguien conduzca hasta allí.
Una sola fuente de alimentación
Una sola fuente convierte el trabajo programado del datacenter en una caída para el cliente.
Memoria sin ECC
No ejecutaremos una carga de trabajo sobre memoria que no puede avisarnos de que está fallando.
RAID por software como argumento de resiliencia, y servidores de marca blanca
No apoyamos los datos de los clientes en el RAID por software de una sola caja, con una caché de escritura sin proteger y la paridad reconstruida en la CPU del host. La resiliencia pertenece a la cabina y a los fabrics redundantes, donde sobrevive a perder el servidor por completo. La marca blanca recibe la misma respuesta: sin ciclo de vida del firmware, sin repuestos en la estantería, sin nadie a quien llamar.
En la práctica. No damos nada por bueno a partir del nombre de un dispositivo o de un valor por defecto del kernel: interrogamos directamente a la controladora RAID y a los discos, por dos caminos independientes, y ajustamos según lo que cada dispositivo informa realmente.
Lo que compramos en su lugar
HPE ProLiant y Dell PowerEdge: ProLiant DL380 Gen10 y Gen11, DL385 Gen11 y blades BL460c Gen10; PowerEdge R740, R750 y R7525, y C6400 para cómputo denso. La misma base en todos ellos.
- Dos fuentes de alimentación hot plug sobre dos acometidas independientes.
- Memoria ECC en todo, con los contadores de errores corregibles vigilados.
- RAID por hardware con caché de escritura respaldada por batería o flash allí donde un servidor guarda discos locales, para que un incidente eléctrico no pueda costar una escritura confirmada.
- SSD SAS 12G enterprise y NVMe enterprise, colocados donde la medición dice que corresponden.
- Gestión fuera de banda en cada caja, sobre una red de gestión aislada físicamente (air-gapped) y enrutada por su propio sistema autónomo, completamente separado.
Hosts que arrancan desde la SAN y no guardan nada
Nuestros hipervisores arrancan desde un volumen en la cabina, presentado a través de dos fabrics Fibre Channel físicamente separados. El servidor en sí no guarda datos de clientes, así que un blade averiado nos cuesta un blade: el de repuesto arranca el mismo volumen. Eso es un cambio de pieza, no una recuperación de datos.
Máquinas que nunca cruzan un socket
Regla de la casa, y no negociable: una máquina virtual nunca recibe más vCPU que núcleos físicos tiene un socket, y nunca más memoria de la que sirve un nodo NUMA. Si abarca dos sockets, parte del tráfico de memoria se vuelve remoto, a aproximadamente 1,7 veces la latencia local, antes de contar el tráfico de coherencia de caché a través de la interconexión entre sockets. La penalización se acumula en lugar de promediarse, y por eso una máquina dimensionada más allá del límite del socket suele ir más lenta que la más pequeña a la que sustituyó.
El flash enterprise no es RAM
Nuestras máquinas virtuales no tienen swap. El swap en una VM empuja la presión de memoria hacia la cabina y gasta resistencia de escritura del flash que existe para servir datos reales. Si una aplicación necesita más memoria, la respuesta honesta es más memoria, o una corrección en la aplicación. Le diremos cuál.
Ajustados, no entregados con los valores por defecto
Los volúmenes respaldados por flash reciben el planificador, la lectura anticipada y la profundidad de cola correctos, no heurísticas escritas para discos giratorios. Pequeñas mejoras permanentes, en cada build.
Storage: HPE 3PAR, all-flash, dos de cada cosa
Los datos de los clientes viven en HPE 3PAR, all-flash, en grupos de aprovisionamiento SSD RAID 6. RAID 6 porque la reconstrucción de una unidad flash grande es una ventana, y no vamos a pasarla a un solo fallo de la pérdida de datos.

Dos controladoras, dos fabrics, muchos caminos
Controladoras duales por cabina. Cada host se conecta a través de dos fabrics Brocade Fibre Channel físicamente separados, un puerto de HBA en cada uno, y se registra con la persona correcta para que el multipathing y ALUA se comporten como espera el sistema operativo. Una controladora, un fabric, una óptica o un puerto de HBA pueden desaparecer y el volumen sigue en línea.
Thin que dice la verdad, volúmenes que se mueven en uso
Los volúmenes son thin con detección automática de ceros, así que un disco de invitado aprovisionado por completo no cuesta casi nada físicamente hasta que llegan datos reales. Las cabinas están en federación, así que migramos un volumen en vivo de una cabina a otra mientras el host sigue leyendo y escribiendo en él. Para las bases de datos en clúster vamos más allá y colocamos cada miembro en una cabina física distinta, de modo que perder una cabina entera cuesta una réplica y el quórum se mantiene.
Higiene de discos, y disciplina en las escrituras
Un disco que informa de un error corregido es un disco cuya corrección interna de errores ya está trabajando, bajo tráfico real de clientes. No esperamos a que falle: se vacía hasta cero, se retira, se sustituye por un disco limpio, y la cabina admite el nuevo automáticamente.
Los backups se extraen, y la recuperación se ajusta al servicio
Los backups son solo pull. Los sistemas protegidos no tienen ruta hacia la infraestructura de backup ni credenciales para ella, así que un compromiso en el lado de producción no puede alcanzar los backups. El lado seguro sale a buscar lo que necesita, nunca al revés. Los objetivos de recuperación se fijan por servicio, no como una cifra única de la casa: un sitio estático y una base de datos transaccional no merecen la misma respuesta.
Un proveedor puede sustituir más adelante el storage, los servidores y el software. Lo que no se arregla después es el cableado, las ópticas y los routers sobre los que se construyó, así que eso lo hicimos bien primero.
Fibra de extremo a extremo
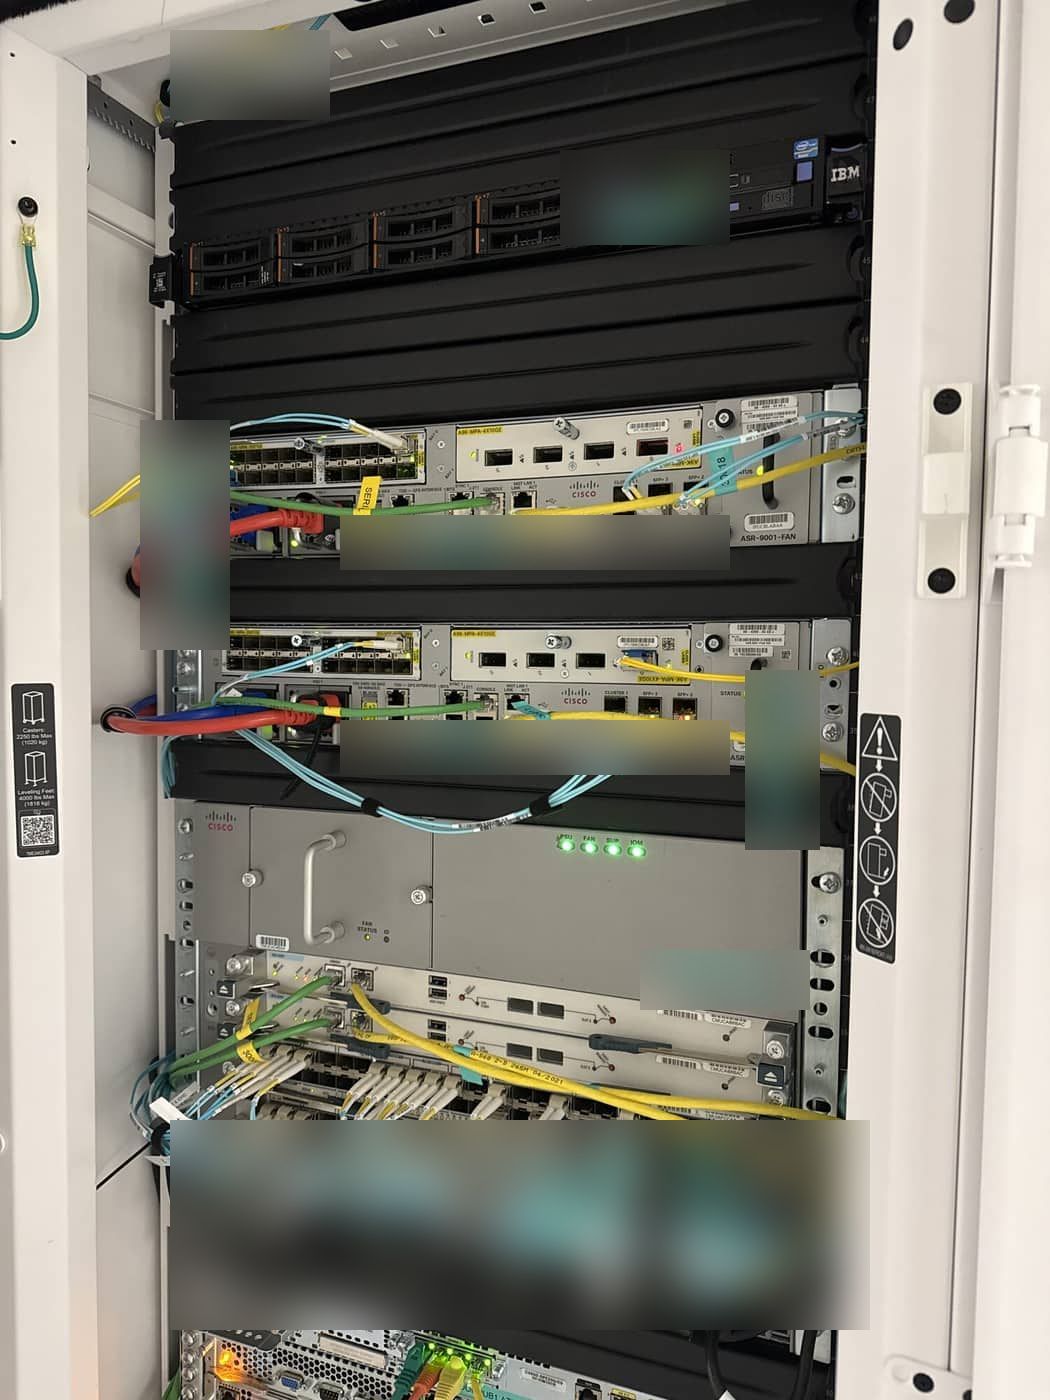
No hay cableado de datos de cobre en nuestra jaula de Atenas. Cada servidor, cada chasis de blades, cada cabina de storage, cada switch y cada router están conectados por fibra óptica. El único cobre que queda en un armario es el tramo corto hasta el puerto de gestión lights-out de un servidor, y eso es deliberado: es la única interfaz cuyo trabajo es funcionar cuando todo lo demás está apagado.
El vidrio gana en todos los ejes que importan dentro de un armario. A un enlace óptico no le afectan el ruido eléctrico ni el latiguillo de alimentación que tiene al lado, así que un enlace está bien o está ausente, nunca misteriosamente al límite, y un tendido cruza el rack, la fila y la sala con la misma especificación. El cobre de alta velocidad es grueso, pesado y poco dado a doblarse, y esa masa acaba colgando del switch al que sirve, delante de su salida de aire; la fibra es fina y ligera, así que los armarios se mantienen limpios. Y cuando llega la siguiente generación de velocidades, la planta se queda donde está: cambiamos el transceptor en cada extremo y conservamos el cable.
En la práctica. Antes de lanzar nuevas plataformas de clientes construimos toda la topología de fibra y port-channels de un rack de blades antes de que existiera la mayoría de los blades. El día del lanzamiento fue un encendido, no un trabajo de cableado.

Solo ópticas originales
Cada SFP, SFP+ y QSFP de nuestros racks es la pieza del propio fabricante, emparejada con el switch o router en el que va y soportada por el fabricante cuyo nombre figura en el chasis. Nunca hemos comprado un transceptor genérico y no vamos a empezar ahora.
El ahorro es pequeño y compra cuatro problemas: lecturas ópticas que pueden no significar nada, lo que le cuesta el mejor diagnóstico de una red óptica, el nivel de luz en vivo en cada extremo; un módulo que funciona con una versión de software y se comporta mal con la siguiente, porque nadie probó esa combinación; un motivo legítimo para que un fabricante cierre el caso de soporte que abre la noche en que más lo necesita; y un enlace que oscila bajo carga por razones que nadie puede reproducir. Así que compramos la pieza correcta, y compramos repuestos: bandejas de ópticas en la estantería dentro del datacenter, para que una sustitución sea un paseo por el pasillo en lugar de un pedido de compra.
En la práctica. Nuestras revisiones rutinarias de estado leen los contadores de errores de interfaz y ópticos en todo el fabric, y como cada módulo es del propio fabricante, lo que informan sirve para actuar: un transceptor que se desvía de la especificación es un cambio planificado desde la bandeja, a nuestro ritmo.


El fabric: leaf y spine, EVPN y VXLAN
Dentro del datacenter todo cuelga de un fabric leaf y spine Cisco Nexus 9000 que ejecuta BGP EVPN con VXLAN. Los spines son puros reflectores de rutas, sin extremos de túnel en ellos por diseño. Los leaves se construyen como pares de port-channel virtuales, así que cada host está conectado por doble vía a dos switches a través de un único bond lógico, y la puerta de enlace de la subred de un cliente es la misma dirección anycast en cada leaf. El tráfico de broadcast se replica mediante BGP y no mediante un árbol multicast, y BFD se ejecuta allí donde importa la detección rápida. Como cualquier VLAN puede vivir en cualquier leaf, podemos extender el Layer 2 de un cliente entre nuestros datacenters y dejar que sus servidores conserven sus direcciones mientras se mueven.
El identificador de red de cada segmento Layer 2 se deriva de su VLAN local mediante una regla fija, y esa regla no es una convención escrita en un documento. Una comprobación automatizada lee el mapa desde cada leaf, confirma que los leaves son idénticos y obedecen la regla, y compara una huella criptográfica de todo el mapa con una línea base firmada en control de versiones. Se ejecuta antes de guardar cualquier cambio y de forma programada después, cualquier desviación avisa a un ingeniero, y un cambio intencionado tiene que volver a firmarse, así que cada cambio del fabric lleva un autor y un rastro de auditoría.
En la práctica. En una prueba de fallo controlada reiniciamos un nodo de un clúster mientras era el camino preferido para una dirección pública en vivo. El fabric convergió sobre un nodo sano en unos tres segundos, y la dirección nunca salió de la tabla de rutas.

El edge: nuestros propios sistemas autónomos
Operamos nuestro propio edge de internet, con nuestros propios sistemas autónomos registrados en RIPE y nuestro propio espacio IPv4 e IPv6, con la producción de clientes y los servicios de plataforma en sistemas autónomos separados, de modo que un problema en uno no puede alcanzar al otro. Los routers son de clase operador: Cisco de la serie ASR 9000 en Atenas, un ASR 9006 al frente del edge de producción, y Juniper MX204 en Ámsterdam, cada uno con la tabla de rutas completa de internet y compartiéndola con su homólogo.
Compramos tránsito a varios operadores en lugar de alquilar un puerto a quien sea el dueño del edificio: OTE Globe, Cogent y Hurricane Electric en Atenas, Arelion, NTT, Deutsche Telekom y Telecom Italia en el lado de Ámsterdam, con las dos sedes unidas sobre Layer 2 privado para que la instalación se comporte como una sola red. Hacemos peering directo en GR-IX y NetIX, y añadimos sesiones bilaterales una a una con las redes con las que realmente hablan nuestros clientes.
IPv6 es nativo en todas partes: doble pila desde los routers del edge hasta su puerta de enlace, sin túneles ni traducción en el camino.
En la práctica. Nuestro fabric de Atenas pasó a doble pila en una sola jornada de trabajo, desde el edge de internet, a través del fabric, hasta una VLAN compartida de clientes en vivo.

Fibre Channel: dos fabrics, nunca un solo camino
La red entre servidores y storage es Fibre Channel, no Ethernet, construida como dos fabrics Brocade completamente independientes. Cada servidor y cada cabina están conectados a ambos, cada fabric con su propio switching de núcleo y su propio switch dentro de cada chasis de blades, de modo que ningún fallo de switch, cable, puerto o software existe a ambos lados del camino de un host.
En la práctica. Como cada host ya mantiene caminos activos hacia todas las cabinas de su federación a través de ambos fabrics, podemos vaciar una cabina de storage entera, por mantenimiento o por un traslado, sin reiniciar una máquina de cliente y sin ventana de mantenimiento.
El backbone cifrado entre nuestras sedes
Nuestros datacenters en Atenas, Ámsterdam y Toronto, nuestra sede central en Chipre y nuestros puntos de presencia regionales están unidos por una superposición Cisco DMVPN: túneles GRE multipunto protegidos con IPsec AES-256, NHRP autenticado, BFD y BGP sobre los túneles. Cada datacenter tiene hubs redundantes, y como la superposición la enruta BGP y no tablas estáticas, perder un hub o un circuito es una retirada de ruta que converge por sí sola.
Una sede con dos circuitos WAN ejecuta una segunda nube DMVPN en el mismo router, así que el segundo circuito no necesita una nueva dirección pública ni ningún cambio en los hubs, y el multipath de BGP reparte el tráfico entre ambos con un hash de reenvío que incluye los puertos, para que los flujos paralelos se dividan de verdad. Dimensionamos según lo que el motor de cifrado puede hacer realmente, unos 11 Gbit/s por hub, no según la cifra impresa en una licencia, y escalamos con multipath de igual coste entre hubs hasta 30 a 40 Gbit/s cuando un cliente lo necesita.
En la práctica. En una sede de doble circuito, una prueba de rendimiento midió en cada sentido más de lo que cualquiera de los dos circuitos podía transportar por sí solo. Esa es la única prueba aceptable de que el multipath de igual coste está funcionando y no solo configurado.
La disciplina que lo acompaña
Bonds que usan ambos enlaces. El bonding de Linux por defecto hace hash sobre direcciones MAC, lo que en un datacenter apila los flujos en un miembro del bond y deja el otro ocioso. Cada servidor con bonding que construimos hace hash en capa 3 y capa 4, con el lado del switch configurado igual. Comprobamos los contadores por puerto en cada build para demostrar que ambos enlaces transportan tráfico.
Cada puerto registrado. No un nombre en una fila: el puerto con su dirección MAC real, el enlace al puerto del switch remoto con su identificador de cable, la posición en el rack, las direcciones y la interfaz de gestión. El dispositivo en vivo es la fuente de la verdad y los registros se hacen para coincidir con él.
Un registro inverso para cada dirección. Cada dirección que asignamos a una interfaz, un loopback, un servicio o un host recibe un PTR en nuestro propio DNS autoritativo, en la misma sesión. Un traceroute a través de nuestra red se lee como una frase que nombra el dispositivo, su función y su sede.
El plano de gestión, y el air gap
El tráfico de clientes y el tráfico de gestión no comparten nada: ni un puerto, ni un switch, ni una dirección, ni una ruta.
Queda exactamente un cable de cobre en nuestros armarios: el puerto de gestión del controlador lights-out de cada servidor. Es también el cable más cuidadosamente aislado del edificio.
Gestión fuera de banda en cada máquina
Cada servidor que operamos es un servidor enterprise de verdad con un controlador lights-out de verdad: iDRAC Enterprise con licencia Datacenter en Dell, iLO Advanced en HPE, ambos gobernados mediante Redfish, y cada chasis de blades a través de su Onboard Administrator. No una placa base de marca blanca cuya idea de gestión remota es un botón de encendido y ninguna consola.
En los chasis de blades, el Onboard Administrator alcanza cada controlador del chasis a través del backplane, y es a su vez un par redundante con failover automático.
En la práctica. Cuando un rack de chasis de blades necesitó licenciar iLO Advanced, y crear una cuenta de gestión en cada blade, no iniciamos sesión en un solo blade. Lo aplicamos a través del Onboard Administrator de cada chasis y el rack quedó listo en minutos, incluidos blades montados esa misma semana que aún no tenían credenciales propias. Es un runbook.
La red de gestión no es la red de producción
El controlador tiene su propio puerto físico y su propio cable hacia su propio switching. No particionamos una tarjeta de red de producción para que el controlador tome prestada una porción, que es el atajo habitual y la razón habitual por la que la gestión acaba a un error de distancia de internet. La gestión vive en sus propios switches, o en sus propias VLAN sobre fabrics que no transportan nada más, en espacio de direcciones privado que no se enruta hacia ni desde ninguna red de cliente y que nunca se anuncia a internet.
Lo llamamos air gap porque así se comporta. Una máquina virtual de cliente, incluso una totalmente comprometida, escaneando a velocidad de línea durante una semana, no puede ver un iLO ni un iDRAC en absoluto. Ni rechazado, ni filtrado: ausente. No hay ningún sitio al que puedan ir los paquetes. Se cumple también en el otro sentido, y eso importa igual: ningún tráfico de gestión viaja por una VLAN de cliente, así que nuestras sesiones de consola, la monitorización y los backups nunca entran en el dominio de broadcast de un cliente ni compiten por su ancho de banda. El aislamiento es lo bastante real como para resultarnos incómodo, y esa es la prueba de que es real: un controlador en una VLAN de gestión no puede alcanzar sin más un servidor web interno para descargar una imagen de firmware, porque no se permite nada que no se haya pedido y dejado por escrito. El ingeniero da el paso adicional.
Los backups viajan por el mismo camino. Se realizan a través de la red fuera de banda, nunca por un segmento de producción.
En la práctica. Una única lista de acceso de gestión canónica está aplicada en cada plataforma que operamos, en las líneas de inicio de sesión de Cisco Nexus, por instancia de enrutamiento en los routers, por interfaz para SSH y HTTPS en los firewalls, permitiendo solo las subredes de gestión designadas, con control plane policing limitando en hardware lo que quede.
El plano de gestión en sí
El plano de gestión es una red por derecho propio y la construimos como tal. Corre sobre nuestro propio backbone cifrado multisede: Cisco DMVPN, IPsec con AES-256, BGP transportado por los túneles, uniendo Atenas, Ámsterdam y Toronto con nuestra sede central en Chipre, que deliberadamente no está en ninguno de los edificios que gestiona. Los hubs son redundantes, con caminos de igual coste entre ellos y a través de circuitos diversos, y una detección de fallos que advierte un camino muerto en bastante menos de un segundo.
El personal llega a él de una sola manera: a través de puertas de enlace VPN y firewalls que poseemos y operamos nosotros mismos, sobre OPNsense y Cisco Firepower, y luego a través de jump hosts dentro del plano, nunca directamente desde el portátil de un ingeniero. Los distintos niveles de confianza nunca comparten un objeto de firewall, así que ampliar el acceso de un grupo no puede ampliar silenciosamente el de otro.
Hacia los planos de backup y disaster recovery la política es denegar por defecto y los datos fluyen en un solo sentido. Producción nunca empuja hacia backup. El lado de backup extrae. Eso se aplica con reglas de denegación explícitas en los appliances de firewall, no con un firewall de host que un host comprometido podría editar, y los segmentos de backup no tienen ninguna ruta a internet. Solo el rango de gestión los alcanza. Si una máquina de producción es tomada por completo, el atacante no obtiene ningún conocimiento de la infraestructura de backup ni ningún camino hacia ella. Desde donde está, no existe.
Los cambios en el backbone se verifican en vivo contra el sistema en marcha, una mitad de un par redundante cada vez, y por eso podemos trabajar en el backbone en mitad de una jornada laboral.
En la práctica. Trasladamos toda la instalación de VPN sitio a sitio de un cliente de un país a otro en una sola sesión, antes de una fecha límite fija. El hub se clonó, se llevó al otro lado y se levantó en paralelo con el original, de modo que ambos estuvieron activos a la vez y siempre hubo un lugar donde los túneles pudieran estar. Los routers de las sucursales se movieron uno a uno, cada uno verificado en marcha antes de tocar el siguiente, cada uno conmutando limpiamente sobre la marcha. Nadie viajó a una sucursal.
La línea base de hardening en cada host
Cada máquina que construimos parte de la misma línea base, y la línea base no está sujeta a negociación. SELinux está en modo enforcing, y no lo desactivamos para que una aplicación coopere: escribimos la política. Los sistemas de ficheros son XFS.
El parcheo no depende de nadie más. Mantenemos nuestro propio espejo de paquetes en nuestro propio datacenter, con los repositorios desde los que instala nuestra flota, con las firmas upstream intactas, accesible solo desde nuestros propios rangos de direcciones. Que un espejo público tenga un mal día no es un evento aquí, y un servidor deliberadamente incapaz de hablar con internet sigue siendo un servidor que podemos parchear por completo.
En la práctica. Cuando se publicó una vulnerabilidad crítica en un runtime de uso generalizado, los paquetes corregidos estaban en producción en cada servidor afectado el mismo día, antes de que acabara esa misma noche. Ni a mano ni con prisas: el despliegue hace un backup, actualiza un host cada vez, muestrea sitios reales de ese host para comprobar una respuesta sana antes y después, y detiene todo el barrido automáticamente si uno no vuelve correctamente. Rápido y cuidadoso no son opuestos si se construye la herramienta que lo hace por uno.
Los registros de las máquinas entran, y nada puede quedarse en silencio
Las severidades serias van directamente al chat de operaciones donde ya está el ingeniero de guardia, y llegan a una persona en segundos; sabemos que son segundos porque lo hemos cronometrado con una alarma real. En el edge, sensores dedicados leen tráfico espejado de los routers de borde y vigilan de forma continua patrones volumétricos y de denegación de servicio.
Un dispositivo puede parecer perfectamente sano desde su propia línea de comandos mientras, en silencio, no envía nada al colector, así que «el logging está configurado» aquí no es una evidencia. Confirmamos que el registro llega, en el extremo remoto, al flujo al que pertenece, después de cada cambio que pudiera haberlo alterado. Los sistemas de monitorización tienen sus propios watchdogs en máquinas separadas, así que «lo que vigilaba ha dejado de vigilar» es en sí mismo una alarma. El silencio nunca es una buena noticia.
En la práctica. Nuestra revisión rutinaria de estado comprueba también dos cosas que la mayoría de las revisiones omiten: si cada dispositivo sigue enviando de verdad sus registros, y si su configuración sigue respaldándose de verdad. Esos dos son los fallos que esconden a los demás.
Análisis en tiempo real en nuestras propias NVIDIA A100
La mayoría de los proveedores recogen los registros en un cubo y lo buscan después de que algo ya se haya roto. Nosotros ponemos el flujo a trabajar. Unas reglas básicas eliminan primero el ruido conocido, y luego todo lo que queda, de routers, switches, firewalls, cabinas de storage y servidores, se analiza a medida que llega mediante modelos de IA que se ejecutan en un conjunto de GPU NVIDIA A100 de nuestra propiedad, dentro de nuestro propio datacenter.
Los modelos leen a través de los dispositivos, no línea a línea: un error en un camino de storage, una interfaz que oscila y una temperatura en aumento en el mismo rack se convierten en una sola historia en lugar de tres mensajes inconexos. Captan los patrones que una regla estática nunca captará, la deriva lenta y la combinación inusual que precede a un fallo, y cada alarma llega al ingeniero con una segunda opinión ya adjunta. Los datos de las máquinas dejan de ser un montón de texto que rastrear con grep y se convierten en una alerta temprana.
Nada de esto sale de nuestra red. Los modelos, las GPU y los datos son todos nuestros, y ninguna línea de registro se envía jamás a un servicio de IA externo.
Un CTO que nos esté evaluando puede pedirnos la lista de acceso, el runbook y el enrutamiento de alarmas. Le mostraremos los tres.
Repuestos en las instalaciones
Los repuestos, hasta chasis completos, están en la misma jaula que las máquinas que los necesitarán, no en el contrato de entrega de un proveedor.
Un repuesto no se gana su sitio en esa estantería por llegar. Los discos pasan por un banco de pruebas, se formatean a bajo nivel al formato de sector de la cabina a la que servirán, y se almacenan solo cuando informan de cero defectos crecidos y de ningún error de lectura, escritura o verificación sin corregir. Un repuesto que falla la noche en que se necesita nunca fue un repuesto.
Sustituir pronto, actualizar a tiempo
Aquí el hardware se retira por evidencias, no por fallo.
Vulnerabilidades críticas, el mismo día. Cuando se divulga un fallo de máxima severidad en algo de lo que dependemos, construimos los paquetes parcheados el mismo día en que se publica la corrección. La configuración protectora se aplica de inmediato. Si aún no existe un paquete corregido para la plataforma que usamos, lo construimos nosotros mismos, compilado en un contenedor limpio a partir de la especificación del propio mantenedor, verificado contra el código fuente publicado del proyecto, instalado host a host con comprobaciones antes y después. La última vez que hizo falta, la corrección estaba en producción unas tres horas después de publicarse el código fuente. Mantenemos nuestro propio espejo de paquetes por la misma razón.
La documentación como infraestructura
Muchas empresas tienen documentación. Nosotros la tratamos como parte de la planta.
Cada cable lleva un identificador único impreso, emitido por un único registro que no puede expedir el mismo número dos veces y que nunca reutiliza uno, ni siquiera después de retirar el cable. La etiqueta nombra ambos extremos: rack, dispositivo y puerto en cada uno. Veintidós años de cableado todavía pueden rastrearse desde la etiqueta, al registro, al puerto del switch, y de vuelta.
Un servicio no está terminado cuando funciona. Está terminado cuando su dirección, su regla de firewall, su registro de inventario y su DNS directo e inverso existen y se han verificado desde fuera de nuestra red.
Nuestras herramientas rechazan el comando cuando la regla no se ha cumplido, lo que es mejor salvaguarda que las buenas intenciones.
Esto es lo que importa a las tres de la madrugada. La pregunta entonces nunca es cuál es la solución ingeniosa. Es qué cambió, y cómo lo devolvemos a su sitio.
Certificados, y auditados
Las cuatro se emitieron en septiembre de 2026 por un organismo de certificación acreditado a nivel nacional, con el alcance redactado como «Managed datacenter hosting service». Ese es el servicio que usted compra realmente, no un rincón de la empresa elegido para facilitar una auditoría.
Sus datos se quedan donde los puso, y en nuestras sedes europeas eso significa dentro de la UE, en hardware de nuestra propiedad, sin cloud público debajo. Firmamos un acuerdo de tratamiento de datos, y nuestro documento de medidas técnicas y organizativas está disponible bajo petición.
Ingenieros, no niveles
Sin bots, y sin primera respuesta de guion.
Los ingenieros que eligen el hardware, lo montan en rack, lo cablean y lo etiquetan son los mismos ingenieros que responden a su ticket, y lo firman con su propio nombre. Funciona porque las personas de aquí conocen su configuración por su nombre y son lo bastante senior como para no necesitar un guion.
En todo nuestro historial de tickets, la mediana de la primera respuesta es de tres minutos, y el 87 por ciento de los tickets se resuelven en menos de una hora. Una buena parte los abrimos nosotros y no usted: nuestra monitorización vigila todo aquello de lo que somos responsables las 24 horas, hasta sus páginas reales, y las alarmas caen en un canal que los ingenieros leen.
Seguimos igual
Los mismos estándares. La misma ingeniería hecha con las manos. Seguimos sin inversores, seguimos sin plan de salida, y seguimos con la regla con la que empezamos en una sala de colocation en Ámsterdam: comprar la máquina mejor.
Ofrecemos visitas acompañadas al datacenter de Atenas: la jaula, la fibra, las ópticas en sus bandejas, los repuestos en la estantería. Se lo enseñaremos nosotros mismos, porque somos quienes lo construimos. Traiga a un ingeniero.
Su próximo socio de infraestructura
¿Quiere verlo?
Cuéntenos qué ejecuta. Le responde un ingeniero, y la visita al datacenter corre de nuestra cuenta.
+357 222 32280
Empecemos por su infraestructura.
Un poco de contexto nos ayuda a empezar la conversación adecuada.