

Qué preguntar a un proveedor de GPU antes de firmar
Doce preguntas antes de alquilar servidores GPU para IA: la tarjeta exacta, dedicada o compartida, jurisdicción, drivers, exposición y tratamiento de los datos.
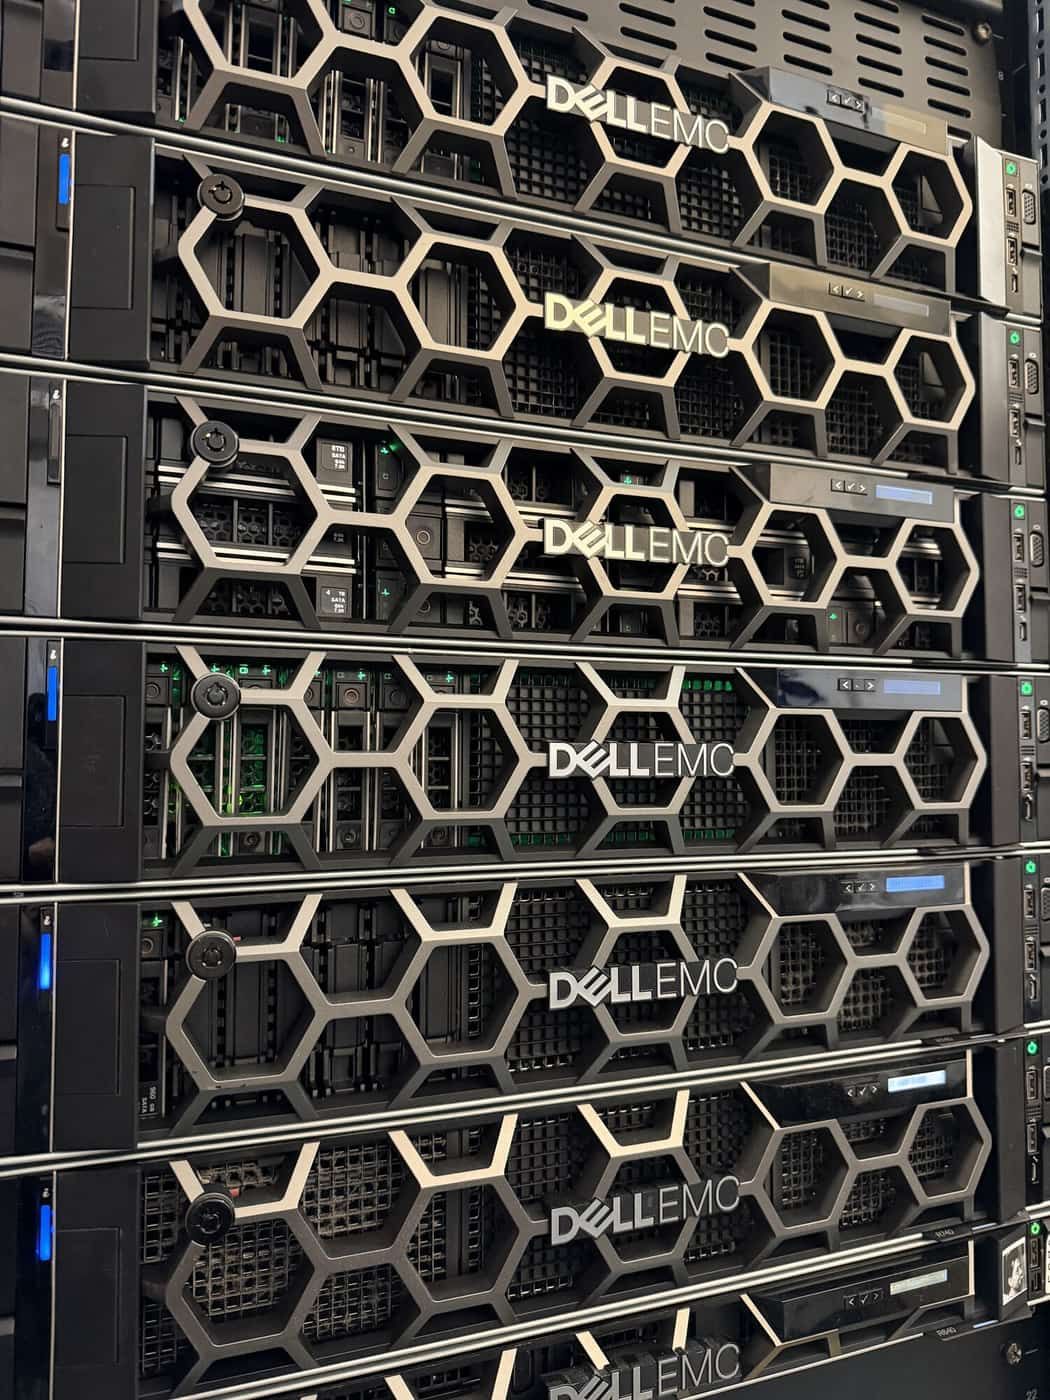
Las ofertas de GPU se parecen de lejos: un nombre de tarjeta, un plazo de entrega, un precio. De cerca, dos ofertas con el mismo nombre de tarjeta pueden ser productos muy distintos, y las diferencias deciden si su modelo funciona bien, si sus datos se quedan donde los necesita y si la plataforma seguirá siendo suya para confiar en ella el año que viene. Estas son las preguntas que haríamos a cualquier proveedor, nosotros incluidos, y cómo comprobar las respuestas cuando el servidor esté en sus manos.
Sobre el hardware
1. ¿Qué tarjeta exactamente? Un nombre de modelo no es una especificación. La misma familia viene con distintos tamaños de memoria y en distintos formatos, una tarjeta PCIe o un módulo en una placa con un enlace de alta velocidad entre GPU. Para modelos grandes, la memoria de la GPU decide qué cabe, y para trabajo multi-GPU el enlace entre tarjetas decide lo bien que escala. Pida la variante exacta por escrito.
2. ¿Es dedicada, o una porción? Una GPU puede dividirse en particiones o compartirse por tiempo entre clientes. Eso está bien cuando lo sabe y el precio lo refleja. No está bien cuando cree que tiene una tarjeta entera. Pregunte si recibe el dispositivo físico completo, y si la carga de trabajo de alguien más corre en él.
3. ¿Qué rodea a la tarjeta? Una GPU rápida estrangulada por un host lento es una GPU lenta. Pregunte por los procesadores, cuánta memoria de sistema hay por GPU, cuántos carriles PCIe llegan a cada tarjeta, el NVMe local para pesos de modelos y datasets, y la red entre servidores si va a entrenar en más de uno.
4. ¿Cuándo puedo tenerlo? Pida un plazo de entrega con el que pueda planificar, y pregunte si es el mismo para un segundo servidor cuando el primero tenga éxito.
Sobre dónde vive
5. ¿Dónde está físicamente, y bajo qué jurisdicción? Si procesa datos sanitarios, legales, financieros o de personal, el país y la entidad jurídica que opera el hardware importan tanto como el hardware. Pregunte por el datacenter, no por el nombre de la región.
6. ¿Quién puede acceder al servidor y a sus datos? Pregunte quién tiene acceso administrativo, si el personal de manos remotas puede tocar la máquina, cómo se registra el acceso y qué pasa con los discos cuando termina el contrato. Una buena respuesta nombra el método de borrado y ofrece un certificado.
7. ¿Se envía algo a un servicio externo? Algunas ofertas de IA gestionada registran prompts y salidas, o enrutan ciertas peticiones a un modelo de terceros. Pregunte directamente si algún contenido, prompt, completion, embedding o log sale del servidor o de la red del proveedor, y consiga la respuesta en el contrato.
Sobre el software
8. ¿Quién mantiene la pila de drivers? Los drivers de la GPU, el runtime CUDA y el toolkit de contenedores deben encajar entre sí y con el kernel. Pregunte quién los actualiza, cómo se prueban y si los módulos del kernel están firmados para que el servidor pueda funcionar con Secure Boot y la política de seguridad que espera en cualquier otra máquina.
9. ¿Puedo ejecutar contenedores con la GPU, de forma limpia? La mayoría de las pilas de IA se distribuyen como contenedores. El runtime de contenedores debería ver la GPU a través del toolkit de contenedores del fabricante, sin ejecutar contenedores privilegiados para conseguirlo.
10. ¿Pueden operar la pila del modelo, o solo alquilarme la máquina? Servir bien un modelo implica batching, decisiones de cuantización, un servidor de inferencia, un modelo de embeddings y normalmente una base de datos vectorial. Algunos proveedores le entregan una contraseña de root y se van. Si quiere la pila construida y operada, pregunte quién lo hará, y pida un endpoint que hable el formato de API que sus aplicaciones ya usan, para que pasar de una API pública a su propio modelo sea un cambio de configuración, no una reescritura.
Sobre exposición y coste
11. ¿Está el endpoint en la internet pública? Un endpoint de inferencia en una dirección pública es una superficie de ataque y una factura esperando a que otro la infle. Pregunte si puede ser accesible solo desde su red privada.
12. ¿De qué depende el coste? El hardware mensual fijo se comporta de forma muy distinta a la facturación por token o por petición a medida que crece el uso. Pregunte qué cambia el precio, y si se aplican límites de tasa a hardware que usted está pagando.
Verifique el primer día
Cuando el servidor sea suyo, compruebe que es lo que se prometió:
nvidia-smi
nvidia-smi -q | grep -E 'Product Name|Serial|Memory|ECC|Persistence|Power Limit'
nvidia-smi topo -m
nvidia-smi -q -d PERFORMANCE
lspci | grep -i nvidia
mokutil --sb-state
nvidia-smi -q confirma el producto exacto y su memoria, y muestra si ECC está activado y si se ha registrado algún error. topo -m muestra cómo se conectan las GPU entre sí y con los procesadores, lo que le dice si el tráfico multi-GPU toma una ruta rápida. La sección de rendimiento informa de los relojes y de cualquier motivo de throttling, como límites de potencia o temperatura, que querrá ver despejados bajo una carga sostenida. Si hay particionado en uso, también aparece aquí. Por último, ejecute su propio modelo con sus propios datos a la concurrencia que espera y mida tokens por segundo y latencia. Ese es el benchmark que importa.
Cómo las respondemos nosotros
Suministramos la GPU de datacenter NVIDIA que su carga de trabajo requiera, A100, H100, L40, L40S y otras, como hardware dedicado sobre plataformas enterprise HPE y Dell, entregado con un plazo de 48 horas, en nuestros datacenters de Atenas y Ámsterdam dentro de la UE. Los servidores GPU se construyen como cualquier otro servidor que operamos: módulos del kernel firmados por el fabricante, Podman con el toolkit de contenedores de NVIDIA, SELinux en modo enforcing. Cuando construimos encima la pila de IA privada, los modelos se sirven a través de endpoints compatibles con OpenAI en un segmento de red aislado, y nada en la ruta del contenido llama a un servicio de IA externo. Así construimos una plataforma para un cliente que analiza historiales médicos: cada paso corre sobre modelos locales dentro de Digital Realty Atenas, y los datos nunca tocan una nube pública. Los discos que salen de servicio se sanean con Blancco, con un certificado de borrado archivado para cada uno.
Tráiganos su modelo y su objetivo de rendimiento, y le diremos qué tarjeta encaja y por qué.
Related (rows[1])
Relacionado: Servidores GPU e infraestructura de IA privada · Servidores bare metal en HPE y Dell · Kubernetes privado sobre bare metal, OpenShift y OKD
Publicado el 1 de octubre de 2026.
Todas las notas de campo