

Τι κάνουμε · Storage και υπολογιστική ισχύς: GPU servers και υποδομή ιδιωτικού AI
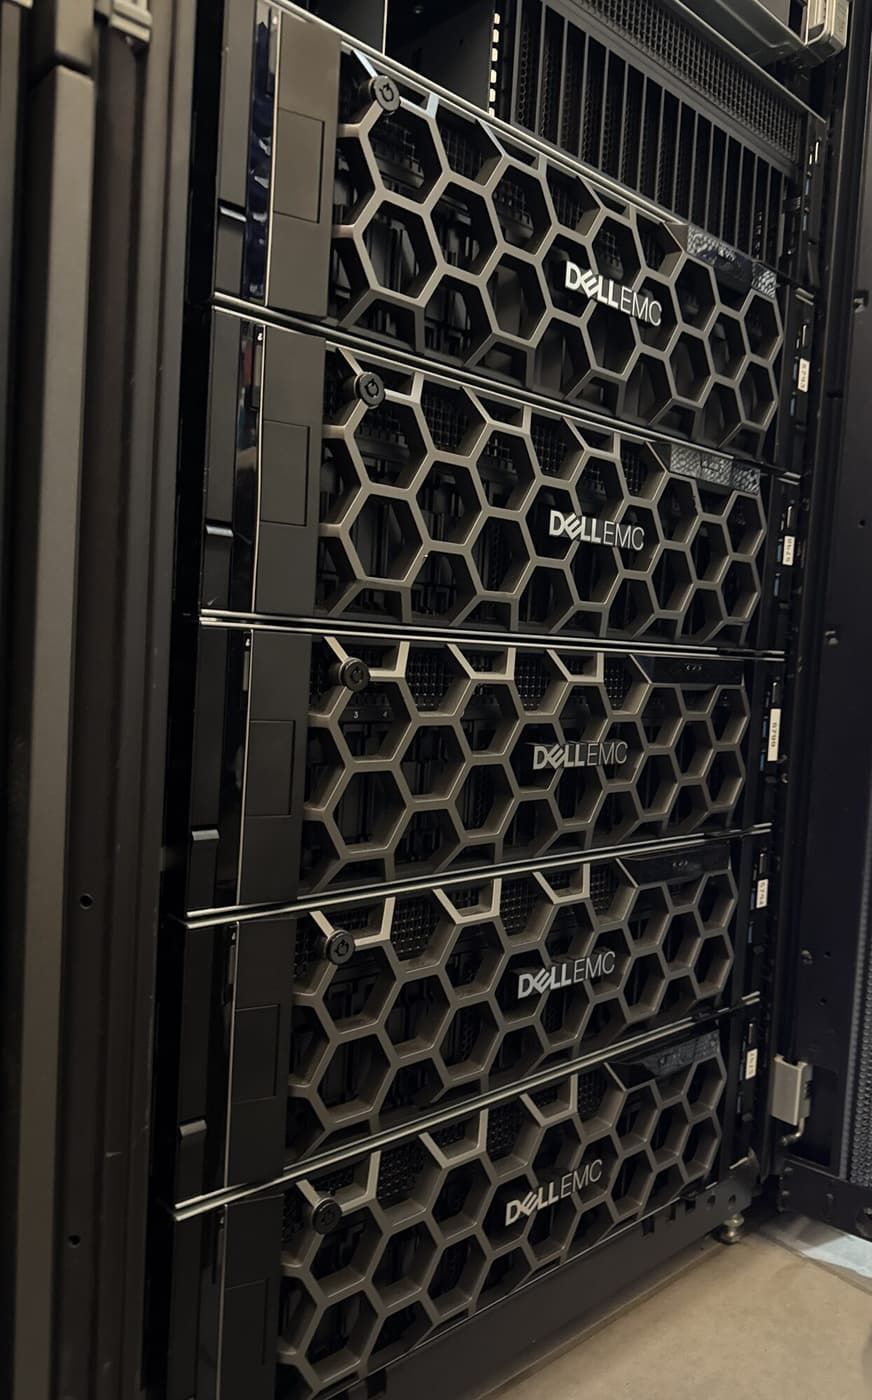
Η GPU που χρειάζεστε, στο datacenter μας, μέσα σε 48 ώρες: NVIDIA L4, L40, L40S, A100, H100 και άλλες. Τρέξτε open-weight μοντέλα για chat, αναζήτηση, εξαγωγή και ανάλυση σε hardware που είναι δικό σας να το χρησιμοποιείτε, ώστε τα εμπιστευτικά δεδομένα να μην πλησιάζουν ποτέ μια δημόσια υπηρεσία AI.
Τι είναι
Δύο πράγματα, που πωλούνται χωριστά ή μαζί. GPU servers: αποκλειστικά μηχανήματα με τους επιταχυντές NVIDIA που ζητά ο φόρτος εργασίας σας, σε enterprise πλατφόρμες HPE και Dell στα datacenters μας, με χρόνο παράδοσης 48 ωρών. Ιδιωτικό AI: ολόκληρο το stack χτισμένο πάνω τους, από model serving και embeddings έως vector search και retrieval με παραπομπές, σε λειτουργία από τους μηχανικούς μας, προσβάσιμο μόνο από το ιδιωτικό σας δίκτυο.
Πώς το χτίζουμε
Οποιαδήποτε τρέχουσα NVIDIA data center GPU. L4, L40, L40S, A100, H100 και οι υπόλοιπες της τρέχουσας γκάμας. Διαστασιολογούμε την κάρτα με βάση το μοντέλο και τον φόρτο εργασίας, όχι με βάση έναν κατάλογο: ένα quantised μεγάλο μοντέλο σε μία κάρτα για inference, περισσότερες κάρτες για training ή υψηλό throughput, μια μικρότερη κάρτα για embeddings δίπλα τους.
Χτισμένο με τον τρόπο του enterprise Linux. Kernel modules υπογεγραμμένα από τον κατασκευαστή, Podman με το NVIDIA container toolkit, SELinux σε enforcing.
Τυπικά APIs, ιδιωτικά endpoints. Τα μοντέλα σερβίρονται μέσω OpenAI-compatible endpoints σε απομονωμένο τμήμα δικτύου, ώστε οι εφαρμογές σας να αλλάζουν ένα base URL για να περάσουν από ένα δημόσιο API στα δικά σας μοντέλα. Τίποτα στη διαδρομή του περιεχομένου δεν καλεί εξωτερική υπηρεσία AI.
Retrieval που παραθέτει τις πηγές του. Για φόρτους εγγράφων και email συνδυάζουμε ένα embedding μοντέλο με μια vector database και ένα full-text index, ώστε οι απαντήσεις να θεμελιώνονται στα δικά σας έγγραφα και να παραπέμπουν πίσω σε αυτά. Τα pipelines μεγάλων εγγράφων κάνουν εξαγωγή σελίδα προς σελίδα, και μετά διασταυρώνουν το αποτέλεσμα με τις δικές του παραπομπές.
Storage που ακολουθεί. Τα βάρη των μοντέλων, τα datasets και τα αρχεία βρίσκονται στο all-flash SAN μας ή σε γρήγορο τοπικό NVMe, επιλεγμένο με μέτρηση.
Από τι σας προστατεύει
- Εμπιστευτικά δεδομένα (ιατρικά, νομικά, οικονομικά, προσωπικού) που φεύγουν από το κτίριο ή τη δικαιοδοσία.
- Έναν λογαριασμό ανά token που μεγαλώνει με κάθε επιτυχημένο μήνα.
- Έναν προμηθευτή AI που αλλάζει όρους, rate limits ή τιμές την καλύτερή σας μέρα.
- Μήνες αναμονής για χωρητικότητα GPU.
- Ένα AI endpoint εκτεθειμένο στο δημόσιο internet.
Στην πράξη
Ιατρικοί φάκελοι που αναλύθηκαν χωρίς να φύγουν από την Αθήνα. Χτίσαμε μια πλατφόρμα ιδιωτικού AI για έναν πελάτη που χρειαζόταν να αναλύει ιατρικούς φακέλους: οι φάκελοι ασθενών μπαίνουν, μια δομημένη αναφορά με παραπομπές βγαίνει, και κάθε βήμα τρέχει σε τοπικά μοντέλα μέσα στο Digital Realty Athens. Τα δεδομένα δεν αγγίζουν ποτέ public cloud.
Ένας εμπορικός φόρτος AI, αναπαραγμένος σε ιδιωτικές GPU. Για μια πλατφόρμα coaching, αναπαράγαμε το AI pipeline της από άκρη σε άκρη στο δικό μας hardware: επτά αναλυτικά περάσματα πάνω σε πραγματική απομαγνητοφώνηση συνεδρίας, δεκάδες δομημένα συμπεράσματα εξαγόμενα σε λιγότερο από ένα λεπτό, με αποτέλεσμα που ταίριαζε στενά με την εμπορική υπηρεσία με την οποία συγκρίθηκε, και χωρίς κόστος ανά κλήση.
Γιατί EuroVPS
- Οποιαδήποτε τρέχουσα NVIDIA data center GPU, παραδομένη σε 48 ώρες.
- GPU servers και ιδιωτικό AI στα datacenters μας σε Αθήνα και Άμστερνταμ, εντός ΕΕ.
- OpenAI-compatible endpoints, ώστε η απομάκρυνση από ένα δημόσιο API να είναι μία γραμμή κώδικα.
- Μηχανικοί που χτίζουν το stack των μοντέλων, το storage και το δίκτυο, όχι απλώς σας νοικιάζουν μια κάρτα.
- Σταθερά κόστη, χωρίς μετρητή ανά token.
Συχνές ερωτήσεις
- Ποιες GPU μπορώ να πάρω; Ό,τι χρειάζεται ο φόρτος εργασίας σας: L4, L40, L40S, A100, H100 και άλλες. Πείτε μας το μοντέλο και το throughput που χρειάζεστε και θα το διαστασιολογήσουμε.
- Πόσο χρόνο παίρνει; 48 ώρες.
- Πού βρίσκονται οι GPU servers; Στα datacenters μας σε Αθήνα και Άμστερνταμ.
- Μπορείτε να τρέχετε τα μοντέλα για εμάς, όχι απλώς να παρέχετε το hardware; Ναι. Αναπτύσσουμε, σερβίρουμε και λειτουργούμε open-weight μοντέλα και το retrieval stack γύρω τους.
- Θα χρησιμοποιηθούν τα δεδομένα μας για να εκπαιδευτεί κάτι; Όχι. Τα δεδομένα σας μένουν στο hardware σας στο datacenter μας. Τίποτα δεν στέλνεται σε εξωτερικό μοντέλο.
- Μπορούμε να συνεχίσουμε να χρησιμοποιούμε τον υπάρχοντα κώδικά μας; Συνήθως ναι. Τα endpoints μας μιλούν την ίδια μορφή API που χρησιμοποιούν ήδη οι περισσότερες εφαρμογές.
- closing line: Τα δεδομένα σας, τα μοντέλα σας, το datacenter μας. Μιλήστε με έναν μηχανικό για την GPU και το AI stack που χρειάζεστε.
- CTA: Μιλήστε με έναν μηχανικό
Ο επόμενος συνεργάτης σας στην υποδομή
Ας δούμε την υποδομή σας.
Πείτε μας τι τρέχετε σήμερα και τι χρειάζεται βελτίωση. Ένας μηχανικός θα εξετάσει το αίτημά σας και θα σας βοηθήσει να σχεδιάσετε το επόμενο βήμα.
+357 222 32280
Ας ξεκινήσουμε από την υποδομή σας.
Λίγο πλαίσιο μάς βοηθά να ξεκινήσουμε τη σωστή συζήτηση.