

Qué hacemos · Storage y cómputo: Disaster recovery y réplicas entre sedes
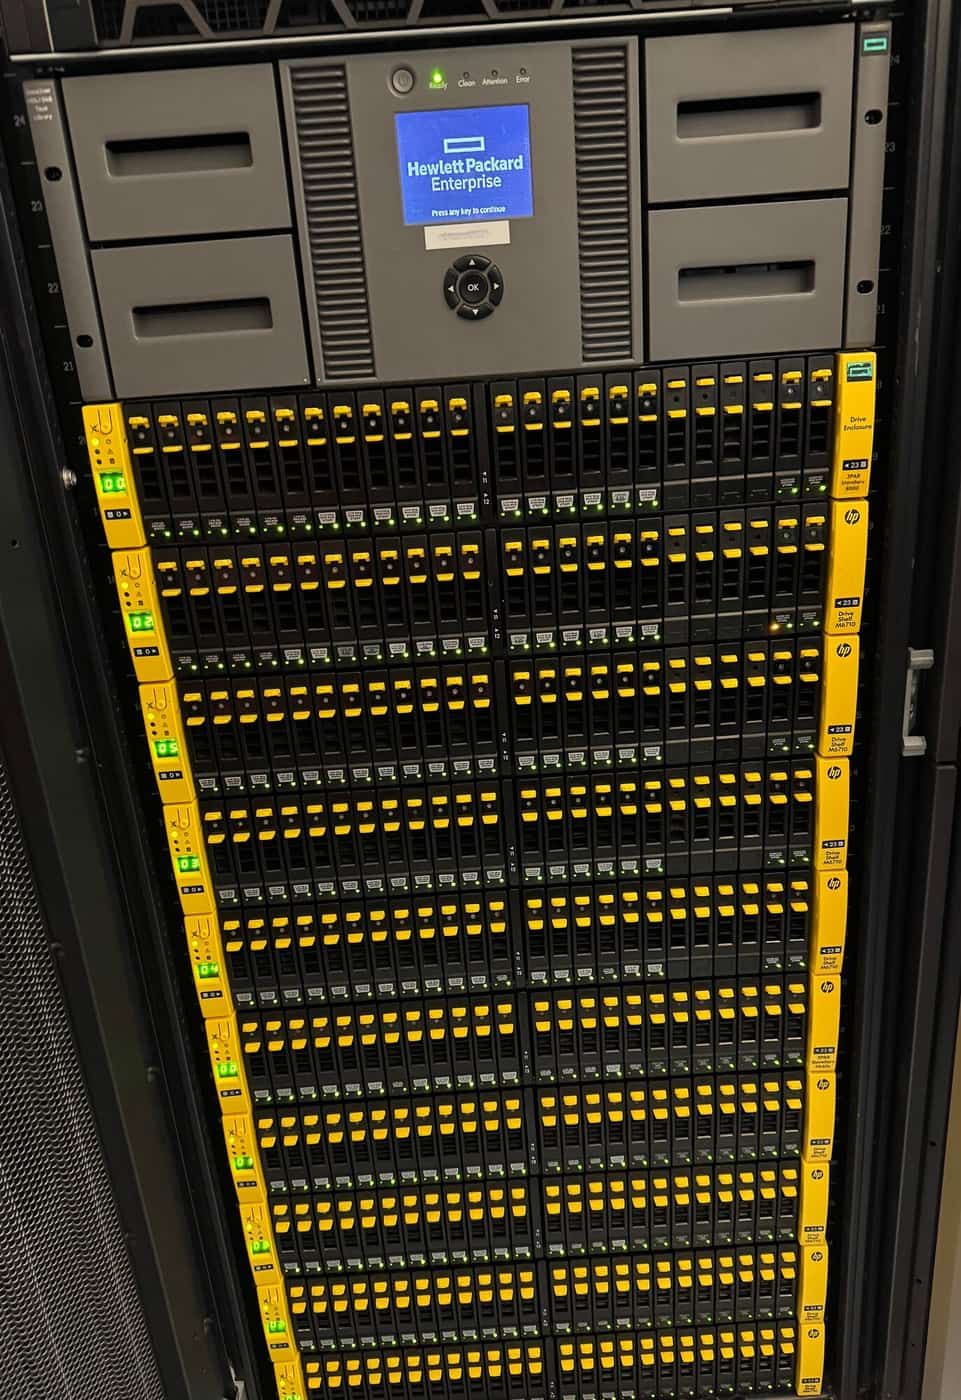
Para los sistemas críticos mantenemos una copia actualizada de forma continua en una segunda sede, de modo que la recuperación sea un failover y no una restauración, y diseñamos la ruta de replicación, la postura del firewall a su alrededor y la monitorización que nos avisa en el momento en que la copia se queda atrás.
Qué es
Un diseño de recuperación ajustado al servicio que contrata. Un servicio pequeño y sencillo recibe backups sólidos y un camino de vuelta probado. Una plataforma que no puede caerse recibe réplicas en vivo en otro datacenter, storage replicado entre cabinas y un front end que sigue sirviendo mientras el back end se recupera. El punto de recuperación y el tiempo de recuperación siguen al servicio, y los suyos los dejamos por escrito.
Cómo lo construimos
Réplicas de base de datos en vivo en una segunda sede. Una base de datos de producción se replica de forma continua, por identificador global de transacción, a una réplica de solo lectura en otro datacenter a través de nuestro backbone privado cifrado.
Pull-only, impuesto en el firewall. El lado protegido nunca empuja. Los sistemas de réplica y de backup entran en producción a tomar lo que necesitan, y los backups se toman a través de nuestra red out-of-band físicamente aislada (air-gapped), nunca a través de un segmento de producción; producción no tiene ruta de red hacia ellos ni credenciales para ellos. Solo nuestra red de gestión puede alcanzar los sistemas de recuperación, y todo lo demás está denegado de forma explícita en los appliances de firewall, no solo en los hosts.
Storage replicado entre países. Por debajo, los volúmenes pueden replicarse de cabina a cabina entre cabinas HPE 3PAR en Atenas y Ámsterdam, por puertos dedicados, de modo que ya existe una copia a nivel de bloque de su plataforma en el otro datacenter. Dentro de cada sede, los sistemas en clúster mantienen cada miembro en una cabina física distinta.
Los datos de la UE se quedan en la UE. Las réplicas y los backups de datos alojados en la UE permanecen dentro de nuestra infraestructura de la UE.
Cifrados en reposo, borrados con certificado. El cifrado en reposo está disponible por defecto. Los discos que salen de servicio se sanean con Blancco, y conservamos el certificado PDF de borrado de cada disco que borramos.
Vigilando el desfase. El estado de la replicación se comprueba cada pocos minutos, y cualquier cambio de estado, rota, retrasada o recuperada, genera una alerta a los ingenieros de guardia.
Sirviendo durante una caída del back end. Para las propiedades web públicas, la capa de caché se configura para seguir sirviendo contenido cuando la capa de aplicación está caída, de modo que un fallo del back end no se convierta en una caída pública mientras lo recuperamos.
Los backups debajo de todo
Hacemos backup de máquinas virtuales, servidores Linux y Windows en bare metal, servidores SQL y nodos cPanel y Plesk con Veeam, y de datos de ficheros y bases de datos Linux con un hub de backup con deduplicación que extrae por SSH usando claves restringidas de solo añadir (append-only). Los repositorios corren sobre XFS con clonado rápido y un nivel de repositorio bastionado que recibe los trabajos de copia. Las programaciones se fijan a partir de tiempos de ejecución medidos para que los trabajos grandes nunca colisionen, la cobertura se comprueba contra el inventario real, no contra el estado de los trabajos, y las restauraciones se prueban con regularidad, hasta semanalmente.
De qué le protege
- Perder su host de base de datos principal o su sede principal.
- Que un ransomware o un intruso borre sus backups desde el servidor comprometido.
- El desfase de las réplicas: el estado de cada réplica se comprueba cada pocos minutos.
- Que una caída de la aplicación se convierta en una caída pública.
- Huecos en la cobertura de backup: cada máquina que debe tener backup lo tiene, y lo comprobamos contra lo que está en ejecución.
En la práctica
Un sitio de noticias siguió sirviendo con el back end apagado. Para un editor de noticias configuramos la capa de caché para servir contenido obsoleto ante error durante un día entero, y después lo demostramos: el back end se marcó deliberadamente como caído y las páginas en caché siguieron devolviéndose con normalidad a los lectores.
Un clúster de base de datos diseñado para perder una cabina. Para un cliente de analítica, el volumen de datos de cada miembro del clúster se sitúa en una cabina física distinta, de modo que la pérdida de una cabina entera cuesta una réplica y la base de datos sigue sirviendo sin failover alguno.
Por qué EuroVPS
- Backup y replicación pull-only, impuestos en el firewall, sin excepciones.
- Recuperación diseñada y documentada por servicio.
- Réplicas y backups monitorizados por frescura, no asumidos.
- Replicación de cabina a cabina entre Atenas y Ámsterdam, con los datos de la UE dentro de la UE.
- Diseño alineado con ISO 27001, NIS2 y las directrices NIST sobre protección de perímetro.
Preguntas frecuentes
- ¿Qué RPO y RTO obtengo? Depende del servicio que contrate. Los servicios básicos reciben backups y una ruta de restauración definida; los servicios con cobertura entre sedes reciben réplicas en vivo y failover. Los suyos los dejaremos por escrito.
- ¿Por qué pull-only? Si producción pudiera empujar hacia el backup, un atacante en producción podría alcanzar el backup. Con pull-only, esa ruta no existe.
- ¿Puede mi réplica vivir en otro país? Sí. Atenas y Ámsterdam se replican entre sí, de cabina a cabina y de base de datos a base de datos, por nuestra propia red privada. Los datos alojados en la UE se quedan dentro de nuestra infraestructura de la UE.
- ¿Prueban las restauraciones? Sí, con regularidad, hasta semanalmente, y comprobamos la cobertura contra lo que de verdad está en ejecución, no contra lo que dice el trabajo de backup.
- ¿Están mis datos cifrados en reposo? Sí, por defecto. Y cuando un disco sale de servicio se sanea con Blancco, con un certificado de borrado conservado para ese disco.
- closing line: La recuperación se diseña antes del mal día, no durante. Hable con un ingeniero sobre lo que necesitan sus servicios.
- CTA: Hable con un ingeniero
Su próximo socio de infraestructura
Veamos su infraestructura.
Cuéntenos qué ejecuta hoy y qué necesita mejorar. Un ingeniero revisará su solicitud y le ayudará a planificar el siguiente paso.
+357 222 32280
Empecemos por su infraestructura.
Un poco de contexto nos ayuda a empezar la conversación adecuada.