

Soporte gestionado: Las personas que lo montan en el rack
responden a su ticket.
- Nuestra mediana de primera respuesta a un ticket de cliente en los últimos doce meses.
- Tres minutos
- La proporción de tickets resueltos en una hora, en todo nuestro historial de tickets.
- 87%
- Ingenieros de turno las 24 horas, todos los días del año.
- 24/7/365
Medido a partir de nuestros propios registros de tickets, contando una respuesta de un ingeniero, no un acuse de recibo automático.
Ingeniería 24/7Personas de turno las 24 horas
Un ingeniero con nombreAlguien es responsable del siguiente paso
Gestión incluidaEn todos los productos managed
Del sistema operativo al hardwareEl equipo detrás de todo el stack
Cuando algo necesita atención
Una conversación con
las personas que hacen el trabajo.
Una alerta puede abrir la conversación. Usted también. En cualquier caso, el ingeniero que lo examina puede trabajar en el servidor, el storage y la red que hay detrás.
Muchos tickets empiezan por nosotros: la monitorización abre la conversación antes de que usted lo note.
El trabajo de cada día
La mayor parte del soporte es
cuidar de los detalles.
Un servidor parcheado. El correo funcionando. Un certificado renovado. El trabajo operativo habitual forma parte del servicio desde el primer día.
Paneles de control
Administración de cPanel, WHM y Plesk. Cuidamos del panel, investigamos problemas de cuentas y acordamos el software que necesita su infraestructura.
Seguridad y limpieza
Hardening del servidor, investigación de malware y limpieza manual. La monitorización del spam saliente nos ayuda a encontrar cuentas comprometidas.
Entrega de correo
SPF, DKIM, colas de correo y salida de blacklists. Ayuda con los servicios de los que dependen su equipo y sus clientes cada día.
Actualizaciones del sistema operativo y del stack
Parcheo y actualizaciones de seguridad, con ventanas de mantenimiento acordadas en torno a su carga de trabajo. También planificamos cambios mayores de sistema operativo.
DNS y certificados
Configuración de DNS, DNS inverso e instalación y renovación de SSL. El trabajo en torno al sitio web también forma parte de la gestión.
Monitorización e investigación
Observium, Graylog, Percona PMM y Zabbix, con ingenieros detrás que pueden investigar la infraestructura que hay tras una alerta.
Cuando el trabajo va más a fondo
El mismo equipo.
Hasta el final.
Los problemas de infraestructura rara vez se detienen en una sola capa. Nuestros ingenieros pueden seguirlos desde el entorno de la aplicación hasta los sistemas que hay debajo.
Una migración planificada
Inventario, construcción del destino, validación y un cutover acordado. Nuestros ingenieros ejecutan la migración y mantienen una ruta de rollback en el plan.
Migraciones gestionadasStorage hasta el fabric
El equipo que opera su servidor también opera nuestras cabinas HPE 3PAR y nuestros dobles fabrics Brocade Fibre Channel.
Nuestra plataforma de storageUna recuperación para la que puede prepararse
Backups offsite y planificación de la recuperación en torno a sus datos. La retención, las pruebas de restore y cualquier alcance de DR entre sedes se acuerdan con usted.
Backups y recuperaciónRendimiento en todo el stack
Investigación en el sistema operativo, la base de datos, el servidor web y la red. Damos a sus desarrolladores hallazgos sobre los que pueden actuar.
Dimensionamiento para la carga de trabajoUna red que operamos nosotros
Nuestro propio AS200477, BGP y nuestras conexiones upstream. Los ingenieros que examinan un problema de enrutamiento trabajan con la propia red.
Dentro de nuestra redUn perímetro gestionado
Política de firewall dedicada y separación de red para su entorno, con los cambios y la gestión continua a cargo de nuestro equipo.
Managed firewallsQuién responde
Ingenieros
en cada paso.
Las personas que responden a sus tickets son ingenieros con acceso a su plataforma, el mismo equipo que la diseña, la construye y la opera. Pueden conectarse, leer los logs y corregir el problema, no solo registrarlo y pasarlo a otro.
Cuando un asunto necesita un especialista, va directamente al ingeniero que conoce esa parte de su plataforma, con todo el contexto adjunto, para que nunca tenga que explicarlo dos veces.
Si su servicio incluye un acuerdo contractual de primera línea, por ejemplo un partner que atiende a sus propios usuarios finales, funciona exactamente como se acordó, y todo lo que llega a nosotros termina en manos de un ingeniero.
En la sala. En el ticket.
La infraestructura es nuestra.
También la responsabilidad.
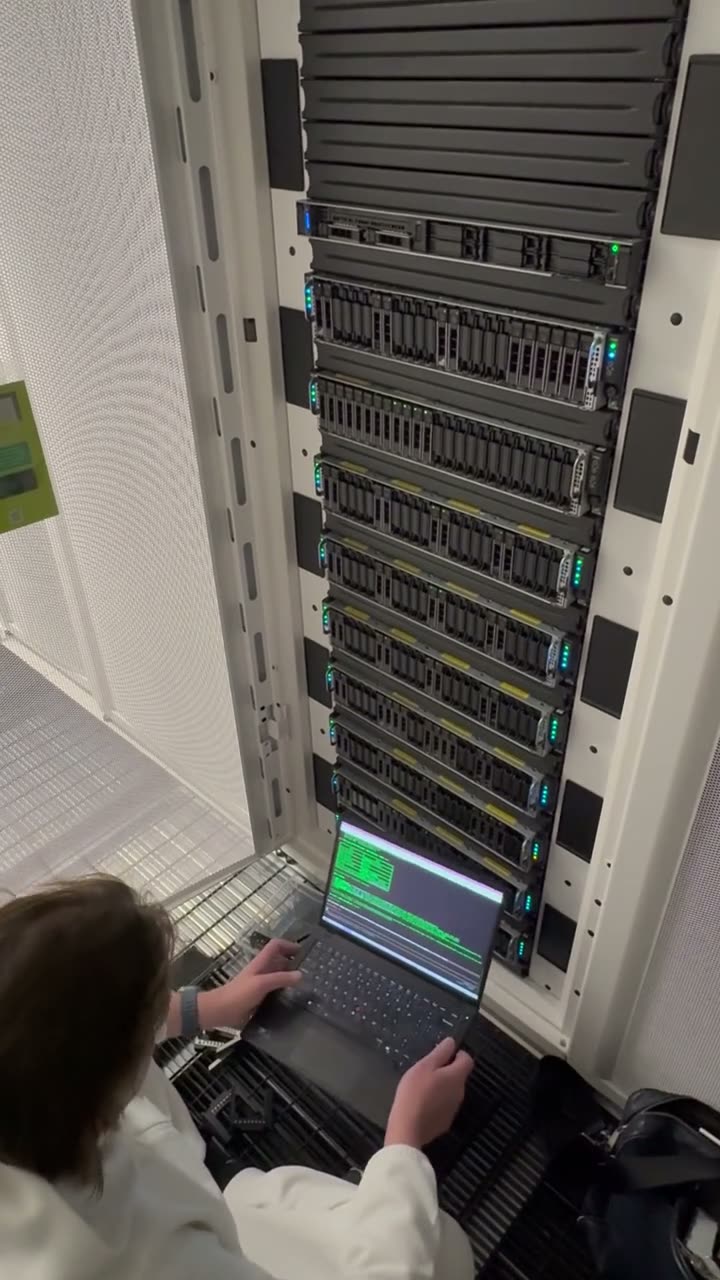
El equipo que responde a su ticket también monta el hardware en los racks, opera la red y trabaja en la consola cuando un servidor necesita atención.
Cada ticket
Cómo trabajamos.
Minutos, no horas.
Mediana de primera respuesta de tres minutos en el último año. 87% de los tickets resueltos en una hora en todo nuestro historial. Los tickets de hardware se responden normalmente en menos de diez minutos.
A menudo abrimos nosotros el ticket primero.
Nuestra monitorización vigila sus servidores, su ruta de red y sus páginas reales. Cuando algo parece ir mal, empezamos a trabajar y se lo decimos, con frecuencia antes de que lo note.
Una persona con nombre en cada respuesta.
Cada respuesta va firmada por el ingeniero que la escribió.
Un canal directo para plataformas más grandes.
Los clientes con plataformas más grandes o complejas pueden tener un canal de chat dedicado con nuestros ingenieros, junto al sistema de tickets.
Respuestas con pruebas.
Cuando pregunta qué ocurrió, recibe una cronología a partir de nuestra monitorización, logs y telemetría, no una suposición.
Cambios hechos con cuidado.
Si un cambio puede afectar a su tráfico, acordamos primero con usted el momento.
Proactivos, las 24 horas
Le llamamos nosotros,
no al revés.
Nuestro NOC vigila cada servidor y clúster de cliente las 24 horas, con la monitorización sobre la que corre nuestra propia plataforma: hosts, servicios, storage, rutas de red y los puertos de aplicación que le importan. Cuando algo se degrada, un ingeniero actúa primero y le informa después: el fallo se investiga y se repara, y usted recibe un ticket saliente, o un mensaje en su canal privado de Mattermost si su cuenta tiene uno, que describe qué se encontró y qué se hizo. Cada incidente produce además un informe escrito en PDF: qué ocurrió, qué se reparó, qué se hizo por nuestra parte y lo que queda abierto por la suya, por ejemplo un cambio que sus desarrolladores deban hacer en la aplicación, con el plan de acción para cerrarlo.
La misma disciplina se aplica a las vulnerabilidades. Cuando se publicó PHP2Shell, y antes las vulnerabilidades del kernel de Linux publicadas como Copy Fail, Dirty Frag, GhostLock, Bad Epoll, Januscape y OVSwrap, la condición de carrera de ssh-keysign, la vulnerabilidad del módulo rewrite de nginx y los avisos de los plugins de Plesk y LiteSpeed, nuestros ingenieros desplegaron las correcciones en todos los servidores managed a medida que se verificaban y comprobaron que las aplicaciones alojadas volvían limpiamente. Donde los paquetes de la distribución aún no habían salido, construimos y firmamos nosotros mismos los paquetes parcheados y los desplegamos como solución provisional, y los sustituimos por las compilaciones del fabricante cuando llegaron. A cada cliente se le informó de qué se parcheó, cuándo y cómo se verificó.
Cómo es en la realidad
En la práctica.
Una pregunta a última hora de la noche, respondida en una hora.
La noche en que una vulnerabilidad de seguridad crítica se parcheaba en todo internet, el desarrollador de un cliente preguntó si sus servidores estaban cubiertos. En una hora tenía su respuesta: todos ellos parcheados, con el mismo número de sitios en funcionamiento antes y después.
Un canal dedicado que lleva años funcionando.
Uno de nuestros clientes más grandes trabaja con nuestros ingenieros a través de un canal de chat dedicado desde hace años, junto al sistema de tickets. Las preguntas del día a día, los cambios planificados y los asuntos urgentes llegan directamente a las personas que operan la plataforma.
Un editor de noticias de ámbito nacional, con soporte allí donde están sus lectores.
El editor se trasladó a Digital Realty Athens, cerca de los lectores que forman casi toda su audiencia, y recibe soporte de los mismos ingenieros que construyeron allí su plataforma.
Soporte en tiempo real en Mattermost
Hable con los ingenieros que operan
su plataforma, en el momento en que ocurre.
Los tickets son la forma en que todo cliente de EuroVPS nos contacta, y los responden ingenieros, no un guion. Cuando su equipo quiere algo más, le damos un canal privado de Mattermost con nuestros ingenieros dentro: usted escribe, un ingeniero responde y la conversación queda registrada junto al historial de su plataforma. Sin menú telefónico, sin cola, sin «ya le llamaremos».
Incluido
Con nuestras ofertas de clase enterprise: el private cloud, los clústeres dedicados y las plataformas managed vienen con soporte en Mattermost para su equipo.
Disponible en cualquier plan
Como complemento a 300 € por usuario al mes, desde una sola máquina virtual hasta un servidor dedicado.
En nuestra propia plataforma
Corre en nuestro propio Mattermost, alojado en nuestros propios datacenters, con su canal visible solo para su equipo y nuestros ingenieros.
Añada soporte en tiempo real Cómo funciona nuestro team chat
Los detalles prácticos
Qué esperar
de su equipo.
Hable de responsabilidades, escalado y el alcance de su infraestructura con los ingenieros que cuidarán de ella.
Pregunte a un ingenieroEn los últimos doce meses nuestra mediana de primera respuesta fue de tres minutos, y en todo nuestro historial el 87% de los tickets se resolvieron en una hora. Se miden a partir de nuestros propios registros de tickets y cuentan una respuesta de un ingeniero, no un acuse de recibo automático. Los compromisos contractuales de respuesta forman parte de su acuerdo de servicio. Pídanos las condiciones que encajen con su plataforma.
Su próximo socio de infraestructura
Hable con la persona
/ que realmente lo arreglará.
Díganos qué ejecuta y dónde necesita soporte su equipo. Repasaremos con usted la infraestructura, el alcance de la gestión y el siguiente paso.
Clientes actuales: abran un ticket en el área de cliente, 24/7Hable con un ingeniero
Empecemos por su infraestructura.
Un poco de contexto nos ayuda a empezar la conversación adecuada.
Del equipo de ingeniería