

Depuis 2004: Sans compromis
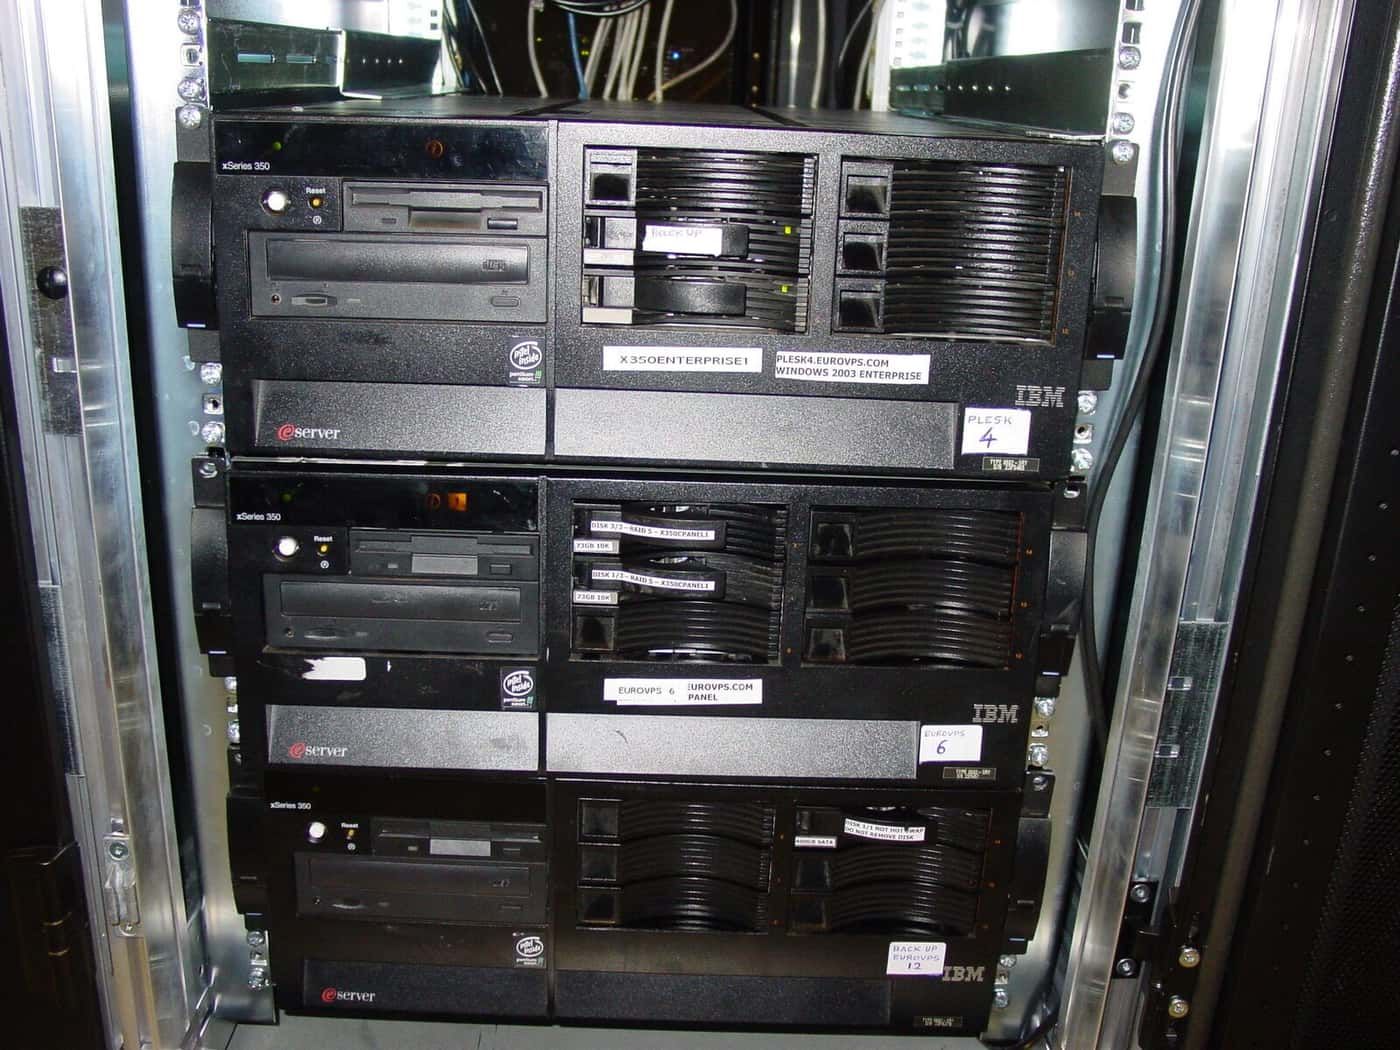
En 2004, EuroVPS, c'était une machine. Pas une machine bon marché.
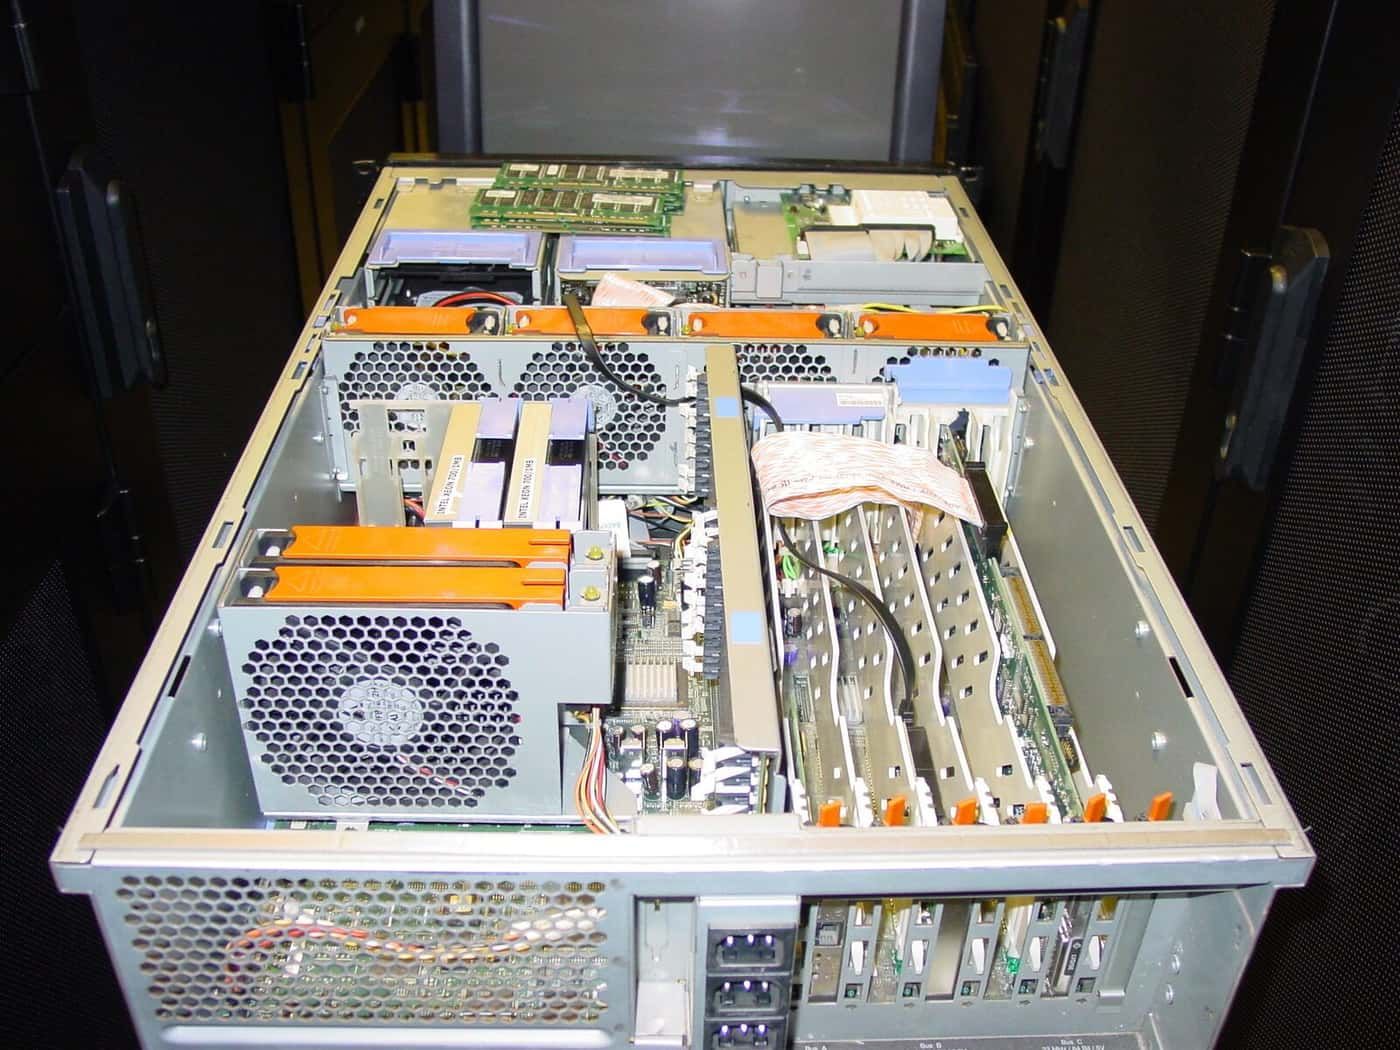
C'était un IBM xSeries 350 : un serveur à quatre sockets, de classe entreprise, acheté comptant et porté à la main dans une salle de colocation à Amsterdam. La machine la moins chère qui aurait fait le travail coûtait une fraction de ce que nous avons payé. Nous avons acheté le xSeries quand même, et la raison est la seule politique d'entreprise que nous ayons jamais eue : on commence avec la meilleure machine qu'on peut se permettre, pas avec la moins chère qui fonctionne.
Plesk tournait dessus. Les étiquettes que nous avons imprimées pour la façade de cette première pile sont encore lisibles sur les photographies : le nom d'hôte sur chaque machine, la disposition RAID sur les emplacements de disques, et un châssis marqué BACK UP. Un serveur, déjà étiqueté emplacement par emplacement, avec une machine séparée qui prenait déjà les backups. Rien dans notre façon de travailler aujourd'hui n'est une invention tardive. Ce sont les mêmes habitudes, avec plus de matériel.
Les années Amsterdam
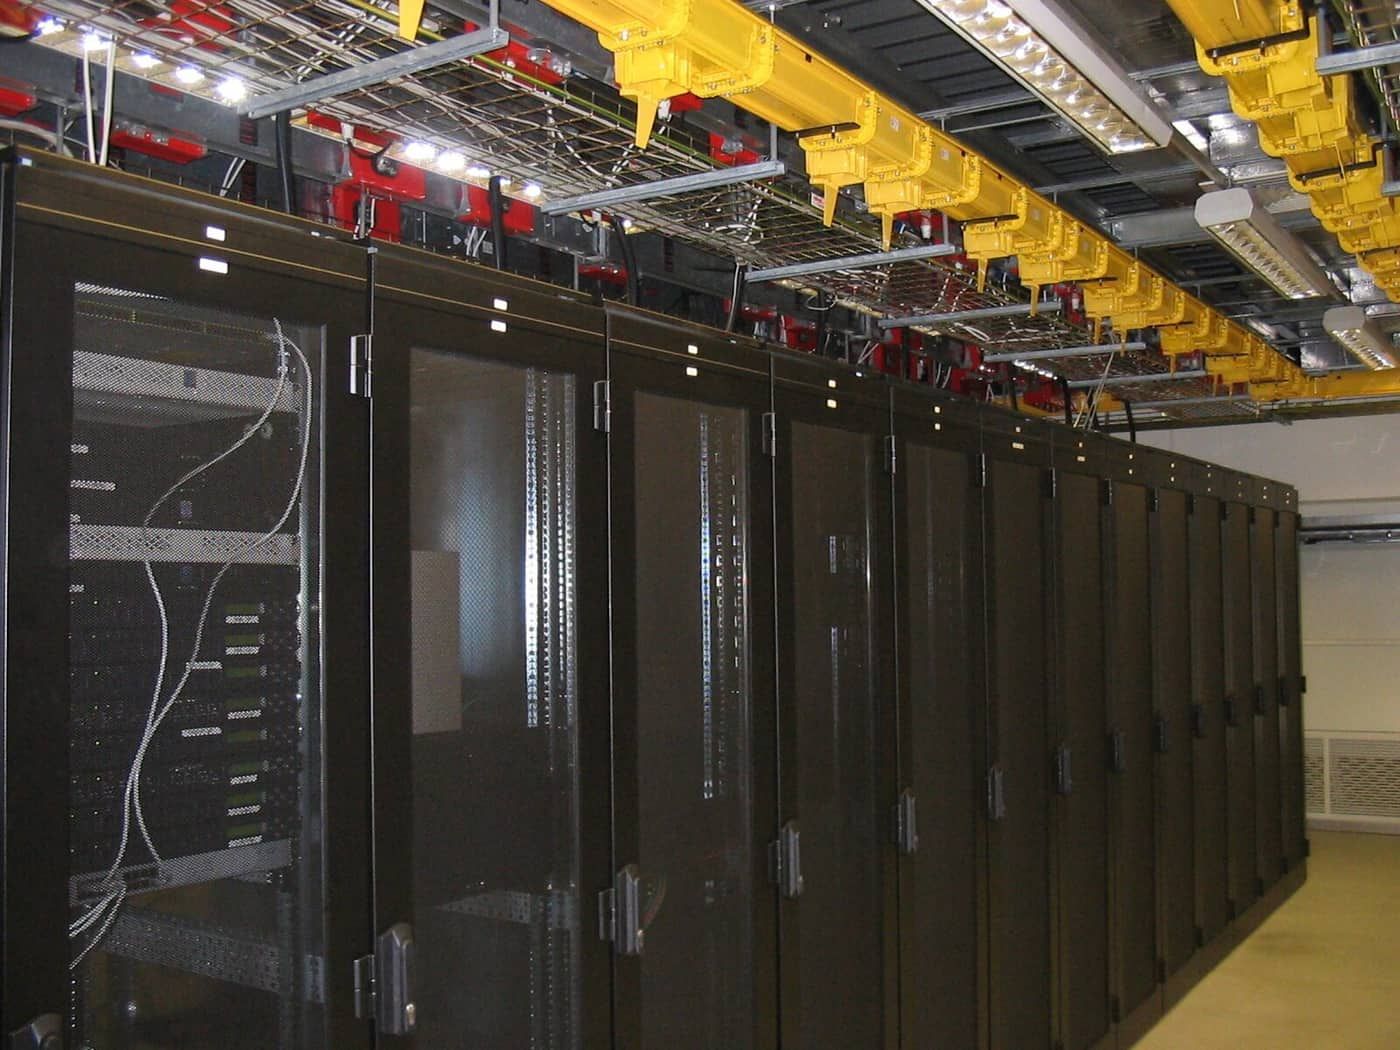
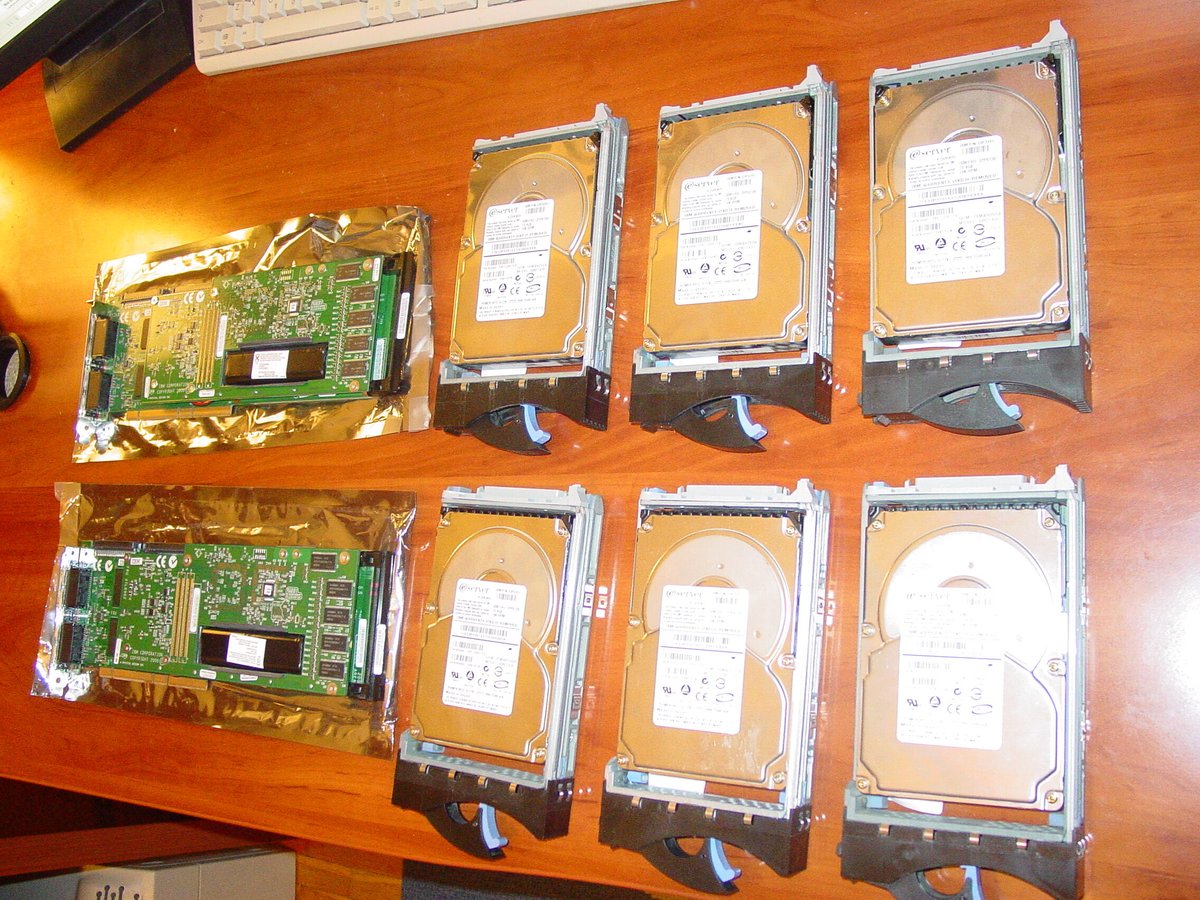
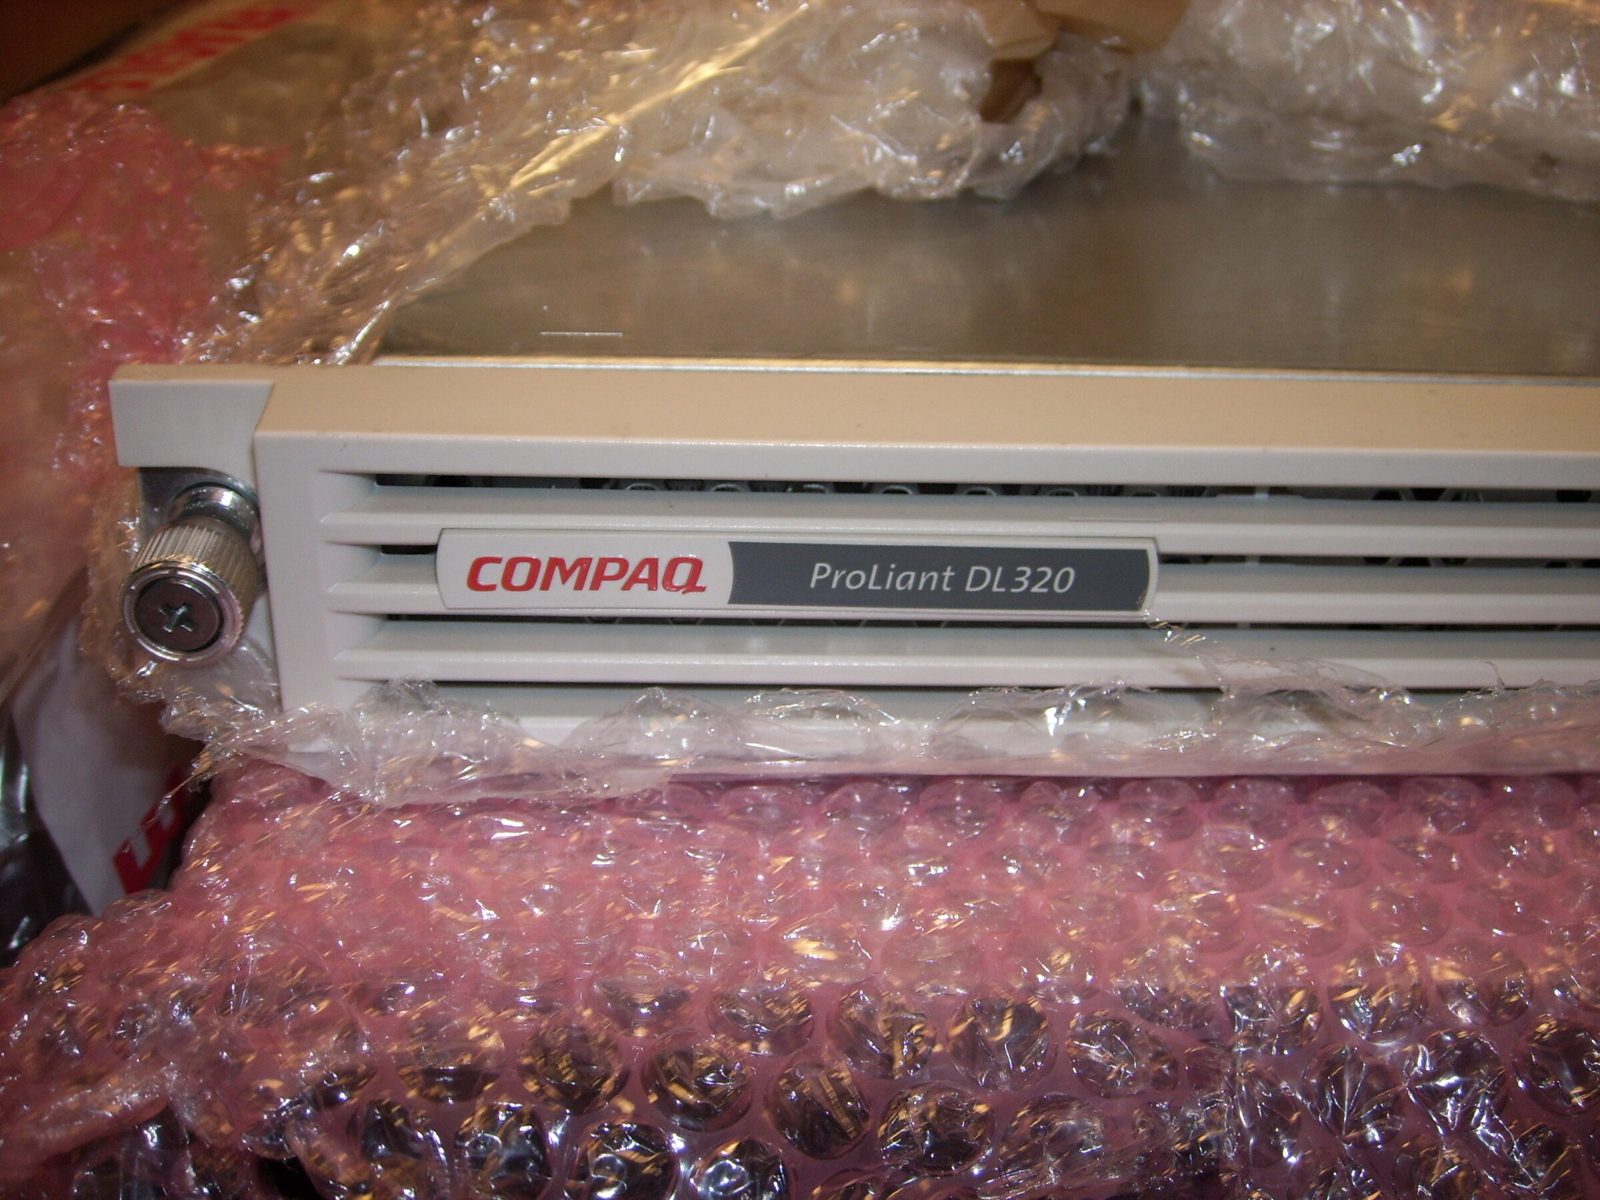
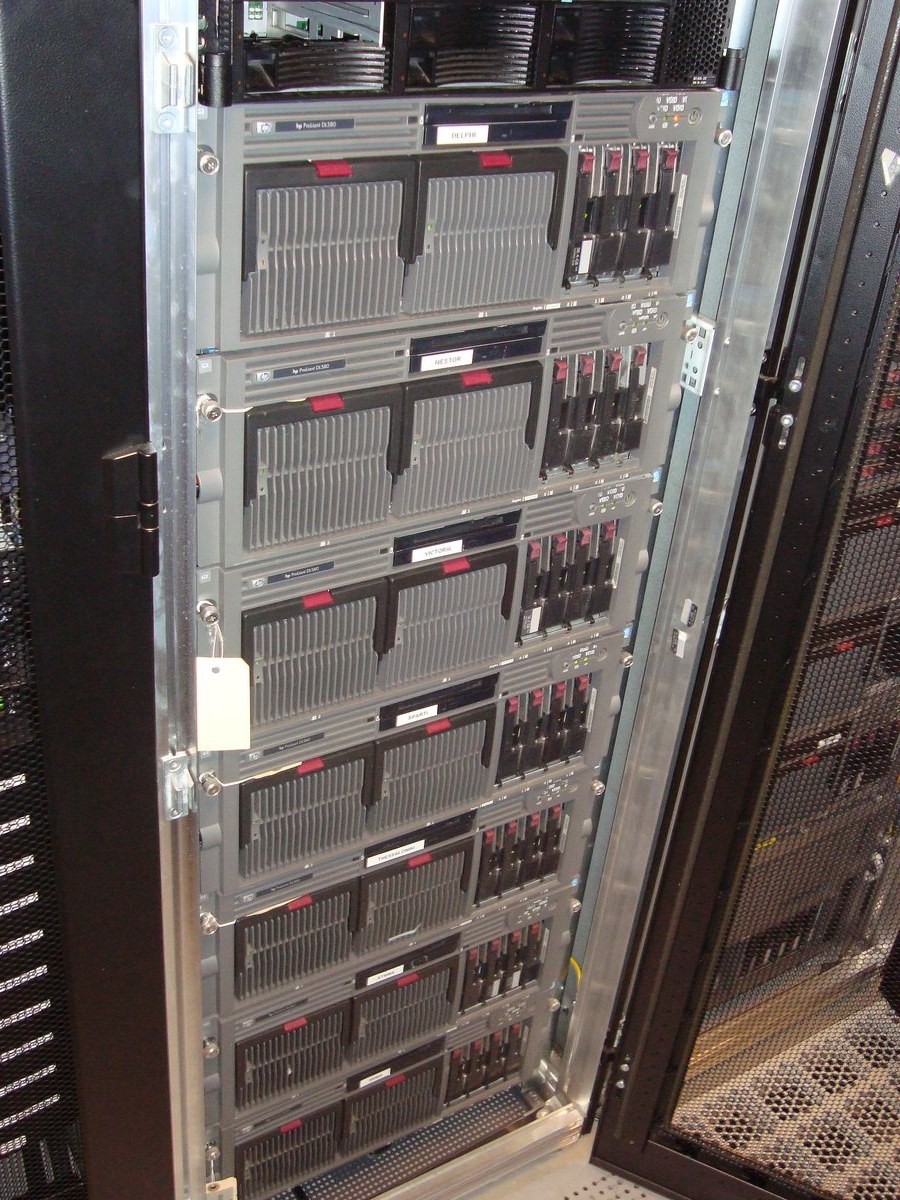
Les premières années, c'était une allée, un chariot de dépannage et un ordinateur portable posé par terre. IBM xSeries d'abord, puis Compaq et HP ProLiant côte à côte pendant la majeure partie de la décennie, achetés neufs et déballés entre les baies. Le stockage est passé tôt sur des baies d'entreprise, EMC CLARiiON sur des fabrics Fibre Channel doubles, avec du Cisco au cœur, parce que nous préférons payer le second chemin plutôt que d'expliquer un jour pourquoi il n'y en avait pas. Les châssis de blades ont suivi, puis des colonnes entières, et le parc a grandi jusqu'à nos propres cages chez Iron Mountain.

Athènes, Amsterdam, Toronto
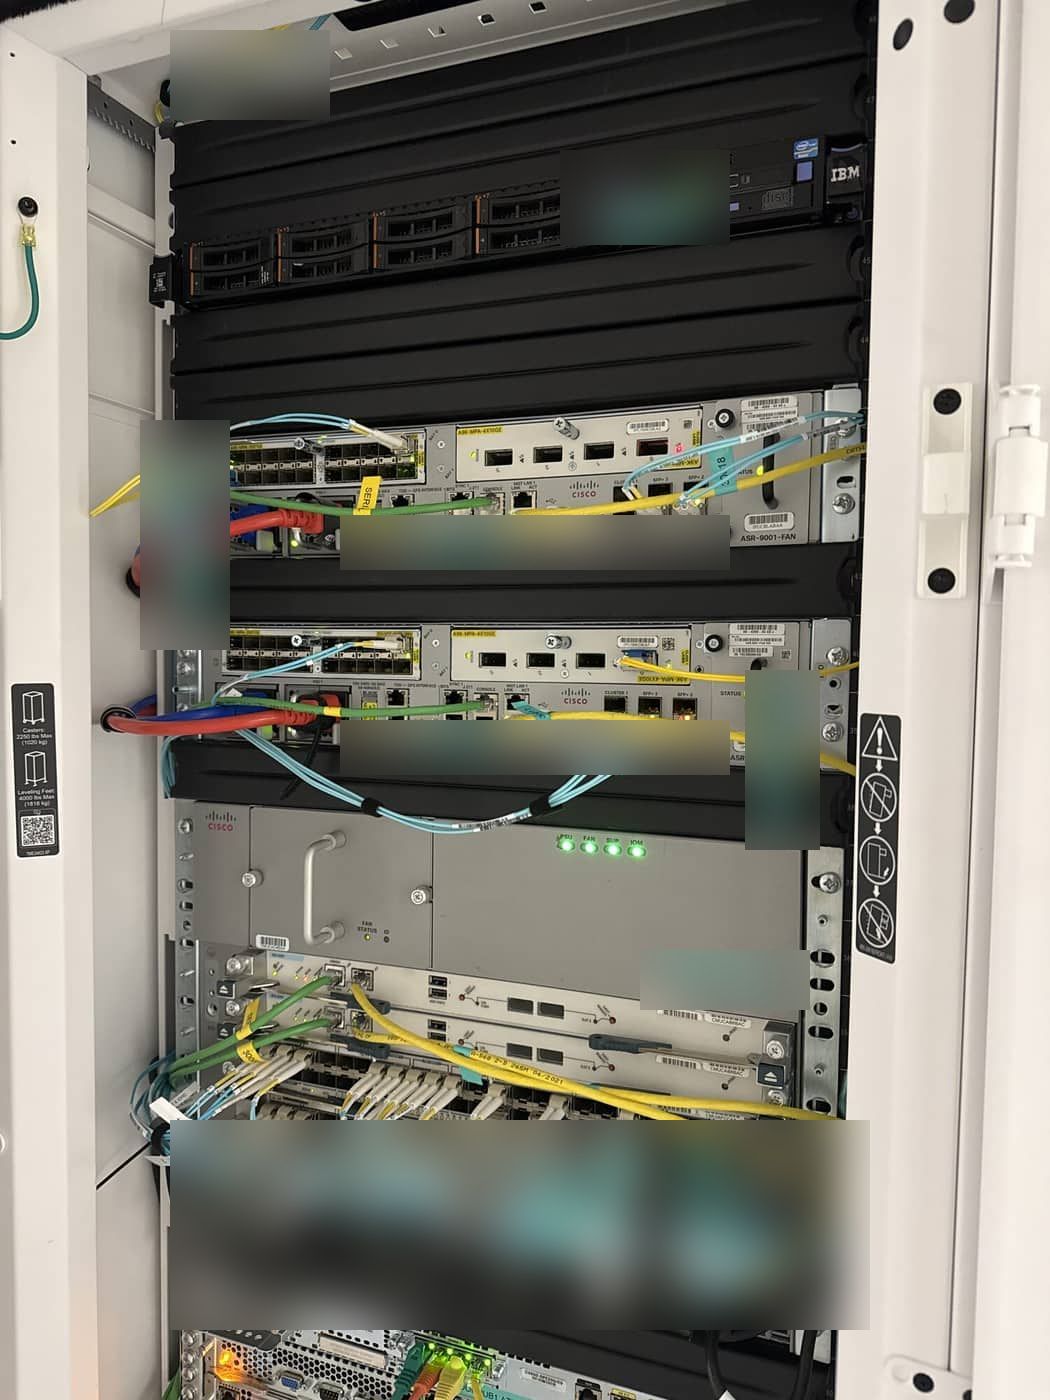
Le vaisseau amiral aujourd'hui, c'est notre propre cage chez Digital Realty Athens : nos propres routeurs, du stockage all-flash, de la fibre sur chaque port, construite comme le premier rack a été construit, par nous. Amsterdam continue, relié à Athènes par un Layer 2 privé, pour que les deux se comportent comme un seul réseau et que vous puissiez passer de l'un à l'autre sans rien renuméroter. Toronto couvre l'Amérique du Nord depuis Cogent. Notre siège social est à Chypre.

Un seul système d'exploitation, sur tout le parcours
Notre premier serveur tournait sous Red Hat Enterprise Linux, et nous y sommes restés à chaque version majeure depuis. Pas parce que c'était à la mode : un système d'exploitation avec un cycle de vie publié, des paquets signés, SELinux en mode enforcing et un éditeur qui se tient derrière chaque mise à jour, c'est la décision que nous n'avons jamais à revoir.
Deux décennies sur une seule plateforme, c'est en soi une forme d'investissement. Chaque build, chaque règle de durcissement et chaque runbook de mise à niveau que nous possédons a été écrit une fois et amélioré depuis, au lieu d'être jeté avec chaque nouvelle distribution du mois.
Nous avons aussi rendu la pareille. Dès 2005, nous avons exploité un miroir public pour le projet CentOS, gratuitement, depuis notre propre réseau, pour que n'importe qui dans le monde puisse installer et mettre à jour CentOS sur la bande passante d'EuroVPS.
Oui, nous sponsorisons un bureau. Nous donnons actuellement trois serveurs HPE ProLiant au projet KDE. Nos ingénieurs font tourner KDE Plasma sur Red Hat Enterprise Linux depuis plus longtemps que certains de nos clients n'existent. Quand les gens qui choisissent le matériel tiennent autant à un outil, l'outil reçoit des serveurs.
La qualité avant le profit
Nous venons d'une époque d'avant que la maximisation des marges ne devienne le mantra.
EuroVPS n'a pas de capital-risque, pas d'investisseurs extérieurs et pas de plan de sortie. Personne ne nous a jamais dit de retirer un coût d'une plateforme pour embellir un trimestre, parce qu'il n'y a pas de trimestre à embellir ni personne pour qui l'embellir. L'entreprise est dirigée par les gens qui l'ont construite, serveur après serveur, de leurs propres mains.
Ce n'est pas du sentiment, c'est un processus de décision. Chaque choix technique ici se tranche sur le mérite technique et sur ce qu'il nous coûtera d'être réveillés, pas sur ce qu'il fait à une marge. Quand une société d'hébergement prend de l'argent extérieur, elle doit un jour rendre quelque chose, et ce qui est rendu est presque toujours la partie que vous ne voyez pas : la seconde alimentation, l'optique d'origine, la pièce de rechange sur l'étagère, l'ingénieur senior à trois heures du matin. Nous avons gardé les quatre, parce que les gens qui décident ici sont ceux qui reçoivent l'alerte.
Ce que nous refusons d'acheter
Nous sommes une société d'hébergement, le matériel n'est donc pas une ligne de coût que nous essayons de réduire. C'est le produit. Presque tout ce qui rend l'hébergement bon marché bon marché se résume à une courte liste de composants, et aucun d'eux ne passe sous une charge de travail de nos clients.
Disques SATA
Un port, un chemin, un contrôleur : un point de défaillance unique par construction, et aucune couche logicielle au-dessus ne peut inventer un second chemin. SATA a une file peu profonde et se remet mal des erreurs, si bien qu'un disque de classe bureautique peut rester à réessayer un secteur faible pendant que tout ce qui est au-dessus attend. Le SAS d'entreprise a deux ports, rapporte honnêtement ses compteurs d'erreurs et rend la main assez vite pour que la couche RAID fasse son travail.
SSD SATA
Même port unique, même file peu profonde, sur une interface conçue pour des disques rotatifs. Mettre du flash derrière du SATA, c'est payer le support puis jeter l'essentiel de ce qu'il offre. Ce marché est aussi massivement grand public : faible endurance, pas de second port, souvent aucune protection contre les coupures de courant.
Barrettes M.2 NVMe grand public
Les barrettes grand public n'embarquent généralement pas de condensateurs de protection contre les coupures, si bien qu'une écriture en cours quand le courant disparaît est une écriture que vous ne reverrez peut-être jamais, et leur endurance est spécifiée pour un poste de travail, pas pour une base de données qui écrit toute la journée. Nous faisons tourner beaucoup de NVMe, sous forme de disques d'entreprise U.2 et U.3 avec protection contre les coupures, dans des tiroirs hot plug. Jamais sous forme de barrette collée à une carte qui détient l'unique copie.
Cartes mères mono-socket de classe bureautique
Un socket, une alimentation, pas de gestion out-of-band digne de ce nom, et trop peu de lignes PCIe pour porter à la fois un HBA Fibre Channel à deux ports et un réseau redondant. Pas de fond de panier hot plug non plus, si bien que chaque panne de composant est une extinction. La conception dit une chose : si ceci casse, le service reste cassé jusqu'à ce que quelqu'un prenne la voiture.
Une alimentation unique
Une seule alimentation transforme les travaux planifiés du datacenter en interruption pour le client.
Mémoire sans ECC
Nous ne ferons pas tourner une charge de travail sur une mémoire incapable de nous dire qu'elle est en train de défaillir.
Le RAID logiciel comme récit de résilience, et les serveurs white box
Nous ne posons pas les données des clients sur le RAID logiciel d'une seule machine, avec un cache d'écriture non protégé et une parité reconstruite sur le CPU de l'hôte. La résilience appartient à la baie et aux fabrics redondants, où elle survit à la perte entière du serveur. Le white box reçoit la même réponse : pas de cycle de vie du firmware, pas de pièces sur l'étagère, personne à appeler.
En pratique. Nous ne prenons rien pour acquis d'après un nom de périphérique ou une valeur par défaut du noyau : nous interrogeons le contrôleur RAID et les disques directement, par deux chemins indépendants, et nous réglons d'après ce que chaque périphérique rapporte réellement.
Ce que nous achetons à la place
HPE ProLiant et Dell PowerEdge : ProLiant DL380 Gen10 et Gen11, DL385 Gen11 et blades BL460c Gen10 ; PowerEdge R740, R750 et R7525, et C6400 pour le calcul dense. La même base sur chacun d'eux.
- Deux alimentations hot plug sur deux arrivées indépendantes.
- De la mémoire ECC partout, avec les compteurs d'erreurs corrigibles surveillés.
- Du RAID matériel avec cache d'écriture secouru par batterie ou par flash partout où un serveur garde des disques locaux, pour qu'un incident électrique ne puisse pas coûter une écriture acquittée.
- Des SSD SAS 12G d'entreprise et du NVMe d'entreprise, placés là où la mesure dit qu'ils ont leur place.
- Une gestion out-of-band sur chaque machine, sur un réseau de gestion totalement isolé (air-gapped), routé par son propre système autonome, entièrement séparé.
Des hôtes qui démarrent depuis le SAN et ne gardent rien
Nos hyperviseurs démarrent depuis un volume sur la baie, présenté sur deux fabrics Fibre Channel physiquement séparés. Le serveur lui-même ne détient aucune donnée client, si bien qu'un blade en panne nous coûte un blade : le remplaçant démarre le même volume. C'est un échange de pièce, pas une récupération de données.
Des machines qui ne franchissent jamais un socket
Règle de la maison, et non négociable : une machine virtuelle ne reçoit jamais plus de vCPU qu'un socket n'a de cœurs physiques, et jamais plus de mémoire qu'un nœud NUMA n'en sert. Étalez-la sur deux sockets et une partie du trafic mémoire devient distant, à environ 1,7 fois la latence locale, avant même le trafic de cohérence de cache sur l'interconnexion entre sockets. La pénalité se cumule au lieu de se lisser, et c'est pourquoi une machine dimensionnée au-delà de la frontière du socket tourne souvent plus lentement que la plus petite qu'elle a remplacée.
Le flash d'entreprise n'est pas de la RAM
Nos machines virtuelles n'ont pas de swap. Le swap sur une VM pousse la pression mémoire vers la baie et consomme une endurance d'écriture flash qui existe pour servir de vraies données. Si une application a besoin de plus de mémoire, la réponse honnête est plus de mémoire, ou un correctif dans l'application. Nous vous dirons lequel des deux.
Réglés, pas livrés sur les valeurs par défaut
Les volumes sur flash reçoivent le bon ordonnanceur, la bonne lecture anticipée et la bonne profondeur de file, pas des heuristiques écrites pour des disques rotatifs. De petits gains permanents, sur chaque build.
Stockage : HPE 3PAR, all-flash, deux de tout
Les données des clients vivent sur HPE 3PAR, all-flash, dans des groupes de provisionnement SSD en RAID 6. RAID 6 parce que la reconstruction d'un gros disque flash est une fenêtre, et que nous ne la passerons pas à une panne de la perte de données.

Deux contrôleurs, deux fabrics, de nombreux chemins
Deux contrôleurs par baie. Chaque hôte se raccorde par deux fabrics Brocade Fibre Channel physiquement séparés, un port HBA dans chacun, et il est enregistré avec la bonne persona pour que le multipathing et l'ALUA se comportent comme le système d'exploitation l'attend. Un contrôleur, un fabric, une optique ou un port HBA peut disparaître, le volume reste en ligne.
Du thin qui dit la vérité, des volumes qui bougent en service
Les volumes sont thin avec détection automatique des zéros, si bien qu'un disque invité entièrement provisionné ne coûte presque rien physiquement tant que de vraies données n'arrivent pas. Les baies sont en fédération, nous migrons donc un volume vivant d'une baie à une autre pendant que l'hôte continue d'y lire et d'y écrire. Pour les bases de données en cluster, nous allons plus loin et plaçons chaque membre sur une baie physique différente, pour que la perte d'une baie entière coûte un réplica et que le quorum tienne.
Hygiène des disques, et discipline sur les écritures
Un disque qui rapporte une erreur corrigée est un disque dont la correction d'erreurs interne travaille déjà, sous le trafic réel des clients. Nous n'attendons pas qu'il tombe : il est vidé jusqu'à zéro, retiré, remplacé par un disque propre, et la baie admet le nouveau automatiquement.
Les backups tirent, et la reprise s'ajuste au service
Les backups sont pull-only. Les systèmes protégés n'ont aucun chemin vers l'infrastructure de backup et aucun identifiant pour elle, si bien qu'une compromission côté production ne peut pas atteindre les backups. Le côté sécurisé tend la main et prend ce dont il a besoin, jamais l'inverse. Les objectifs de reprise sont fixés par service, pas comme un chiffre unique pour tous : un site statique et une base de données transactionnelle ne méritent pas la même réponse.
Un hébergeur peut remplacer plus tard le stockage, les serveurs et le logiciel. Ce qui ne se corrige pas après coup, c'est le câblage, les optiques et les routeurs sur lesquels il a été construit, alors ceux-là, nous les avons faits correctement en premier.
De la fibre de bout en bout
Il n'y a aucun câblage de données en cuivre dans notre cage d'Athènes. Chaque serveur, chaque châssis de blades, chaque baie de stockage, chaque commutateur et chaque routeur est connecté en fibre optique. Le seul cuivre qui reste dans une baie est le court brin vers le port de gestion lights-out d'un serveur, et c'est délibéré : c'est la seule interface dont le travail est de fonctionner quand tout le reste est éteint.
Le verre gagne sur chaque axe qui compte dans une baie. Une liaison optique se moque du bruit électrique ou du câble d'alimentation posé à côté, si bien qu'une liaison est soit bonne soit absente, jamais mystérieusement limite, et un brin traverse le rack, la rangée et la salle à la même spécification. Le cuivre haut débit est épais, lourd et peu enclin à se courber, et cette masse finit suspendue au commutateur qu'elle dessert, devant son extraction d'air ; la fibre est fine et légère, les baies restent donc propres. Et quand la génération de débits suivante arrive, l'installation reste en place : nous changeons l'émetteur-récepteur à chaque extrémité et nous gardons le câble.
En pratique. Avant le lancement de nouvelles plateformes clients, nous avons construit toute la topologie fibre et port-channel d'un rack de blades avant même que la plupart des blades n'existent. Le jour du lancement a été une mise sous tension, pas un chantier de câblage.

Des optiques d'origine uniquement
Chaque SFP, SFP+ et QSFP dans nos racks est la pièce du fabricant lui-même, assortie au commutateur ou au routeur dans lequel elle est insérée et supportée par le constructeur dont le nom figure sur le châssis. Nous n'avons jamais acheté d'émetteur-récepteur générique et nous n'allons pas commencer.
L'économie est faible et elle achète quatre problèmes : des relevés optiques qui peuvent ne rien vouloir dire, ce qui vous prive du meilleur diagnostic sur un réseau optique, le niveau de lumière en direct à chaque extrémité ; un module qui fonctionne sur une version logicielle et se comporte mal sur la suivante, parce que personne n'a testé cette combinaison ; une raison légitime pour un constructeur de clore le dossier de support que vous ouvrez la nuit où vous en avez le plus besoin ; et une liaison qui bat en charge pour des raisons que personne ne peut reproduire. Nous achetons donc la bonne pièce, et nous achetons des rechanges : des plateaux d'optiques sur l'étagère, dans le datacenter, pour qu'un remplacement soit une promenade dans l'allée plutôt qu'un bon de commande.
En pratique. Nos contrôles de santé de routine lisent les compteurs d'erreurs des interfaces et des optiques sur tout le fabric, et parce que chaque module est celui du constructeur, ce qu'ils rapportent est exploitable : un émetteur-récepteur qui dérive hors spécification est un remplacement planifié depuis le plateau, à notre heure.


Le fabric : leaf et spine, EVPN et VXLAN
À l'intérieur du datacenter, tout est suspendu à un fabric leaf et spine Cisco Nexus 9000 faisant tourner BGP EVPN avec VXLAN. Les spines sont de purs route reflectors, sans extrémité de tunnel sur eux par conception. Les leaves sont construits en paires virtual port-channel, si bien que chaque hôte est dual-homed sur deux commutateurs par un seul bond logique, et que la passerelle d'un sous-réseau client est la même adresse anycast sur chaque leaf. Le trafic broadcast est répliqué par BGP plutôt que par un arbre multicast, et BFD tourne là où la détection rapide compte. Comme n'importe quel VLAN peut vivre sur n'importe quel leaf, nous pouvons étendre le Layer 2 d'un client entre nos datacenters et laisser ses serveurs garder leurs adresses pendant qu'ils déménagent.
L'identifiant réseau de chaque segment Layer 2 est dérivé de son VLAN local par une règle fixe, et cette règle n'est pas une convention dans un document. Un contrôle automatisé lit la carte depuis chaque leaf, confirme que les leaves sont identiques et obéissent à la règle, et compare une empreinte cryptographique de toute la carte avec une référence signée sous contrôle de version. Il tourne avant que toute modification soit enregistrée et de façon planifiée ensuite, une dérive alerte un ingénieur, et une modification voulue doit être re-signée, si bien que chaque changement du fabric porte un auteur et une piste d'audit.
En pratique. Lors d'un test de panne contrôlé, nous avons redémarré un nœud de cluster alors qu'il était le chemin préféré pour une adresse publique en service. Le fabric a convergé vers un nœud sain en environ trois secondes, et l'adresse n'a jamais quitté la table de routage.

L'edge : nos propres systèmes autonomes
Nous exploitons notre propre edge internet, sur nos propres systèmes autonomes enregistrés au RIPE et notre propre espace IPv4 et IPv6, avec la production des clients et les services de plateforme sur des systèmes autonomes séparés pour qu'un problème sur l'un ne puisse pas atteindre l'autre. Les routeurs sont de classe opérateur : Cisco ASR 9000 series à Athènes, un ASR 9006 en première ligne de l'edge de production, et Juniper MX204 à Amsterdam, chacun portant la table de routage complète d'internet et l'échangeant avec son jumeau.
Nous achetons du transit auprès de plusieurs opérateurs plutôt que de louer un port à qui possède le bâtiment : OTE Globe, Cogent et Hurricane Electric à Athènes, Arelion, NTT, Deutsche Telekom et Telecom Italia du côté d'Amsterdam, les deux sites étant reliés par un Layer 2 privé pour que le parc se comporte comme un seul réseau. Nous faisons du peering direct au GR-IX et au NetIX, et nous ajoutons des sessions bilatérales une à une avec les réseaux auxquels nos clients parlent réellement.
IPv6 est natif partout : dual-stack des routeurs d'edge jusqu'à votre passerelle, sans tunnel et sans traduction sur le chemin.
En pratique. Notre fabric d'Athènes est passé en dual-stack en une seule journée de travail, de l'edge internet à travers le fabric jusqu'à un VLAN client partagé en service.

Fibre Channel : deux fabrics, jamais un seul chemin
Le réseau entre les serveurs et le stockage est du Fibre Channel, pas de l'Ethernet, construit comme deux fabrics Brocade complètement indépendants. Chaque serveur et chaque baie sont connectés aux deux, chaque fabric avec sa propre commutation cœur et son propre commutateur dans chaque châssis de blades, si bien qu'aucun commutateur, câble, port ou défaut logiciel unique n'existe des deux côtés du chemin d'un hôte.
En pratique. Parce que chaque hôte détient déjà des chemins vivants vers chaque baie de sa fédération sur les deux fabrics, nous pouvons vider une baie de stockage entière, pour maintenance ou déménagement, sans redémarrer une machine client et sans fenêtre de maintenance.
Le backbone chiffré entre nos sites
Nos datacenters d'Athènes, d'Amsterdam et de Toronto, notre siège social à Chypre et nos points de présence régionaux sont reliés par un overlay Cisco DMVPN : tunnels GRE multipoint protégés par IPsec en AES-256, NHRP authentifié, BFD, et BGP au-dessus des tunnels. Chaque datacenter a des hubs redondants, et comme l'overlay est routé par BGP plutôt que par des tables statiques, perdre un hub ou un circuit est un retrait de route qui converge tout seul.
Un site avec deux circuits WAN fait tourner un second cloud DMVPN sur le même routeur, si bien que le second circuit n'a besoin ni d'une nouvelle adresse publique ni d'un changement sur les hubs, et le multipath BGP répartit le trafic sur les deux avec un hachage de forwarding qui inclut les ports, pour que les flux parallèles se séparent réellement. Nous dimensionnons d'après ce que le moteur de chiffrement peut vraiment faire, environ 11 Gbit/s par hub, pas d'après le chiffre imprimé sur une licence, et nous montons en charge avec de l'equal-cost multipath entre hubs jusqu'à 30 à 40 Gbit/s quand un client en a besoin.
En pratique. Sur un site à deux circuits, un test de débit a mesuré plus dans chaque sens que ce que l'un ou l'autre des circuits pouvait porter seul. C'est la seule preuve acceptable que l'equal-cost multipath fonctionne, et pas seulement qu'il est configuré.
La discipline qui va avec
Des bonds qui utilisent les deux liaisons. Le bonding Linux par défaut hache sur les adresses MAC, ce qui, dans un datacenter, empile les flux sur un membre du bond et laisse l'autre inactif. Chaque serveur en bond que nous construisons hache sur les couches 3 et 4, avec le côté commutateur réglé pour correspondre. Nous vérifions les compteurs par port sur chaque build pour prouver que les deux liaisons portent du trafic.
Chaque port enregistré. Pas un nom sur une ligne : le port avec sa vraie adresse MAC, la liaison vers le port du commutateur distant avec son identifiant de câble, la position dans le rack, les adresses et l'interface de gestion. L'équipement en service est la source de vérité et les enregistrements sont faits pour lui correspondre.
Un enregistrement inverse pour chaque adresse. Chaque adresse que nous attribuons à une interface, un loopback, un service ou un hôte reçoit un PTR dans notre propre DNS faisant autorité, dans la même séance. Un traceroute à travers notre réseau se lit comme une phrase qui nomme l'équipement, son rôle et son site.
Le plan de gestion, et l'air gap
Le trafic client et le trafic de gestion ne partagent rien : ni un port, ni un commutateur, ni une adresse, ni une route.
Il reste exactement un câble en cuivre dans nos baies : le port de gestion du contrôleur lights-out de chaque serveur. C'est aussi le câble le plus soigneusement isolé du bâtiment.
Gestion out-of-band sur chaque machine
Chaque serveur que nous exploitons est un vrai serveur d'entreprise avec un vrai contrôleur lights-out : iDRAC Enterprise avec licence Datacenter sur Dell, iLO Advanced sur HPE, les deux pilotés via Redfish, et chaque châssis de blades via son Onboard Administrator. Pas une carte mère white box dont l'idée de la gestion distante est un bouton d'alimentation et pas de console.
Sur les châssis de blades, l'Onboard Administrator atteint chaque contrôleur du châssis par le fond de panier, et il est lui-même une paire redondante avec basculement automatique.
En pratique. Quand un rack de châssis de blades a eu besoin d'une licence iLO Advanced, et d'un compte de gestion créé sur chaque blade, nous ne nous sommes connectés à aucun blade. Nous l'avons poussé via l'Onboard Administrator de chaque châssis et le rack était terminé en quelques minutes, y compris des blades installés la semaine même, qui n'avaient pas encore d'identifiants propres. C'est un runbook.
Le réseau de gestion n'est pas le réseau de production
Le contrôleur a son propre port physique et son propre câble vers sa propre commutation. Nous ne partitionnons pas une carte réseau de production pour laisser le contrôleur en emprunter une tranche, ce qui est le raccourci habituel et la raison habituelle pour laquelle la gestion finit à une erreur d'internet. La gestion vit sur ses propres commutateurs, ou sur ses propres VLAN sur des fabrics qui ne portent rien d'autre, dans un espace d'adressage privé qui n'est routé ni vers ni depuis aucun réseau client et n'est jamais annoncé sur internet.
Nous appelons cela un air gap parce que c'est ainsi que cela se comporte. Une machine virtuelle cliente, même entièrement compromise, scannant à pleine vitesse pendant une semaine, ne peut pas voir un iLO ou un iDRAC du tout. Pas refusé, pas filtré : absent. Les paquets n'ont nulle part où aller. Cela tient aussi dans l'autre sens, et c'est tout aussi important : aucun trafic de gestion ne circule sur un VLAN client, si bien que nos sessions de console, notre supervision et nos backups n'entrent jamais dans le domaine de diffusion d'un client ni ne rivalisent avec sa bande passante. L'isolation est assez réelle pour nous gêner, ce qui est la preuve qu'elle est réelle : un contrôleur sur un VLAN de gestion ne peut pas atteindre négligemment un serveur web interne pour récupérer une image de firmware, parce que rien n'est permis qui n'ait été demandé et écrit. L'ingénieur fait le pas supplémentaire.
Les backups voyagent de la même façon. Ils sont pris par le réseau out-of-band, jamais à travers un segment de production.
En pratique. Une seule liste d'accès de gestion canonique est appliquée sur chaque plateforme que nous exploitons, sur les lignes de connexion des Cisco Nexus, par instance de routage sur les routeurs, par interface pour SSH et HTTPS sur les firewalls, n'autorisant que des sous-réseaux de gestion nommés, avec du control plane policing qui limite en matériel ce qui reste.
Le plan de gestion lui-même
Le plan de gestion est un réseau à part entière et nous l'avons construit comme tel. Il tourne sur notre propre backbone multi-sites chiffré : Cisco DMVPN, IPsec en AES-256, BGP transporté sur les tunnels, reliant Athènes, Amsterdam et Toronto à notre siège social à Chypre, qui n'est délibérément dans aucun des bâtiments qu'il gère. Les hubs sont redondants, avec des chemins à coût égal entre eux et sur des circuits distincts, et une détection de panne qui remarque un chemin mort en bien moins d'une seconde.
Le personnel y accède d'une seule façon : par des passerelles VPN et des firewalls que nous possédons et exploitons nous-mêmes, sur OPNsense et Cisco Firepower, puis par des hôtes de rebond à l'intérieur du plan, plutôt que directement depuis l'ordinateur portable d'un ingénieur. Des niveaux de confiance différents ne partagent jamais un objet de firewall, si bien qu'élargir l'accès d'un groupe ne peut pas élargir silencieusement celui d'un autre.
Vers les plans de backup et de disaster recovery, la politique est deny par défaut et les données circulent dans un seul sens. La production ne pousse jamais vers le backup. Le côté backup tire. C'est imposé par des règles de refus explicites sur les appliances firewall, pas par un firewall d'hôte qu'un hôte compromis pourrait modifier, et les segments de backup n'ont aucune route vers internet. Seule la plage de gestion les atteint. Si une machine de production est entièrement prise, l'attaquant n'acquiert aucune connaissance de l'infrastructure de backup et aucun chemin vers elle. De là où il se tient, elle n'existe pas.
Les modifications du backbone sont vérifiées en direct sur le système en fonctionnement, une moitié d'une paire redondante à la fois, et c'est pourquoi nous pouvons travailler sur le backbone au milieu d'une journée de travail.
En pratique. Nous avons déplacé tout le parc de VPN site à site d'un client d'un pays à un autre en une seule séance, avant une échéance fixe. Le hub a été cloné, transporté et mis en service en parallèle de l'original, si bien que les deux étaient actifs en même temps et qu'il y avait toujours un endroit où les tunnels pouvaient se poser. Les routeurs d'agence ont été basculés un à un, chacun vérifié actif avant de toucher au suivant, chacun basculant proprement en chemin. Personne ne s'est déplacé dans une agence.
Le socle de durcissement sur chaque hôte
Chaque machine que nous construisons part du même socle, et le socle n'est pas négociable. SELinux est en mode enforcing, et nous ne le désactivons pas pour qu'une application coopère, nous écrivons la politique à la place. Les systèmes de fichiers sont en XFS.
L'application des correctifs ne dépend de personne d'autre. Nous exploitons notre propre miroir de paquets dans notre propre datacenter, portant les dépôts depuis lesquels notre parc installe, signatures amont intactes, joignable uniquement depuis nos propres plages d'adresses. Un miroir public qui passe une mauvaise journée n'est pas un événement ici, et un serveur délibérément incapable de parler à internet reste un serveur que nous pouvons entièrement corriger.
En pratique. Quand une vulnérabilité critique a été publiée dans un environnement d'exécution largement utilisé, les paquets corrigés étaient en production sur chaque serveur concerné le jour même, avant la fin de la nuit. Ni à la main ni dans la précipitation : le déploiement prend un backup, met à niveau un hôte à la fois, sonde de vrais sites sur cet hôte pour vérifier une réponse saine avant et après, et interrompt automatiquement toute la vague si l'un d'eux ne revient pas correctement. Rapide et soigneux ne sont pas contraires si l'on construit la chose qui le fait pour soi.
Les journaux des machines rentrent, et rien n'a le droit de se taire
Les sévérités sérieuses vont directement dans le chat des opérations, où l'ingénieur d'astreinte se trouve déjà, et atteignent un humain en quelques secondes ; nous savons que ce sont des secondes parce que nous l'avons chronométré avec une vraie alarme. En edge, des sondes dédiées lisent le trafic miroité depuis les routeurs de bordure et surveillent en continu les motifs volumétriques et de déni de service.
Un équipement peut sembler parfaitement sain depuis sa propre ligne de commande tout en n'envoyant silencieusement rien au collecteur, si bien que « la journalisation est configurée » n'est pas une preuve ici. Nous confirmons que le journal arrive, à l'autre bout, dans le flux auquel il appartient, après chaque modification qui aurait pu le perturber. Les systèmes de supervision ont leurs propres chiens de garde sur des machines séparées, si bien que « la chose qui surveillait a cessé de surveiller » est elle-même une alarme. Le silence n'est jamais une bonne nouvelle.
En pratique. Notre contrôle de santé de routine vérifie aussi deux choses que la plupart des contrôles sautent : si chaque équipement expédie encore réellement ses journaux, et si sa configuration est encore réellement sauvegardée. Ces deux pannes sont celles qui cachent les autres.
Analyse en temps réel sur nos propres NVIDIA A100
La plupart des hébergeurs collectent les journaux dans un seau et y cherchent après que quelque chose a déjà cassé. Nous mettons le flux au travail. Des règles de base retirent d'abord le bruit connu, puis tout ce qui reste, venant des routeurs, commutateurs, firewalls, baies de stockage et serveurs, est analysé à l'arrivée par des modèles d'IA tournant sur un ensemble de nos propres GPU NVIDIA A100, à l'intérieur de notre propre datacenter.
Les modèles lisent à travers les équipements, pas une ligne de journal à la fois : une erreur de chemin de stockage, une interface qui bat et une température qui monte sur le même rack deviennent une seule histoire au lieu de trois messages sans rapport. Ils repèrent les motifs qu'une règle statique ne verra jamais, la dérive lente et la combinaison inhabituelle qui précède une panne, et chaque alarme atteint l'ingénieur avec un second avis déjà attaché. Les données machine cessent d'être un tas de texte à fouiller et deviennent une alerte précoce.
Rien de tout cela ne quitte notre réseau. Les modèles, les GPU et les données sont tous à nous, et aucune ligne de journal n'est jamais envoyée à un service d'IA extérieur.
Un CTO qui nous évalue est le bienvenu pour demander la liste d'accès, le runbook et le routage des alarmes. Nous vous montrerons les trois.
Des pièces de rechange sur place
Les pièces de rechange, jusqu'aux châssis entiers, sont dans la même cage que les machines qui en auront besoin, pas sur le contrat de livraison d'un fournisseur.
Une pièce de rechange ne gagne pas sa place sur cette étagère en arrivant. Les disques passent sur un banc de test, sont formatés au niveau bas au format de secteur de la baie qu'ils serviront, et ne sont stockés qu'une fois qu'ils rapportent zéro défaut apparu et aucune erreur de lecture, d'écriture ou de vérification non corrigée. Une pièce de rechange qui tombe la nuit où vous en avez besoin n'a jamais été une pièce de rechange.
Remplacer tôt, mettre à niveau à l'heure
Ici, le matériel est retiré sur des preuves, pas sur une panne.
Les vulnérabilités critiques, le jour même. Quand une faille de sévérité maximale est divulguée dans quelque chose dont nous dépendons, nous construisons des paquets corrigés le jour même où le correctif est publié. La configuration de protection est appliquée immédiatement. Si aucun paquet corrigé n'existe encore pour la plateforme que nous exploitons, nous le construisons nous-mêmes, compilé dans un conteneur propre d'après la spécification du mainteneur lui-même, vérifié contre la source publiée du projet, installé hôte par hôte avec des contrôles avant et après. La dernière fois que cela a été nécessaire, le correctif était en production environ trois heures après la publication de la source. Nous exploitons notre propre miroir de paquets pour la même raison.
La documentation comme infrastructure
Beaucoup d'entreprises ont de la documentation. Nous la traitons comme une partie de l'installation.
Chaque câble porte un identifiant unique imprimé, issu d'un seul registre qui ne peut pas émettre deux fois le même numéro et n'en réutilise jamais un, même après le retrait du câble. L'étiquette nomme les deux extrémités, rack, équipement et port à chacune. Vingt-deux ans de câblage peuvent encore se tracer de l'étiquette à l'enregistrement, au port du commutateur, et retour.
Un service n'est pas terminé quand il fonctionne. Il est terminé quand son adresse, sa règle de firewall, sa fiche d'inventaire et son DNS direct et inverse existent tous et ont été vérifiés depuis l'extérieur de notre réseau.
Notre outillage refuse la commande quand la règle n'a pas été respectée, ce qui est une meilleure garde que les bonnes intentions.
C'est ce qui compte à trois heures du matin. La question alors n'est jamais quelle est l'astuce ingénieuse. C'est qu'est-ce qui a changé, et comment le remettre en place.
Certifiés, et audités
Les quatre ont été délivrés en septembre 2026 par un organisme de certification accrédité au niveau national, avec le périmètre libellé « Managed datacenter hosting service ». C'est le service que vous achetez réellement, pas un coin de l'entreprise choisi pour faciliter un audit.
Vos données restent là où vous les mettez, et sur nos sites européens, cela veut dire dans l'UE, sur du matériel qui nous appartient, sans cloud public en dessous. Nous signons un accord de traitement des données, et notre document de mesures techniques et organisationnelles est disponible sur demande.
Des ingénieurs, pas des niveaux
Pas de bots, et pas de première réponse scriptée.
Les ingénieurs qui choisissent le matériel, le mettent en rack, le câblent et l'étiquettent sont les mêmes ingénieurs qui répondent à votre ticket, et ils le signent de leur propre nom. Cela fonctionne parce que les gens ici connaissent votre configuration par son nom et sont assez seniors pour ne pas avoir besoin d'un script.
Sur l'ensemble de notre historique de tickets, notre première réponse médiane est de trois minutes, et 87 % des tickets sont résolus dans l'heure. Une bonne part est ouverte par nous plutôt que par vous : notre supervision surveille tout ce dont nous sommes responsables, 24h/24, jusqu'à vos pages réelles, et les alarmes arrivent dans un canal que les ingénieurs lisent.
Toujours les mêmes
Mêmes standards. Même ingénierie les mains dans le matériel. Toujours pas d'investisseurs, toujours pas de plan de sortie, et toujours la règle avec laquelle nous avons commencé dans une salle de colocation à Amsterdam : acheter la meilleure machine.
Nous organisons des visites accompagnées du datacenter d'Athènes : la cage, la fibre, les optiques dans leurs plateaux, les pièces de rechange sur l'étagère. Nous vous le ferons visiter nous-mêmes, parce que c'est nous qui l'avons construit. Venez avec un ingénieur.
Votre prochain partenaire d'infrastructure
Vous voulez le voir ?
Dites-nous ce que vous faites tourner. Un ingénieur répond, et la visite du datacenter est pour nous.
+357 222 32280
Commençons par votre environnement.
Un peu de contexte nous aide à démarrer la bonne conversation.