Le blog EuroVPS
Notes de terrain.
Depuis la salle des machines.
Décisions, investigations et leçons tirées de l'exploitation d'une infrastructure de production. Écrites par les personnes qui en prennent soin.
Sélection de lecture
Par l'équipe d'ingénieurs
Une nouvelle maison pour EuroVPS : le managed hosting, tel que nous le pratiquons
Le nouveau eurovps.com est en ligne. Il dit, en langage clair, ce que nous construisons et exploitons chaque jour, et c'est le premier pas d'une direction que nous avons choisie délibérément.
Lire l'article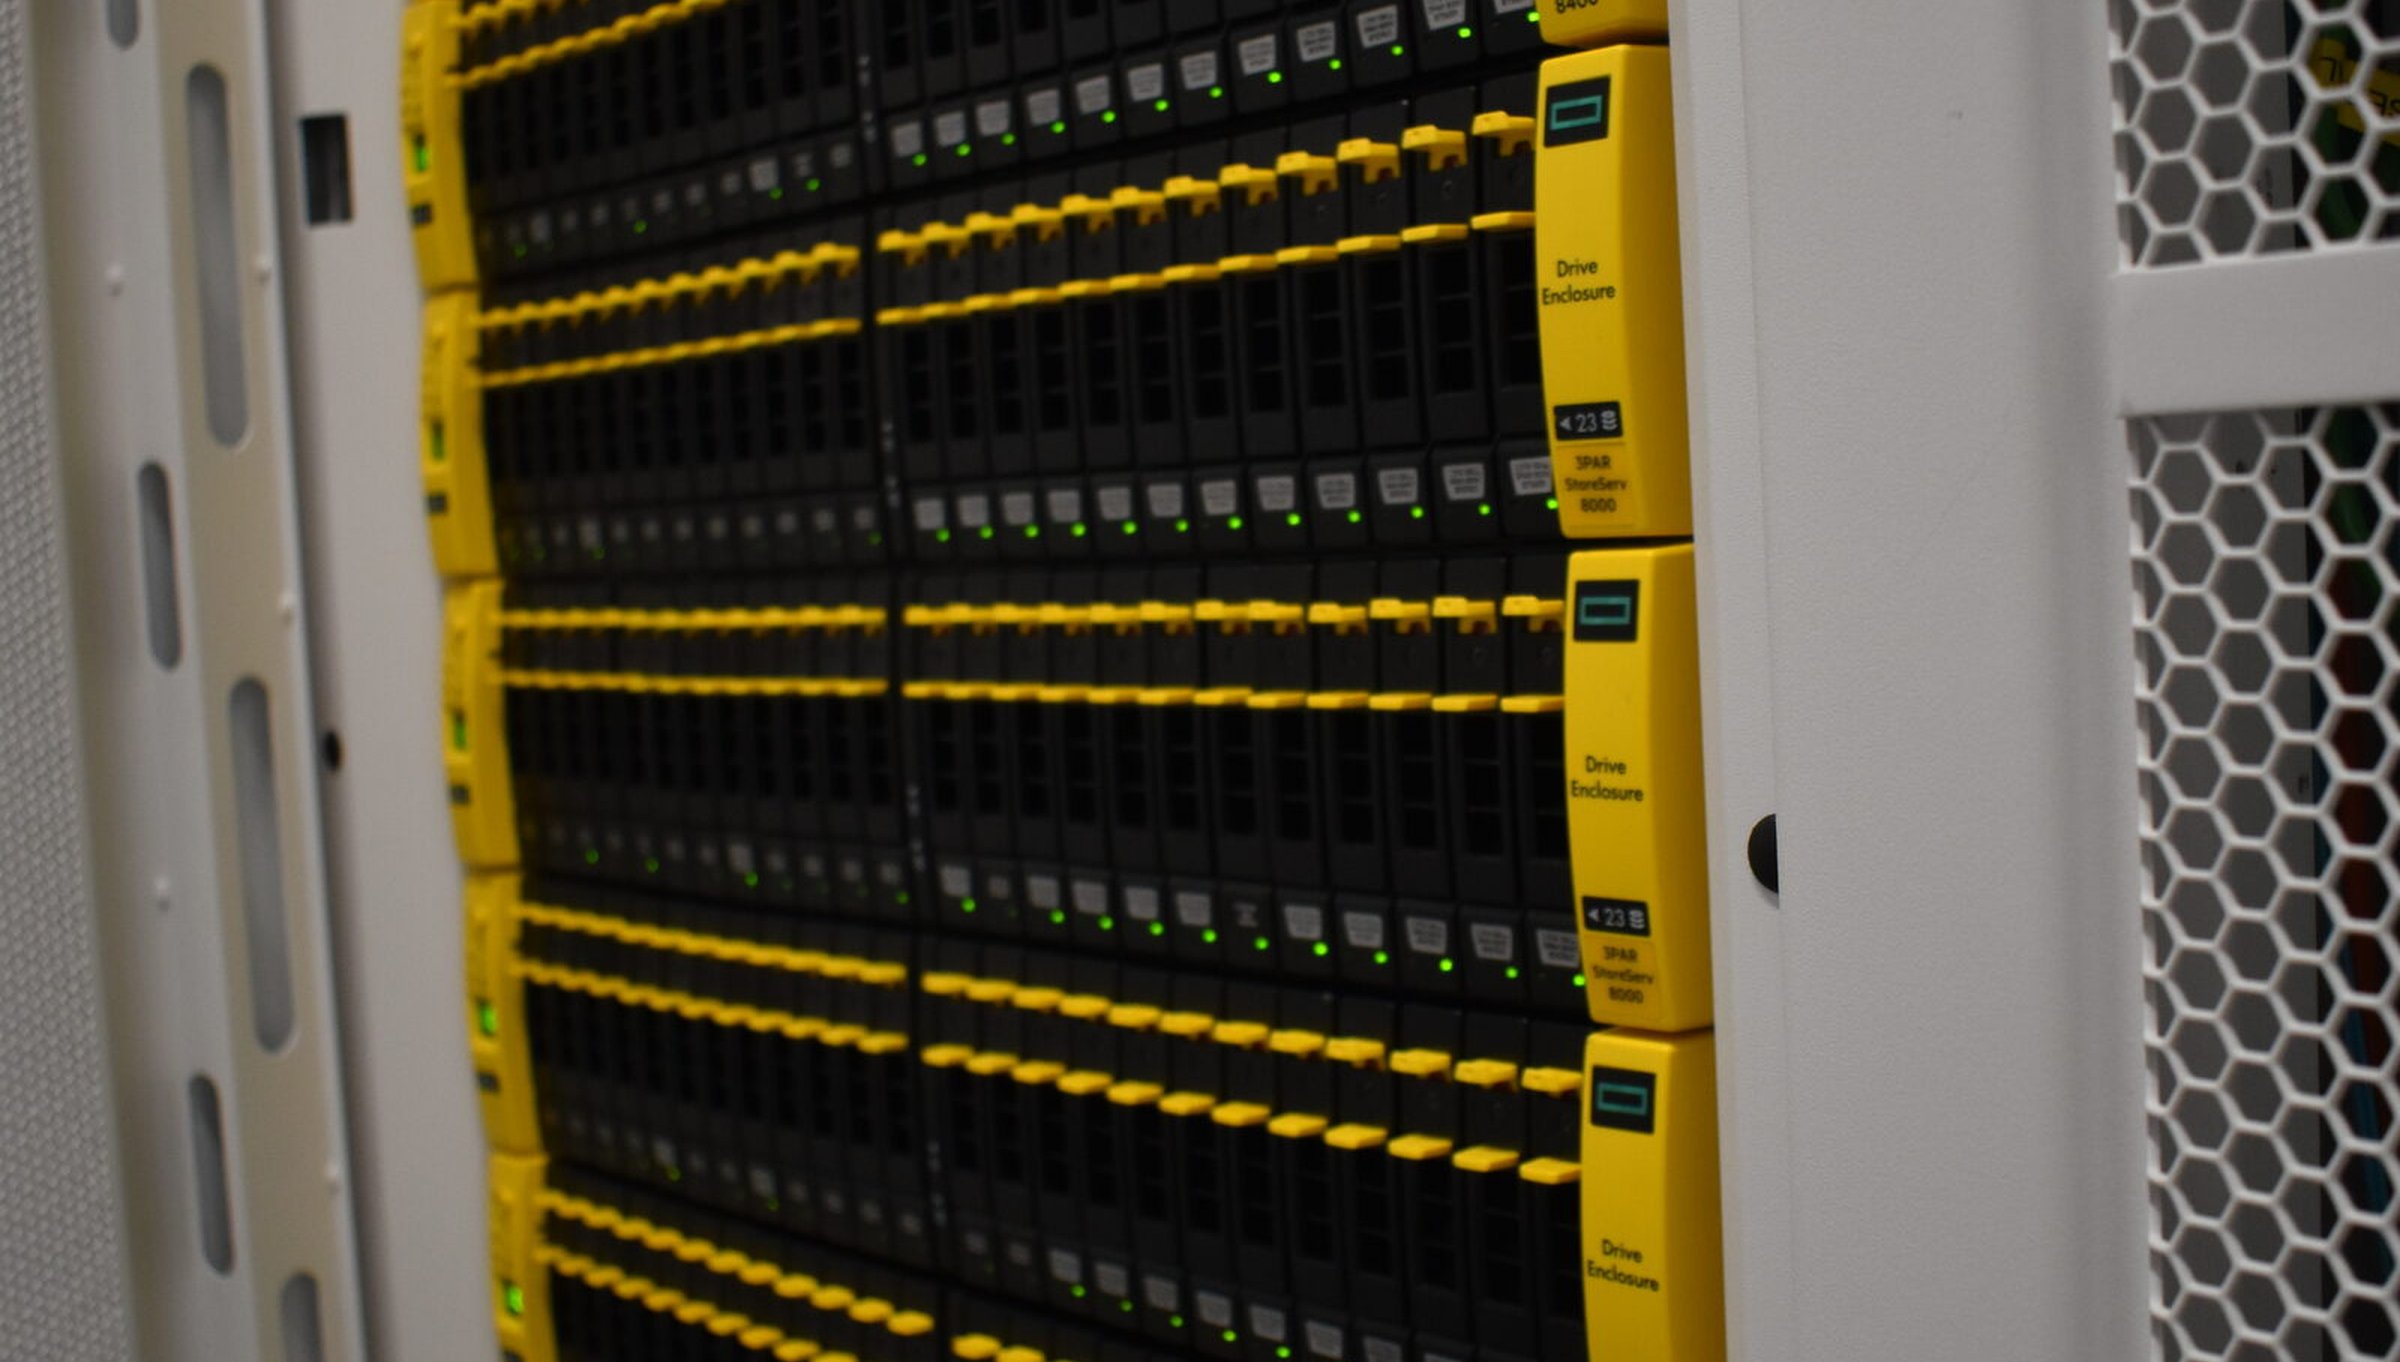
Les archives
Plus d'articles de l'équipe.
Une migration est un projet, pas un ticket.
Le groupe de sites d'information à fort trafic d'un grand éditeur devait changer de datacenter, réarchitecturé pour la montée en charge sur le chemin vers notre bare metal. Nous avons conçu la plateforme, l'avons testée sous charge et avons basculé en une opération de deux heures avec une fenêtre visible d'environ cinq minutes et un chemin de retour arrière à chaque phase.
Cohérence lecture après écriture sur un cluster Galera
Un cluster Galera ou Percona XtraDB certifie une écriture au commit et l'applique sur les autres nœuds un instant plus tard, et une lecture routée dans cet intervalle voit le passé.
Ils ont cessé de nous appeler quand quelque chose casse.
Les clients ont cessé de nous appeler quand quelque chose casse et ont commencé à nous appeler pour construire la suite : release engineering, environnements de staging, accès sécurisé et migrations menées en projet remplissent désormais notre file d'ingénierie. La preuve n'est pas un témoignage. C'est le travail lui-même.
Des exports et des montages NFS qui échouent sans casse
Les défauts de NFS qui abîment le contenu partagé : exports ouverts, accès root, montages soft et blocages au démarrage, avec les réglages et les contrôles qui les corrigent.
Un backup GitLab que vous ne pouvez pas restaurer n'est qu'un gros fichier
L'archive de backup de GitLab laisse de côté les fichiers qui la rendent restaurable. Quoi copier à côté d'elle, comment la tirer en sécurité, et comment prouver qu'une restauration fonctionne.
503 ou 403 instantané : vérifiez d'abord au-dessus de l'application
Une page d'erreur qui arrive sans aucune latence a été servie avant que votre application ne tourne, donc la checklist part du edge et ne descend vers le code qu'en dernier.
Comment les sites sont réellement compromis, et comment ne pas être la cible facile.
En sécurité, la cause supposée par le client est en général « rien ne va mal ». Voici comment les sites sont réellement compromis, pourquoi le haut de la liste est évitable, et comment nous prouvons qu'une porte est fermée avant de la déclarer fermée.
Un switch peut mourir et votre stockage continue de servir
Ce que le multipath sur deux fabrics Fibre Channel indépendants vous apporte, pourquoi le RAID à l'intérieur d'un serveur protège beaucoup moins qu'il n'y paraît, et pourquoi la maintenance d'un fabric n'est pas un événement pour la charge de travail.
Votre hébergeur devrait ouvrir le ticket en premier.
Sur notre desk, beaucoup de tickets, c'est nous qui les ouvrons, depuis la supervision et la détection de sécurité, avant que le client ne dépose quoi que ce soit. Les quatre gestes d'une équipe déployée en avant, et la frontière qui fait de « entièrement infogéré » un modèle décrit plutôt qu'un adjectif.
Deux circuits, un routeur. Un DMVPN double cloud qui utilise les deux liens
Construisez un second cloud DMVPN avec des tunnel keys, faites tourner du BGP multipath sur les deux circuits WAN, et dimensionnez la capacité chiffrée à partir du moteur crypto, pas de la licence.
Pourquoi nous avons standardisé sur HPE 3PAR all-flash
Une seule famille de baies, choisie et maîtrisée, bat un menu de paliers de stockage multi-constructeurs. L'argument de la standardisation pour le stockage, avec l'architecture, tirée du dossier public, comme preuve.
Chercher dans des décennies d'e-mails : les mots-clés d'abord, le sens ensuite
La recherche IA sur les e-mails échoue sur des données sales. Comment nettoyer, threader et indexer une archive pour que mots-clés et sémantique coopèrent.
Fenêtres de maintenance : ce qui se fait sous charge à la place
La plupart des travaux planifiés sur une infrastructure redondante se font pendant qu'elle sert. Les changements qui exigent une fenêtre sont conçus, bornés et convenus avec vous d'abord.
Arithmétique de la table d'états : dimensionner un firewall pour les floods, pas pour les moyennes
Pourquoi un firewall stateful manque d'états avant de manquer de bande passante, comment dimensionner la table et les timeouts, et quand passer en stateless.
ERR_TOO_MANY_REDIRECTS derrière un CDN : les deux réglages qui bouclent ensemble.
La boucle de redirection qui ne laisse rien dans le journal d'accès : un mode SSL du CDN qui appelle l'origine en HTTP, et une redirection sur l'origine qui ignore le proxy. Reproduisez-la avec une seule requête et corrigez les deux bouts.
Comment tester une restauration, pas seulement un backup
Un job de backup vert prouve que le job a tourné. Un test de restauration prouve que vous pouvez récupérer : contrôles de couverture, trois niveaux de restauration, lab isolé, chronométrage.
Limitez le chemin coûteux, pas le crawler
Trouvez les URL qui coûtent du vrai travail et limitez-y les crawlers avec les stick tables HAProxy et un 429, sans nuire à la recherche ni aux visiteurs.
Pourquoi un compte root compromis impose de reconstruire le serveur, pas de le nettoyer.
Sous Unix, root est un nombre, pas un nom. Un compte UID 0 sans trace de création n'a été fabriqué par aucun outil, il a été écrit à la main dans le fichier des utilisateurs. Comment le trouver, pourquoi un seul contrôle réussi n'est pas une preuve, et pourquoi un accès root pendant n'importe quelle fenêtre impose une reconstruction, pas un nettoyage.
Notre prix ne change pas quand votre trafic change.
L'egress au gigaoctet, le support par palier, le burst facturé seulement une fois qu'il a eu lieu. Voici comment se lit votre facture quand la machine en dessous est à vous.
Ne vous arrêtez pas à la première panne.
Le mode de défaillance que cet article veut faire disparaître : votre site s'effondre, quelqu'un trouve une panne plausible, la corrige, crie victoire, et le site reste à terre. Les pires jours, il y a quatre autres pannes derrière la première. Voici la méthode pour démêler, une règle à la fois, avec l'indice qui trahit chaque type de panne.
Chaque intégration de tickets livre deux fois. Construisez-la pour cela.
Des webhooks qui réessaient, des partenaires qui renvoient, des réseaux qui perdent des réponses. Comment construire un pont de tickets signé, idempotent, sans boucles et à périmètre limité, avec du code que vous pouvez réutiliser.
Les plus lus
Les guides vers lesquels les lecteurs reviennent- 0110 raisons pour lesquelles votre site se charge lentement (et comment les corriger)
- 02Les fichiers de logs Linux que vous devez surveiller sur RHEL 9 et 10
- 03Configurer WordPress Multisite avec nginx et PHP-FPM sur RHEL 9 et 10
- 04Archimède et la poulie composée : comment un homme a mû un navire
- 05Guide complet des codes d'état HTTP : série 300
- 06Guide complet des codes d'état HTTP : série 400
- 07Combien de RAM, de CPU, d'espace et d'IOPS votre VPS a-t-il vraiment besoin ?
Mettez la lecture en pratique
Vous avez une charge de travail en tête ?
Commencez par les chiffres.
Les assistants de dimensionnement transforment vos exigences en configuration proposée et en fourchette de prix indicative. Un ingénieur peut vous aider à vérifier ce qui convient.