

Infrastructure GPU infogérée: Votre modèle.
Votre machine.
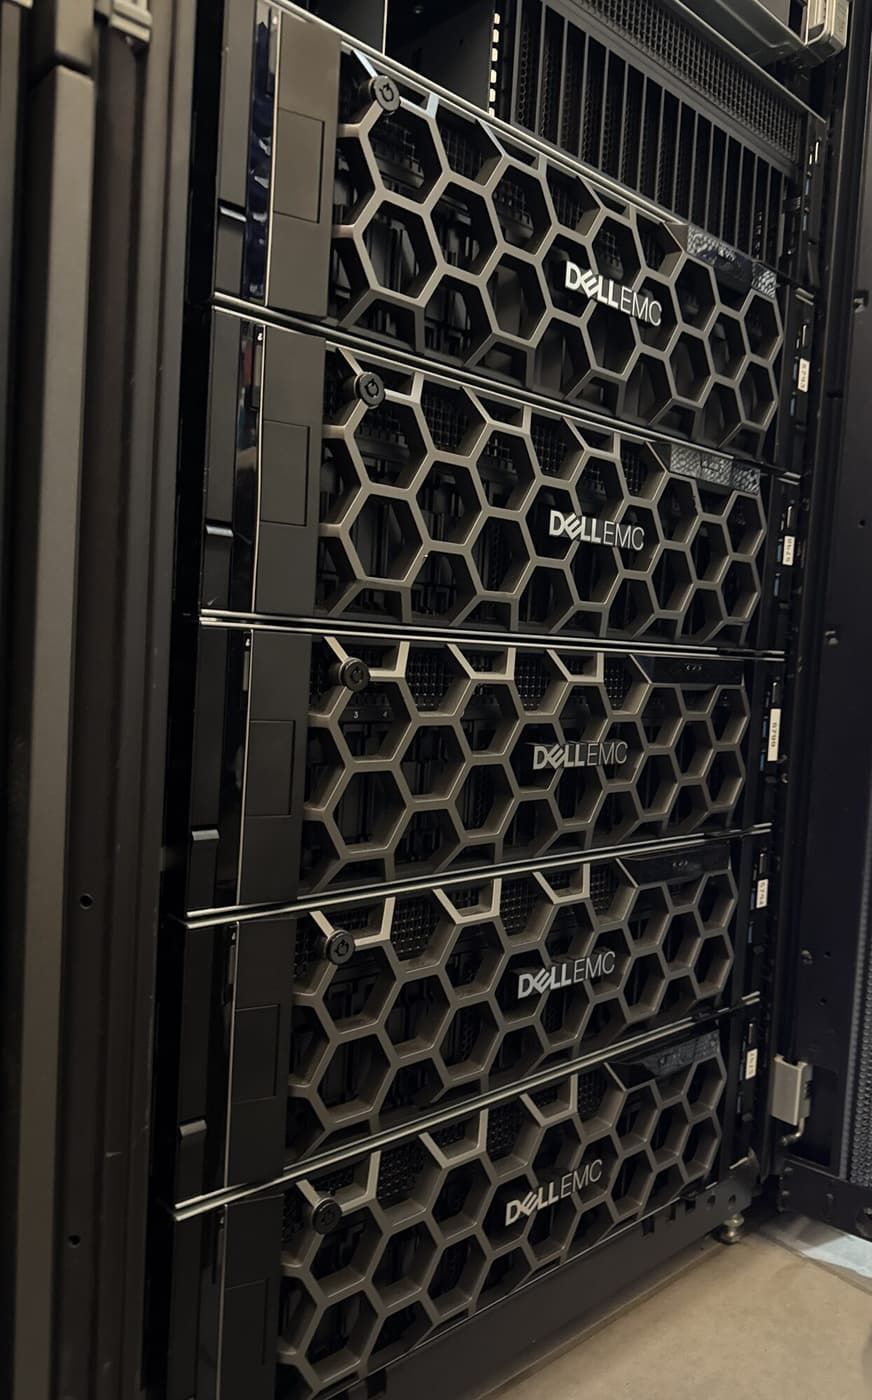
Des GPU dédiésUne capacité réservée pour vous
Un endpoint privéUn accès conçu autour de votre application
Athènes et AmsterdamDigital Realty, dans l'UE
Infogéré par des ingénieursDu déploiement à l'exploitation
Le matériel
N'importe quel GPU que nous pouvons acheter.
Dans notre datacenter sous 48 heures.
NVIDIA L4, L40, L40S, A100, H100 et le reste de la gamme actuelle, dimensionnés pour le modèle et la charge de travail. Vos propres GPU privés, dans nos datacenters Digital Realty d'Athènes et d'Amsterdam, dans l'UE.
Modèle et machine, considérés ensemble
Un modèle. Une machine.
Un plan.
Explorez quelques points de départ pour un endpoint privé. Nous convenons du modèle exact, des exigences de serving et du matériel autour de ce que vous devez faire tourner.
Une connexion privée au modèle sur une infrastructure dédiée.
Architecture illustrativeUn point de départ pour la conversation
Llama
- Le modèle
- Un modèle de texte de classe 70B, dont la version actuelle est convenue avec vous. Nous l'évaluons au regard des besoins de votre application en langue, en qualité et en temps de réponse.
- Le dimensionnement
- Nous testons ensemble la précision, la longueur de contexte et les requêtes concurrentes avant de choisir la capacité GPU et la configuration de serving.
- Version et conditions
- Llama est fourni sous la community license de Meta, qui a ses propres conditions d'usage et d'échelle. Nous confirmons que la version exacte convient à votre usage avant le déploiement.
Un point de départ pour la conversation
Mistral
- Le modèle
- Un modèle de taille moyenne, dont la version actuelle est convenue avec vous, est une option à évaluer pour un assistant privé ou un endpoint applicatif.
- Le dimensionnement
- Nous convenons de la précision et du contexte dont vous avez besoin, puis nous testons la charge de serving. La taille du modèle à elle seule ne garantit pas qu'il tienne sur le GPU.
- Version et conditions
- Mistral publie certains poids sous licence Apache 2.0 et d'autres sous ses propres conditions de recherche ou commerciales. Nous confirmons lesquelles s'appliquent à la version que vous choisissez.
Un point de départ pour la conversation
Qwen
- Le modèle
- Une famille de modèles de tailles variées. Nous choisissons une version précise à tester avec votre application, plutôt que de dimensionner du matériel pour le nom de la famille.
- Le dimensionnement
- Nous partons du modèle sélectionné et de vos propres prompts. Le contexte, la précision et les objectifs de trafic guident la configuration finale.
- Version et conditions
- Vérifiez les conditions pour le modèle et la taille exacts. La model card du 72B en lien est un exemple, pas une licence pour toute la famille.
Conçu avec vous
DeepSeek
- Le modèle
- Un grand modèle mixture-of-experts, dont la version actuelle est convenue avec vous. Il demande une architecture de serving réfléchie et une évaluation de la charge de travail.
- Le dimensionnement
- Conçu avec vous. Nous évaluons la mémoire GPU, les interconnexions et les options de déploiement avant de convenir d'une configuration ou d'un prix.
- Version et conditions
- Les conditions du modèle sont distinctes de la licence du code du dépôt. Vérifiez la version choisie avant le déploiement.
Un point de départ pour la conversation
Pas encore décidé
- Le modèle
- Partez de ce que l'application doit faire. Nous vous aidons à présélectionner des modèles à tester sur vos propres prompts et documents.
- Le dimensionnement
- Nous examinons avec vous la qualité des réponses, le temps de réponse et le trafic attendu, puis nous convenons ensemble du modèle et du matériel.
- Version et conditions
- La présélection comprend les versions exactes des modèles et leurs conditions, pour que la décision de déploiement soit prise avec tous les détails sous les yeux.
Configuration finale et tarification convenues après le dimensionnement.
L'ingénierie fait partie du service
Nous faisons l'ingénierie.
Vous appelez un endpoint.
Une seule équipe pour le matériel, la stack de serving et l'exploitation quotidienne. Vous apportez la charge de travail, nous travaillons les détails avec vous.
Rencontrer votre équipe supportUn modèle et une machine qui s'accordent
Nous examinons le modèle, la mémoire et la concurrence attendue, puis nous testons la configuration proposée avec vos prompts.
La stack de serving, mise en place
Pilotes GPU, runtime d'inférence et configuration de l'endpoint. Nos ingénieurs prennent en charge l'infrastructure autour de votre modèle.
Un accès à vos conditions
Un endpoint privé avec un accès réseau et une journalisation configurés autour de vos applications et de vos exigences de données.
Infogéré au-delà du déploiement
L'équipe qui met en place la machine reste responsable de l'exploitation et investigue les problèmes sur l'hôte et la stack de serving.
Des mises à jour, avec un plan
Vous gardez une version de modèle choisie. Les changements sont validés et la fenêtre de mise à jour convenue avant de passer à la suivante.
Une capacité qui suit la demande
Nous réexaminons avec vous la mémoire, la longueur de contexte et la concurrence à mesure que l'usage grandit, et nous ajoutons des GPU ou un second hôte quand les chiffres le disent.
Qu'allez-vous faire tourner ?
Quatre charges de travail illustratives. Nous façonnons le modèle, l'accès privé et la capacité autour de votre application.
RAG sur des documents privés
Amenez la récupération (retrieval) et l'inférence sur une infrastructure infogérée. Construisez des réponses à partir de documents approuvés, avec des citations qui renvoient à la source.
- Modèle, embeddings et base de données vectorielle ensemble
- Accès aux documents par VPN ou par réseau privé
Un assistant interne
Donnez à votre équipe un assistant sur une connaissance interne approuvée, avec un accès et une journalisation des prompts configurés autour de votre organisation.
- Une inférence dédiée pour votre équipe
- Journalisation et rétention convenues avec vous
Des fonctions IA dans votre produit
Servez les réponses du modèle via un endpoint que votre application appelle. Nous convenons de la version du modèle et dimensionnons la capacité avec de vrais prompts et la demande attendue.
- Inférence sur votre infrastructure GPU infogérée
- Capacité et concurrence testées pour votre application
Assistance au code sur du code source privé
Faites tourner un modèle de code avec un contexte approuvé issu de vos dépôts et un accès privé. Gardez l'inférence et le code source sur une infrastructure infogérée, avec des complétions renvoyées à votre équipe.
- Fichiers sélectionnés et code récupéré comme contexte
- Accès aux dépôts limité aux utilisateurs autorisés
Un déploiement d'IA privée
Des dossiers médicaux
analysés sans quitter Athènes.
Un client avait besoin d'IA pour analyser des dossiers médicaux : les dossiers de patients entrent, un rapport structuré et cité en sort, et chaque étape tourne sur des modèles locaux, sur les GPU privés du client lui-même, à l'intérieur de Digital Realty Athens. Les données ne touchent jamais un cloud public.
Avant le déploiement
Le modèle n'est
que le début.
Mémoire, accès, coût et exploitation continue. Passons en revue ce dont votre endpoint a besoin.
Poser une question à un ingénieurNous travaillons avec des modèles à poids ouverts (open-weight), dont Llama, Mistral, Qwen et DeepSeek. La version exacte, le logiciel de serving, les besoins matériels et les conditions de licence sont examinés pour votre déploiement. Si vous n'avez pas choisi de modèle, nous pouvons présélectionner des options et les tester sur vos prompts.
Votre prochain partenaire d'infrastructure
Apportez-nous le modèle que
vous voulez faire tourner.
Parlez-nous de votre modèle, de vos données et de votre charge de travail attendue. Nous travaillerons avec vous le matériel, la stack de serving et le déploiement.
+357 222 32280
Commençons par votre environnement.
Un peu de contexte nous aide à démarrer la bonne conversation.
De l'équipe d'ingénierie
La réflexion derrière l'endpoint.
AI Hosting · 8 min read
A 70B model really does fit on a 48GB card, once you count what quantization costs.
Read the articleAI Hosting · 6 min read
Your AI endpoint doesn't have to be on the internet.
Read the articleAI Hosting · 5 min read