

Ce que nous faisons · Stockage et compute: Disaster recovery et réplicas entre sites
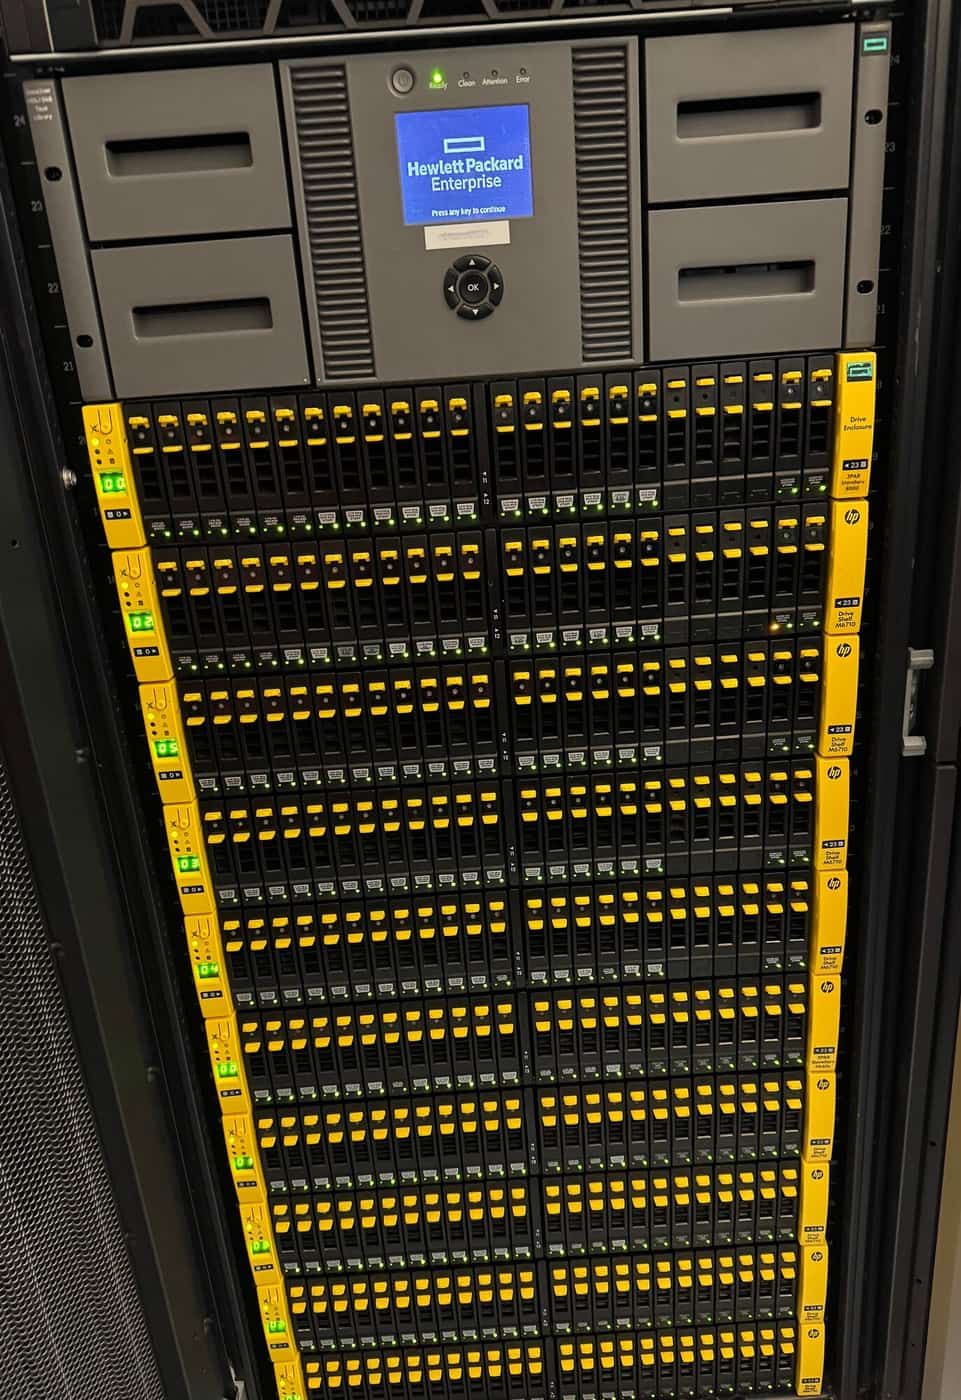
Pour les systèmes critiques, nous conservons une copie mise à jour en continu sur un second site, pour que la reprise après sinistre (disaster recovery) soit une bascule plutôt qu'une restauration, et nous concevons le chemin de réplication, la posture firewall qui l'entoure et la supervision qui nous prévient à l'instant où la copie prend du retard.
De quoi il s'agit
Une conception de reprise adaptée au service que vous commandez. Un service petit et simple reçoit des backups solides et un chemin de retour testé. Une plateforme qui ne peut pas être indisponible reçoit des réplicas en direct dans un autre datacenter, un stockage répliqué entre baies, et un frontal qui continue de servir pendant que l'arrière-plan se rétablit. Le point de reprise et le délai de reprise suivent le service, et nous mettons les vôtres par écrit.
Comment nous le construisons
Des réplicas de base de données en direct sur un second site. Une base de données de production se réplique en continu, par identifiant global de transaction, vers un réplica en lecture seule dans un autre datacenter, par notre backbone privé chiffré.
Pull-only, imposé au firewall. Le côté protégé ne pousse jamais. Les systèmes de réplica et de backup vont chercher en production ce dont ils ont besoin, et les backups sont pris par notre réseau hors bande air-gapped, jamais à travers un segment de production ; la production n'a aucun chemin réseau vers eux et aucun identifiant pour eux. Seul notre réseau d'administration peut atteindre les systèmes de reprise, et tout le reste est explicitement refusé sur les appliances firewall, pas seulement sur les hôtes.
Du stockage répliqué entre pays. En dessous, les volumes peuvent se répliquer de baie à baie entre des baies HPE 3PAR à Athènes et à Amsterdam, sur des ports dédiés, de sorte qu'une copie au niveau bloc de votre plateforme existe déjà dans l'autre datacenter. À l'intérieur de chaque site, les systèmes en cluster gardent chaque membre sur une baie physique différente.
Les données UE restent dans l'UE. Les réplicas et les backups de données hébergées dans l'UE restent dans notre infrastructure européenne.
Chiffré au repos, effacé avec certificat. Le chiffrement au repos est disponible par défaut. Les disques qui quittent le service sont assainis avec Blancco, et nous conservons le certificat d'effacement PDF de chaque disque que nous effaçons.
À l'affût de la dérive. L'état de la réplication est vérifié toutes les quelques minutes, et tout changement d'état, rompu, en retard ou rétabli, déclenche une alerte vers les ingénieurs de garde.
Servir pendant une panne de l'arrière-plan. Pour les propriétés web publiques, la couche de cache est configurée pour continuer à servir du contenu quand le niveau applicatif est indisponible, pour qu'une panne de l'arrière-plan ne devienne pas une panne publique pendant que nous la réparons.
Les backups sous tout cela
Nous sauvegardons les machines virtuelles, les serveurs bare metal Linux et Windows, les serveurs SQL et les nœuds cPanel et Plesk avec Veeam, et les fichiers et bases de données Linux avec un hub de backup dédupliquant qui tire par SSH avec des clés restreintes, en ajout seul. Les dépôts tournent sur XFS avec clonage rapide et un niveau de dépôt durci qui reçoit les travaux de copie. Les plannings sont fixés d'après des durées mesurées pour que les gros travaux ne se télescopent jamais, la couverture est vérifiée contre l'inventaire réel, pas déduite de l'état des tâches, et les restaurations sont testées régulièrement, jusqu'à une fois par semaine.
Ce dont il vous protège
- Perdre votre hôte de base de données principal ou votre site principal.
- Un ransomware ou un intrus qui supprime vos backups depuis le serveur compromis.
- La dérive des réplicas : l'état de chaque réplica est vérifié toutes les quelques minutes.
- Une panne applicative qui se transforme en panne publique.
- Des trous dans la couverture de backup : chaque machine qui doit être sauvegardée l'est, et nous le vérifions par rapport à ce qui tourne.
En pratique
Un site d'information qui a continué de servir avec son arrière-plan coupé. Pour un éditeur de presse, nous avons configuré le niveau de cache pour servir du contenu périmé en cas d'erreur pendant une journée entière, puis nous l'avons prouvé : l'arrière-plan a été délibérément marqué en échec et les pages en cache ont continué d'être servies normalement aux lecteurs.
Un cluster de bases de données conçu pour perdre une baie. Pour un client d'analytique, le volume de données de chaque membre du cluster réside sur une baie physique différente, de sorte que la perte d'une baie entière coûte un réplica et que la base de données continue de servir sans aucune bascule.
Pourquoi EuroVPS
- Backup et réplication pull-only, imposés sur le firewall, sans exception.
- Une reprise conçue et documentée par service.
- Des réplicas et des backups supervisés pour leur fraîcheur, pas supposés à jour.
- Une réplication de baie à baie entre Athènes et Amsterdam, avec les données UE conservées dans l'UE.
- Une conception alignée sur les recommandations ISO 27001, NIS2 et NIST en matière de protection des frontières.
Questions fréquentes
- Quels RPO et RTO vais-je obtenir ? Cela dépend du service que vous commandez. Les services de base reçoivent des backups et un chemin de restauration défini ; les services avec couverture multi-site reçoivent des réplicas en direct et une bascule. Nous mettrons les vôtres par écrit.
- Pourquoi pull-only ? Si la production pouvait pousser vers le backup, un attaquant présent en production pourrait atteindre le backup. En pull-only, ce chemin n'existe pas.
- Mon réplica peut-il se trouver dans un autre pays ? Oui. Athènes et Amsterdam se répliquent l'une vers l'autre, de baie à baie et de base de données à base de données, sur notre propre réseau privé. Les données hébergées dans l'UE restent dans notre infrastructure européenne.
- Testez-vous les restaurations ? Oui, régulièrement, jusqu'à une fois par semaine, et nous vérifions la couverture par rapport à ce qui tourne réellement, pas par rapport à ce que dit la tâche de backup.
- Mes données sont-elles chiffrées au repos ? Oui, par défaut. Et quand un disque quitte le service, il est assaini avec Blancco, avec un certificat d'effacement conservé pour ce disque.
- closing line: La reprise se conçoit avant le mauvais jour, pas pendant. Parlez à un ingénieur de ce dont vos services ont besoin.
- CTA: Parler à un ingénieur
Votre prochain partenaire d'infrastructure
Examinons votre environnement.
Dites-nous ce que vous faites tourner aujourd'hui et ce qui doit s'améliorer. Un ingénieur examinera votre demande et vous aidera à planifier la suite.
+357 222 32280
Commençons par votre environnement.
Un peu de contexte nous aide à démarrer la bonne conversation.