

Desde 2004: Sem compromissos
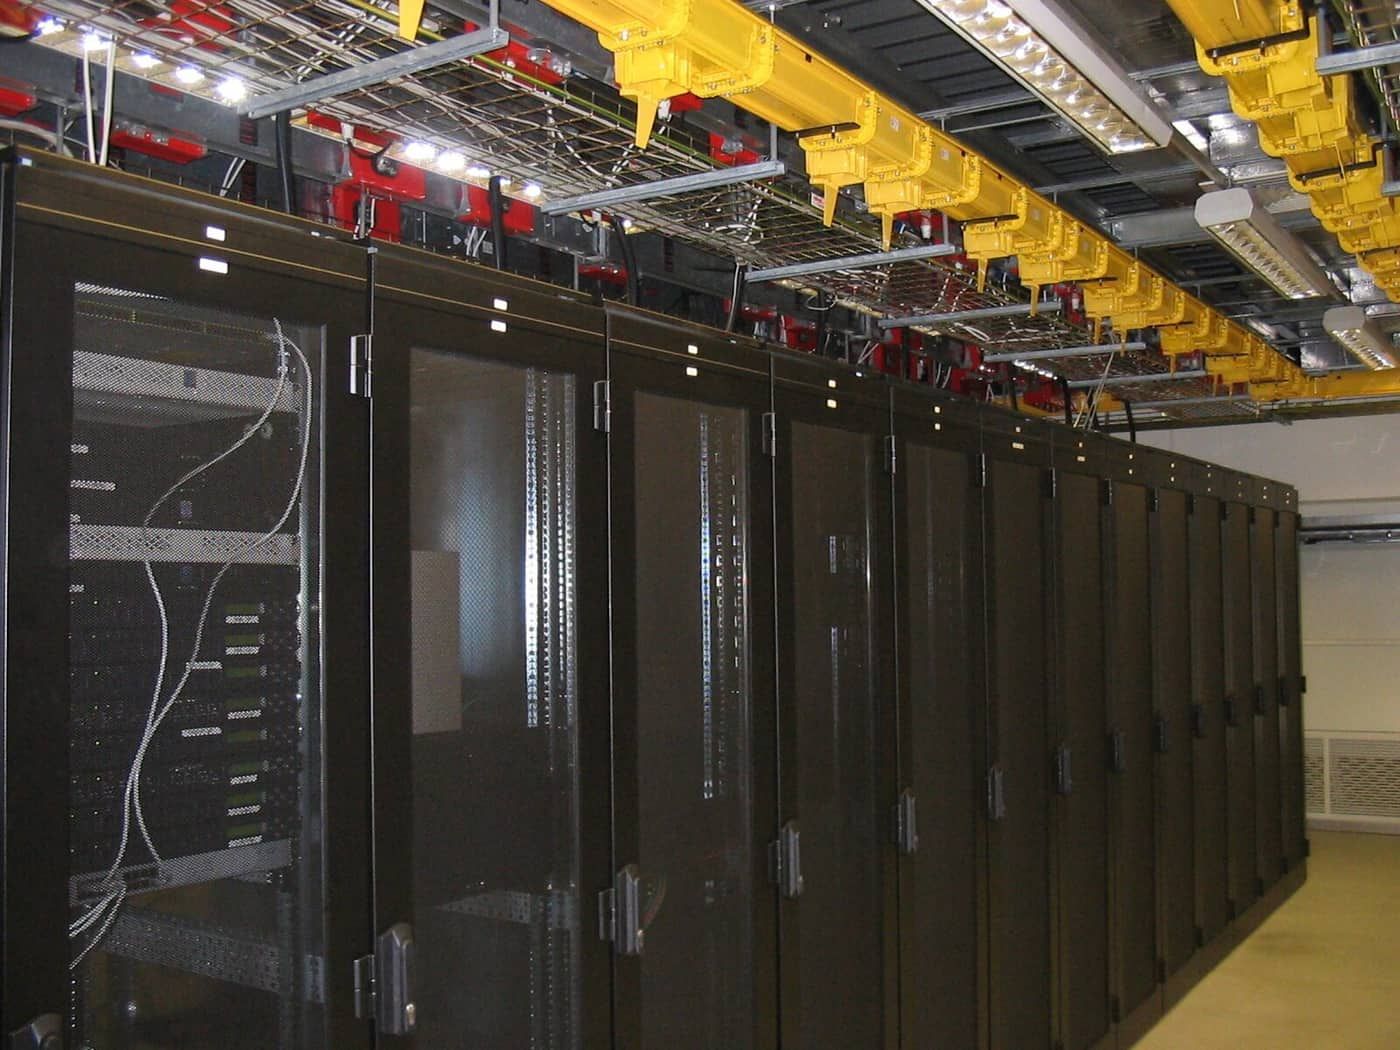
Em 2004 a EuroVPS era uma máquina. Não uma máquina barata.
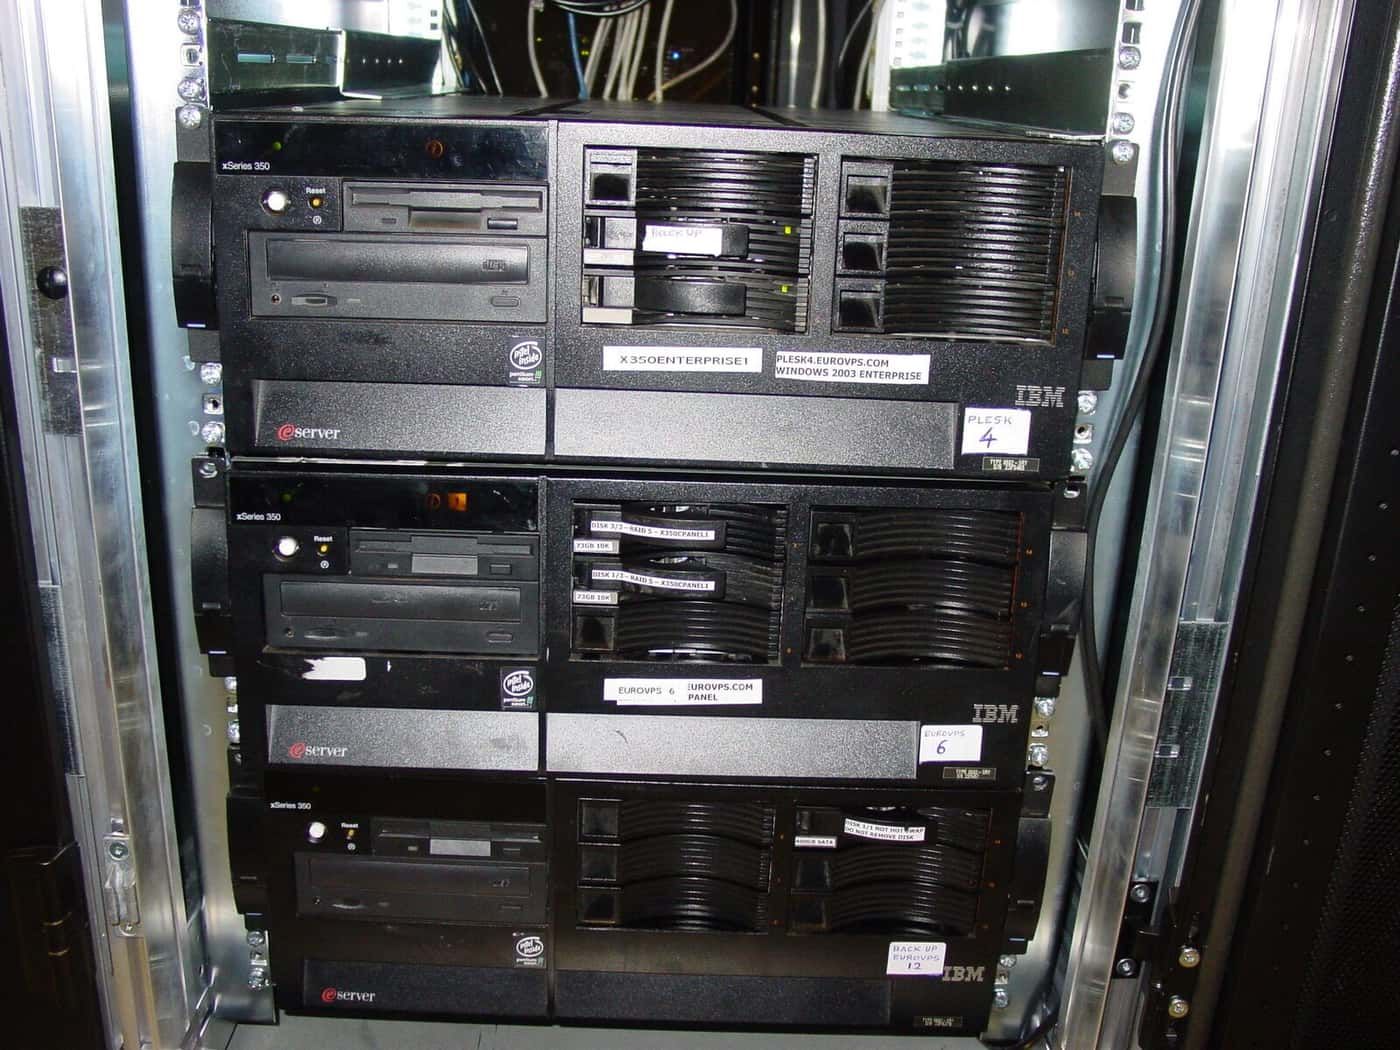
Era um IBM xSeries 350: um servidor de quatro sockets, de classe enterprise, comprado a pronto e levado à mão para uma sala de colocation em Amesterdão. A máquina mais barata que teria feito o trabalho custava uma fração do que pagámos. Comprámos o xSeries na mesma, e a razão é a única política de empresa que alguma vez tivemos: começa-se com a melhor máquina que se consegue pagar, não com a mais barata que funciona.
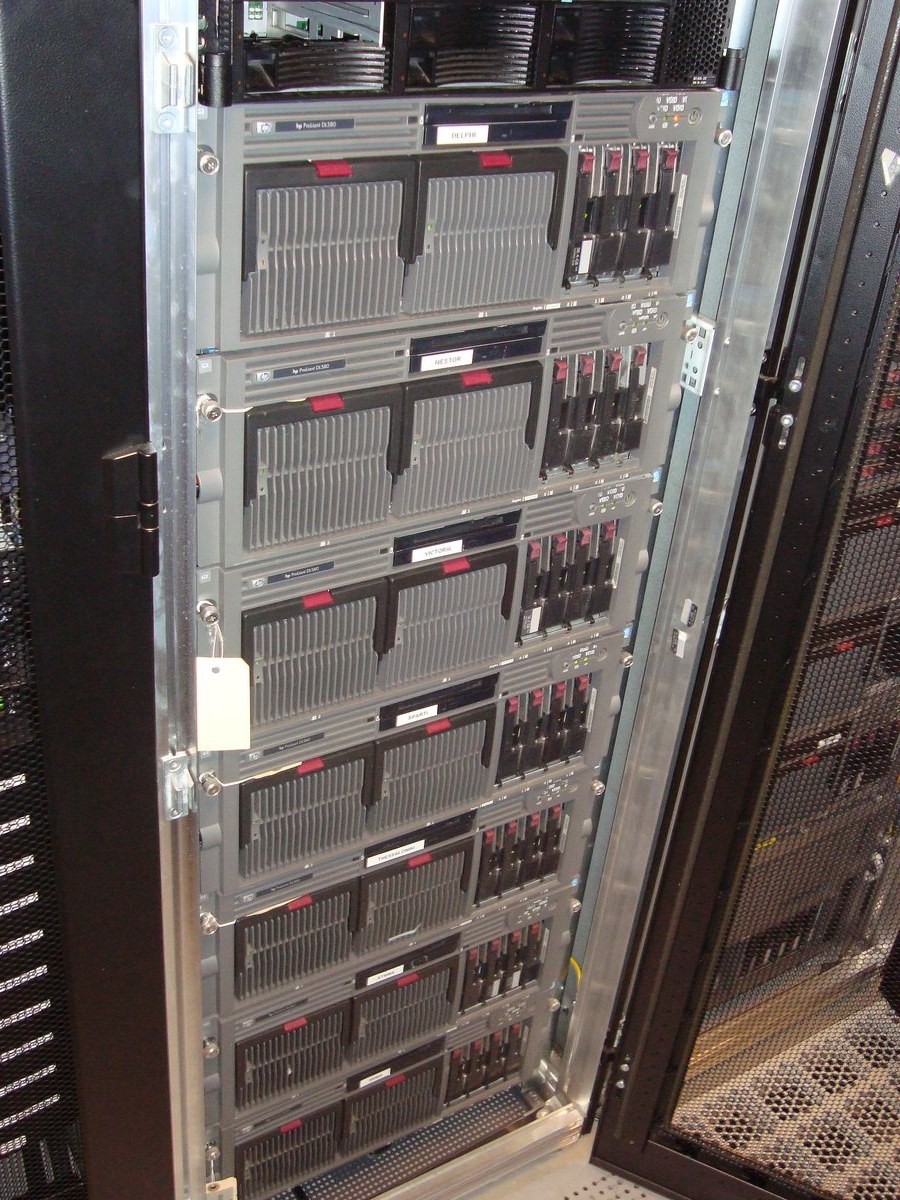
Corria Plesk. As etiquetas que imprimimos para a frente daquela primeira stack ainda se leem nas fotografias: o hostname em cada máquina, a disposição do RAID nas baias dos discos, e um chassis marcado BACK UP. Um servidor, já etiquetado baia a baia, com uma máquina separada já a fazer backups. Nada na forma como trabalhamos hoje é uma invenção posterior. São os mesmos hábitos, com mais hardware.
Os anos de Amesterdão
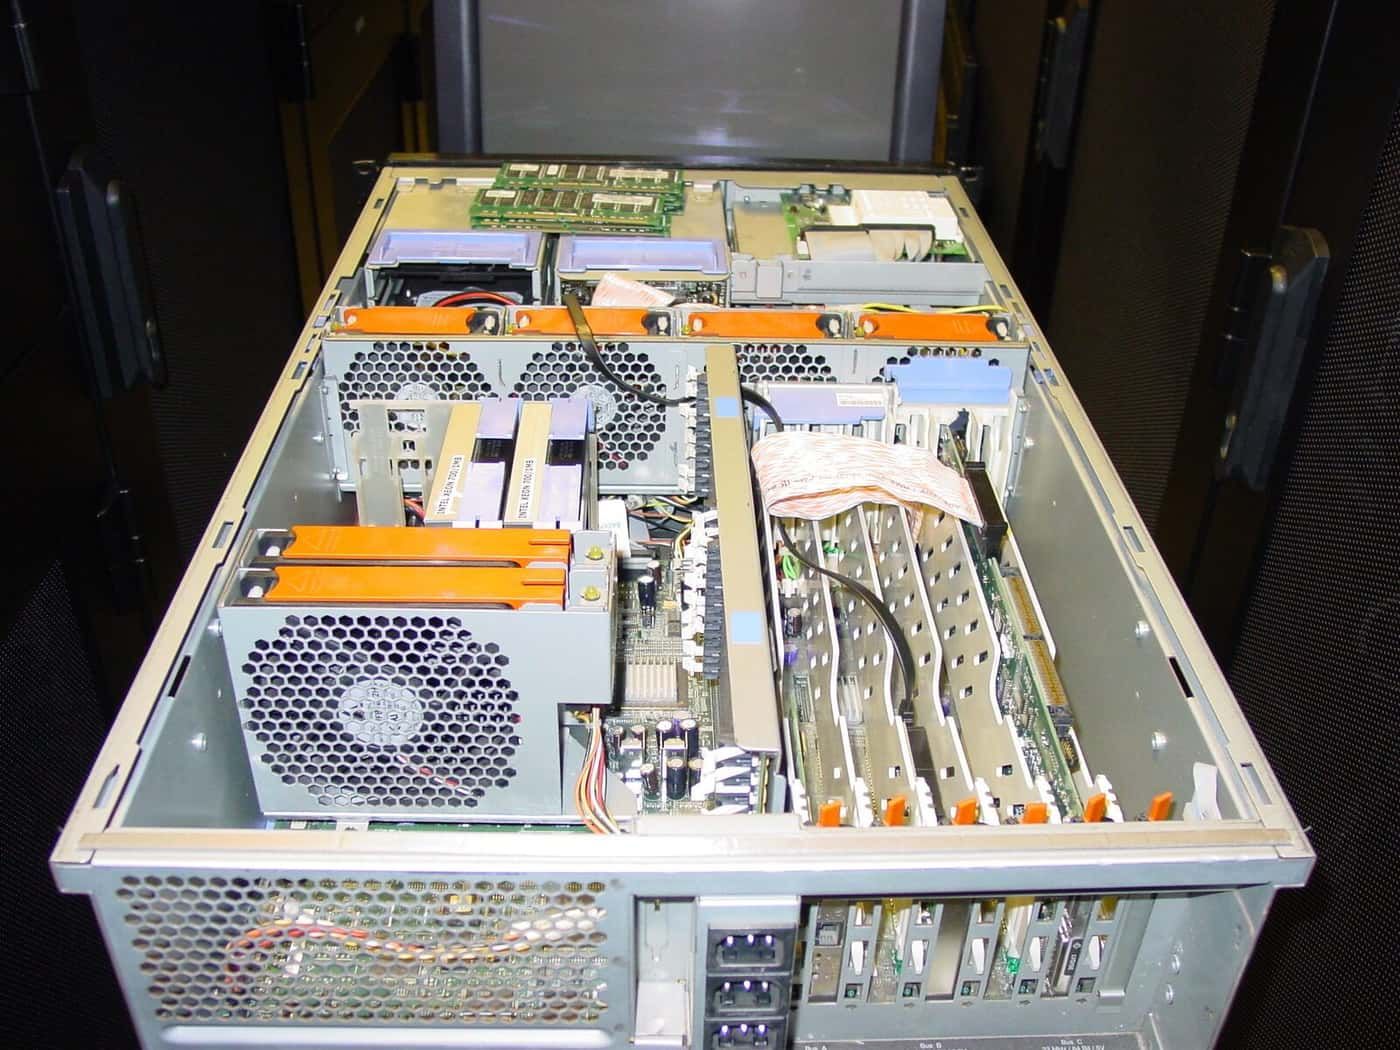
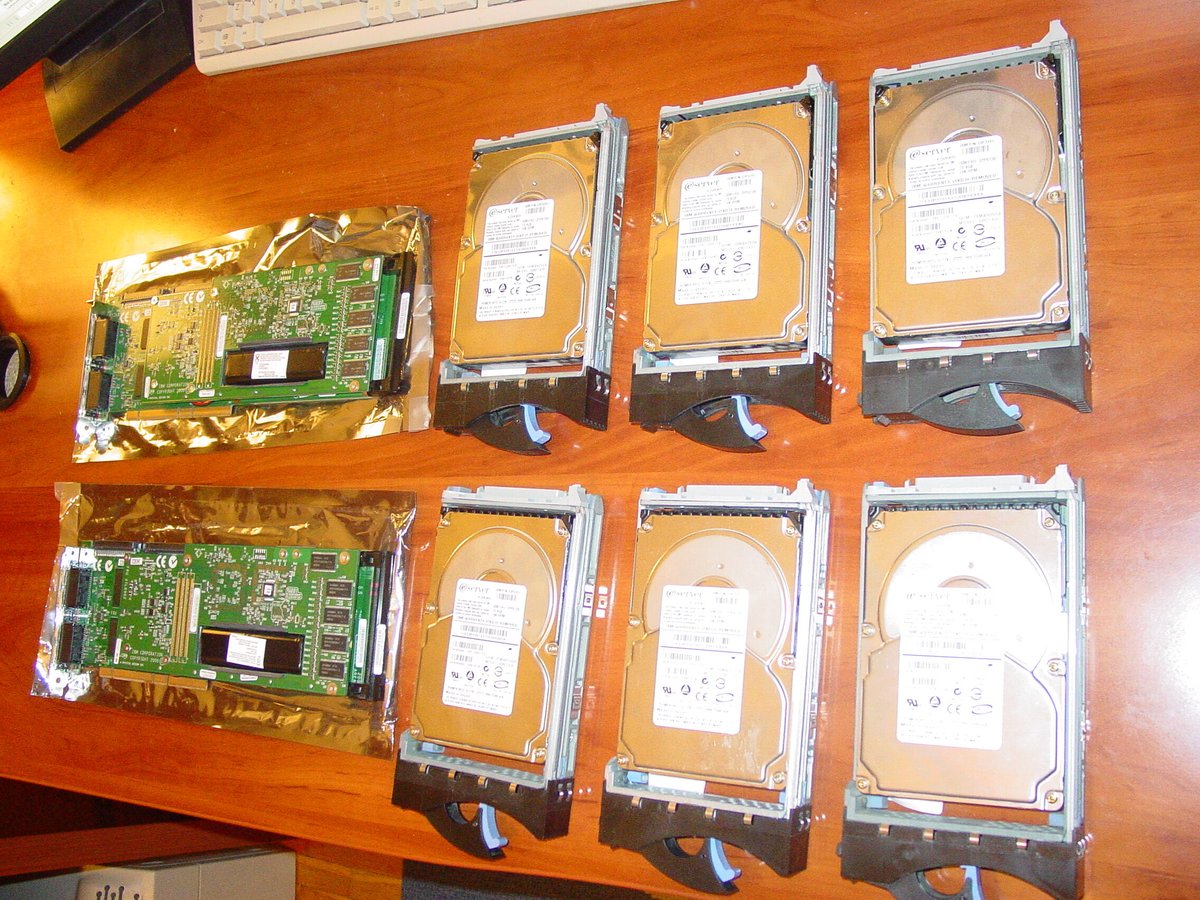
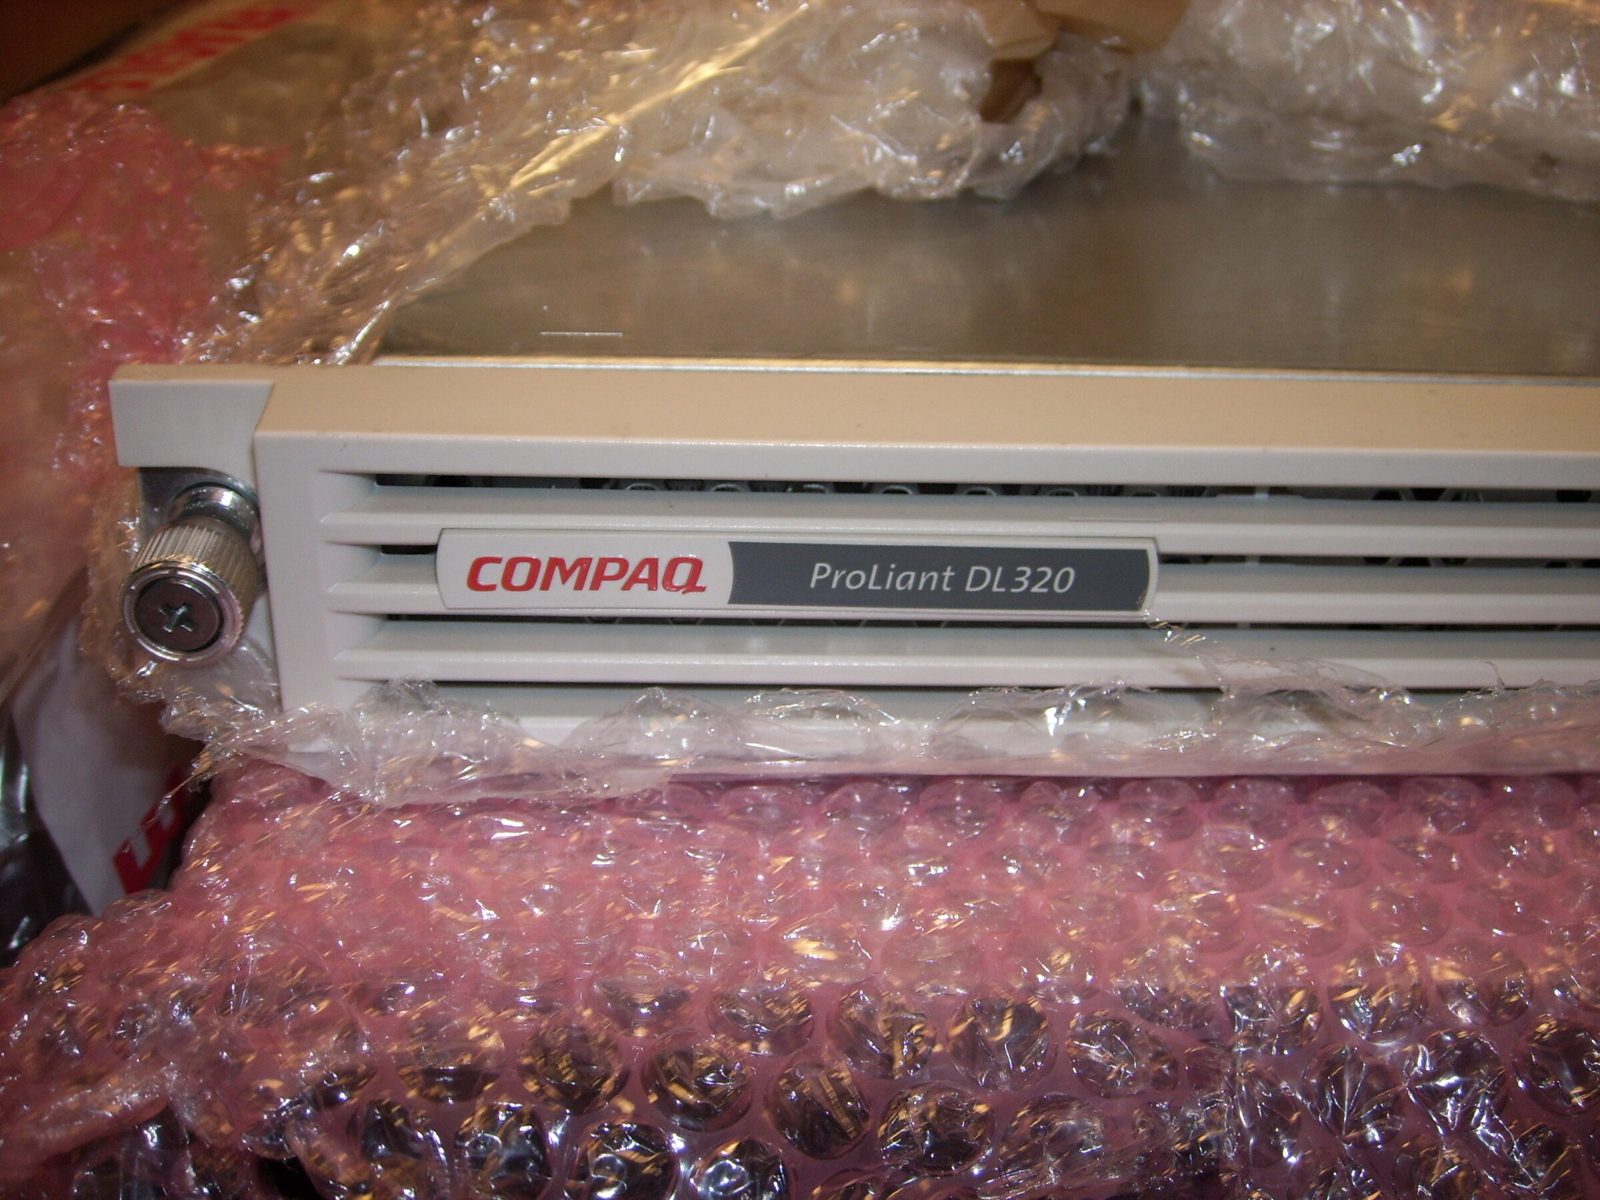
Os primeiros anos foram um corredor, um crash cart e um portátil no chão. IBM xSeries primeiro, depois Compaq e HP ProLiant lado a lado durante a maior parte da década, comprados novos e desembalados entre os bastidores. O storage passou cedo para arrays enterprise, EMC CLARiiON sobre fabrics Fibre Channel duplos, com Cisco no core, porque preferimos pagar o segundo caminho a explicar um dia porque não havia um. Seguiram-se os chassis de blades, depois colunas inteiras deles, e a instalação cresceu para cages nossas na Iron Mountain.

Atenas, Amesterdão, Toronto
O site principal hoje é a nossa própria cage no Digital Realty Athens: routers nossos, storage all-flash, fibra até cada porta, construída como o primeiro rack foi construído, por nós. Amesterdão continua, ligada a Atenas por Layer 2 privado, para que as duas se comportem como uma única rede e se possa mover entre elas sem renumerar nada. Toronto cobre a América do Norte a partir da Cogent. A nossa sede corporativa fica no Chipre.

Um sistema operativo, do princípio ao fim
O nosso primeiro servidor corria Red Hat Enterprise Linux, e mantivemo-nos nele em todas as versões principais desde então. Não porque estivesse na moda: um sistema operativo com um ciclo de vida publicado, pacotes assinados, SELinux em enforcing e um fornecedor que responde por cada atualização é a decisão que nunca temos de revisitar.
Duas décadas numa única plataforma são, por si só, um investimento. Cada build, cada regra de hardening e cada runbook de upgrade que temos foi escrito uma vez e melhorado desde então, em vez de ser deitado fora com cada nova distribuição do mês.
Também retribuímos. A partir de 2005 mantivemos um mirror público para o projeto CentOS, gratuitamente, a partir da nossa própria rede, para que qualquer pessoa no mundo pudesse instalar e atualizar o CentOS com largura de banda da EuroVPS.
Sim, patrocinamos um desktop. Atualmente doamos três servidores HPE ProLiant ao projeto KDE. Os nossos engenheiros correm KDE Plasma em Red Hat Enterprise Linux há mais tempo do que alguns dos nossos clientes existem. Quando as pessoas que escolhem o hardware se importam tanto com uma ferramenta, a ferramenta recebe servidores.
Qualidade acima do lucro
Vimos de uma época em que a maximização das margens ainda não era o mantra.
A EuroVPS não tem venture capital, não tem investidores externos e não tem plano de saída. Nunca ninguém nos disse para tirar um custo de uma plataforma para um trimestre parecer melhor, porque não há trimestre a embelezar nem ninguém para quem o embelezar. A empresa é dirigida pelas pessoas que a construíram, servidor a servidor, com as próprias mãos.
Isto não é sentimentalismo, é um processo de decisão. Cada escolha técnica aqui é resolvida pelo mérito de engenharia e pelo que nos vai custar sermos acordados, não pelo que faz a uma margem. Quando uma empresa de hosting aceita dinheiro de fora, acaba por ter de devolver alguma coisa, e o que é devolvido é quase sempre a parte que não se vê: a segunda alimentação elétrica, a ótica original, a peça sobresselente na prateleira, o engenheiro sénior às três da manhã. Nós mantivemos as quatro, porque as pessoas que decidem aqui são as pessoas que recebem o alerta.
O que recusamos comprar
Somos uma empresa de hosting, por isso o hardware não é uma linha de custos que tentamos encolher. É o produto. Quase tudo o que torna barato o hosting barato reduz-se a uma pequena lista de componentes, e nenhum deles fica por baixo de uma carga de trabalho de um cliente nosso.
Discos SATA
Uma porta, um caminho, um controlador: um ponto único de falha por construção, e nenhuma camada de software por cima consegue inventar um segundo caminho. O SATA tem filas pouco profundas e recupera mal de erros, pelo que um disco de classe desktop pode ficar a tentar reler um setor fraco enquanto tudo acima dele espera. O SAS enterprise tem duas portas, reporta os seus contadores de erros com honestidade e devolve o controlo depressa o suficiente para a camada RAID fazer o seu trabalho.
SSD SATA
A mesma porta única, a mesma fila pouco profunda, numa interface construída para discos rotativos. Pôr flash atrás de SATA significa pagar o meio e depois deitar fora a maior parte do que ele oferece. Esse mercado é também esmagadoramente de consumo: baixa resistência, nenhuma segunda porta, muitas vezes nenhuma proteção contra perda de energia.
Pens M.2 NVMe de consumo
As pens de consumo normalmente não trazem condensadores de proteção contra perda de energia, pelo que uma escrita em curso quando a energia falha é uma escrita que pode nunca mais ser vista, e a sua resistência é especificada para um desktop, não para uma base de dados que escreve o dia inteiro. Corremos muito NVMe, como discos enterprise U.2 e U.3 com proteção contra perda de energia em suportes hot plug. Nunca como uma pen colada a uma placa a guardar a única cópia.
Placas de um único socket, de classe desktop
Um socket, uma fonte, nenhuma gestão out-of-band digna do nome, e demasiado poucas lanes PCIe para suportar ao mesmo tempo um HBA Fibre Channel de duas portas e rede redundante. Também não há backplane hot plug, pelo que cada falha de componente é um desligar. O desenho diz uma coisa: se isto avariar, o serviço fica avariado até alguém ir lá de carro.
Uma única fonte de alimentação
Uma fonte transforma trabalho programado no datacenter numa interrupção para o cliente.
Memória sem ECC
Não corremos uma carga de trabalho em memória que não nos consegue dizer que está a falhar.
Software RAID como história de resiliência, e servidores white box
Não assentamos dados de clientes no software RAID de uma única caixa, com uma write cache desprotegida e paridade reconstruída no CPU do host. A resiliência pertence ao array e aos fabrics redundantes, onde sobrevive à perda total do servidor. O white box recebe a mesma resposta: nenhum ciclo de vida de firmware, nenhuma peça sobresselente na prateleira, ninguém a quem ligar.
Na prática. Não tomamos nada como certo a partir de um nome de dispositivo ou de uma predefinição do kernel: interrogamos o controlador RAID e os discos diretamente, por dois caminhos independentes, e afinamos com base no que cada dispositivo realmente reporta.
O que compramos em vez disso
HPE ProLiant e Dell PowerEdge: ProLiant DL380 Gen10 e Gen11, DL385 Gen11 e blades BL460c Gen10. PowerEdge R740, R750 e R7525, e C6400 para computação densa. A mesma base em cada um deles.
- Duas fontes de alimentação hot plug em duas alimentações independentes.
- Memória ECC em toda a linha, com os contadores de erros corrigíveis vigiados.
- Hardware RAID com write cache protegida por bateria ou flash sempre que um servidor guarda discos locais, para que um evento de energia não custe uma escrita confirmada.
- SSD SAS 12G enterprise e NVMe enterprise, colocados onde a medição diz que pertencem.
- Gestão out-of-band em todas as máquinas, numa rede de gestão fisicamente isolada (air-gapped) encaminhada pelo seu próprio sistema autónomo, completamente separado.
Hosts que arrancam do SAN e não guardam nada
Os nossos hypervisors arrancam de um volume no array, apresentado por dois fabrics Fibre Channel fisicamente separados. O servidor em si não guarda dados de clientes, pelo que um blade avariado nos custa um blade: o substituto arranca do mesmo volume. Isso é uma troca de peça, não uma recuperação de dados.
Máquinas que nunca atravessam um socket
Regra da casa, e não negociável: uma máquina virtual nunca recebe mais vCPU do que os cores físicos de um socket, e nunca mais memória do que a que um nó NUMA serve. Ao estender-se por dois sockets, parte do tráfego de memória torna-se remoto, a cerca de 1,7 vezes a latência local, antes ainda do tráfego de coerência de cache através da interligação entre sockets. A penalização acumula-se em vez de se diluir, e é por isso que uma máquina dimensionada para lá do limite do socket corre muitas vezes mais devagar do que a mais pequena que substituiu.
Flash enterprise não é RAM
As nossas máquinas virtuais não têm swap. O swap numa VM empurra a pressão de memória para baixo, para o array, e gasta resistência de escrita do flash que existe para servir dados reais. Se uma aplicação precisa de mais memória, a resposta honesta é mais memória, ou uma correção na aplicação. Dir-lhe-emos qual das duas.
Afinados, não entregues com as predefinições
Os volumes em flash recebem o scheduler, o read-ahead e a profundidade de fila certos, não heurísticas escritas para discos rotativos. Ganhos pequenos e permanentes, em cada build.
Storage: HPE 3PAR, all-flash, dois de tudo
Os dados dos clientes vivem em HPE 3PAR, all-flash, em grupos de provisioning SSD RAID 6. RAID 6 porque o rebuild de um disco flash grande é uma janela, e não a vamos passar a uma falha de distância da perda de dados.

Dois controladores, dois fabrics, muitos caminhos
Controladores duplos por array. Cada host liga-se através de dois fabrics Brocade Fibre Channel fisicamente separados, uma porta HBA em cada um, e é registado com a persona correta para que o multipathing e o ALUA se comportem como o sistema operativo espera. Um controlador, um fabric, uma ótica ou uma porta HBA podem desaparecer e o volume mantém-se online.
Thin que diz a verdade, volumes que se movem em utilização
Os volumes são thin com zero detect automático, pelo que um disco de guest totalmente provisionado custa fisicamente quase nada até chegarem dados reais. Os arrays estão em federation, pelo que migramos um volume ao vivo de um array para outro enquanto o host continua a ler e a escrever nele. Para bases de dados em cluster vamos mais longe e colocamos cada membro num array físico diferente, para que a perda de um array inteiro custe uma réplica e o quórum se mantenha.
Higiene dos discos, e disciplina nas escritas
Um disco que reporta um erro corrigido é um disco cuja correção de erros interna já está a trabalhar, sob tráfego real de clientes. Não esperamos que falhe: é esvaziado até zero, retirado, substituído por um disco limpo, e o array admite o novo automaticamente.
Os backups puxam, e a recuperação acompanha o serviço
Os backups são exclusivamente pull. Os sistemas protegidos não têm rota para a infraestrutura de backup nem credenciais para ela, pelo que um comprometimento do lado da produção não consegue chegar aos backups. O lado seguro estende a mão e leva o que precisa, nunca o inverso. Os objetivos de recuperação são definidos por serviço, não como um número único para toda a casa: um site estático e uma base de dados transacional não merecem a mesma resposta.
Um fornecedor pode substituir mais tarde o storage, os servidores e o software. O que não se corrige depois é a cablagem, as óticas e os routers sobre os quais foi construído, por isso acertámos nesses primeiro.
Fibra de ponta a ponta
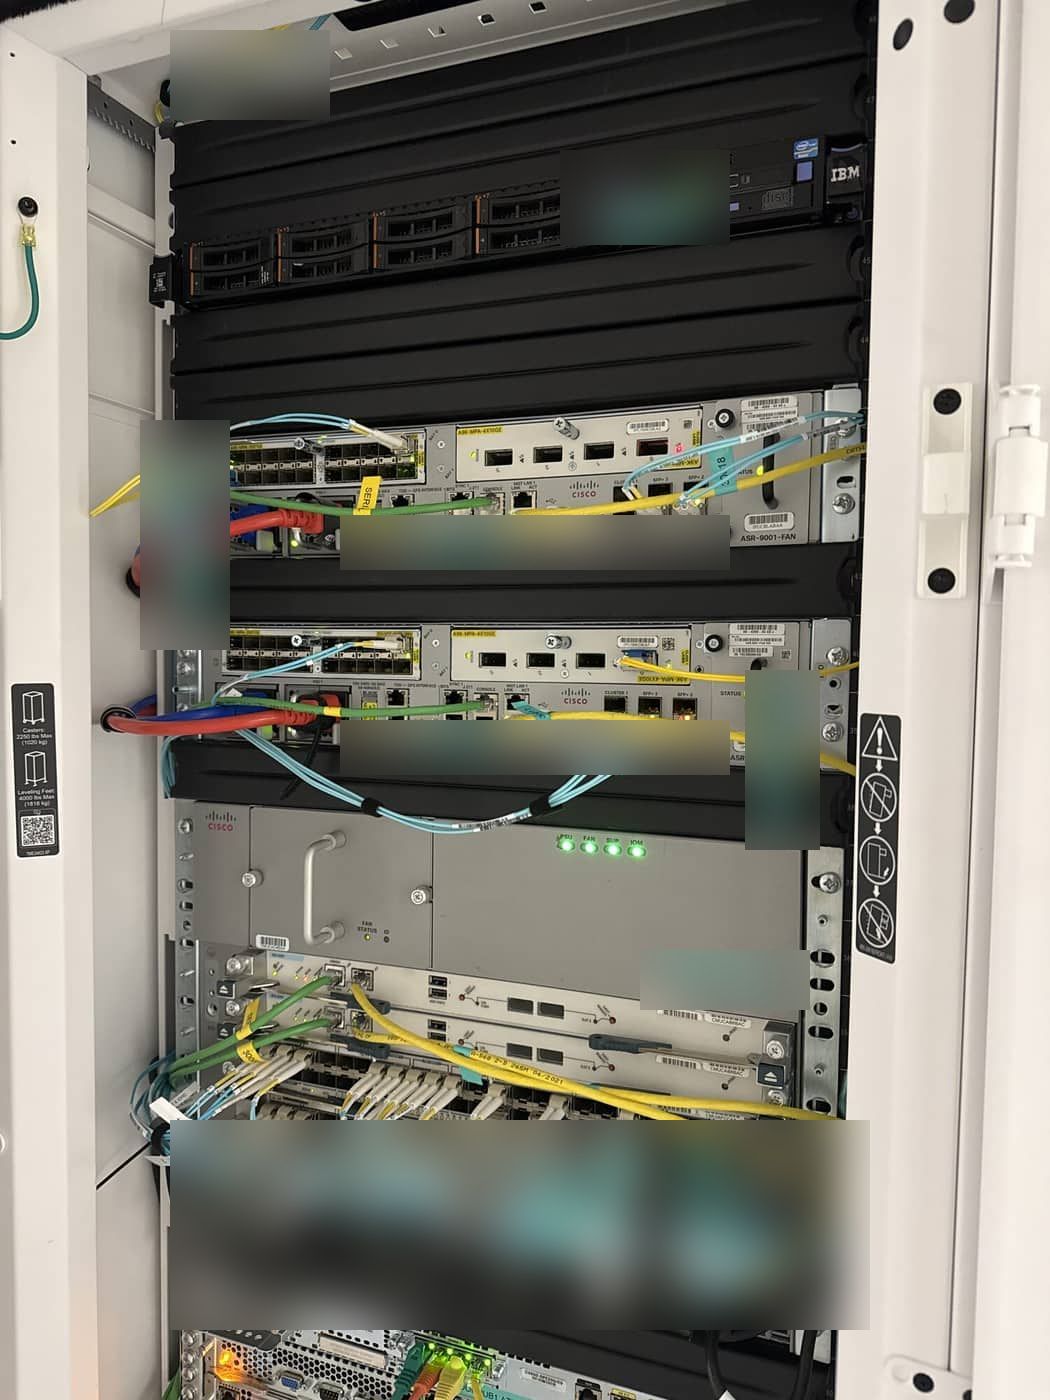
Não há cablagem de dados em cobre na nossa cage de Atenas. Cada servidor, cada chassis de blades, cada array de storage, cada switch e cada router está ligado por fibra ótica. O único cobre que resta num bastidor é o troço curto até à porta de gestão lights-out de um servidor, e isso é deliberado: é a única interface cujo trabalho é funcionar quando tudo o resto está desligado.
O vidro ganha em todos os eixos que importam num bastidor. Uma ligação ótica não se importa com ruído elétrico nem com o cabo de alimentação que está ao lado, pelo que uma ligação ou está certa ou está ausente, nunca misteriosamente marginal, e um troço atravessa o rack, a fila e a sala com a mesma especificação. O cobre de alta velocidade é grosso, pesado e relutante em dobrar, e essa massa acaba pendurada no switch que serve, à frente da sua exaustão. A fibra é fina e leve, por isso os bastidores mantêm-se limpos. E quando chega a geração seguinte de velocidades, a planta fica onde está: trocamos o transcetor em cada extremidade e mantemos o cabo.
Na prática. Antes do lançamento de novas plataformas de clientes, construímos toda a topologia de fibra e de port-channel de um rack de blades antes de a maioria dos blades existir. O dia do lançamento foi um ligar, não um trabalho de cablagem.

Apenas óticas originais
Cada SFP, SFP+ e QSFP nos nossos racks é a peça do próprio fabricante, combinada com o switch ou o router em que está e suportada pelo fornecedor cujo nome está no chassis. Nunca comprámos um transcetor genérico e não vamos começar agora.
A poupança é pequena e compra quatro problemas: leituras óticas que podem não significar nada, custando-lhe o melhor diagnóstico numa rede ótica, o nível de luz ao vivo em cada extremidade. Um módulo que funciona numa versão de software e se porta mal na seguinte, porque ninguém testou essa combinação. Um motivo legítimo para um fornecedor fechar o pedido de suporte que abre na noite em que mais precisa dele. E uma ligação que oscila (flap) sob carga por razões que ninguém consegue reproduzir. Por isso compramos a peça certa, e compramos sobresselentes: tabuleiros de óticas na prateleira, dentro do datacenter, para que uma substituição seja um passeio pelo corredor em vez de uma ordem de compra.
Na prática. As nossas verificações de saúde de rotina leem os contadores de erros de interface e óticos em todo o fabric, e porque cada módulo é o original do fornecedor, o que eles reportam pode ser acionado: um transcetor a desviar-se da especificação é uma troca planeada a partir do tabuleiro, ao nosso ritmo.


O fabric: leaf e spine, EVPN e VXLAN
Dentro do datacenter tudo está pendurado num fabric leaf e spine Cisco Nexus 9000 a correr BGP EVPN com VXLAN. Os spines são route reflectors puros, sem endpoints de túnel, por desenho. Os leaves são construídos como pares de virtual port-channel, pelo que cada host está dual-homed a dois switches através de um único bond lógico, e o gateway de uma sub-rede de cliente é o mesmo endereço anycast em todos os leaves. O tráfego de broadcast é replicado pelo BGP em vez de por uma árvore multicast, e o BFD corre onde a deteção rápida importa. Como qualquer VLAN pode viver em qualquer leaf, podemos estender o Layer 2 de um cliente entre os nossos datacenters e deixar os seus servidores manter os endereços enquanto se movem.
O identificador de rede de cada segmento Layer 2 é derivado da sua VLAN local por uma regra fixa, e essa regra não é uma convenção num documento. Uma verificação automatizada lê o mapa de todos os leaves, confirma que os leaves são idênticos e obedecem à regra, e compara uma impressão digital criptográfica do mapa inteiro com uma baseline assinada em controlo de versões. Corre antes de qualquer alteração ser guardada e de forma agendada depois, um desvio alerta um engenheiro, e uma alteração intencional tem de ser reassinada, pelo que cada alteração ao fabric traz um autor e um rasto de auditoria.
Na prática. Num teste de falha controlado, reiniciámos um nó de cluster enquanto era o caminho preferido para um endereço público ao vivo. O fabric convergiu para um nó saudável em cerca de três segundos, e o endereço nunca saiu da tabela de routing.

O edge: os nossos próprios sistemas autónomos
Operamos o nosso próprio edge de internet, em sistemas autónomos nossos registados no RIPE e com espaço IPv4 e IPv6 nosso, com a produção dos clientes e os serviços de plataforma em sistemas autónomos separados, para que um problema num não possa chegar ao outro. Os routers são de classe carrier: Cisco ASR 9000 series em Atenas, um ASR 9006 à frente do edge de produção, e Juniper MX204 em Amesterdão, cada um com a tabela de routing completa da internet, trocada com o seu par.
Compramos trânsito a vários carriers em vez de alugar uma porta a quem é dono do edifício: OTE Globe, Cogent e Hurricane Electric em Atenas, Arelion, NTT, Deutsche Telekom e Telecom Italia do lado de Amesterdão, com os dois sites ligados por Layer 2 privado para que a instalação se comporte como uma única rede. Fazemos peering direto no GR-IX e no NetIX, e acrescentamos sessões bilaterais uma a uma com as redes com que os nossos clientes realmente falam.
O IPv6 é nativo em todo o lado: dual-stack dos routers de edge até ao seu gateway, sem túneis e sem tradução no caminho.
Na prática. O nosso fabric de Atenas passou a dual-stack num único dia de trabalho, do edge de internet, através do fabric, até uma VLAN partilhada de clientes ao vivo.

Fibre Channel: dois fabrics, nunca um único caminho
A rede entre servidores e storage é Fibre Channel, não Ethernet, construída como dois fabrics Brocade completamente independentes. Cada servidor e cada array estão ligados a ambos, cada fabric com o seu próprio switching de core e o seu próprio switch dentro de cada enclosure de blades, para que nenhum switch, cabo, porta ou falha de software exista em ambos os lados do caminho de um host.
Na prática. Como cada host já tem caminhos ao vivo para todos os arrays da sua federation em ambos os fabrics, conseguimos esvaziar um array de storage inteiro, para manutenção ou para uma mudança, sem reiniciar uma máquina de cliente e sem janela de manutenção.
O backbone encriptado entre os nossos sites
Os nossos datacenters em Atenas, Amesterdão e Toronto, a nossa sede corporativa no Chipre e os nossos pontos de presença regionais estão ligados por um overlay Cisco DMVPN: túneis GRE multiponto protegidos por IPsec com AES-256, NHRP autenticado, BFD, e BGP sobre os túneis. Cada datacenter tem hubs redundantes, e como o overlay é encaminhado pelo BGP e não por tabelas estáticas, perder um hub ou um circuito é uma retirada de rota que converge sozinha.
Um site com dois circuitos WAN corre uma segunda cloud DMVPN no mesmo router, pelo que o segundo circuito não precisa de novo endereço público nem de alteração nos hubs, e o BGP multipath distribui o tráfego por ambos com um hash de encaminhamento que inclui portas, para que os fluxos paralelos se dividam de facto. Dimensionamos em função do que o motor de encriptação consegue realmente fazer, cerca de 11 Gbit/s por hub, não do número impresso numa licença, e escalamos com equal-cost multipath entre hubs até 30 a 40 Gbit/s quando um cliente precisa.
Na prática. Num site com dois circuitos, um teste de débito mediu mais em cada sentido do que qualquer um dos circuitos conseguiria transportar sozinho. Essa é a única prova aceitável de que o equal-cost multipath está a funcionar e não apenas configurado.
A disciplina que vem com isso
Bonds que usam as duas ligações. A predefinição de bonding do Linux faz hash por endereços MAC, o que num datacenter empilha os fluxos num membro do bond e deixa o outro parado. Cada servidor com bond que construímos faz hash por layer 3 e layer 4, com o lado do switch configurado a condizer. Verificamos os contadores por porta em cada build para provar que ambas as ligações transportam tráfego.
Cada porta registada. Não um nome numa linha: a porta com o seu endereço MAC real, a ligação à porta do switch do outro lado com o identificador do cabo, a posição no rack, os endereços e a interface de gestão. O dispositivo ao vivo é a fonte da verdade e os registos são feitos para corresponder a ele.
Um registo reverso para cada endereço. Cada endereço que atribuímos a uma interface, a um loopback, a um serviço ou a um host recebe um PTR no nosso próprio DNS autoritativo, na mesma sessão. Um traceroute através da nossa rede lê-se como uma frase que nomeia o dispositivo, a sua função e o seu site.
O plano de gestão, e o air gap
O tráfego de clientes e o tráfego de gestão não partilham nada: nem uma porta, nem um switch, nem um endereço, nem uma rota.
Resta exatamente um cabo de cobre nos nossos bastidores: a porta de gestão do controlador lights-out de cada servidor. É também o cabo mais cuidadosamente isolado do edifício.
Gestão out-of-band em todas as máquinas
Cada servidor que operamos é um verdadeiro servidor enterprise com um verdadeiro controlador lights-out: iDRAC Enterprise com licença Datacenter nos Dell, iLO Advanced nos HPE, ambos comandados por Redfish, e cada chassis de blades através do seu Onboard Administrator. Não uma placa-mãe white box cuja ideia de gestão remota é um botão de energia e nenhuma consola.
Nos chassis de blades, o Onboard Administrator chega a todos os controladores do enclosure através do backplane, e é ele próprio um par redundante com failover automático.
Na prática. Quando um rack de chassis de blades precisou de licenças iLO Advanced, e de uma conta de gestão criada em cada blade, não entrámos num único blade. Fizemo-lo através do Onboard Administrator de cada chassis e o rack ficou pronto em minutos, incluindo blades instalados nessa semana que ainda não tinham credenciais próprias. É um runbook.
A rede de gestão não é a rede de produção
O controlador tem a sua própria porta física e o seu próprio cabo até ao seu próprio switching. Não particionamos uma placa de rede de produção para o controlador pedir emprestada uma fatia dela, que é o atalho habitual e a razão habitual para a gestão acabar a um erro de distância da internet. A gestão vive nos seus próprios switches, ou nas suas próprias VLAN em fabrics que não transportam mais nada, em espaço de endereçamento privado que não é encaminhado de ou para nenhuma rede de cliente e nunca é anunciado à internet.
Chamamos-lhe air gap porque é assim que se comporta. Uma máquina virtual de cliente, mesmo totalmente comprometida, a fazer scan a line rate durante uma semana, não consegue ver de todo um iLO ou um iDRAC. Não recusado, não filtrado: ausente. Os pacotes não têm para onde ir. Também se verifica no sentido inverso, e isso importa tanto quanto: nenhum tráfego de gestão viaja numa VLAN de cliente, pelo que as nossas sessões de consola, a monitorização e os backups nunca entram no domínio de broadcast de um cliente nem competem pela sua largura de banda. O isolamento é suficientemente real para nos ser inconveniente, e essa é a prova de que é real: um controlador numa VLAN de gestão não consegue chegar casualmente a um servidor web interno para descarregar uma imagem de firmware, porque nada é permitido que não tenha sido pedido e escrito. O engenheiro dá o passo extra.
Os backups viajam pelo mesmo caminho. São feitos pela rede out-of-band, nunca por um segmento de produção.
Na prática. Uma única lista de acesso de gestão canónica está vinculada em todas as plataformas que operamos, nas linhas de login dos Cisco Nexus, por instância de routing nos routers, por interface para SSH e HTTPS nas firewalls, permitindo apenas sub-redes de gestão nomeadas, com control plane policing a limitar em hardware o que sobrar.
O próprio plano de gestão
O plano de gestão é uma rede por direito próprio e construímo-lo como tal. Corre no nosso próprio backbone encriptado multi-site: Cisco DMVPN, IPsec a AES-256, BGP transportado sobre os túneis, a ligar Atenas, Amesterdão e Toronto à nossa sede corporativa no Chipre, que deliberadamente não está em nenhum dos edifícios que gere. Os hubs são redundantes, com caminhos de custo igual entre eles e por circuitos diversos, e com deteção de falhas que nota um caminho morto em bem menos de um segundo.
O pessoal chega a ele de uma única forma: através de gateways VPN e firewalls que possuímos e operamos nós próprios, em OPNsense e Cisco Firepower, e depois através de jump hosts dentro do plano, e não diretamente do portátil de um engenheiro. Níveis de confiança diferentes nunca partilham um objeto de firewall, pelo que alargar o acesso de um grupo não consegue alargar silenciosamente o de outro.
Para os planos de backup e de disaster recovery, a política é negar por defeito e os dados fluem num só sentido. A produção nunca empurra para o backup. O lado do backup puxa. Isso é imposto com regras de negação explícitas nos equipamentos de firewall, não com uma firewall de host que um host comprometido poderia editar, e os segmentos de backup não têm qualquer rota para a internet. Só a gama de gestão lhes chega. Se uma máquina de produção for completamente tomada, o atacante não ganha nenhum conhecimento da infraestrutura de backup nem nenhum caminho até ela. De onde está, ela não existe.
As alterações ao backbone são verificadas ao vivo contra o sistema em execução, uma metade de um par redundante de cada vez, e é por isso que conseguimos trabalhar no backbone a meio de um dia de trabalho.
Na prática. Movemos toda a instalação de VPN site-to-site de um cliente de um país para outro numa única sessão, antes de um prazo fixo. O hub foi clonado, transportado e levantado em paralelo com o original, para que ambos estivessem ao vivo ao mesmo tempo e houvesse sempre um sítio onde os túneis pudessem estar. Os routers das sucursais foram movidos um a um, cada um verificado em funcionamento antes de o seguinte ser tocado, cada um a fazer failover de forma limpa pelo caminho. Ninguém se deslocou a uma sucursal.
A baseline de hardening em todos os hosts
Cada máquina que construímos parte da mesma baseline, e a baseline não está em negociação. O SELinux está em enforcing, e não o desligamos para uma aplicação cooperar, escrevemos a política. Os sistemas de ficheiros são XFS.
O patching não depende de mais ninguém. Mantemos o nosso próprio mirror de pacotes no nosso próprio datacenter, com os repositórios a partir dos quais a nossa frota instala, com as assinaturas upstream intactas, acessível apenas a partir das nossas próprias gamas de endereços. Um mirror público a ter um mau dia não é um acontecimento aqui, e um servidor deliberadamente incapaz de falar com a internet continua a ser um servidor que conseguimos atualizar por completo.
Na prática. Quando foi publicada uma vulnerabilidade crítica num runtime amplamente utilizado, os pacotes corrigidos estavam em produção em todos os servidores afetados no mesmo dia, antes do fim dessa mesma noite. Não à mão e não à pressa: o rollout faz um backup, atualiza um host de cada vez, amostra sites reais nesse host para uma resposta saudável antes e depois, e para automaticamente toda a passagem se um não voltar corretamente. Rápido e cuidadoso não são opostos quando se constrói a coisa que o faz por nós.
Os logs das máquinas entram, e nada pode ficar em silêncio
As severidades sérias vão diretamente para o chat de operações onde o engenheiro de serviço já está, chegando a um humano em segundos, e sabemos que são segundos porque o cronometrámos com um alarme real. No edge, sensores dedicados leem tráfego espelhado dos border routers e vigiam continuamente padrões volumétricos e de negação de serviço.
Um dispositivo pode parecer perfeitamente saudável a partir da sua própria linha de comandos enquanto silenciosamente não envia nada para o coletor, por isso «o logging está configurado» não é prova aqui. Confirmamos que o log chega, do outro lado, no fluxo a que pertence, depois de cada alteração que o pudesse ter perturbado. Os sistemas de monitorização têm os seus próprios watchdogs em máquinas separadas, para que «aquilo que estava a vigiar deixou de vigiar» seja, por si só, um alarme. O silêncio nunca é boa notícia.
Na prática. A nossa verificação de saúde de rotina confirma também duas coisas que a maioria das verificações salta: se cada dispositivo continua realmente a enviar os seus logs, e se a sua configuração continua realmente a ser copiada em backup. Essas duas são as falhas que escondem as outras.
Análise em tempo real nas nossas próprias NVIDIA A100
A maioria dos fornecedores recolhe logs para um balde e pesquisa-o depois de algo já ter avariado. Nós pomos o fluxo a trabalhar. Regras básicas retiram primeiro o ruído conhecido, e depois tudo o que resta, de routers, switches, firewalls, arrays de storage e servidores, é analisado à medida que chega por modelos de IA a correr num conjunto de GPU NVIDIA A100 nossas, dentro do nosso próprio datacenter.
Os modelos leem transversalmente aos dispositivos, não uma linha de log de cada vez: um erro de caminho de storage, uma interface a oscilar e uma temperatura a subir no mesmo rack tornam-se uma única história em vez de três mensagens sem relação. Apanham os padrões que uma regra estática nunca apanhará, o desvio lento e a combinação invulgar que antecede uma falha, e cada alarme chega ao engenheiro já com uma segunda opinião anexada. Os dados das máquinas deixam de ser um monte de texto para fazer grep e tornam-se um aviso antecipado.
Nada disto sai da nossa rede. Os modelos, as GPU e os dados são todos nossos, e nenhuma linha de log é alguma vez enviada para um serviço de IA externo.
Um CTO que nos esteja a avaliar é bem-vindo a pedir a lista de acesso, o runbook e o encaminhamento dos alarmes. Mostramos os três.
Sobresselentes no local
As peças sobresselentes, até chassis inteiros, estão na mesma cage que as máquinas que vão precisar delas, não num contrato de entrega de um fornecedor.
Uma peça sobresselente não ganha o seu lugar nessa prateleira por ter chegado. Os discos vão para uma bancada de testes, são formatados a baixo nível para o formato de setor do array que vão servir, e só entram em stock depois de reportarem zero grown defects e nenhum erro não corrigido de leitura, escrita ou verificação. Uma peça sobresselente que falha na noite em que é precisa nunca foi uma peça sobresselente.
Substituir cedo, atualizar a tempo
Aqui o hardware é retirado com base em evidência, não em falha.
Vulnerabilidades críticas, no mesmo dia. Quando é divulgada uma falha de severidade máxima em algo de que dependemos, construímos pacotes corrigidos no mesmo dia em que a correção é publicada. A configuração protetora entra imediatamente. Se ainda não existir pacote corrigido para a plataforma que operamos, construímo-lo nós próprios, compilado num container limpo a partir da especificação do próprio maintainer, verificado contra o código-fonte publicado do projeto, instalado host a host com verificações antes e depois. Da última vez que foi necessário, a correção estava em produção cerca de três horas depois de o código-fonte ter sido publicado. Mantemos o nosso próprio mirror de pacotes pela mesma razão.
A documentação como infraestrutura
Muitas empresas têm documentação. Nós tratamo-la como parte da planta.
Cada cabo traz um identificador único impresso, de um único registo que não consegue emitir o mesmo número duas vezes e nunca reutiliza um, mesmo depois de o cabo ser retirado. A etiqueta nomeia as duas extremidades, rack, dispositivo e porta em cada uma. Vinte e dois anos de cablagem continuam a poder ser seguidos da etiqueta, ao registo, à porta do switch, e de volta.
Um serviço não está terminado quando funciona. Está terminado quando o seu endereço, a sua regra de firewall, o seu registo de inventário e o seu DNS direto e reverso existem todos e foram verificados a partir de fora da nossa rede.
As nossas ferramentas recusam o comando quando a regra não foi cumprida, o que é uma guarda melhor do que as boas intenções.
É isto que importa às três da manhã. A pergunta nessa altura nunca é qual é a solução engenhosa. É o que mudou, e como o repomos.
Certificados, e auditados
As quatro foram emitidas em setembro de 2026 por um organismo de certificação acreditado a nível nacional, com o âmbito escrito como «Managed datacenter hosting service». É esse o serviço que realmente compra, não um canto da empresa escolhido para tornar fácil uma auditoria.
Os seus dados ficam onde os colocou, e nos nossos sites europeus isso significa dentro da UE, em hardware que nos pertence, sem nenhuma public cloud por baixo. Assinamos um acordo de tratamento de dados, e o nosso documento de medidas técnicas e organizativas está disponível mediante pedido.
Engenheiros, não níveis
Sem bots, e sem primeira resposta por guião.
Os engenheiros que escolhem o hardware, o instalam no rack, o cablam e o etiquetam são os mesmos engenheiros que respondem ao seu ticket, e assinam-no com o próprio nome. Isso funciona porque as pessoas aqui conhecem a sua configuração pelo nome e são suficientemente seniores para não precisarem de um guião.
Em todo o nosso histórico de tickets, a primeira resposta mediana é de três minutos, e 87 por cento dos tickets são resolvidos dentro da hora. Uma boa parte é aberta por nós e não pela sua empresa: a nossa monitorização vigia de forma contínua tudo aquilo por que somos responsáveis, até às suas páginas reais, e os alarmes chegam a um canal que os engenheiros leem.
Continua igual
Os mesmos padrões. A mesma engenharia feita à mão. Continuamos sem investidores, continuamos sem plano de saída, e continua a regra com que começámos numa sala de colocation em Amesterdão: comprar a melhor máquina.
Fazemos visitas acompanhadas ao datacenter de Atenas: a cage, a fibra, as óticas nos seus tabuleiros, as peças sobresselentes na prateleira. Somos nós que o mostramos, porque fomos nós que o construímos. Traga um engenheiro.
O seu próximo parceiro de infraestrutura
Quer ver com os seus olhos?
Diga-nos o que executa. Um engenheiro responde, e a visita ao datacenter é por nossa conta.
+357 222 32280
Comecemos pela sua infraestrutura.
Um pouco de contexto ajuda-nos a começar a conversa certa.