

Infraestrutura GPU gerida: O seu modelo.
A sua máquina.
GPU dedicadasCapacidade reservada para si
Um endpoint privadoAcesso desenhado em torno da sua aplicação
Atenas e AmesterdãoDigital Realty, dentro da UE
Gerido por engenheirosDa instalação à operação
O hardware
Qualquer GPU que possamos comprar.
No nosso datacenter em 48 horas.
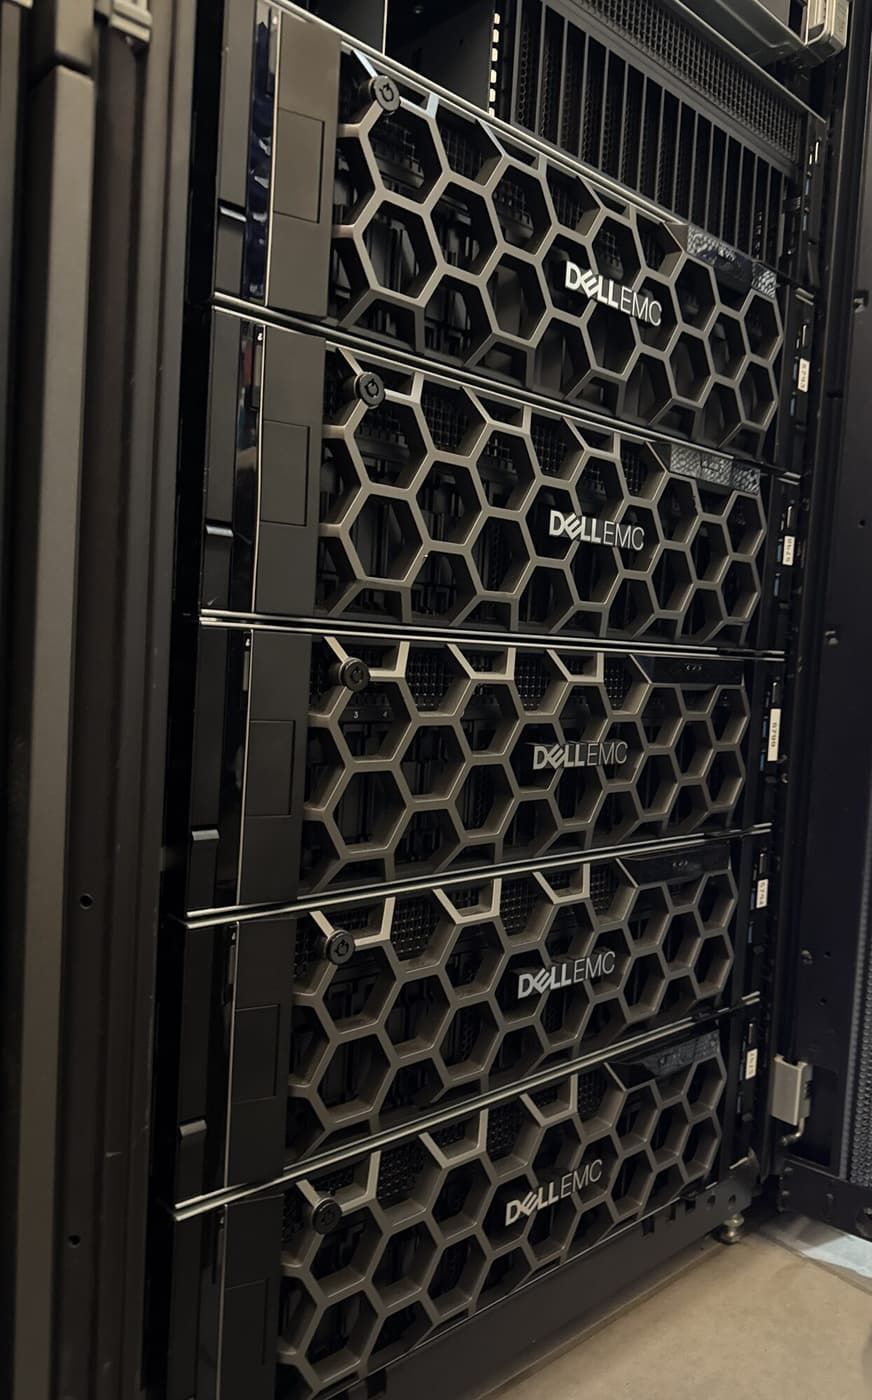
NVIDIA L4, L40, L40S, A100, H100 e o resto da gama atual, dimensionadas para o modelo e para a carga de trabalho. GPU privadas, suas, nos nossos datacenters Digital Realty em Atenas e Amesterdão, dentro da UE.
Modelo e máquina, considerados em conjunto
Um modelo. Uma máquina.
Um plano.
Explore alguns pontos de partida para um endpoint privado. Acordamos o modelo exato, os requisitos de serving e o hardware em torno do que precisa de executar.
Uma ligação privada ao modelo em infraestrutura dedicada.
Arquitetura ilustrativaUm ponto de partida para a conversa
Llama
- O modelo
- Um modelo de texto da classe 70B, com a versão atual acordada consigo. Avaliamo-lo face às necessidades de idioma, qualidade e tempo de resposta da sua aplicação.
- O dimensionamento
- Testamos em conjunto a precisão, o comprimento de contexto e os pedidos simultâneos antes de escolher a capacidade GPU e a configuração de serving.
- Versão e termos
- O Llama é distribuído ao abrigo da community license da Meta, que tem as suas próprias condições de utilização e de escala. Confirmamos que a versão exata se adequa à sua utilização antes da instalação.
Um ponto de partida para a conversa
Mistral
- O modelo
- Um modelo de dimensão média, com a versão atual acordada consigo, é uma opção a avaliar para um assistente privado ou um endpoint de aplicação.
- O dimensionamento
- Acordamos a precisão e o contexto de que precisa, e depois testamos a carga de serving. A dimensão do modelo, por si só, não garante que caiba na GPU.
- Versão e termos
- A Mistral publica alguns pesos (weights) sob licença Apache 2.0 e outros sob termos próprios de investigação ou comerciais. Confirmamos quais se aplicam à versão que escolher.
Um ponto de partida para a conversa
Qwen
- O modelo
- Uma família de modelos de várias dimensões. Escolhemos uma versão específica para testar com a sua aplicação, em vez de dimensionar hardware para o nome da família.
- O dimensionamento
- Começamos com o modelo selecionado e os seus próprios prompts. O contexto, a precisão e os objetivos de tráfego orientam a configuração final.
- Versão e termos
- Reveja os termos para o modelo e a dimensão exatos. O model card do 72B no link é um exemplo, não uma licença para toda a família.
Desenhado consigo
DeepSeek
- O modelo
- Um grande modelo mixture-of-experts, com a versão atual acordada consigo. Exige uma arquitetura de serving ponderada e uma avaliação da carga de trabalho.
- O dimensionamento
- Desenhado consigo. Avaliamos a memória GPU, as interligações e as opções de instalação antes de acordar uma configuração ou um preço.
- Versão e termos
- Os termos do modelo são distintos da licença de código do repositório. Reveja a versão escolhida antes da instalação.
Um ponto de partida para a conversa
Ainda não sabemos
- O modelo
- Comece pelo que a aplicação precisa de fazer. Ajudamos a pré-selecionar modelos para testar nos seus próprios prompts e documentos.
- O dimensionamento
- Analisamos consigo a qualidade das respostas, o tempo de resposta e o tráfego esperado, e depois acordamos em conjunto o modelo e o hardware.
- Versão e termos
- A pré-seleção inclui as versões exatas dos modelos e os respetivos termos, para que a decisão de instalação seja tomada com todos os detalhes à vista.
A configuração final e o preço são acordados após o dimensionamento.
A engenharia faz parte do serviço
Nós fazemos a engenharia.
A sua equipa chama um endpoint.
Uma equipa para o hardware, a serving stack e a operação do dia a dia. A sua empresa traz a carga de trabalho; nós trabalhamos os detalhes consigo.
Conheça a sua equipa de suporteUm modelo e uma máquina que encaixam
Analisamos o modelo, a memória e a concorrência esperada, e depois testamos a configuração proposta com os seus prompts.
A serving stack, instalada
Drivers GPU, o runtime de inferência e a configuração do endpoint. Os nossos engenheiros tratam da infraestrutura em torno do seu modelo.
Acesso nos seus termos
Um endpoint privado com acesso de rede e registo (logging) configurados em torno das suas aplicações e dos requisitos dos seus dados.
Gerido para além da instalação
A equipa que instala a máquina mantém-se responsável pela operação e investiga problemas em todo o host e na serving stack.
Atualizações, com um plano
Mantenha uma versão escolhida do modelo; as alterações são validadas e a janela de atualização acordada antes de passar à seguinte.
Capacidade que acompanha a procura
Revemos consigo a memória, o comprimento de contexto e a concorrência à medida que a utilização cresce, e acrescentamos GPU ou um segundo host quando os números o justificam.
O que vai executar?
Quatro cargas de trabalho ilustrativas. Moldamos o modelo, o acesso privado e a capacidade em torno da sua aplicação.
RAG sobre documentos privados
Traga a recuperação (retrieval) e a inferência para infraestrutura gerida. Construa respostas a partir de documentos aprovados, com citações para a fonte.
- Modelo, embeddings e vector database em conjunto
- Acesso aos documentos por VPN ou rede privada
Um assistente interno
Dê à sua equipa um assistente sobre conhecimento interno aprovado, com acesso e registo de prompts configurados em torno da sua organização.
- Inferência dedicada para a sua equipa
- Registo e retenção acordados consigo
Funcionalidades de IA no seu produto
Sirva respostas do modelo através de um endpoint que a sua aplicação chama. Acorde a versão do modelo e dimensione a capacidade com prompts reais e a procura esperada.
- Inferência na sua infraestrutura GPU gerida
- Capacidade e concorrência testadas para a sua aplicação
Assistência de código sobre código-fonte privado
Execute um modelo de código com contexto aprovado dos seus repositórios e acesso privado. Mantenha a inferência e o código-fonte em infraestrutura gerida, com as conclusões devolvidas à sua equipa.
- Ficheiros selecionados e código recuperado como contexto
- Acesso aos repositórios limitado a utilizadores autorizados
Uma instalação de IA privada
Registos médicos analisados
sem sair de Atenas.
Um cliente precisava de IA para analisar registos médicos: entram processos de doentes, sai um relatório estruturado e com citações, e cada passo corre em modelos locais nas GPU privadas do próprio cliente dentro do Digital Realty Athens. Os dados nunca tocam numa public cloud.
Antes de instalar
O modelo é
apenas o início.
Memória, acesso, custo e operação contínua. Vamos analisar em conjunto o que o seu endpoint precisa.
Pergunte a um engenheiroTrabalhamos com modelos de pesos abertos (open-weight), incluindo Llama, Mistral, Qwen e DeepSeek. A versão exata, o software de serving, as necessidades de hardware e os termos de licença são revistos para a sua instalação. Se ainda não escolheu um modelo, podemos pré-selecionar opções e testá-las nos seus prompts.
O seu próximo parceiro de infraestrutura
Traga-nos o modelo
que quer executar.
Fale-nos do seu modelo, dos seus dados e da carga de trabalho esperada. Trabalharemos consigo o hardware, a serving stack e a instalação.
+357 222 32280
Comecemos pela sua infraestrutura.
Um pouco de contexto ajuda-nos a começar a conversa certa.
Da equipa de engenharia
O raciocínio por trás do endpoint.
AI Hosting · 8 min read
A 70B model really does fit on a 48GB card, once you count what quantization costs.
Read the articleAI Hosting · 6 min read
Your AI endpoint doesn't have to be on the internet.
Read the articleAI Hosting · 5 min read