

Suporte gerido: As pessoas que o instalam no rack
respondem ao seu ticket.
- A nossa mediana de primeira resposta a um ticket de cliente nos últimos doze meses.
- Três minutos
- A percentagem de tickets resolvidos na primeira hora, em todo o nosso histórico de tickets.
- 87%
- Engenheiros de turno de forma contínua, todos os dias do ano.
- 24/7/365
Medido a partir dos nossos próprios registos de tickets, contando uma resposta de um engenheiro, não uma confirmação automática de receção.
Engenharia 24/7Pessoas de turno de forma contínua
Um engenheiro identificadoAlguém é responsável pelo passo seguinte
Gestão incluídaEm todos os produtos geridos
Do SO ao hardwareA equipa por trás de toda a stack
Quando algo precisa de atenção
Uma conversa com
as pessoas que fazem o trabalho.
Um alerta pode abrir a conversa. A sua equipa também. Em qualquer dos casos, o engenheiro que analisa o assunto pode trabalhar no servidor, no storage e na rede por trás dele.
Muitos tickets começam connosco: a monitorização abre a conversa antes de dar por isso.
O trabalho de todos os dias
A maior parte do suporte
cuidar dos detalhes.
Um servidor atualizado. E-mail a funcionar. Um certificado renovado. O trabalho operacional regular faz parte do serviço desde o início.
Painéis de controlo
Administração de cPanel, WHM e Plesk. Cuidamos do painel, investigamos problemas de contas e acordamos o software de que a sua infraestrutura precisa.
Segurança e limpeza
Reforço de segurança (hardening) do servidor, investigação de malware e limpeza manual. A monitorização de spam de saída ajuda-nos a encontrar contas comprometidas.
Entrega de e-mail
SPF, DKIM, filas de correio e recuperação de blacklists. Ajuda com os serviços de que a sua equipa e os seus clientes dependem todos os dias.
Atualizações do SO e da stack
Patching e atualizações de segurança, com janelas de manutenção acordadas em torno da sua carga de trabalho. Planeamos também mudanças maiores de sistema operativo.
DNS e certificados
Configuração de DNS, reverse DNS e instalação e renovação de SSL. O trabalho em torno do website também faz parte da gestão.
Monitorização e investigação
Observium, Graylog, Percona PMM e Zabbix, com engenheiros por trás que podem investigar a infraestrutura por detrás de um alerta.
Quando o trabalho vai mais fundo
A mesma equipa.
Até ao fim.
Os problemas de infraestrutura raramente param numa camada. Os nossos engenheiros conseguem segui-los do ambiente da aplicação até aos sistemas por baixo.
Uma migração planeada
Inventário, construção do destino, validação e uma transição final (cutover) acordada. Os nossos engenheiros executam a migração e mantêm um caminho de rollback no plano.
Migrações geridasStorage até ao fabric
A equipa que opera o seu servidor também opera os nossos arrays HPE 3PAR e os fabrics Fibre Channel Brocade duplos.
A nossa plataforma de storageRecuperação para a qual se pode preparar
Backups offsite e planeamento da recuperação em torno dos seus dados. A retenção, os testes de restore e qualquer âmbito de disaster recovery (DR) entre sites são acordados consigo.
Backups e recuperaçãoDesempenho em toda a stack
Investigação no SO, na base de dados, no servidor web e na rede. Damos aos seus programadores conclusões sobre as quais podem agir.
Dimensionamento para a carga de trabalhoUma rede que operamos
O nosso próprio AS200477, BGP e as nossas ligações upstream. Os engenheiros que analisam um problema de routing trabalham com a própria rede.
Por dentro da nossa redeUm perímetro gerido
Política de firewall dedicada e separação de rede para o seu ambiente, com as alterações e a gestão contínua a cargo da nossa equipa.
Managed firewallsQuem responde
Engenheiros
em cada passo.
As pessoas que respondem aos seus tickets são engenheiros com acesso à sua plataforma, a mesma equipa que a desenha, constrói e opera. Podem entrar, ler os logs e corrigir o problema, em vez de apenas o registar e passar adiante.
Quando um assunto precisa de um especialista, vai diretamente para o engenheiro que conhece essa parte da sua plataforma, com todo o contexto anexado, para que nunca tenha de o explicar duas vezes.
Se o seu serviço inclui um acordo contratual de primeira linha, por exemplo um parceiro que atende os seus próprios utilizadores finais, funciona exatamente como acordado, e tudo o que chega até nós cai nas mãos de um engenheiro.
No piso. No ticket.
A infraestrutura é nossa.
A responsabilidade também.
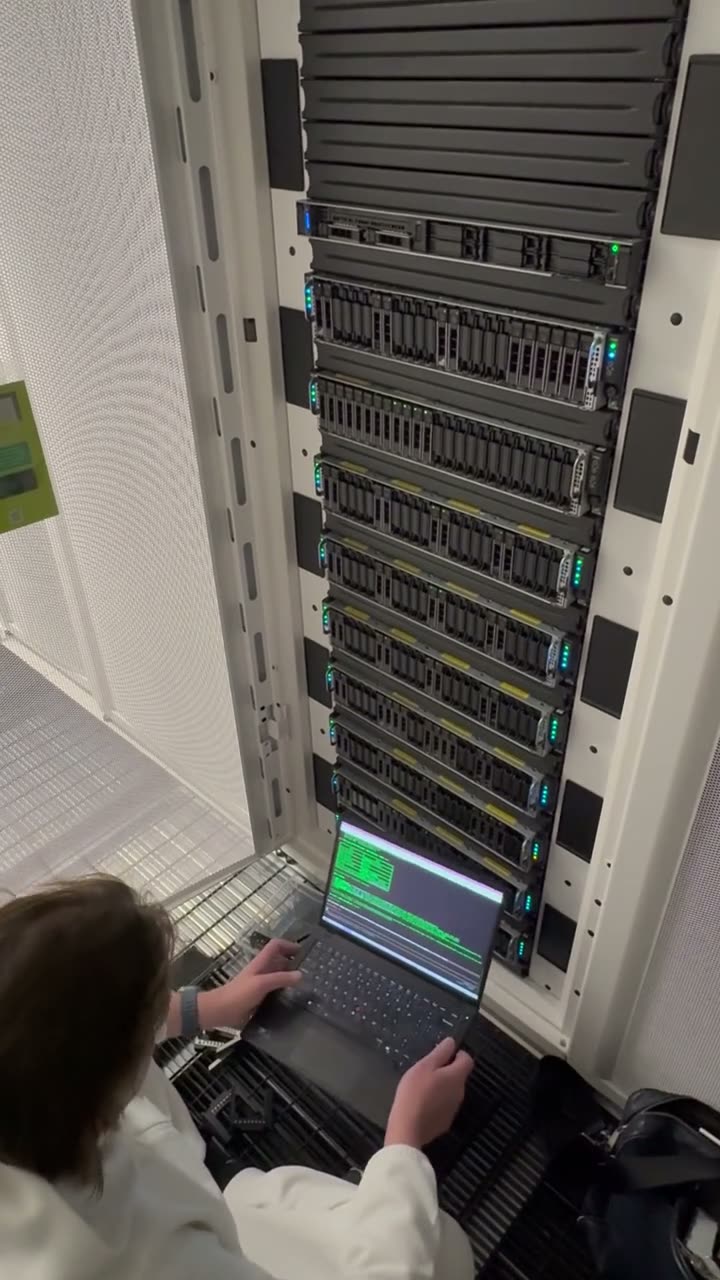
A equipa que responde ao seu ticket também instala o hardware nos racks, opera a rede e trabalha na consola quando um servidor precisa de atenção.
Cada ticket
Como trabalhamos.
Minutos, não horas.
Mediana de três minutos na primeira resposta no último ano. 87% dos tickets resolvidos na primeira hora em todo o nosso histórico. Os tickets de hardware são normalmente respondidos em poucos minutos.
Muitas vezes somos nós a abrir o ticket.
A nossa monitorização vigia os seus servidores, o caminho da sua rede e as suas páginas reais. Quando algo parece errado, começamos a trabalhar e avisamos, frequentemente antes de dar por isso.
Uma pessoa identificada em cada resposta.
Cada resposta é assinada pelo engenheiro que a escreveu.
Um canal direto para plataformas maiores.
Os clientes com plataformas maiores ou mais complexas podem ter um canal de chat dedicado com os nossos engenheiros, em paralelo com o sistema de tickets.
Respostas com provas.
Quando pergunta o que aconteceu, recebe uma cronologia a partir da nossa monitorização, dos logs e da telemetria, não um palpite.
Alterações feitas com cuidado.
Se uma alteração puder tocar no seu tráfego, acordamos primeiro consigo o momento.
Proativos, de forma contínua
Somos nós que o contactamos,
não o contrário.
O nosso NOC vigia todos os servidores e clusters de clientes de forma contínua, com a monitorização em que a nossa própria plataforma assenta: hosts, serviços, storage, caminhos de rede e as portas de aplicação que importam para si. Quando algo se degrada, um engenheiro age primeiro e informa depois: a falha é investigada e reparada, e recebe um ticket de saída, ou uma mensagem no seu canal Mattermost privado se a sua conta tiver um, a descrever o que foi encontrado e o que foi feito. Cada incidente produz também um relatório escrito em PDF: o que aconteceu, o que foi reparado, o que foi feito do nosso lado e o que fica em aberto do seu, por exemplo uma alteração que os seus programadores precisam de fazer na aplicação, com o plano de ação para a fechar.
A mesma disciplina aplica-se às vulnerabilidades. Quando o PHP2Shell foi divulgado, e antes dele as falhas do kernel Linux publicadas como Copy Fail, Dirty Frag, GhostLock, Bad Epoll, Januscape e OVSwrap, a race condition do ssh-keysign, a falha do módulo rewrite do nginx, os avisos dos plugins do Plesk e do LiteSpeed, os nossos engenheiros aplicaram as correções em todos os servidores geridos à medida que eram verificadas e confirmaram que as aplicações alojadas voltaram a funcionar sem problemas. Onde os pacotes da distribuição ainda não tinham sido publicados, construímos e assinámos nós próprios os pacotes corrigidos e instalámo-los como correção provisória, substituindo-os pelos builds do fornecedor quando chegaram. Cada cliente foi informado do que foi corrigido, quando, e como foi verificado.
Como é na prática
Na prática.
Uma pergunta tarde da noite, respondida na primeira hora.
Na noite em que uma falha de segurança crítica estava a ser corrigida em toda a internet, o programador de um cliente perguntou se os seus servidores tinham sido cobertos. Em menos de uma hora tinha a resposta: todos corrigidos, com o mesmo número de websites a funcionar antes e depois.
Um canal dedicado que funciona há anos.
Um dos nossos maiores clientes trabalha com os nossos engenheiros através de um canal de chat dedicado há anos, em paralelo com o sistema de tickets. Perguntas do dia a dia, alterações planeadas e assuntos urgentes chegam diretamente às pessoas que operam a plataforma.
Um editor de notícias nacional, com suporte onde estão os seus leitores.
O editor mudou-se para o Digital Realty Athens, perto dos leitores que constituem quase toda a sua audiência, e tem o suporte dos mesmos engenheiros que construíram lá a sua plataforma.
Suporte em tempo real no Mattermost
Fale com os engenheiros que operam
a sua plataforma, no momento em que acontece.
Os tickets são a forma como todos os clientes da EuroVPS nos contactam, e são respondidos por engenheiros, não por um guião. Quando a sua equipa quer mais do que isso, damos-lhe um canal Mattermost privado com os nossos engenheiros lá dentro: a sua equipa escreve, um engenheiro responde, e a conversa fica registada ao lado do histórico da sua plataforma. Sem menu telefónico, sem fila, sem «nós ligamos de volta».
Incluído
Com as nossas ofertas de classe enterprise: private cloud, clusters dedicados e plataformas geridas vêm com suporte no Mattermost para a sua equipa.
Disponível em qualquer plano
Como extra a 300 € por utilizador por mês, de uma única máquina virtual a um dedicated server.
Na nossa própria plataforma
Corre no nosso próprio Mattermost, alojado nos nossos próprios datacenters, com o seu canal visível apenas para a sua equipa e para os nossos engenheiros.
Adicione suporte em tempo real Como funciona o nosso team chat
Os detalhes práticos
O que esperar
da sua equipa.
Discuta responsabilidades, escalation e o âmbito da sua infraestrutura com os engenheiros que vão cuidar dela.
Pergunte a um engenheiroNos últimos doze meses, a nossa mediana de primeira resposta foi de três minutos, e em todo o nosso histórico de tickets 87% dos tickets foram resolvidos na primeira hora. São medidos a partir dos nossos próprios registos de tickets e contam uma resposta de um engenheiro, não uma confirmação automática de receção. Os compromissos contratuais de resposta fazem parte do seu acordo de serviço. Peça-nos os termos que se adequam à sua plataforma.
O seu próximo parceiro de infraestrutura
Fale com a pessoa
vai mesmo resolver o problema.
Diga-nos o que executa e onde a sua equipa precisa de suporte. Analisamos consigo a infraestrutura, o âmbito de gestão e o passo seguinte.
Clientes atuais: abrir um ticket na área de cliente, 24/7Fale com um engenheiro
Comecemos pela sua infraestrutura.
Um pouco de contexto ajuda-nos a começar a conversa certa.
Da equipa de engenharia