

O que fazemos · Storage e computação: Disaster recovery e réplicas num segundo site
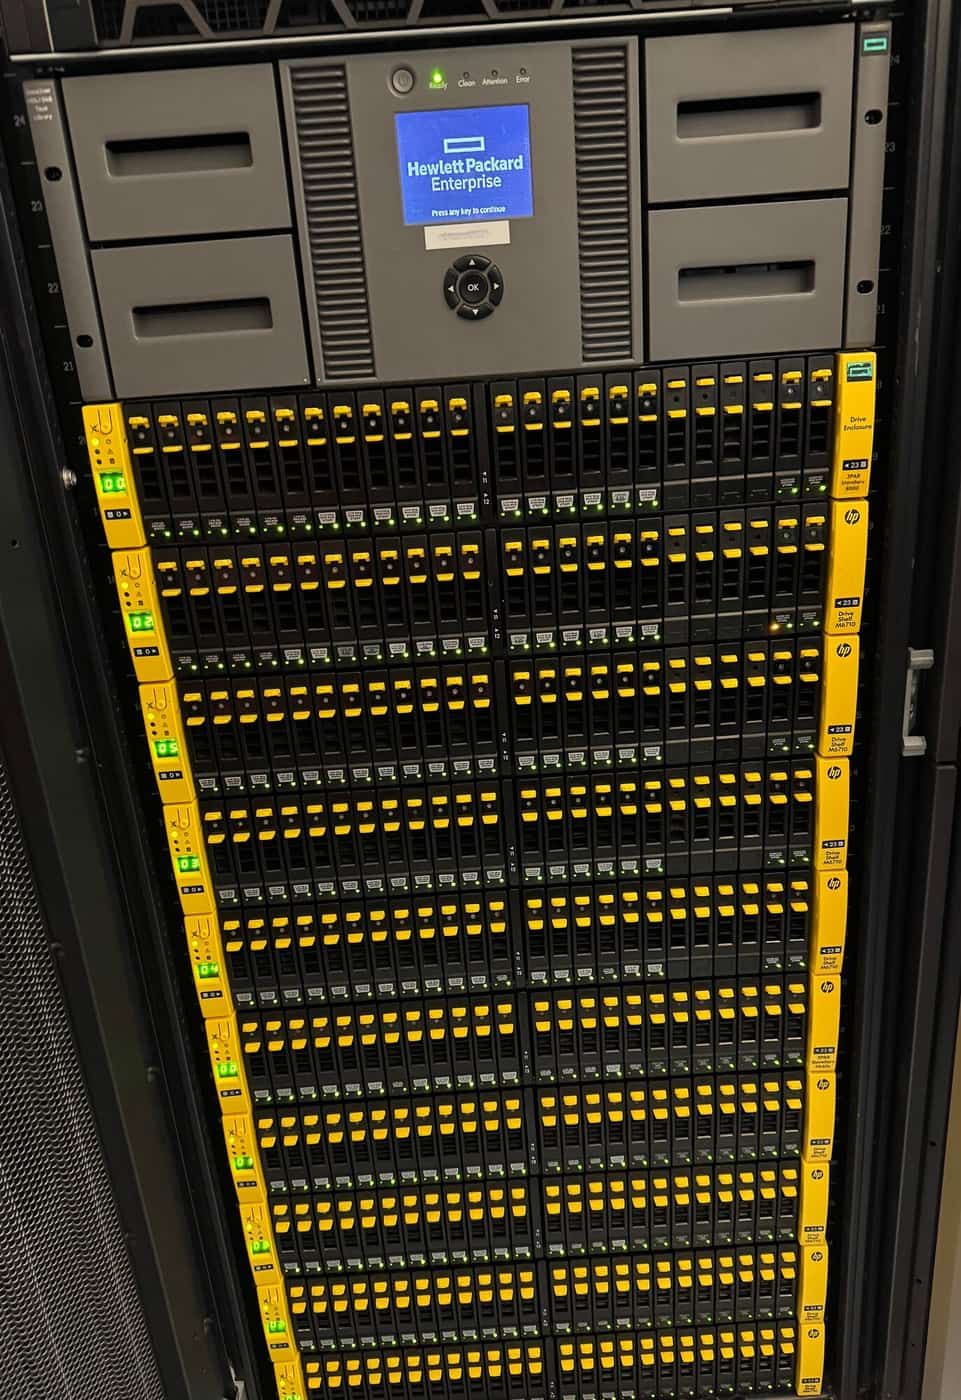
Para os sistemas críticos mantemos uma cópia continuamente atualizada num segundo site, para que a recuperação seja um failover e não um restore, e desenhamos o caminho da replicação, a postura de firewall à sua volta e a monitorização que nos diz no momento em que a cópia fica para trás.
O que é
Um desenho de recuperação de desastres (disaster recovery) ajustado ao serviço que contrata. Um serviço pequeno e simples recebe backups sólidos e um caminho de regresso testado. Uma plataforma que não pode estar em baixo recebe réplicas live noutro datacenter, storage replicado entre arrays e um front end que continua a servir enquanto o back end recupera. O ponto de recuperação (recovery point) e o tempo de recuperação seguem o serviço, e os seus ficam escritos.
Como o construímos
Réplicas live de bases de dados num segundo site. Uma base de dados de produção replica continuamente, por global transaction ID, para uma réplica só de leitura noutro datacenter através do nosso backbone privado encriptado.
Pull-only, imposto na firewall. O lado protegido nunca faz push. Os sistemas de réplica e de backup entram na produção para retirar o que precisam, e os backups são retirados pela nossa rede out-of-band fisicamente isolada (air-gapped), nunca através de um segmento de produção; a produção não tem caminho de rede para eles nem credenciais para eles. Só a nossa rede de gestão pode chegar aos sistemas de recuperação, e tudo o resto é explicitamente negado nos equipamentos de firewall, não apenas nos hosts.
Storage replicado entre países. Por baixo, os volumes podem replicar de array para array entre arrays HPE 3PAR em Atenas e Amesterdão, em portas dedicadas, para que uma cópia ao nível de bloco da sua plataforma já exista no outro datacenter. Dentro de cada site, os sistemas em cluster mantêm cada membro num array físico diferente.
Os dados da UE ficam na UE. As réplicas e os backups de dados alojados na UE ficam dentro da nossa infraestrutura na UE.
Encriptado em repouso, apagado com certificado. A encriptação em repouso está disponível por omissão. Os discos que saem de serviço são sanitizados com Blancco, e guardamos o certificado de eliminação em PDF de cada disco que apagamos.
Atentos ao drift. A saúde da replicação é verificada a cada poucos minutos, e qualquer mudança de estado, quebrada, atrasada ou recuperada, gera um alerta aos engenheiros de serviço.
Servir durante uma falha do back end. Para propriedades web públicas, a camada de cache está configurada para continuar a servir conteúdo quando a camada aplicacional está em baixo, para que uma falha do back end não se transforme numa indisponibilidade pública enquanto recuperamos.
Backups por baixo de tudo isto
Fazemos backup de máquinas virtuais, servidores bare metal Linux e Windows, servidores SQL e nós cPanel e Plesk com Veeam, e de dados de ficheiros e de bases de dados Linux com um backup hub com deduplicação que faz pull por SSH com chaves restritas e append-only. Os repositórios correm em XFS com fast cloning e um nível de repositório com hardening que recebe os copy jobs. Os calendários são definidos a partir de tempos de execução medidos para que os jobs grandes nunca colidam, a cobertura é verificada contra o inventário vivo, não confiada ao estado do job, e os restores são testados regularmente, até semanalmente.
Do que o protege
- Perder o host principal da sua base de dados ou o seu site principal.
- Ransomware ou um intruso a apagar os seus backups a partir do servidor comprometido.
- Drift das réplicas: o estado de cada réplica é verificado a cada poucos minutos.
- Uma indisponibilidade da aplicação transformar-se numa indisponibilidade pública.
- Lacunas na cobertura de backup: todas as máquinas que devem ter backup têm, e verificamo-lo contra o que está a correr.
Na prática
Um site de notícias continuou a servir com o back end desligado. Para um editor de notícias, configurámos a camada de cache para servir conteúdo stale em caso de erro durante um dia inteiro, e depois provámo-lo: o back end foi deliberadamente marcado como falhado e as páginas em cache continuaram a ser devolvidas normalmente aos leitores.
Um cluster de bases de dados desenhado para perder um array. Para um cliente de analytics, o volume de dados de cada membro do cluster está num array físico diferente, para que a perda de um array inteiro custe uma réplica e a base de dados continue a servir sem qualquer failover.
Porquê a EuroVPS
- Backup e replicação pull-only, impostos na firewall, sem exceções.
- Recuperação desenhada e documentada por serviço.
- Réplicas e backups monitorizados quanto à atualidade, não assumidos.
- Replicação de array para array entre Atenas e Amesterdão, com os dados da UE mantidos dentro da UE.
- Desenho alinhado com as orientações ISO 27001, NIS2 e NIST sobre proteção de fronteiras.
Perguntas frequentes
- Que RPO e RTO obtenho? Depende do serviço que contrata. Os serviços básicos recebem backups e um caminho de restore definido; os serviços com cobertura em dois sites recebem réplicas live e failover. Os seus ficam escritos.
- Porquê pull-only? Se a produção pudesse fazer push para o backup, um atacante na produção poderia chegar ao backup. Com pull-only, esse caminho não existe.
- A minha réplica pode viver noutro país? Sim. Atenas e Amesterdão replicam uma para a outra, array para array e base de dados para base de dados, pela nossa própria rede privada. Os dados alojados na UE ficam dentro da nossa infraestrutura na UE.
- Testam restores? Sim, regularmente, até semanalmente, e verificamos a cobertura contra o que está realmente a correr, não contra o que o job de backup diz.
- Os meus dados estão encriptados em repouso? Sim, por omissão. E quando um disco sai de serviço é sanitizado com Blancco, com um certificado de eliminação guardado para esse disco.
- closing line: A recuperação desenha-se antes do mau dia, não durante. Fale com um engenheiro sobre o que os seus serviços precisam.
- CTA: Fale com um engenheiro
O seu próximo parceiro de infraestrutura
Vamos analisar a sua infraestrutura.
Diga-nos o que executa hoje e o que precisa de melhorar. Um engenheiro vai analisar o seu pedido e ajudar a planear o passo seguinte.
+357 222 32280
Comecemos pela sua infraestrutura.
Um pouco de contexto ajuda-nos a começar a conversa certa.