

З 2004 року: Без компромісів
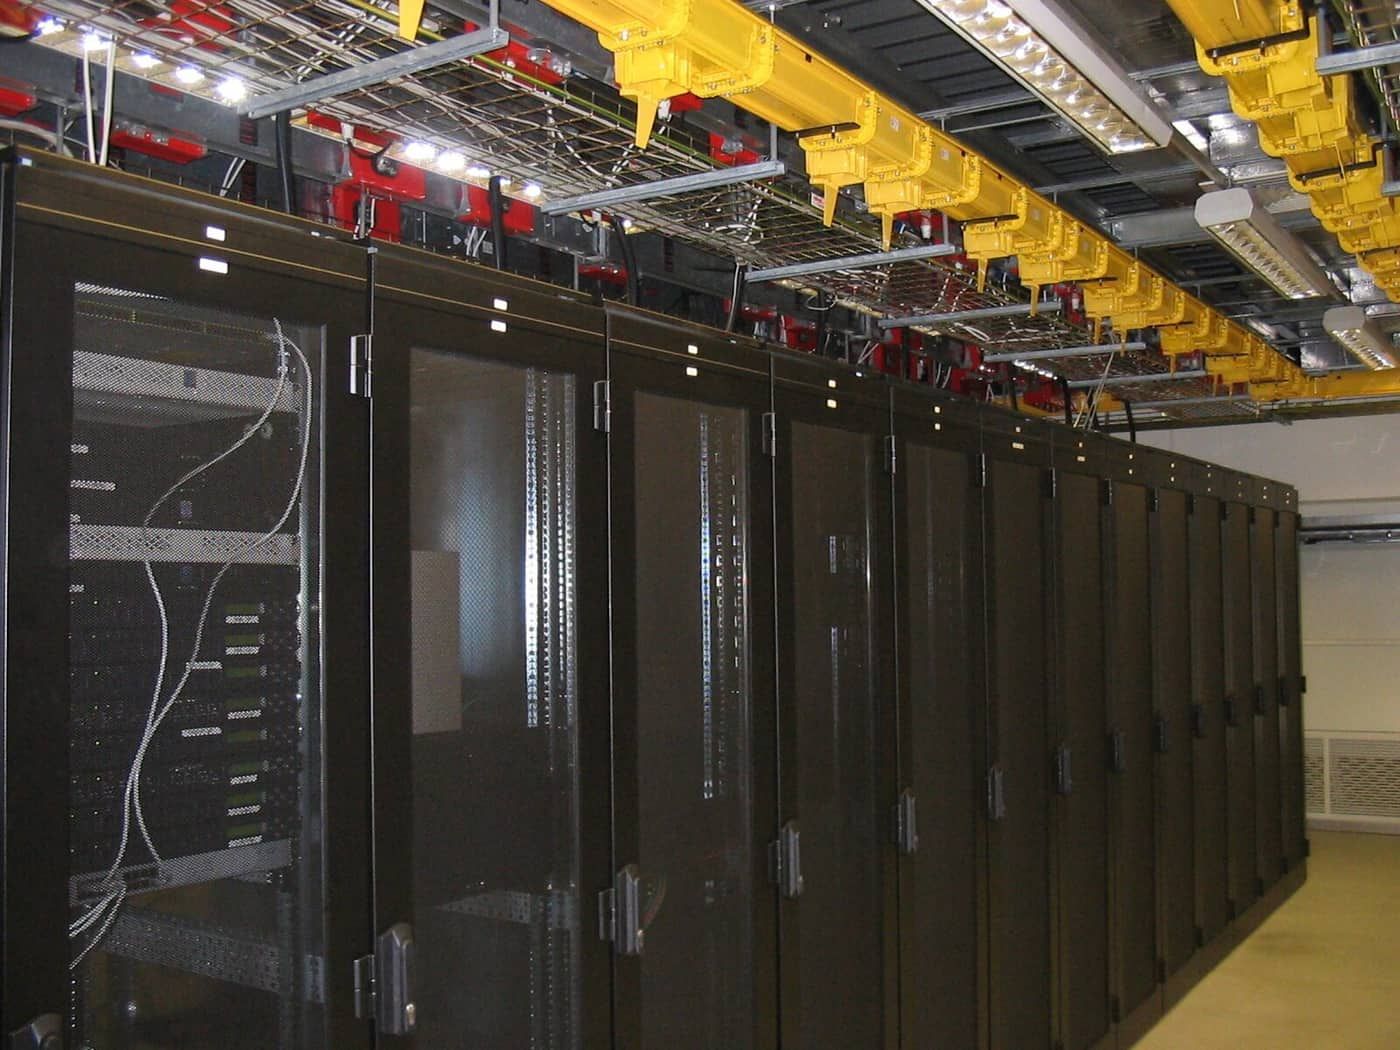
У 2004 році EuroVPS була однією машиною. Не дешевою.
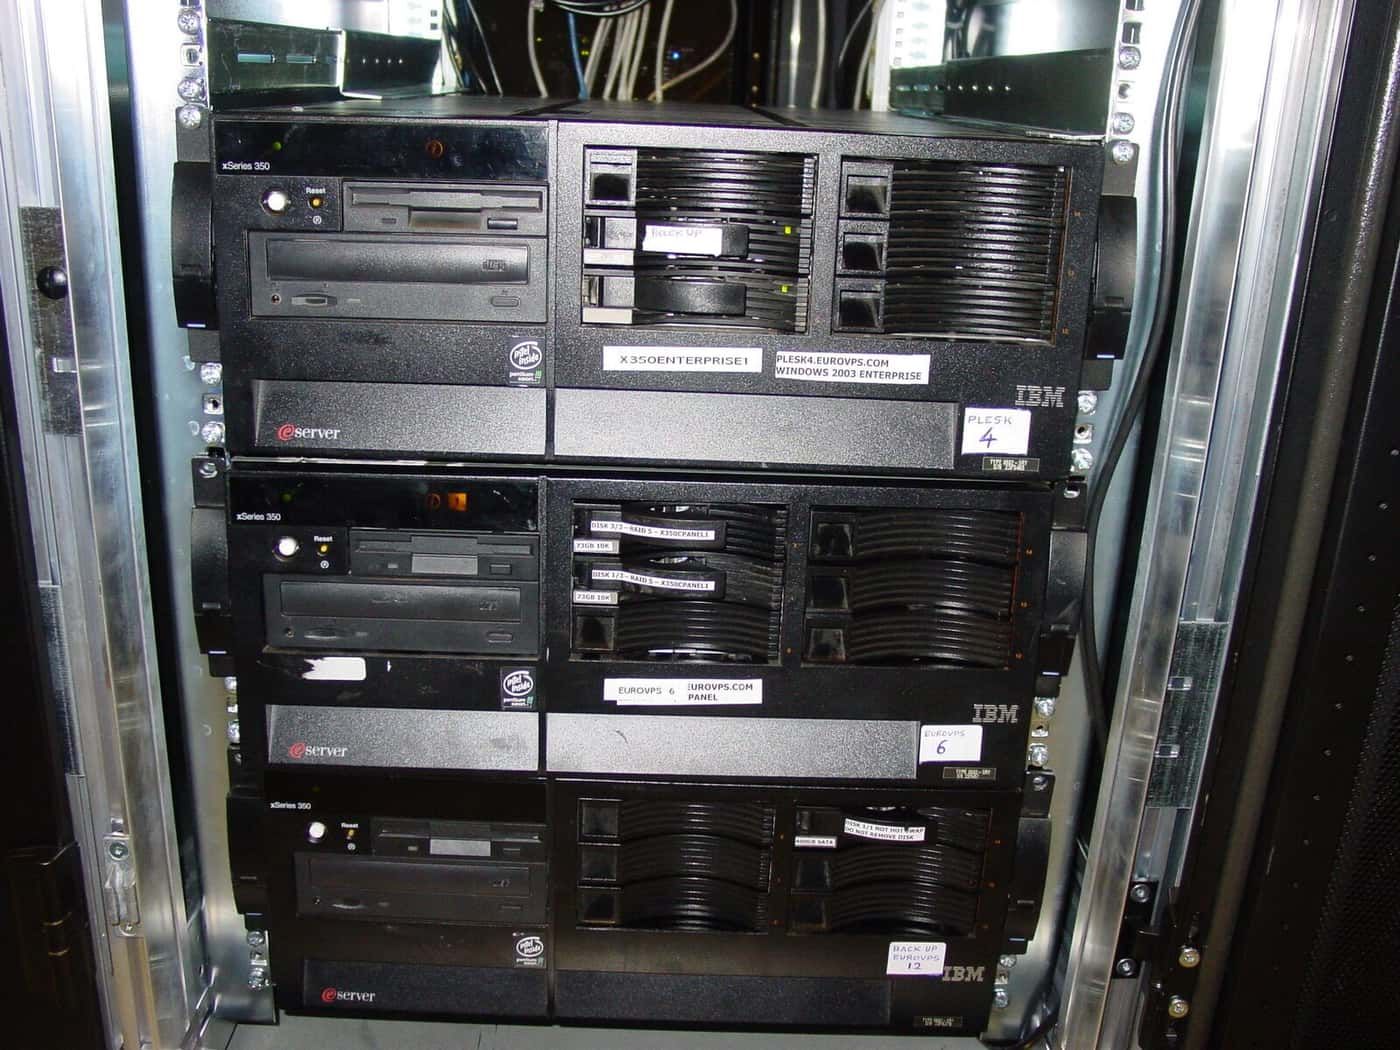
Це був IBM xSeries 350: чотирисокетний сервер enterprise-класу, куплений одразу повністю і внесений на руках у залу колокації в Амстердамі. Найдешевша машина, яка впоралася б із роботою, коштувала частку того, що ми заплатили. Ми все одно купили xSeries, і причина є єдиною корпоративною політикою, яку ми коли-небудь мали: починайте з найкращої машини, яку можете собі дозволити, а не з найдешевшої, яка працює.
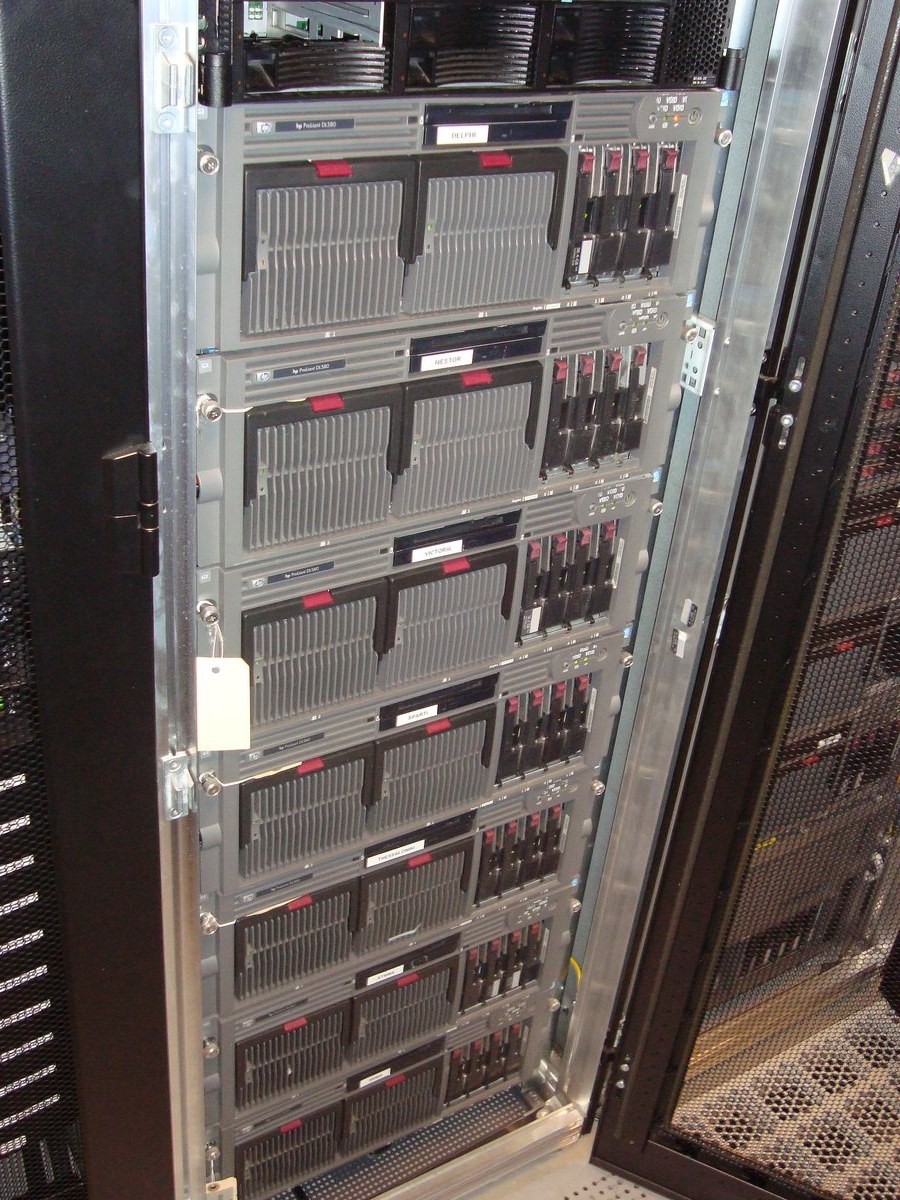
На ньому працював Plesk. Етикетки, які ми надрукували для передньої панелі того першого стека, досі читаються на фотографіях: ім’я хоста на кожній машині, схема RAID по відсіках дисків і одне шасі з позначкою BACK UP. Один сервер, уже промаркований відсік за відсіком, і окрема машина, яка вже робила резервні копії. Ніщо в тому, як ми працюємо сьогодні, не є пізнішим винаходом. Це ті самі звички, з більшою кількістю обладнання.
Амстердамські роки
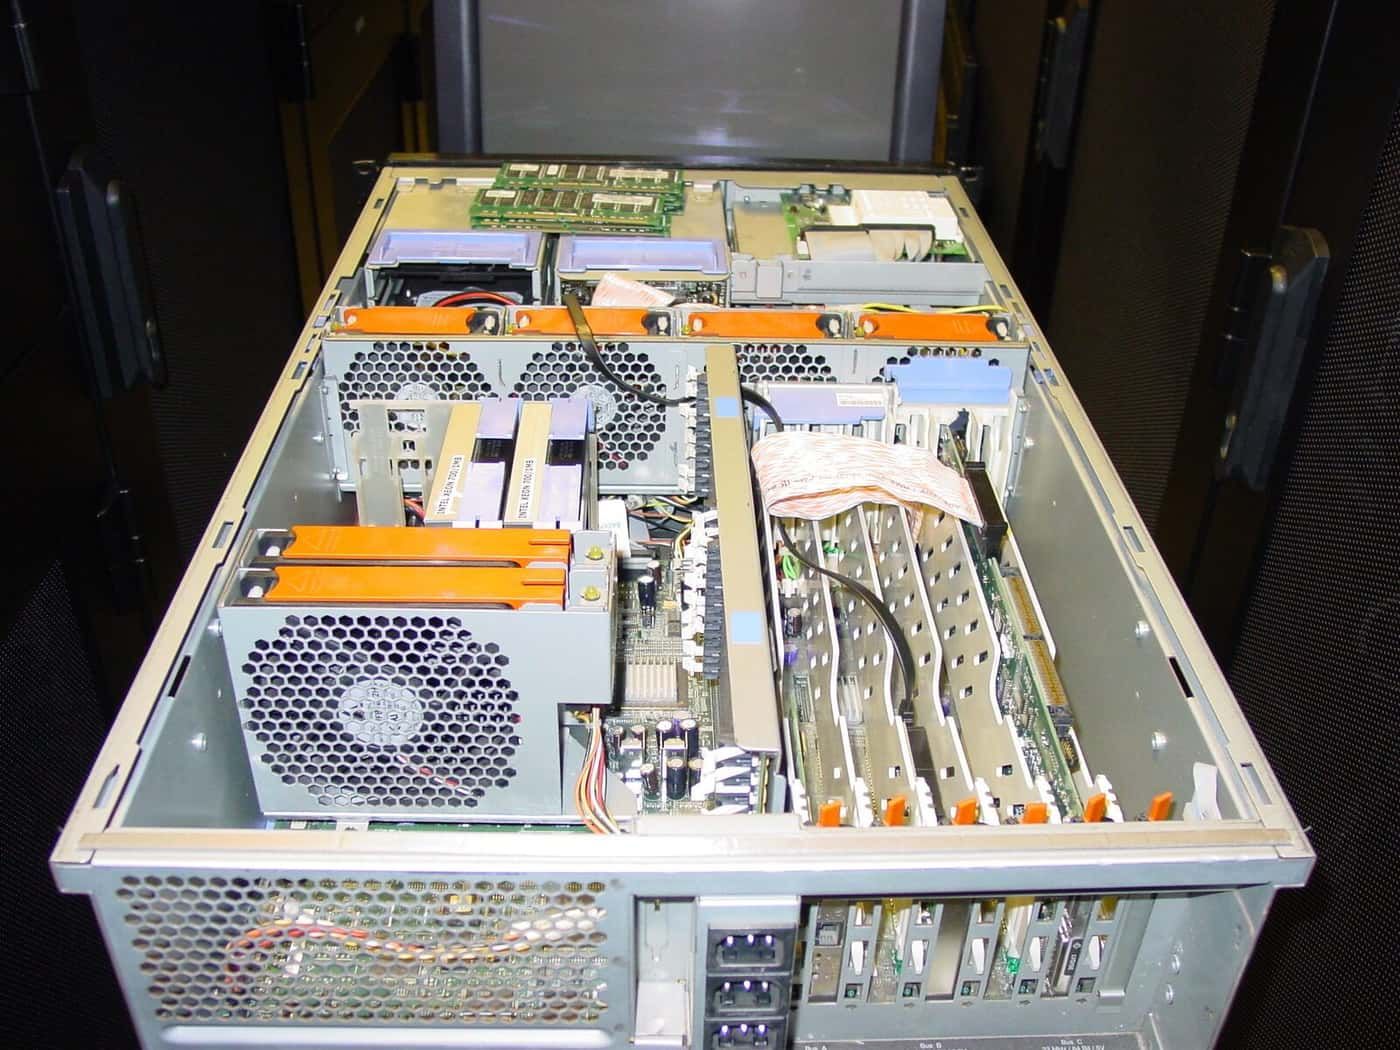
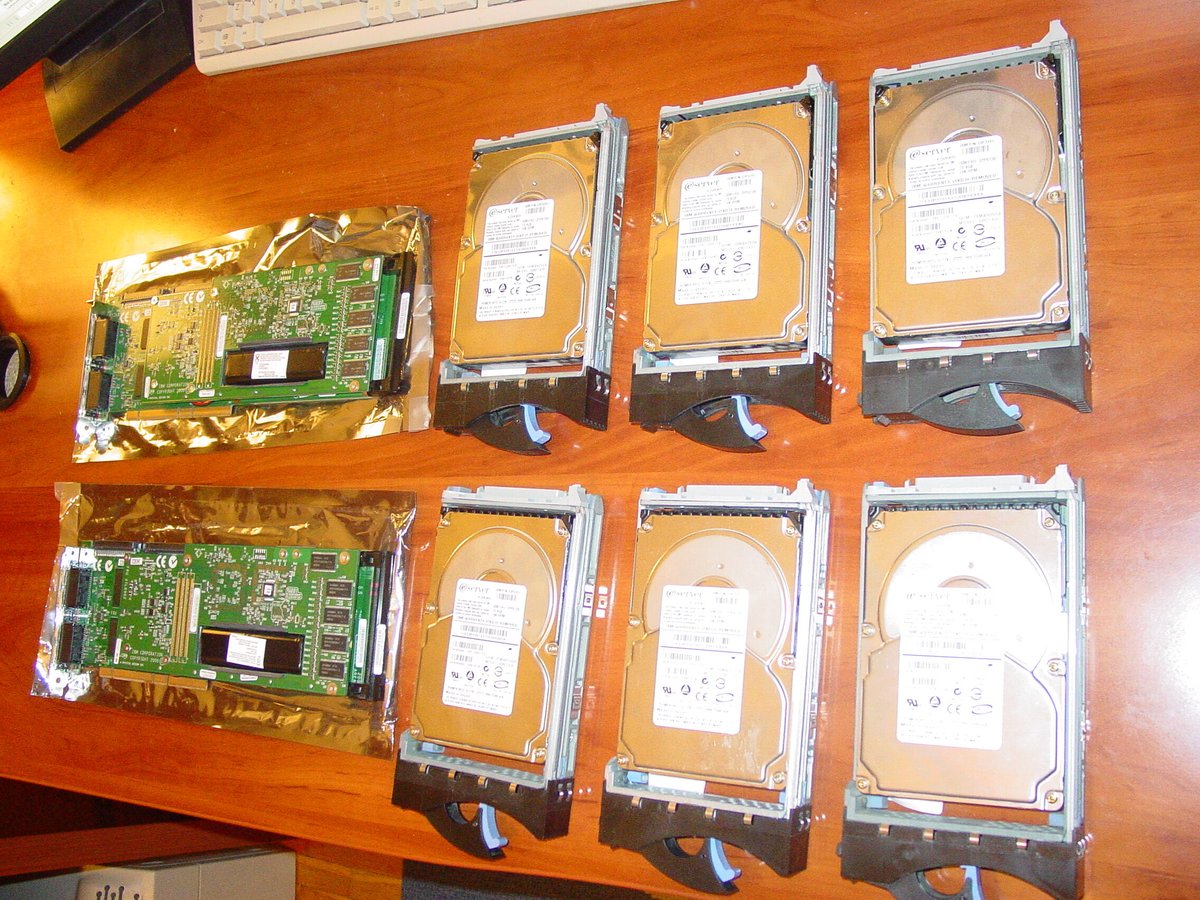
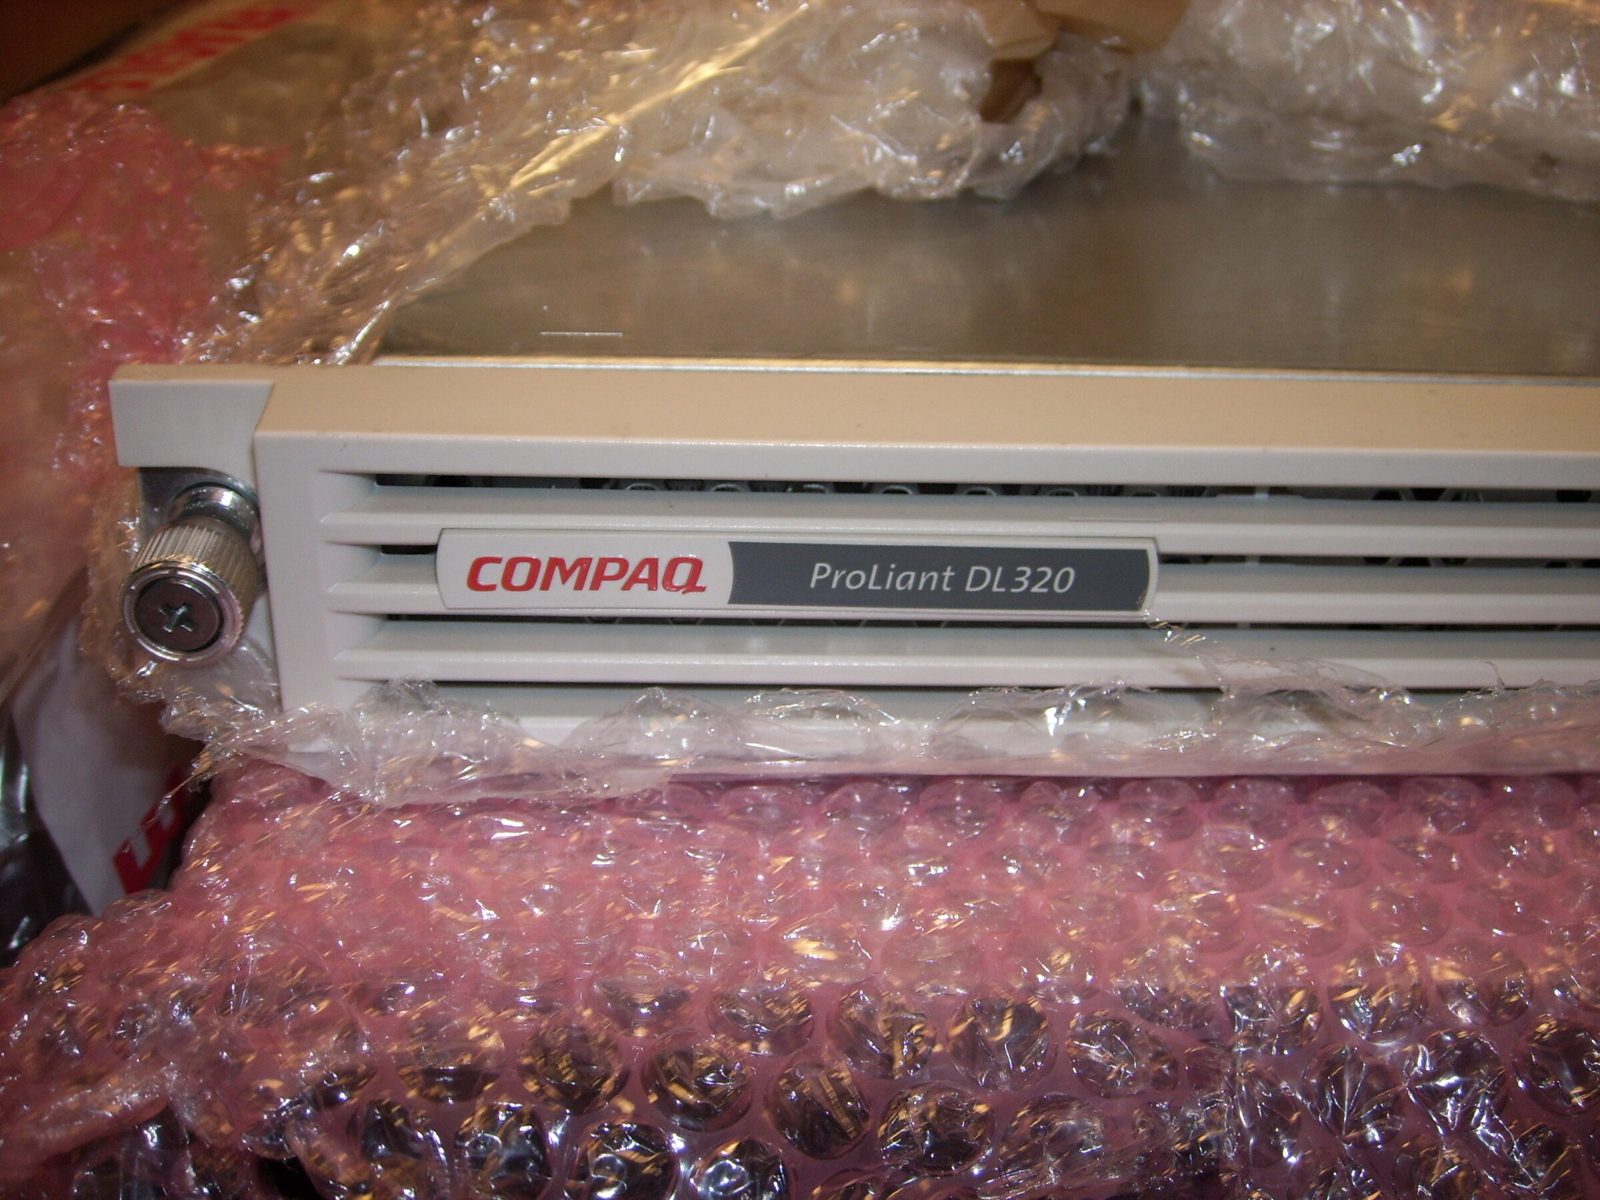
Перші роки були одним проходом між стійками, одним crash cart і одним ноутбуком на підлозі. Спершу IBM xSeries, потім Compaq і HP ProLiant пліч-о-пліч протягом більшої частини десятиліття, куплені новими і розпаковані між шафами. Сховище рано перейшло на enterprise-масиви, EMC CLARiiON поверх подвійних Fibre Channel fabric, з Cisco в ядрі, бо ми радше заплатимо за другий шлях, ніж колись пояснюватимемо, чому його не було. Далі пішли blade-шасі, потім цілі колони з них, і майданчик виріс у власні cage в Iron Mountain.

Афіни, Амстердам, Торонто
Флагман сьогодні є нашим власним cage у Digital Realty Athens: власні маршрутизатори, all-flash сховище, оптика до кожного порту, збудовано так, як був збудований перший rack, нами самими. Амстердам продовжує працювати, з’єднаний з Афінами приватним Layer 2, тож обидва майданчики поводяться як одна мережа, і ви можете переїхати між ними, не змінивши жодної адреси. Торонто покриває Північну Америку через Cogent. Наша корпоративна штаб-квартира на Кіпрі.

Одна операційна система, на всьому шляху
Наш перший сервер працював на Red Hat Enterprise Linux, і ми залишилися на ньому через кожен мажорний реліз відтоді. Не тому, що це було модно: операційна система з опублікованим життєвим циклом, підписаними пакетами, SELinux у режимі enforcing і виробником, який стоїть за кожним оновленням, є рішенням, до якого нам ніколи не доводиться повертатися.
Два десятиліття на одній платформі самі по собі є інвестицією. Кожна збірка, кожне правило hardening і кожен runbook оновлення, які ми маємо, були написані один раз і відтоді лише вдосконалюються, замість того щоб викидатися з кожним новим дистрибутивом місяця.
Ми й віддавали назад. З 2005 року ми тримали публічне дзеркало проєкту CentOS, безкоштовно, з власної мережі, щоб будь-хто у світі міг встановлювати та оновлювати CentOS на bandwidth EuroVPS.
Так, ми спонсоруємо десктоп. Зараз ми даруємо три сервери HPE ProLiant проєкту KDE. Наші інженери працюють на KDE Plasma поверх Red Hat Enterprise Linux довше, ніж існують деякі з наших клієнтів. Коли люди, які обирають обладнання, настільки дбають про інструмент, інструмент отримує сервери.
Якість понад прибуток
Ми родом з епохи до того, як максимізація маржі стала мантрою.
EuroVPS не має венчурного капіталу, зовнішніх інвесторів і плану виходу. Ніхто ніколи не казав нам вирізати витрату з платформи, щоб квартал виглядав краще, бо немає кварталу, який треба показати, і немає того, кому його показувати. Компанією керують люди, які її збудували, сервер за сервером, власними руками.
Це не сентименти, це процес ухвалення рішень. Кожен технічний вибір тут вирішується на інженерних підставах і на тому, чого нам коштуватиме бути розбудженими вночі, а не на тому, що він робить з маржею. Коли хостингова компанія бере гроші ззовні, рано чи пізно вона мусить щось віддати назад, і віддається майже завжди та частина, якої ви не бачите: друга лінія живлення, оригінальний оптичний модуль, запчастина на полиці, senior-інженер о третій ночі. Ми зберегли всі чотири, бо люди, які тут вирішують, є тими самими людьми, які отримують тривогу.
Що ми відмовляємося купувати
Ми хостингова компанія, тож обладнання не є статтею витрат, яку ми намагаємося зменшити. Воно є продуктом. Майже все, що робить дешевий хостинг дешевим, зводиться до короткого списку компонентів, і жоден з них не потрапляє під навантаження наших клієнтів.
Диски SATA
Один порт, один шлях, один контролер: єдина точка відмови за самою конструкцією, і жоден програмний шар над нею не здатен вигадати другий маршрут. SATA має неглибоку чергу і погано відновлюється після помилок, тож диск настільного класу може сидіти й перечитувати слабкий сектор, поки все над ним чекає. Enterprise SAS має два порти, чесно повідомляє свої лічильники помилок і повертає керування досить швидко, щоб рівень RAID зробив свою роботу.
SSD SATA
Той самий єдиний порт, та сама неглибока черга, на інтерфейсі, створеному для дисків, що обертаються. Ставити flash за SATA означає платити за носій, а потім викидати більшу частину того, що він дає. До того ж цей ринок переважно споживчий: низька витривалість, жодного другого порту, часто жодного захисту від втрати живлення.
Споживчі M.2 NVMe-модулі
Споживчі модулі зазвичай не мають конденсаторів захисту від втрати живлення, тож запис, який був у дорозі в момент зникнення живлення, є записом, якого ви можете більше ніколи не побачити, а їхня витривалість розрахована на десктоп, а не на базу даних, яка пише цілий день. Ми використовуємо багато NVMe, у вигляді enterprise-дисків U.2 і U.3 із захистом від втрати живлення в hot plug кошиках. Ніколи у вигляді модуля, приклеєного до плати, що тримає єдину копію.
Односокетні плати настільного класу
Один сокет, один блок живлення, жодного вартого уваги out-of-band керування і замало ліній PCIe, щоб одночасно нести двопортовий Fibre Channel HBA і резервовану мережу. Немає і hot plug backplane, тож кожна відмова компонента означає вимкнення. Конструкція каже одне: якщо це зламається, сервіс залишиться зламаним, доки хтось туди не приїде.
Єдиний блок живлення
Один блок живлення перетворює планові роботи в дата-центрі на простій для клієнта.
Пам’ять без ECC
Ми не запускатимемо навантаження на пам’яті, яка не здатна сказати нам, що виходить з ладу.
Software RAID як історія про стійкість, і white box сервери
Ми не кладемо дані клієнтів на software RAID однієї коробки, з незахищеним кешем запису і парністю, яка перебудовується на процесорі хоста. Стійкість належить масиву і резервованим fabric, де вона переживає навіть повну втрату сервера. White box отримує ту саму відповідь: жодного життєвого циклу прошивок, жодних запчастин на полиці, нікому зателефонувати.
На практиці. Ми нічого не беремо на віру з назви пристрою чи типової настройки ядра: ми опитуємо RAID-контролер і диски напряму, двома незалежними шляхами, і налаштовуємо на основі того, що кожен пристрій насправді повідомляє.
Що ми купуємо натомість
HPE ProLiant і Dell PowerEdge: ProLiant DL380 Gen10 і Gen11, DL385 Gen11 і blade BL460c Gen10. PowerEdge R740, R750 і R7525, а також C6400 для щільних обчислень. Та сама база на кожному з них.
- Два hot plug блоки живлення на двох незалежних лініях.
- Пам’ять ECC всюди, з наглядом за лічильниками виправних помилок.
- Апаратний RAID з кешем запису на батареї або flash всюди, де сервер тримає локальні диски, щоб подія з живленням не коштувала підтвердженого запису.
- Enterprise SAS 12G SSD і enterprise NVMe, розміщені там, де, за вимірюваннями, їм місце.
- Out-of-band керування на кожній машині, у фізично ізольованій (air-gapped) мережі керування, яку маршрутизує власна, повністю окрема автономна система.
Хости, які завантажуються із SAN і нічого не тримають
Наші гіпервізори завантажуються з тому на масиві, поданого через два фізично окремі Fibre Channel fabric. Сам сервер не тримає даних клієнтів, тож зіпсований blade коштує нам одного blade: заміна завантажується з того самого тому. Це заміна деталі, а не відновлення даних.
Машини, які ніколи не перетинають сокет
Домашнє правило, і воно не обговорюється: віртуальна машина ніколи не отримує більше vCPU, ніж фізичних ядер має один сокет, і ніколи більше пам’яті, ніж обслуговує один вузол NUMA. Розтягніть її на два сокети, і частина трафіку пам’яті стає віддаленою, приблизно в 1,7 раза повільнішою за локальну затримку, ще до трафіку когерентності кешу через міжсокетне з’єднання. Штраф накопичується, а не усереднюється, і саме тому машина, розрахована за межу сокета, часто працює повільніше за меншу, яку вона замінила.
Enterprise flash не є RAM
Наші віртуальні машини не отримують swap. Swap у VM зсуває тиск на пам’ять униз на масив і витрачає ресурс запису flash, який існує для обслуговування справжніх даних. Якщо застосунку потрібно більше пам’яті, чесна відповідь є більшою пам’яттю або виправленням у застосунку. Ми скажемо вам, що саме.
Налаштовані, а не як з коробки
Томи на flash отримують правильний планувальник, read-ahead і глибину черги, а не евристики, написані для дисків, що обертаються. Малі, постійні виграші, у кожній збірці.
Сховище: HPE 3PAR, all-flash, усього по два
Дані клієнтів живуть на HPE 3PAR, all-flash, у групах provisioning SSD RAID 6. RAID 6, бо rebuild великого flash-диска є вікном у часі, і ми не проведемо його за одну відмову від втрати даних.

Два контролери, два fabric, багато шляхів
Подвійні контролери на кожен масив. Кожен хост підключається через два фізично окремі Brocade Fibre Channel fabric, по одному порту HBA в кожен, і реєструється з правильною persona, щоб multipathing і ALUA поводилися так, як очікує операційна система. Контролер, fabric, оптичний модуль або порт HBA може зникнути, а том залишається онлайн.
Thin, який каже правду, томи, які переїжджають під час роботи
Томи є thin з автоматичним zero detect, тож повністю виділений диск гостя майже нічого не коштує фізично, доки не прийдуть справжні дані. Масиви об’єднані у federation, тож ми переносимо живий том з одного масиву на інший, поки хост продовжує з нього читати і на нього писати. Для кластерних баз даних ми йдемо далі і розміщуємо кожного учасника на іншому фізичному масиві, щоб втрата цілого масиву коштувала однієї репліки, а кворум зберігався.
Гігієна дисків і дисципліна записів
Диск, який повідомляє про виправлену помилку, є диском, чия внутрішня корекція помилок уже працює, під живим трафіком клієнтів. Ми не чекаємо, доки він вийде з ладу: він повністю звільняється, виводиться, замінюється чистим диском, і масив приймає новий автоматично.
Резервні копії витягуються, а відновлення відповідає сервісу
Резервні копії є виключно pull. Захищені системи не мають маршруту до інфраструктури резервного копіювання і не мають облікових даних до неї, тож компрометація на боці production не може дістатися до резервних копій. Захищена сторона сама тягнеться і бере те, що їй потрібно, ніколи навпаки. Цілі відновлення встановлюються для кожного сервісу окремо, а не одним числом для всіх: статичний сайт і транзакційна база даних не заслуговують на однакову відповідь.
Провайдер може пізніше замінити сховище, сервери і програмне забезпечення. Чого не виправити заднім числом, так це кабелювання, оптики і маршрутизаторів, на яких усе збудовано, тож їх ми зробили правильно першими.
Оптика від краю до краю
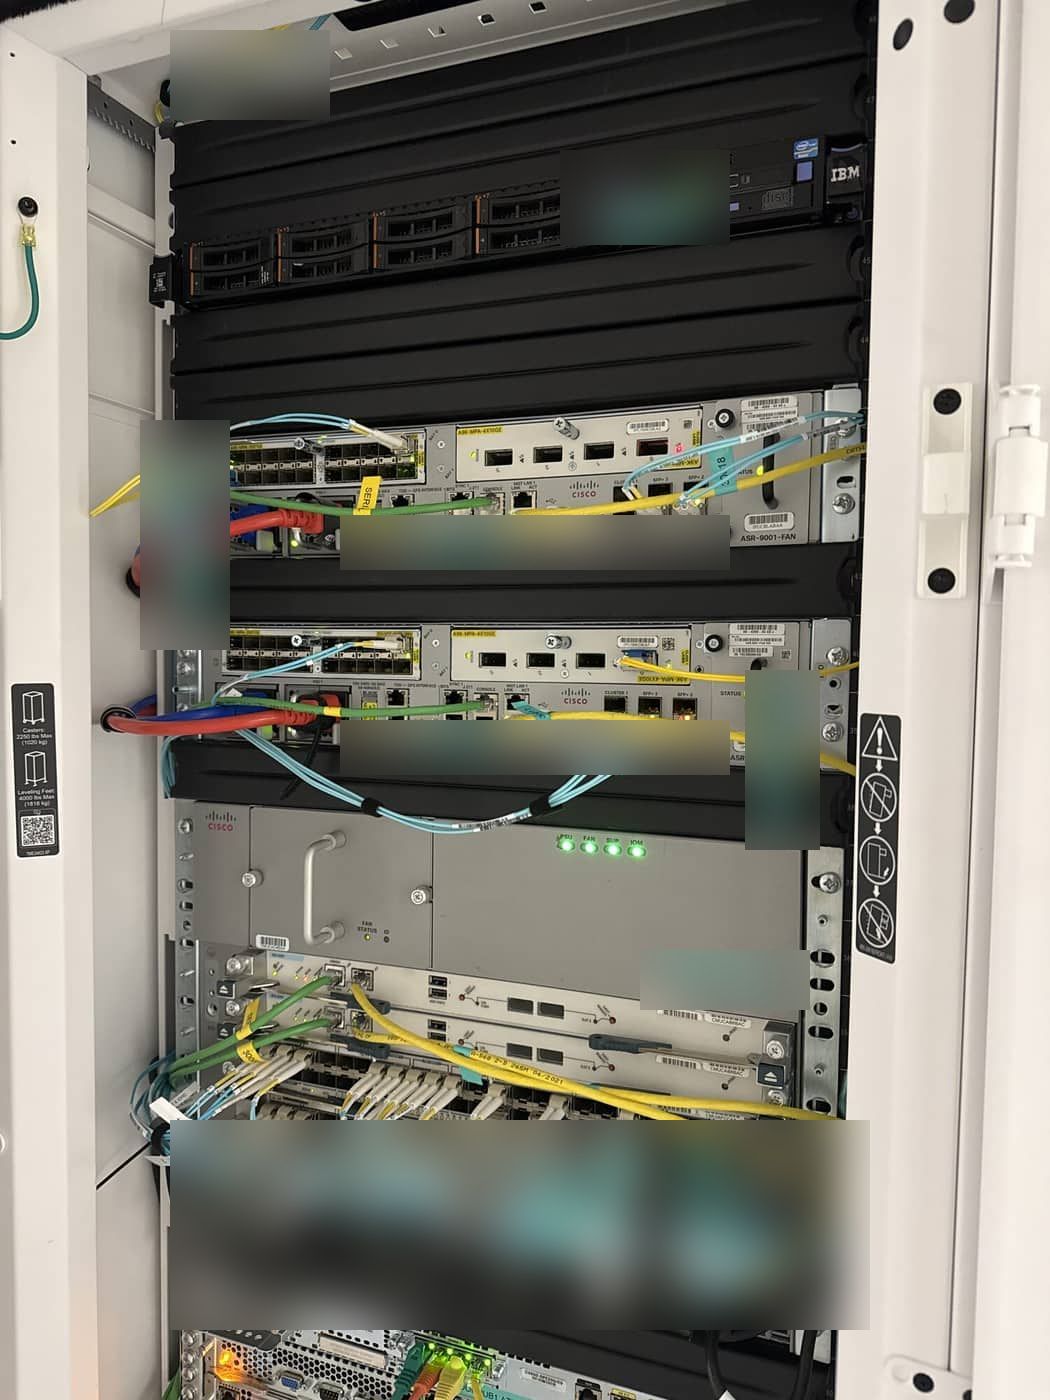
У нашому cage в Афінах немає мідного кабелювання для даних. Кожен сервер, кожне blade-шасі, кожен масив сховища, кожен комутатор і кожен маршрутизатор підключені оптичним волокном. Єдина мідь, що лишилася в шафі, це короткий відрізок до порту lights-out керування сервера, і це навмисно: це той єдиний інтерфейс, чия робота полягає в тому, щоб працювати, коли все інше вимкнено.
Скло виграє за кожною віссю, яка має значення всередині шафи. Оптичному каналу байдуже до електричних завад чи силового кабелю, що лежить поруч, тож канал або справний, або відсутній, ніколи не загадково граничний, а траса перетинає rack, ряд і залу з тією самою специфікацією. Високошвидкісна мідь товста, важка і погано гнеться, і ця маса зрештою висить на комутаторі, який вона обслуговує, перед його витяжкою. Волокно тонке і легке, тож шафи залишаються чистими. А коли приходить наступне покоління швидкостей, інсталяція лишається на місці: ми змінюємо трансивер з кожного боку і залишаємо кабель.
На практиці. Перед запуском нових клієнтських платформ ми збудували всю оптичну і port-channel топологію blade-rack до того, як більшість blade взагалі існувала. День запуску був увімкненням живлення, а не роботою з кабелями.

Тільки оригінальна оптика
Кожен SFP, SFP+ і QSFP у наших rack є оригінальною деталлю виробника, підібраною до комутатора чи маршрутизатора, в якому вона стоїть, і підтримуваною вендором, чиє ім’я написане на шасі. Ми ніколи не купували generic трансиверів і не збираємося починати.
Економія мала, а купує чотири проблеми: оптичні показники, які можуть нічого не означати, що позбавляє вас найкращої діагностики в оптичній мережі, живого рівня світла з кожного боку. Модуль, який працює на одній версії програмного забезпечення і капризує на наступній, бо ніхто не тестував цю комбінацію. Законну підставу для вендора закрити звернення в підтримку, яке ви відкриваєте тієї ночі, коли воно потрібне найбільше. І канал, який робить flap під навантаженням з причин, яких ніхто не може відтворити. Тож ми купуємо правильну деталь, і купуємо запас: лотки з оптикою на полиці всередині дата-центру, щоб заміна була прогулянкою проходом, а не замовленням на закупівлю.
На практиці. Наші регулярні перевірки здоров’я читають лічильники помилок інтерфейсів і оптики по всій fabric, і оскільки кожен модуль є оригінальним від вендора, те, що вони повідомляють, можна використати: трансивер, який виходить за межі специфікації, є плановою заміною з лотка, у наш час.


Fabric: leaf і spine, EVPN і VXLAN
Усередині дата-центру все тримається на fabric leaf і spine на Cisco Nexus 9000, яка працює на BGP EVPN з VXLAN. Spine є чистими route reflector, без кінцевих точок тунелів на них за задумом. Leaf будуються парами virtual port-channel, тож кожен хост під’єднаний dual-homed до двох комутаторів через один логічний bond, а шлюз підмережі клієнта є однією й тією самою anycast-адресою на кожному leaf. Широкомовний трафік реплікується через BGP, а не через дерево multicast, а BFD працює там, де має значення швидке виявлення. Оскільки будь-який VLAN може жити на будь-якому leaf, ми можемо розтягнути Layer 2 клієнта між нашими дата-центрами і дати його серверам зберегти свої адреси під час переїзду.
Мережевий ідентифікатор кожного сегмента Layer 2 виводиться з його локального VLAN за фіксованим правилом, і це правило не є домовленістю в документі. Автоматизована перевірка читає карту з кожного leaf, підтверджує, що leaf ідентичні і дотримуються правила, і порівнює криптографічний відбиток усієї карти з підписаним базовим станом у системі контролю версій. Вона запускається перед збереженням будь-якої зміни і за розкладом після, відхилення викликає інженера, а навмисна зміна має бути перепідписана, тож кожна зміна у fabric несе автора і слід аудиту.
На практиці. У контрольованому тесті відмови ми перезавантажили вузол кластера, поки він був пріоритетним шляхом для живої публічної адреси. Fabric зійшлася на здоровий вузол приблизно за три секунди, і адреса жодного разу не зникла з таблиці маршрутизації.

Edge: наші власні автономні системи
Ми тримаємо власний інтернет-edge, на власних автономних системах, зареєстрованих у RIPE, і з власним простором IPv4 та IPv6, причому production клієнтів і платформні сервіси розміщені в окремих автономних системах, щоб проблема в одній не могла дістатися іншої. Маршрутизатори операторського класу: серія Cisco ASR 9000 в Афінах, ASR 9006 на передньому краї production-edge, і Juniper MX204 в Амстердамі, кожен тримає повну таблицю маршрутизації інтернету і обмінюється нею зі своїм братом.
Ми купуємо транзит у кількох операторів, замість того щоб орендувати порт у того, кому належить будівля: OTE Globe, Cogent і Hurricane Electric в Афінах, Arelion, NTT, Deutsche Telekom і Telecom Italia з боку Амстердама, причому обидва майданчики з’єднані приватним Layer 2, тож уся інсталяція поводиться як одна мережа. Ми робимо прямий peering на GR-IX і NetIX, і додаємо двосторонні сесії одну за одною з мережами, з якими насправді говорять наші клієнти.
IPv6 є нативним усюди: dual-stack від edge-маршрутизаторів до вашого шлюзу, без тунелів і без трансляції на шляху.
На практиці. Наша афінська fabric перейшла на dual-stack за один робочий день, від інтернет-edge через fabric до живого спільного VLAN клієнтів.

Fibre Channel: два fabric, ніколи один шлях
Мережа між серверами і сховищем є Fibre Channel, а не Ethernet, збудованою як два повністю незалежні Brocade fabric. Кожен сервер і кожен масив підключені до обох, кожна fabric має власну комутацію ядра і власний комутатор усередині кожного blade enclosure, тож жоден окремий комутатор, кабель, порт чи програмна помилка не існує з обох боків шляху хоста.
На практиці. Оскільки кожен хост уже тримає живі шляхи до кожного масиву своєї federation в обох fabric, ми можемо спорожнити цілий масив сховища, для обслуговування чи переїзду, без перезавантаження клієнтської машини і без вікна обслуговування.
Зашифрований backbone між нашими майданчиками
Наші дата-центри в Афінах, Амстердамі й Торонто, наша корпоративна штаб-квартира на Кіпрі і наші регіональні точки присутності з’єднані overlay Cisco DMVPN: multipoint GRE-тунелі, захищені IPsec з AES-256, автентифікований NHRP, BFD і BGP поверх тунелів. Кожен дата-центр має резервовані hub, і оскільки overlay маршрутизується через BGP, а не статичними таблицями, втрата hub або каналу є відкликанням маршруту, яке сходиться саме по собі.
Майданчик з двома WAN-каналами тримає другу DMVPN cloud на тому самому маршрутизаторі, тож другому каналу не потрібна нова публічна адреса і не потрібні зміни на hub, а BGP multipath розподіляє трафік між обома з хешем пересилання, який включає порти, тож паралельні потоки справді розділяються. Ми розраховуємо на те, що двигун шифрування справді може зробити, близько 11 Гбіт/с на hub, а не на число, надруковане в ліцензії, і масштабуємо за допомогою equal-cost multipath між hub до 30 або 40 Гбіт/с, коли клієнту це потрібно.
На практиці. На майданчику з двома каналами тест пропускної здатності виміряв у кожному напрямку більше, ніж будь-який з каналів міг перенести сам. Це єдиний прийнятний доказ того, що equal-cost multipath працює, а не просто налаштований.
Дисципліна, яка йде в комплекті
Bond, які використовують обидва канали. Типове налаштування bonding у Linux хешує за MAC-адресами, що в дата-центрі складає потоки на один учасник bond і залишає інший бездіяльним. Кожен сервер з bond, який ми будуємо, хешує за layer 3 і layer 4, зі стороною комутатора, налаштованою відповідно. Ми перевіряємо лічильники по портах у кожній збірці, щоб довести, що обидва канали несуть трафік.
Кожен порт обліковано. Не ім’я в рядку: порт з його справжньою MAC-адресою, лінк до порту віддаленого комутатора з його cable ID, позиція в rack, адреси і інтерфейс керування. Живий пристрій є джерелом істини, а записи приводяться у відповідність до нього.
Зворотний запис для кожної адреси. Кожна адреса, яку ми призначаємо інтерфейсу, loopback, сервісу чи хосту, отримує PTR у нашому власному авторитетному DNS, у тій самій сесії. Traceroute через нашу мережу читається як речення, яке називає пристрій, його роль і його майданчик.
Площина керування і повітряний зазор
Трафік клієнтів і трафік керування не ділять нічого: ні порту, ні комутатора, ні адреси, ні маршруту.
У наших шафах лишився рівно один мідний кабель: порт керування lights-out контролера кожного сервера. Він також є найретельніше ізольованим кабелем у будівлі.
Out-of-band керування на кожній машині
Кожен сервер, який ми експлуатуємо, є справжнім enterprise-сервером зі справжнім lights-out контролером: iDRAC Enterprise з ліцензією Datacenter на Dell, iLO Advanced на HPE, обидва керовані через Redfish, і кожне blade-шасі через свій Onboard Administrator. Не white-box материнська плата, для якої віддалене керування означає кнопку живлення і жодної консолі.
На blade-шасі Onboard Administrator досягає кожного контролера в enclosure через backplane, і сам є резервованою парою з автоматичним failover.
На практиці. Коли rack із blade-шасі потребував ліцензій iLO Advanced і облікового запису керування на кожному blade в ньому, ми не входили на жоден blade. Ми провели це через Onboard Administrator кожного шасі, і rack був готовий за хвилини, включно з blade, встановленими того тижня, які ще не мали власних облікових даних. Це runbook.
Мережа керування не є мережею production
Контролер має власний фізичний порт і власний кабель до власної комутації. Ми не ділимо мережеву карту production, щоб позичити контролеру її шматок, що є звичним скороченням і звичною причиною, чому керування опиняється за одну помилку від інтернету. Керування живе на власних комутаторах або на власних VLAN поверх fabric, які не несуть нічого іншого, у приватному адресному просторі, який не маршрутизується до жодної клієнтської мережі чи з неї і ніколи не анонсується в інтернет.
Ми називаємо це повітряним зазором, бо саме так воно поводиться. Віртуальна машина клієнта, навіть повністю скомпрометована, яка тиждень сканує на швидкості лінії, взагалі не може побачити iLO чи iDRAC. Не відхилено, не відфільтровано: відсутнє. Пакетам нікуди йти. Це працює і в інший бік, і це важить не менше: жоден трафік керування не їздить клієнтським VLAN, тож наші консольні сесії, моніторинг і резервні копії ніколи не входять у широкомовний домен клієнта і не конкурують за його bandwidth. Ізоляція достатньо реальна, щоб бути незручною для нас, і саме це є доказом її реальності: контролер у VLAN керування не може мимохідь дістатися до внутрішнього веб-сервера, щоб стягнути образ прошивки, бо не дозволено нічого, про що не попросили і що не записали. Інженер робить додатковий крок.
Резервні копії подорожують так само. Вони знімаються через out-of-band мережу, ніколи через сегмент production.
На практиці. Один канонічний список доступу керування прив’язаний на кожній платформі, яку ми експлуатуємо: на лініях входу Cisco Nexus, на кожен routing instance на маршрутизаторах, на кожен інтерфейс для SSH і HTTPS на firewall, дозволяючи лише іменовані підмережі керування, з control plane policing, який обмежує апаратно все, що лишилося.
Сама площина керування
Площина керування є мережею сама по собі, і ми збудували її як мережу. Вона працює на нашому власному зашифрованому backbone між майданчиками: Cisco DMVPN, IPsec на AES-256, BGP поверх тунелів, з’єднуючи Афіни, Амстердам і Торонто з нашою корпоративною штаб-квартирою на Кіпрі, яка навмисно не розташована в жодній з будівель, якими керує. Hub резервовані, з маршрутами рівної вартості між ними і через різні канали, і з виявленням відмов, яке помічає мертвий шлях значно швидше ніж за секунду.
Персонал потрапляє туди одним шляхом: через VPN-шлюзи і firewall, якими ми володіємо і які самі експлуатуємо, на OPNsense і Cisco Firepower, а потім через jump hosts усередині площини, а не напряму з ноутбука інженера. Різні рівні довіри ніколи не ділять один об’єкт firewall, тож розширення доступу однієї групи не може тихо розширити доступ іншої.
У бік площин резервного копіювання і аварійного відновлення політика є забороною за замовчуванням, і дані течуть в один бік. Production ніколи не штовхає в резервне копіювання. Сторона резервного копіювання тягне. Це забезпечується явними правилами заборони на firewall-пристроях, а не host firewall, який скомпрометований хост міг би змінити, і сегменти резервного копіювання взагалі не мають маршруту в інтернет. До них дістається лише діапазон керування. Якщо машину production захоплять повністю, зловмисник не отримає жодних знань про інфраструктуру резервного копіювання і жодного шляху до неї. З того місця, де він стоїть, її не існує.
Зміни в backbone перевіряються наживо на працюючій системі, по одній половині резервованої пари за раз, і саме тому ми можемо працювати над backbone посеред робочого дня.
На практиці. Ми перенесли весь парк site-to-site VPN клієнта з однієї країни в іншу за одну сесію, перед жорстким дедлайном. Hub було клоновано, перенесено і піднято паралельно з оригіналом, тож обидва були живими одночасно, і тунелям завжди було куди подітися. Маршрутизатори філій переносилися один за одним, кожен перевірявся в роботі перед тим, як торкнутися наступного, кожен чисто переходив на резерв по дорозі. Ніхто не їздив до філії.
Базовий стандарт hardening на кожному хості
Кожна машина, яку ми будуємо, починається з того самого базового стандарту, і він не підлягає обговоренню. SELinux у режимі enforcing, і ми не вимикаємо його, щоб застосунок став поступливішим, ми натомість пишемо політику. Файлові системи є XFS.
Оновлення не залежить ні від кого іншого. Ми тримаємо власне дзеркало пакетів у власному дата-центрі, з репозиторіями, з яких встановлюється наш парк, з незайманими upstream-підписами, доступне лише з наших власних діапазонів адрес. Публічне дзеркало, у якого поганий день, тут не є подією, а сервер, який навмисно не може говорити з інтернетом, усе одно є сервером, який ми можемо повністю оновити.
На практиці. Коли було опубліковано критичну вразливість у широко використовуваному runtime, виправлені пакети були в production на кожному ураженому сервері того самого дня, до кінця тієї самої ночі. Не вручну і не поспіхом: розгортання робить резервну копію, оновлює по одному хосту за раз, вибірково перевіряє справжні сайти на цьому хості на здорову відповідь до і після, і автоматично зупиняє весь прохід, якщо один не повертається коректно. Швидко і обережно не є протилежностями, якщо ви збудували те, що робить це за вас.
Журнали машин надходять, і нічому не дозволено замовкнути
Серйозні рівні критичності йдуть прямо в операційний чат, де вже є черговий інженер, і досягають людини за секунди, і ми знаємо, що це секунди, бо заміряли це справжньою тривогою. На edge виділені сенсори читають дзеркальний трафік з прикордонних маршрутизаторів і безперервно стежать за об’ємними патернами і патернами відмови в обслуговуванні.
Пристрій може виглядати цілком здоровим зі своєї власної командної оболонки, тихо не надсилаючи нічого до collector, тож «логування налаштовано» тут не є доказом. Ми підтверджуємо, що журнал прибуває, на дальньому кінці, у той потік, якому належить, після кожної зміни, яка могла його порушити. Системи моніторингу мають власні watchdog на окремих машинах, тож «те, що стежило, перестало стежити» саме по собі є тривогою. Тиша ніколи не є доброю новиною.
На практиці. Наша регулярна перевірка здоров’я перевіряє також дві речі, які більшість перевірок пропускає: чи кожен пристрій досі справді надсилає свої журнали, і чи його конфігурація досі справді резервується. Саме ці дві відмови ховають усі інші.
Аналіз у реальному часі на наших власних NVIDIA A100
Більшість провайдерів збирають журнали у відро і шукають у ньому вже після того, як щось зламалося. Ми змушуємо потік працювати. Базові правила спершу прибирають відомий шум, а потім усе, що лишилося, з маршрутизаторів, комутаторів, firewall, масивів сховища і серверів, аналізується в момент надходження моделями AI, які працюють на масиві наших власних GPU NVIDIA A100, усередині нашого власного дата-центру.
Моделі читають упоперек пристроїв, а не по одному рядку журналу: помилка шляху до сховища, інтерфейс, який робить flap, і температура, яка росте в тому самому rack, стають однією історією замість трьох непов’язаних повідомлень. Вони вловлюють патерни, яких статичне правило не вловить ніколи, повільний дрейф і незвичну комбінацію, що передує відмові, і кожна тривога досягає інженера з уже доданою другою думкою. Машинні дані перестають бути купою тексту для grep і стають раннім попередженням.
Ніщо з цього не покидає нашу мережу. Моделі, GPU і дані належать нам, і жоден рядок журналу ніколи не надсилається зовнішньому сервісу AI.
CTO, який нас оцінює, може попросити список доступу, runbook і маршрутизацію тривог. Ми покажемо вам усі три.
Запчастини на місці
Запчастини, аж до цілих шасі, лежать у тому самому cage, що й машини, яким вони знадобляться, а не в договорі постачання якогось вендора.
Запчастина не заслуговує місця на цій полиці самим фактом прибуття. Диски йдуть на тестовий стенд, проходять low-level format у формат сектора масиву, який обслуговуватимуть, і потрапляють на склад лише тоді, коли повідомляють нуль grown defects і жодної невиправленої помилки читання, запису чи перевірки. Запчастина, яка ламається тієї ночі, коли вона вам потрібна, ніколи не була запчастиною.
Замінювати рано, оновлювати вчасно
Обладнання тут виводиться з експлуатації на підставі даних, а не відмови.
Критичні вразливості, того самого дня. Коли розкривається вада найвищої критичності в чомусь, від чого ми залежимо, ми збираємо виправлені пакети того самого дня, коли публікується виправлення. Захисна конфігурація накладається негайно. Якщо для платформи, яку ми експлуатуємо, ще немає виправленого пакета, ми збираємо його самі, скомпільованого в чистому контейнері за специфікацією самого мейнтейнера, звіреного з опублікованим вихідним кодом проєкту, встановленого хост за хостом з перевірками до і після. Останнього разу, коли це знадобилося, виправлення було в production приблизно через три години після публікації вихідного коду. З тієї ж причини ми тримаємо власне дзеркало пакетів.
Документація як інфраструктура
Багато компаній мають документацію. Ми ставимося до неї як до частини інсталяції.
Кожен кабель несе унікальний надрукований ідентифікатор з одного реєстру, який не може видати один номер двічі і ніколи не використовує його повторно, навіть після того, як кабель витягнуто. Етикетка називає обидва кінці, rack, пристрій і порт на кожному. Двадцять два роки кабелювання досі можна простежити від етикетки до запису, до порту комутатора і назад.
Сервіс не закінчено, коли він працює. Він закінчений, коли його адреса, його правило firewall, його запис в обліку і його прямий та зворотний DNS існують і перевірені ззовні нашої мережі.
Наші інструменти відмовляють у виконанні команди, коли правило не дотримано, що є кращим запобіжником, ніж добрі наміри.
Саме це має значення о третій ночі. Питання тоді ніколи не про те, яке рішення найрозумніше. Питання про те, що змінилося і як це повернути назад.
Сертифіковані і перевірені аудитом
Усі чотири видано у вересні 2026 року національно акредитованим органом сертифікації, з областю застосування, записаною як «Managed datacenter hosting service». Це саме той сервіс, який ви насправді купуєте, а не закуток компанії, вибраний для того, щоб аудит минув легко.
Ваші дані залишаються там, де ви їх поклали, і на наших європейських майданчиках це означає в межах ЄС, на обладнанні, яке належить нам, без public cloud знизу. Ми підписуємо угоду про обробку даних, а наш документ про технічні та організаційні заходи доступний за запитом.
Інженери, а не рівні
Без ботів і без завченої першої відповіді.
Інженери, які обирають обладнання, монтують його в rack, кабелюють і маркують, є тими самими інженерами, які відповідають на ваш тікет, і вони підписують його власним ім’ям. Це працює, бо люди тут знають вашу конфігурацію на ім’я і достатньо досвідчені, щоб не потребувати сценарію.
За всю історію наших тікетів медіанна перша відповідь становить три хвилини, а 87 відсотків тікетів вирішуються протягом години. Чималу частку відкриваємо ми, а не ви: наш моніторинг цілодобово стежить за всім, за що ми відповідаємо, аж до ваших справжніх сторінок, і тривоги потрапляють у канал, який читають інженери.
Усе ті самі
Ті самі стандарти. Та сама інженерія власними руками. Досі без інвесторів, досі без плану виходу, і досі те правило, з якого ми почали в залі колокації в Амстердамі: купуй кращу машину.
Ми проводимо екскурсії в супроводі до афінського дата-центру: cage, оптика, оптичні модулі у своїх лотках, запчастини на полиці. Ми проведемо вас самі, бо саме ми це збудували. Візьміть із собою інженера.
Ваш наступний партнер з інфраструктури
Хочете побачити це на власні очі?
Розкажіть нам, що ви запускаєте. Інженер відповість, а візит до дата-центру за наш рахунок.
+357 222 32280
Почнімо з вашої інфраструктури.
Трохи контексту допомагає нам почати правильну розмову.