

Dal 2004: Nessun compromesso
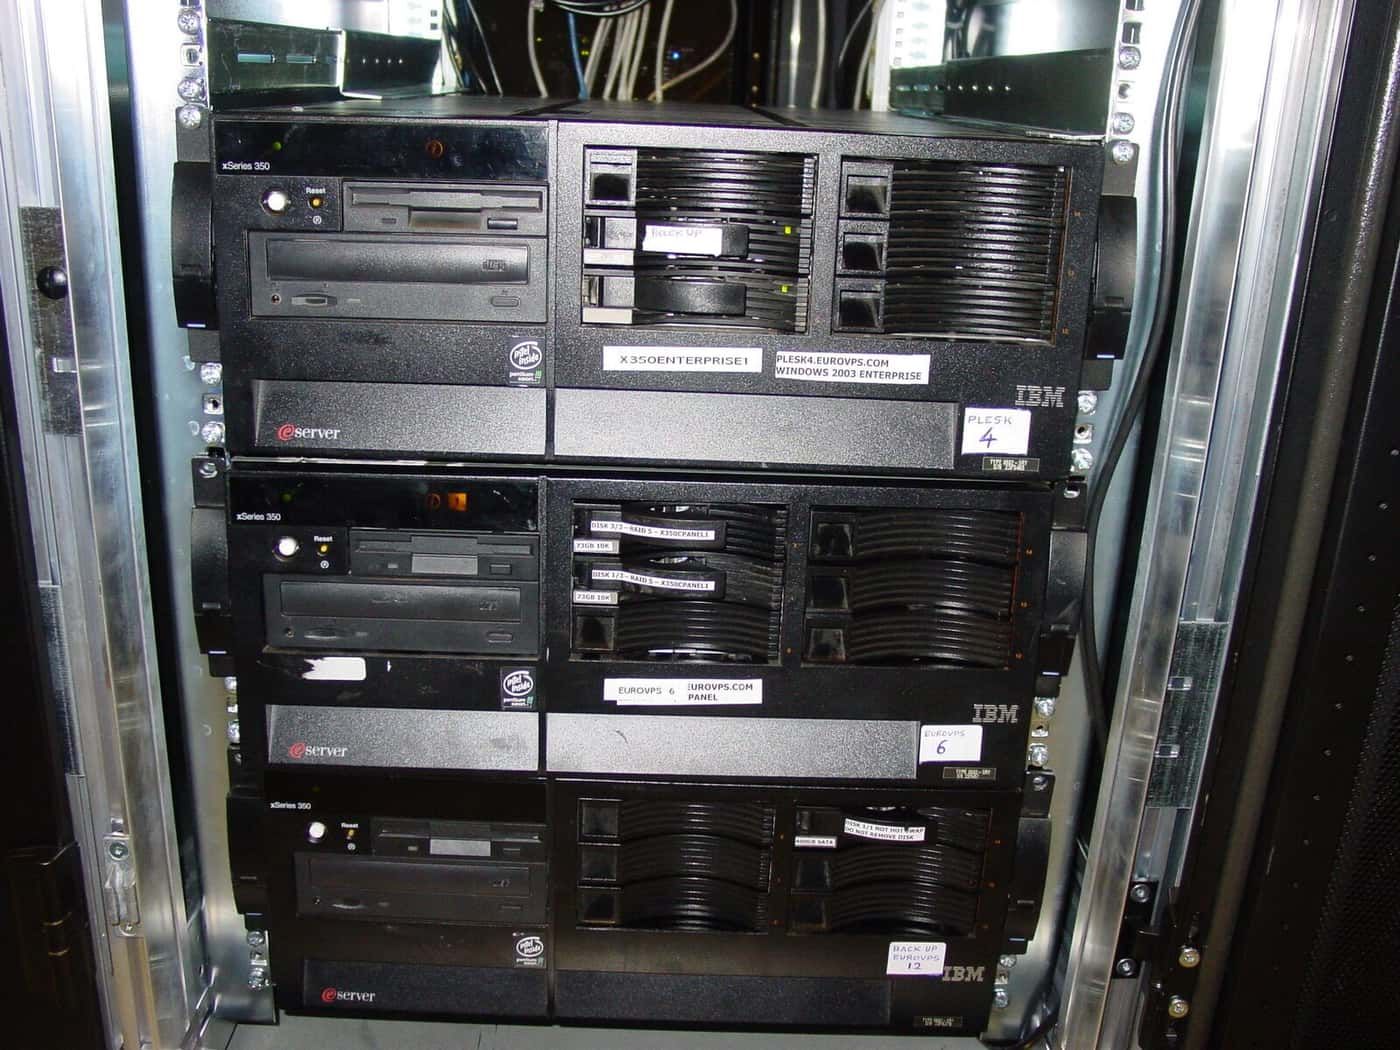
Nel 2004 EuroVPS era una macchina. Non una economica.
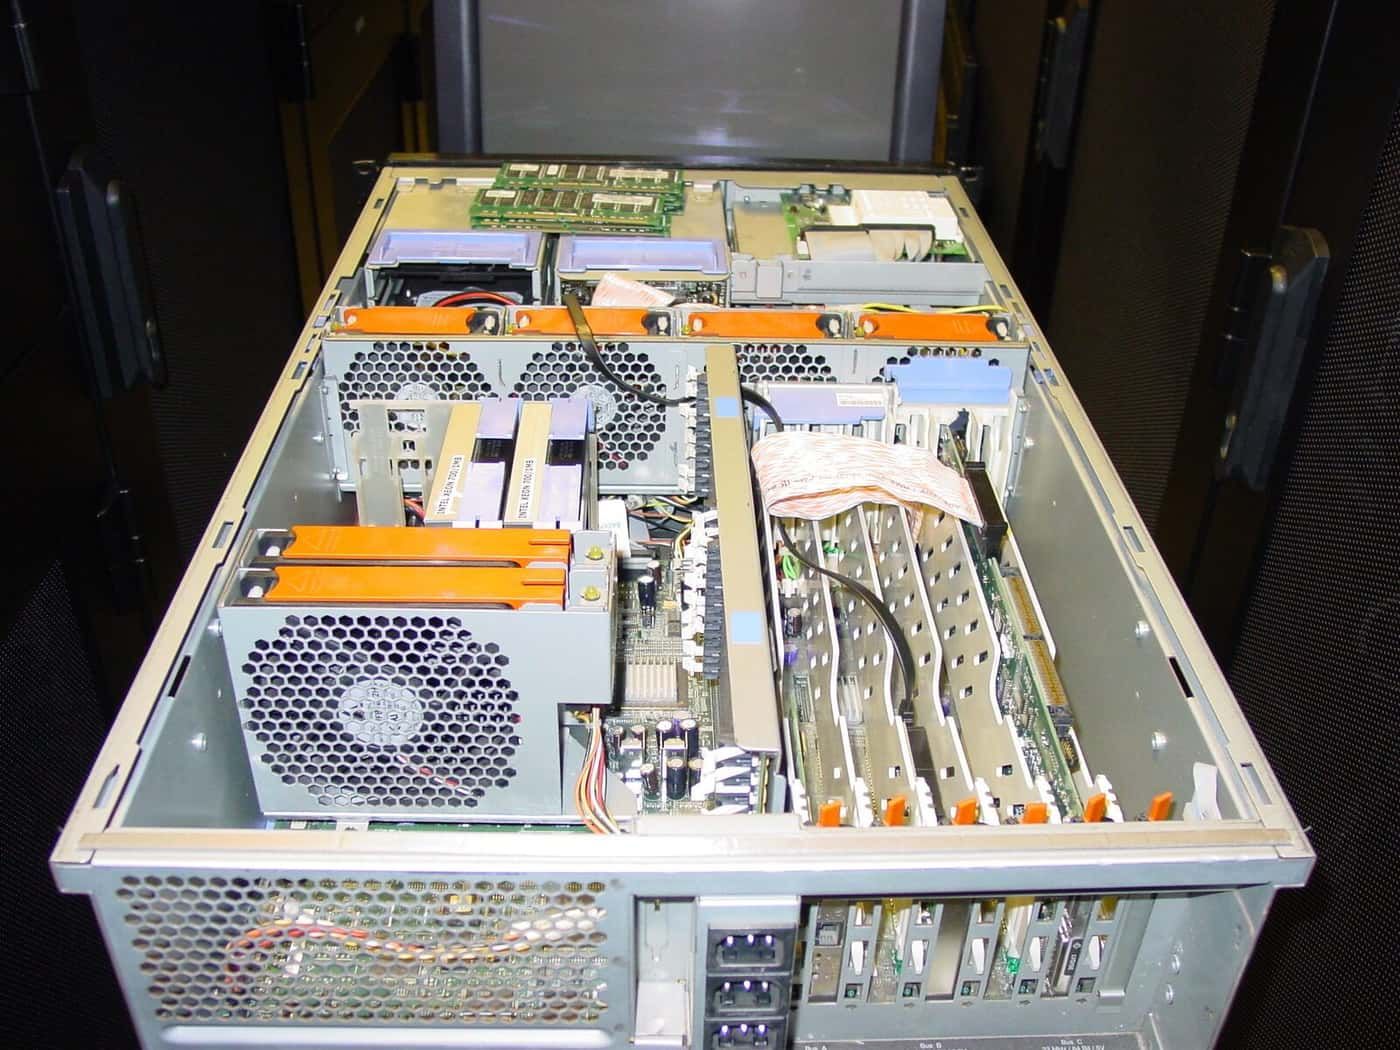
Era un IBM xSeries 350: un server a quattro socket, di classe enterprise, comprato in contanti e portato a mano in una sala di colocation ad Amsterdam. La macchina più economica che avrebbe fatto il lavoro costava una frazione di quanto abbiamo pagato. Abbiamo comprato l'xSeries lo stesso, e il motivo è l'unica politica aziendale che abbiamo mai avuto: si parte dalla macchina migliore che ci si può permettere, non dalla più economica che funziona.
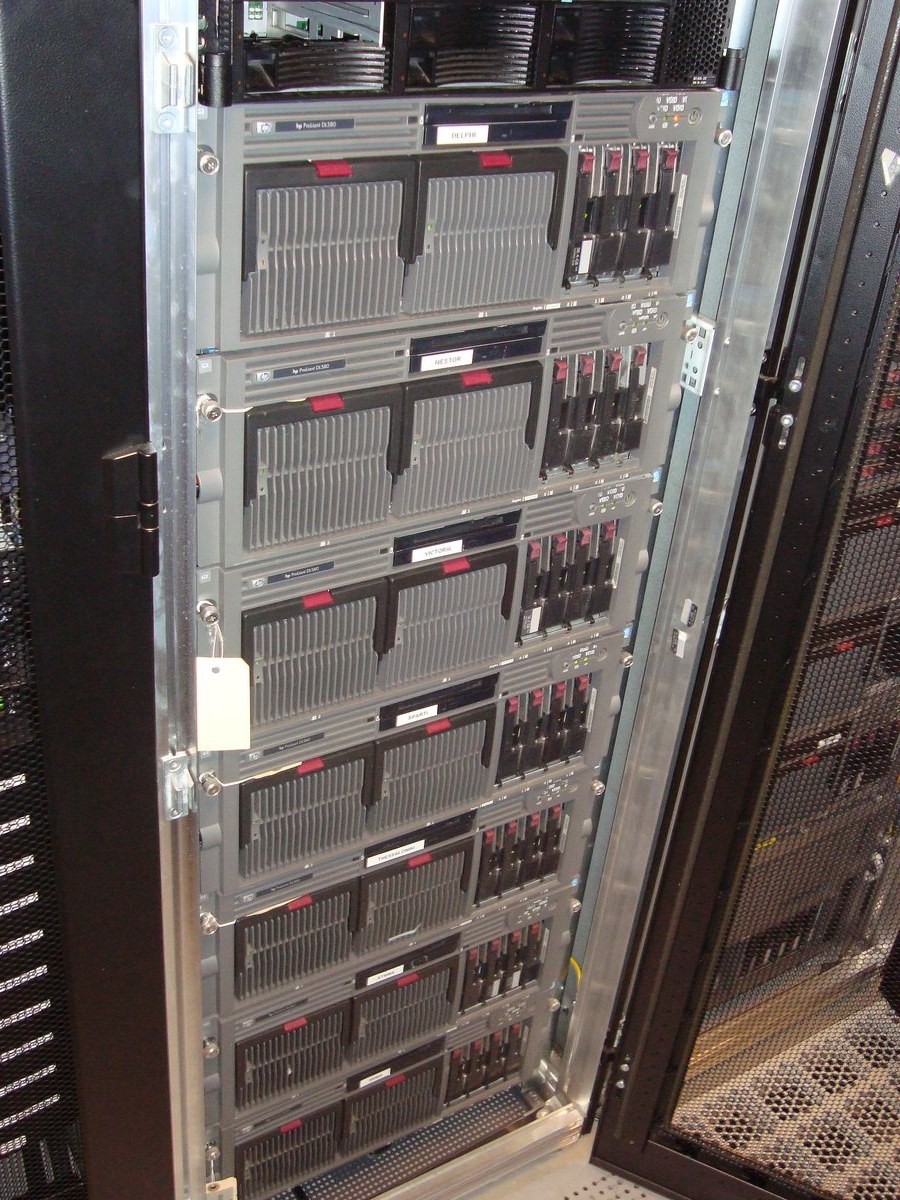
Ci girava Plesk. Le etichette che abbiamo stampato per il frontale di quel primo stack sono ancora leggibili nelle fotografie: l'hostname su ogni macchina, la disposizione del RAID sugli alloggiamenti dei dischi, e uno chassis marcato BACK UP. Un server, già etichettato alloggiamento per alloggiamento, con una macchina separata che già faceva i backup. Niente del modo in cui lavoriamo oggi è un'invenzione successiva. Sono le stesse abitudini, con più hardware.
Gli anni di Amsterdam
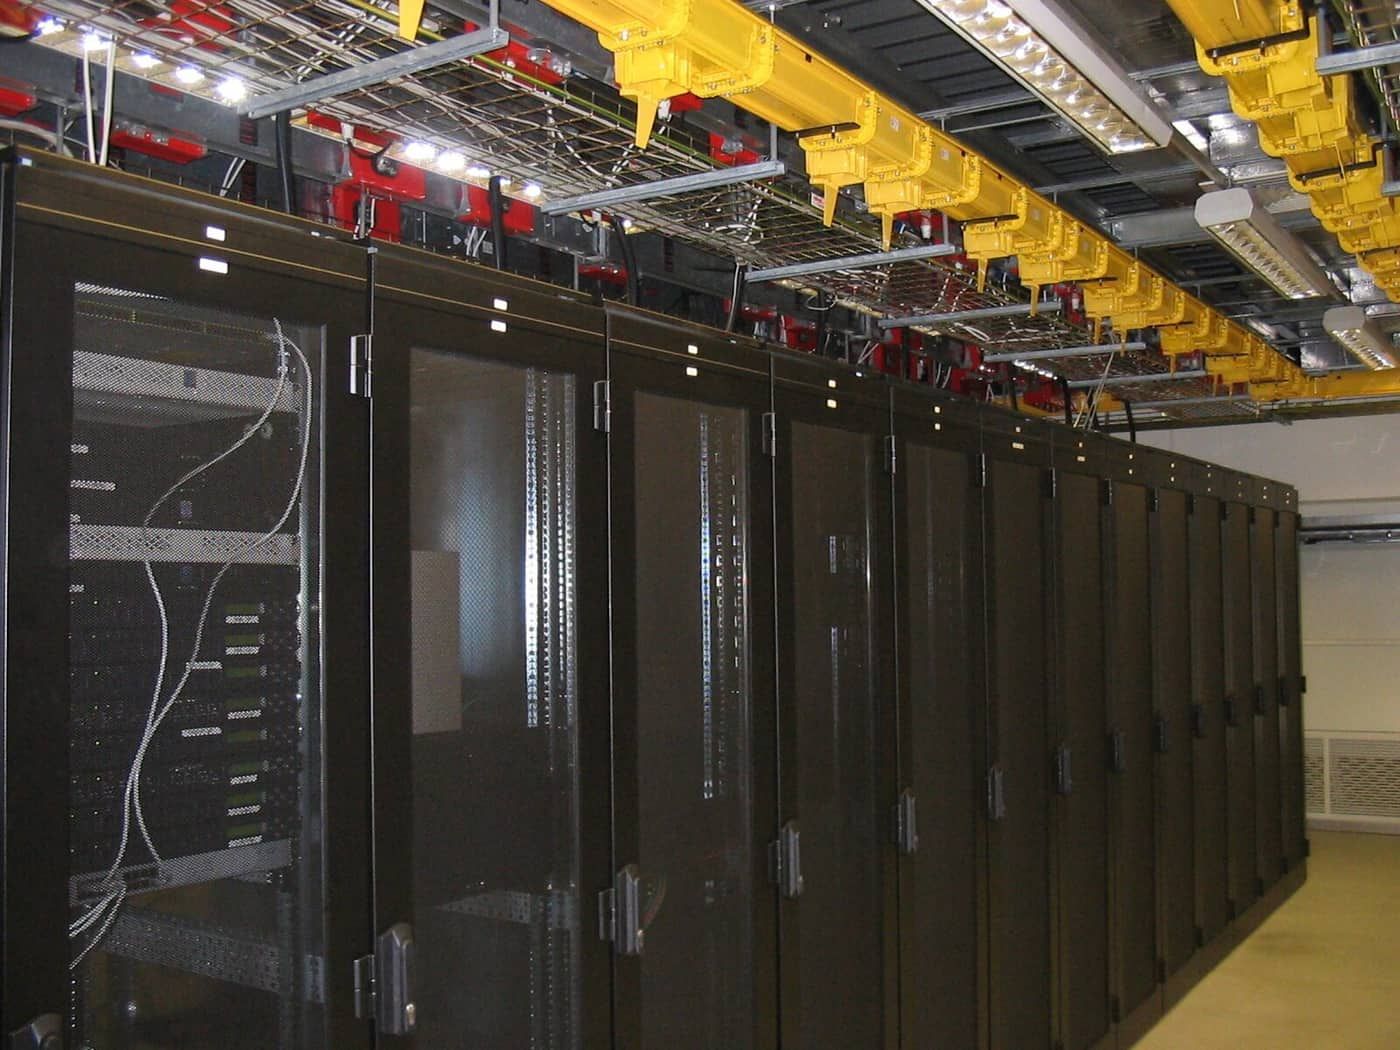
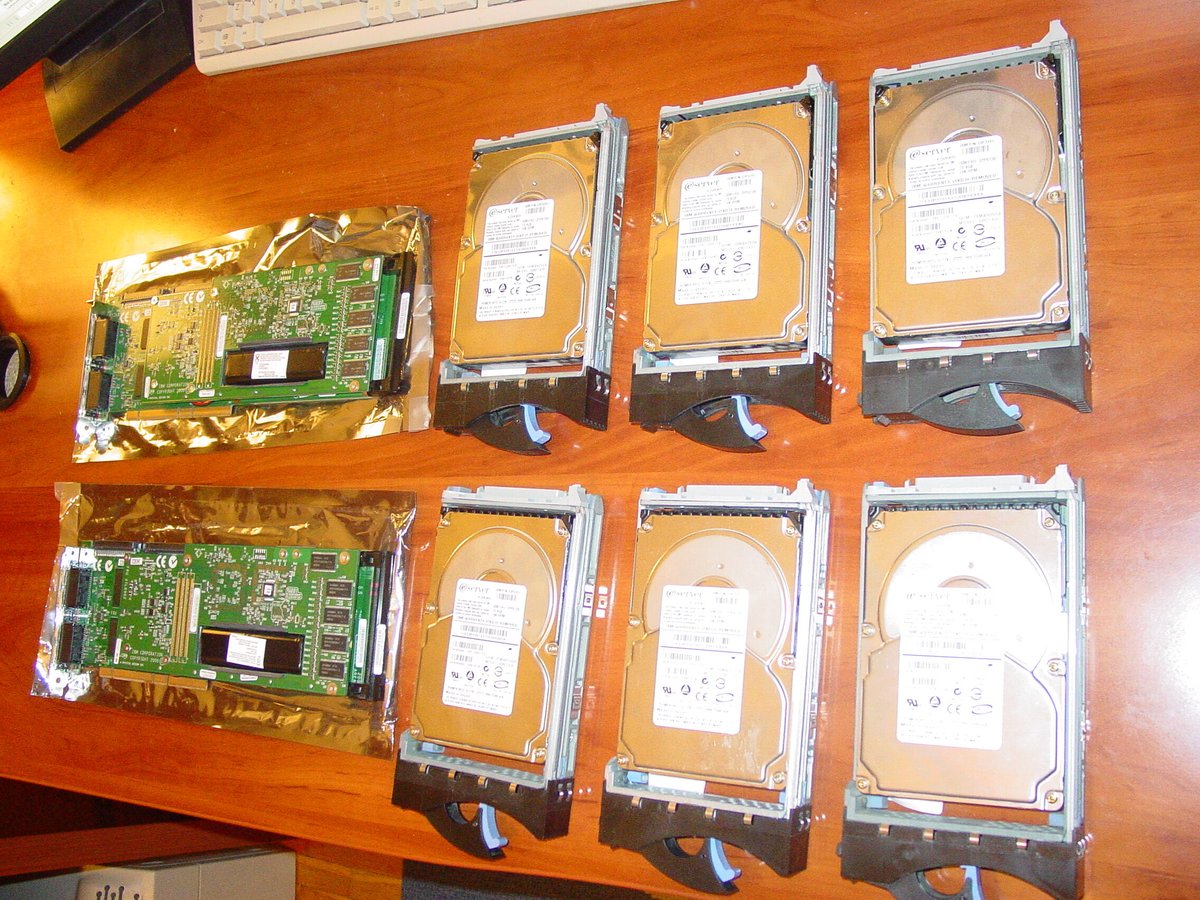
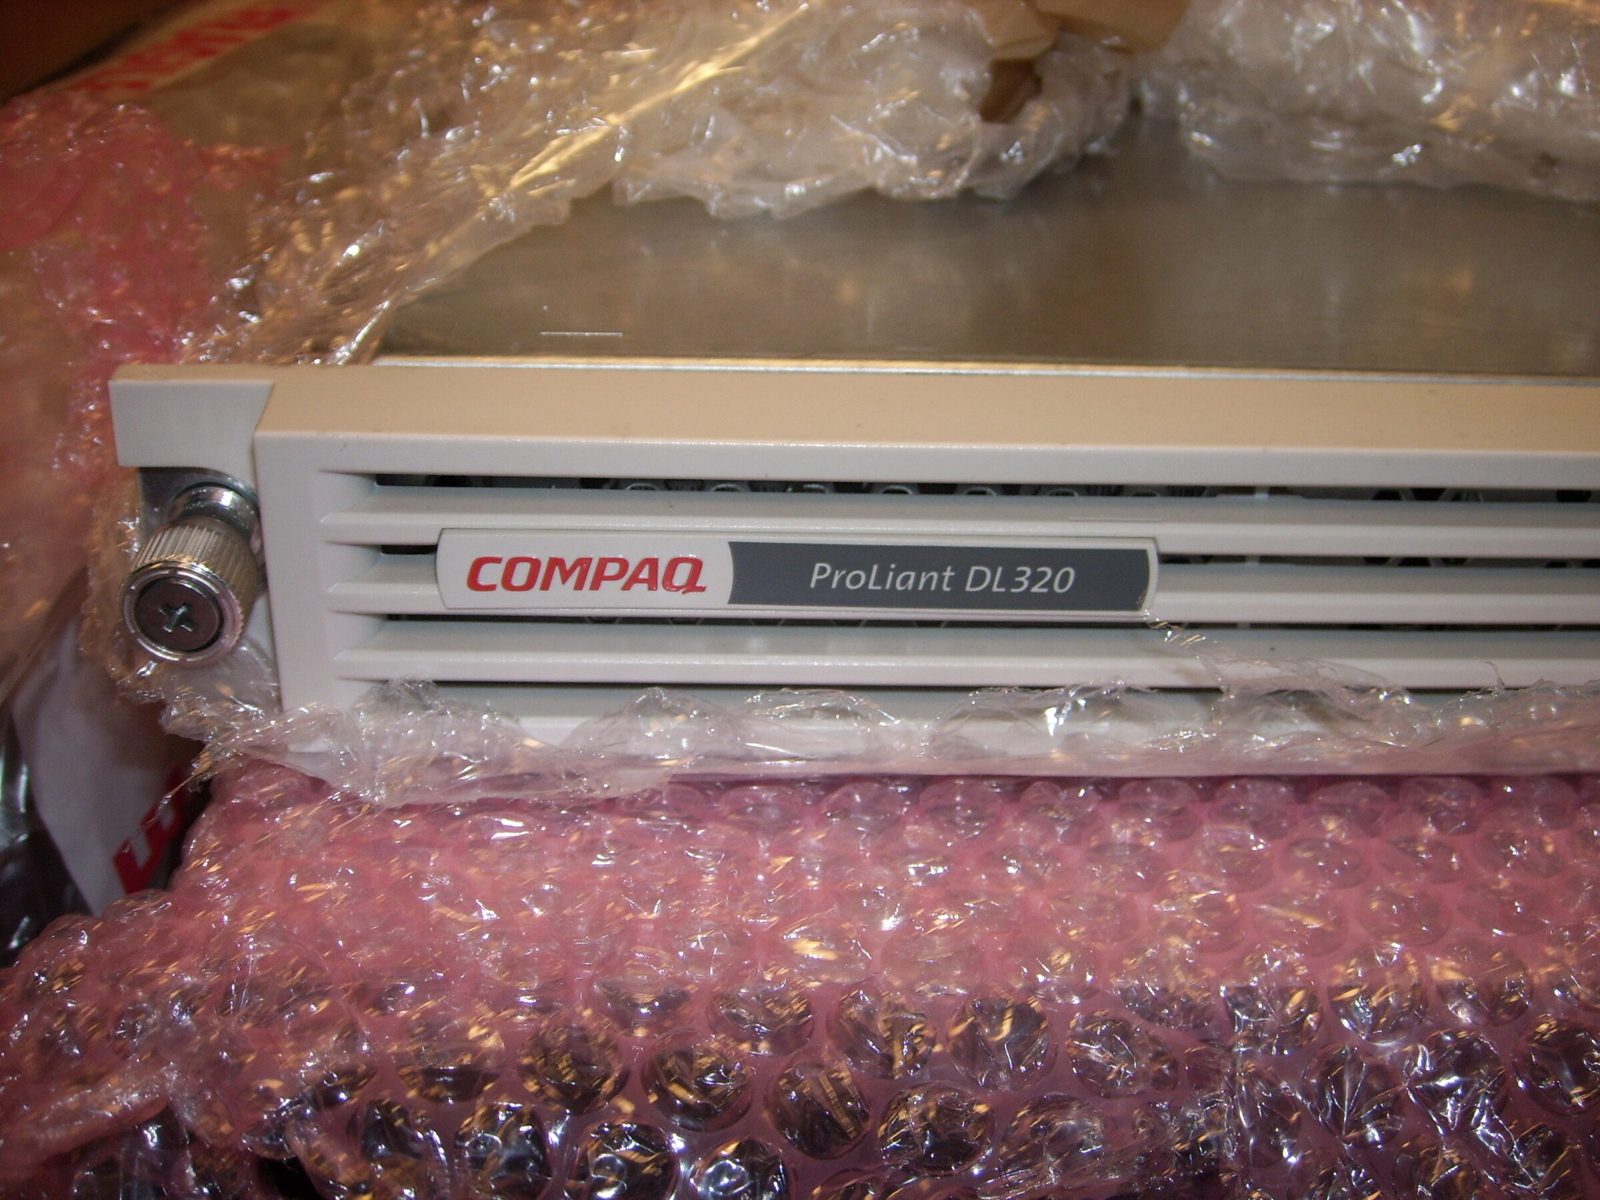
I primi anni erano un corridoio, un crash cart e un laptop sul pavimento. Prima IBM xSeries, poi Compaq e HP ProLiant fianco a fianco per quasi tutto il decennio, comprati nuovi e spacchettati tra gli armadi. Lo storage è passato presto su array enterprise, EMC CLARiiON su doppi fabric Fibre Channel, con Cisco al core, perché preferiamo pagare la seconda strada piuttosto che spiegare un giorno perché non c'era. Sono seguiti gli chassis blade, poi intere colonne, e l'installazione è cresciuta fino ai nostri cage a Iron Mountain.

Atene, Amsterdam, Toronto
L'ammiraglia oggi è il nostro cage al Digital Realty Athens: router nostri, storage all-flash, fibra su ogni porta, costruito come fu costruito il primo rack, da noi. Amsterdam continua, unita ad Atene su Layer 2 privato, così le due sedi si comportano come una sola rete e potete spostarvi tra l'una e l'altra senza cambiare un solo indirizzo. Toronto copre il Nord America da Cogent. La nostra sede centrale è a Cipro.

Un solo sistema operativo, per tutta la strada
Il nostro primo server girava su Red Hat Enterprise Linux, e ci siamo rimasti attraverso ogni major release da allora. Non perché fosse di moda: un sistema operativo con un ciclo di vita pubblicato, pacchetti firmati, SELinux in enforcing e un vendor che sta dietro ogni aggiornamento è la decisione che non dobbiamo mai riconsiderare.
Due decenni su una sola piattaforma sono di per sé un investimento. Ogni build, ogni regola di hardening e ogni runbook di aggiornamento che possediamo è stato scritto una volta e migliorato da allora, invece di essere buttato via con ogni nuova distribuzione del mese.
Abbiamo anche restituito. Dal 2005 abbiamo gestito un mirror pubblico per il progetto CentOS, gratuitamente, dalla nostra rete, perché chiunque al mondo potesse installare e aggiornare CentOS con la banda di EuroVPS.
Sì, sponsorizziamo un desktop. Attualmente doniamo tre server HPE ProLiant al progetto KDE. I nostri ingegneri usano KDE Plasma su Red Hat Enterprise Linux da più tempo di quanto alcuni dei nostri clienti esistano. Quando le persone che scelgono l'hardware tengono così tanto a uno strumento, lo strumento riceve dei server.
Qualità prima del profitto
Veniamo da un'epoca precedente a quella in cui massimizzare il margine è diventato il mantra.
EuroVPS non ha venture capital, non ha investitori esterni e non ha un piano di uscita. Nessuno ci ha mai detto di togliere un costo da una piattaforma per far sembrare migliore un trimestre, perché non c'è nessun trimestre da far sembrare migliore e nessuno a cui farlo sembrare. L'azienda è guidata dalle persone che l'hanno costruita, server dopo server, con le proprie mani.
Non è sentimentalismo, è un processo decisionale. Ogni scelta tecnica qui si decide sul merito ingegneristico e su quanto ci costerà essere svegliati di notte, non su cosa fa a un margine. Quando un'azienda di hosting prende soldi da fuori, prima o poi deve restituire qualcosa, e quello che viene restituito è quasi sempre la parte che non vedete: la seconda linea di alimentazione, l'ottica originale, il ricambio sullo scaffale, l'ingegnere senior alle tre di notte. Noi li abbiamo tenuti tutti e quattro, perché le persone che decidono qui sono le persone che ricevono l'allarme.
Cosa rifiutiamo di comprare
Siamo un'azienda di hosting, quindi l'hardware non è una voce di costo che cerchiamo di ridurre. È il prodotto. Quasi tutto ciò che rende economico l'hosting economico si riduce a una breve lista di componenti, e nessuno di questi finisce sotto un carico di lavoro di un nostro cliente.
Dischi SATA
Una porta, una strada, un controller: un singolo punto di guasto per costruzione, e nessun livello software sopra può inventarsi una seconda via. SATA ha code poco profonde e si riprende male dagli errori, così un disco di classe desktop può restare a ritentare un settore debole mentre tutto ciò che sta sopra aspetta. Il SAS enterprise ha due porte, riporta onestamente i suoi contatori di errore e restituisce il controllo abbastanza in fretta perché il livello RAID faccia il suo lavoro.
SSD SATA
Stessa porta singola, stessa coda poco profonda, su un'interfaccia costruita per dischi rotanti. Mettere il flash dietro SATA significa pagare il supporto e poi buttare via la maggior parte di ciò che offre. Quel mercato è anche in larghissima parte consumer: bassa resistenza, nessuna seconda porta, spesso nessuna protezione dalla perdita di alimentazione.
Stick NVMe M.2 consumer
Gli stick consumer di solito non hanno condensatori di protezione dalla perdita di alimentazione, quindi una scrittura in corso quando manca la corrente è una scrittura che potreste non rivedere mai, e la loro resistenza è specificata per un desktop, non per un database che scrive tutto il giorno. Di NVMe ne usiamo in abbondanza, come dischi enterprise U.2 e U.3 con protezione dalla perdita di alimentazione in carrier hot plug. Mai come stick incollato a una scheda che tiene l'unica copia.
Schede desktop a socket singolo
Un socket, un alimentatore, nessuna gestione out-of-band degna del nome, e troppo poche linee PCIe per portare insieme un HBA Fibre Channel a due porte e una rete ridondata. Non c'è nemmeno un backplane hot plug, quindi ogni guasto di un componente è uno spegnimento. Il progetto dice una cosa sola: se questo si rompe, il servizio resta rotto finché qualcuno non ci va in macchina.
Un singolo alimentatore
Un solo alimentatore trasforma il lavoro programmato del datacenter in un'interruzione per il cliente.
Memoria senza ECC
Non faremo girare un carico di lavoro su una memoria che non sa dirci che sta fallendo.
Software RAID come storia di resilienza, e server white box
Non appoggiamo i dati dei clienti sul software RAID di una singola macchina, con una write cache non protetta e la parità ricostruita sulla CPU dell'host. La resilienza appartiene all'array e ai fabric ridondati, dove sopravvive anche alla perdita dell'intero server. Il white box riceve la stessa risposta: nessun ciclo di vita del firmware, nessun ricambio sullo scaffale, nessuno da chiamare.
In pratica. Non diamo nulla per scontato da un nome di dispositivo o da un default del kernel: interroghiamo direttamente il controller RAID e i dischi, per due strade indipendenti, e ottimizziamo in base a ciò che ogni dispositivo riporta davvero.
Cosa compriamo invece
HPE ProLiant e Dell PowerEdge: ProLiant DL380 Gen10 e Gen11, DL385 Gen11 e blade BL460c Gen10. PowerEdge R740, R750 e R7525, e C6400 per il compute denso. La stessa base su ognuno di essi.
- Due alimentatori hot plug su due linee indipendenti.
- Memoria ECC ovunque, con i contatori degli errori correggibili sotto osservazione.
- RAID hardware con write cache protetta da batteria o flash ovunque un server tenga dischi locali, così un evento di alimentazione non può costare una scrittura confermata.
- SSD SAS 12G enterprise e NVMe enterprise, collocati dove le misurazioni dicono che devono stare.
- Gestione out-of-band su ogni macchina, su una rete di gestione air-gapped instradata da un sistema autonomo proprio, completamente separato.
Host che fanno il boot dalla SAN e non tengono nulla
I nostri hypervisor fanno il boot da un volume sull'array, presentato su due fabric Fibre Channel fisicamente separati. Il server in sé non tiene dati dei clienti, quindi un blade guasto ci costa un blade: il sostituto fa il boot dallo stesso volume. È una sostituzione di parti, non un recupero dati.
Macchine che non attraversano mai un socket
Regola di casa, e non negoziabile: una macchina virtuale non riceve mai più vCPU dei core fisici di un socket, e mai più memoria di quella servita da un nodo NUMA. Se si estende su due socket, parte del traffico di memoria diventa remoto, a circa 1,7 volte la latenza locale, ancora prima del traffico di coerenza della cache sull'interconnessione tra i socket. La penalità si accumula invece di mediarsi, ed è per questo che una macchina dimensionata oltre il confine del socket spesso gira più lenta di quella più piccola che ha sostituito.
Il flash enterprise non è RAM
Le nostre macchine virtuali non ricevono swap. Lo swap su una VM spinge la pressione di memoria giù sull'array e consuma resistenza in scrittura del flash che esiste per servire dati reali. Se un'applicazione ha bisogno di più memoria, la risposta onesta è più memoria, o una correzione nell'applicazione. Vi diremo quale delle due.
Ottimizzati, non lasciati sui default
I volumi su flash ricevono lo scheduler, il read ahead e la profondità di coda giusti, non euristiche scritte per dischi rotanti. Piccoli guadagni permanenti, su ogni build.
Storage: HPE 3PAR, all-flash, due di tutto
I dati dei clienti vivono su HPE 3PAR, all-flash, in provisioning group SSD RAID 6. RAID 6 perché la ricostruzione di un grande disco flash è una finestra di tempo, e non la passeremo a un solo guasto dalla perdita di dati.

Due controller, due fabric, molte strade
Doppi controller per array. Ogni host si collega attraverso due fabric Brocade Fibre Channel fisicamente separati, una porta HBA in ciascuno, ed è registrato con la persona corretta perché multipathing e ALUA si comportino come il sistema operativo si aspetta. Un controller, un fabric, un'ottica o una porta HBA possono venir meno e il volume resta online.
Thin che dice la verità, volumi che si spostano mentre sono in uso
I volumi sono thin con zero detect automatico, così un disco guest interamente provisionato costa fisicamente quasi nulla finché non arrivano dati reali. Gli array sono in federation, quindi migriamo un volume attivo da un array all'altro mentre l'host continua a leggere e scrivere. Per i database in cluster andiamo oltre e collochiamo ogni membro su un array fisico diverso, così perdere un intero array costa una replica e il quorum regge.
Igiene dei dischi, e disciplina sulle scritture
Un disco che riporta un errore corretto è un disco la cui correzione interna degli errori sta già lavorando, sotto traffico reale dei clienti. Non aspettiamo che si guasti: viene svuotato fino a zero, dismesso, sostituito con un disco pulito, e l'array ammette automaticamente quello nuovo.
I backup prelevano, e il ripristino segue il servizio
I backup sono solo in pull. I sistemi protetti non hanno alcuna rotta verso l'infrastruttura di backup né credenziali per essa, quindi una compromissione sul lato produzione non può raggiungere i backup. Il lato sicuro va a prendere ciò che gli serve, mai il contrario. Gli obiettivi di ripristino sono fissati per servizio, non come un numero unico di casa: un sito statico e un database transazionale non meritano la stessa risposta.
Un provider può sostituire più tardi storage, server e software. Ciò che non si può correggere dopo sono il cablaggio, le ottiche e i router su cui è stato costruito, quindi quelli li abbiamo fatti bene per primi.
Fibra da un capo all'altro
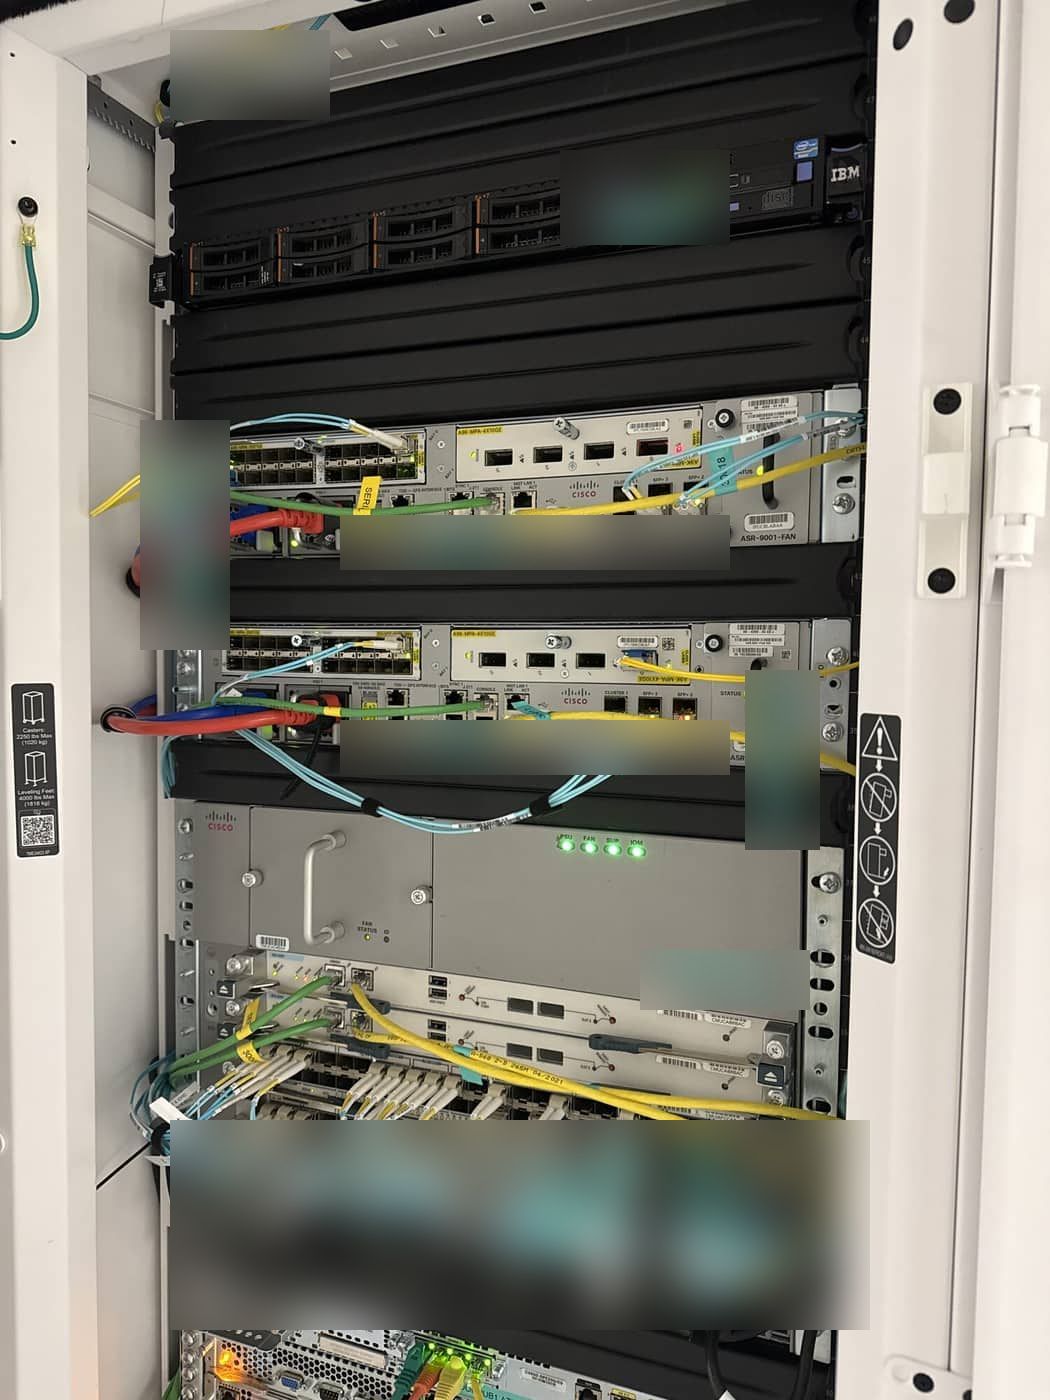
Non c'è cablaggio dati in rame nel nostro cage di Atene. Ogni server, ogni chassis blade, ogni array di storage, ogni switch e ogni router è collegato in fibra ottica. L'unico rame rimasto in un armadio è il breve tratto verso la porta di gestione lights-out di un server, ed è voluto: è l'unica interfaccia il cui compito è funzionare quando tutto il resto è spento.
Il vetro vince su ogni asse che conta in un armadio. Un collegamento ottico non si cura del rumore elettrico né del cavo di alimentazione che gli passa accanto, così un link è giusto o assente, mai misteriosamente marginale, e una tratta attraversa il rack, la fila e la sala con la stessa specifica. Il rame ad alta velocità è spesso, pesante e restio a piegarsi, e quella massa finisce appesa allo switch che serve, davanti alla sua espulsione dell'aria; la fibra è sottile e leggera, così gli armadi restano puliti. E quando arriva la generazione successiva di velocità, l'impianto resta dov'è: cambiamo il transceiver a ciascuna estremità e teniamo il cavo.
In pratica. Prima del lancio di nuove piattaforme per i clienti abbiamo costruito l'intera topologia in fibra e di port-channel di un rack di blade prima ancora che la maggior parte dei blade esistesse. Il giorno del lancio è stata un'accensione, non un lavoro di cablaggio.

Solo ottiche originali
Ogni SFP, SFP+ e QSFP nei nostri rack è il componente originale del produttore, abbinato allo switch o al router in cui si trova e supportato dal vendor il cui nome è sullo chassis. Non abbiamo mai comprato un transceiver generico e non inizieremo adesso.
Il risparmio è piccolo e compra quattro problemi: letture ottiche che possono non significare nulla, privandovi della migliore diagnostica su una rete ottica, il livello di luce in tempo reale a ciascuna estremità; un modulo che funziona su una release software e si comporta male sulla successiva, perché nessuno ha testato quella combinazione; un motivo legittimo per un vendor di chiudere il caso di supporto che aprite la notte in cui ne avete più bisogno; e un link che oscilla sotto carico per ragioni che nessuno riesce a riprodurre. Quindi compriamo il componente giusto, e compriamo ricambi: vassoi di ottiche sullo scaffale dentro il datacenter, così una sostituzione è una passeggiata lungo il corridoio invece di un ordine d'acquisto.
In pratica. I nostri controlli di salute di routine leggono i contatori di errore delle interfacce e delle ottiche su tutto il fabric, e poiché ogni modulo è originale del vendor, ciò che riportano è utilizzabile: un transceiver che va fuori specifica è una sostituzione pianificata dal vassoio, con i nostri tempi.


Il fabric: leaf e spine, EVPN e VXLAN
Dentro il datacenter tutto è appeso a un fabric leaf e spine Cisco Nexus 9000 che fa girare BGP EVPN con VXLAN. Gli spine sono puri route reflector, senza endpoint di tunnel per scelta progettuale. I leaf sono costruiti come coppie in virtual port-channel, così ogni host è dual-homed verso due switch attraverso un solo bond logico, e il gateway della subnet di un cliente è lo stesso indirizzo anycast su ogni leaf. Il traffico broadcast è replicato da BGP anziché da un albero multicast, e BFD gira dove il rilevamento rapido conta. Poiché qualsiasi VLAN può vivere su qualsiasi leaf, possiamo estendere il Layer 2 di un cliente tra i nostri datacenter e lasciare che i suoi server mantengano i loro indirizzi mentre si spostano.
L'identificatore di rete di ogni segmento Layer 2 deriva dalla sua VLAN locale per una regola fissa, e quella regola non è una convenzione in un documento. Un controllo automatizzato legge la mappa da ogni leaf, conferma che i leaf siano identici e rispettino la regola, e confronta un'impronta crittografica dell'intera mappa con una baseline firmata sotto controllo di versione. Gira prima che qualsiasi modifica venga salvata e a intervalli dopo, una deriva avvisa un ingegnere, e una modifica voluta deve essere rifirmata, così ogni cambiamento al fabric porta un autore e una traccia di audit.
In pratica. In un test di guasto controllato abbiamo riavviato un nodo del cluster mentre era il percorso preferito per un indirizzo pubblico attivo. Il fabric è converso su un nodo sano in circa tre secondi, e l'indirizzo non ha mai lasciato la tabella di routing.

L'edge: i nostri sistemi autonomi
Gestiamo noi il nostro edge internet, sui nostri sistemi autonomi registrati presso RIPE e sul nostro spazio IPv4 e IPv6, con la produzione dei clienti e i servizi di piattaforma su sistemi autonomi separati, così un problema su uno non può raggiungere l'altro. I router sono carrier-class: Cisco serie ASR 9000 ad Atene, un ASR 9006 in testa all'edge di produzione, e Juniper MX204 ad Amsterdam, ciascuno con la tabella di routing internet completa e scambiata con il suo gemello.
Compriamo transit da più carrier invece di affittare una porta da chi possiede l'edificio: OTE Globe, Cogent e Hurricane Electric ad Atene, Arelion, NTT, Deutsche Telekom e Telecom Italia sul lato di Amsterdam, con le due sedi unite su Layer 2 privato perché l'intera installazione si comporti come una sola rete. Facciamo peering diretto a GR-IX e NetIX, e aggiungiamo sessioni bilaterali una alla volta con le reti con cui i nostri clienti parlano davvero.
IPv6 è nativo ovunque: dual-stack dai router edge al vostro gateway, senza tunnel e senza traduzione nel percorso.
In pratica. Il nostro fabric di Atene è passato in dual-stack in una sola giornata lavorativa, dall'edge internet attraverso il fabric fino a una VLAN condivisa attiva dei clienti.

Fibre Channel: due fabric, mai una sola strada
La rete tra server e storage è Fibre Channel, non Ethernet, costruita come due fabric Brocade completamente indipendenti. Ogni server e ogni array sono collegati a entrambi, ciascun fabric con il proprio switching di core e il proprio switch dentro ogni enclosure blade, così nessun singolo switch, cavo, porta o guasto software esiste su entrambi i lati del percorso di un host.
In pratica. Poiché ogni host ha già percorsi attivi verso ogni array della sua federation su entrambi i fabric, possiamo svuotare un intero array di storage, per manutenzione o per un trasloco, senza riavviare una macchina di un cliente e senza una finestra di manutenzione.
La dorsale cifrata tra le nostre sedi
I nostri datacenter ad Atene, Amsterdam e Toronto, la nostra sede centrale a Cipro e i nostri punti di presenza regionali sono uniti da un overlay Cisco DMVPN: tunnel GRE multipoint protetti da IPsec con AES-256, NHRP autenticato, BFD, e BGP sopra i tunnel. Ogni datacenter ha hub ridondati, e poiché l'overlay è instradato da BGP anziché da tabelle statiche, perdere un hub o un circuito è un ritiro di rotta che converge da solo.
Una sede con due circuiti WAN fa girare una seconda cloud DMVPN sullo stesso router, così il secondo circuito non ha bisogno di un nuovo indirizzo pubblico né di modifiche sugli hub, e il multipath BGP distribuisce il traffico su entrambi con un hash di forwarding che include le porte, così i flussi paralleli si dividono davvero. Dimensioniamo in base a ciò che il motore di cifratura sa fare realmente, circa 11 Gbit/s per hub, non in base al numero stampato su una licenza, e scaliamo con equal-cost multipath tra gli hub fino a 30 o 40 Gbit/s quando un cliente ne ha bisogno.
In pratica. Su una sede a doppio circuito, un test di throughput ha misurato in ciascuna direzione più di quanto ognuno dei due circuiti potesse trasportare da solo. È l'unica prova accettabile che l'equal-cost multipath stia funzionando e non sia soltanto configurato.
La disciplina che lo accompagna
Bond che usano entrambi i link. Il default del bonding Linux fa l'hash sugli indirizzi MAC, che in un datacenter ammucchia i flussi su un membro del bond e lascia l'altro inattivo. Ogni server in bond che costruiamo fa l'hash a livello 3 e livello 4, con il lato switch impostato di conseguenza. Controlliamo i contatori per porta su ogni build per dimostrare che entrambi i link trasportano traffico.
Ogni porta registrata. Non un nome su una riga: la porta con il suo vero indirizzo MAC, il link alla porta dello switch remoto con il suo ID del cavo, la posizione nel rack, gli indirizzi e l'interfaccia di gestione. Il dispositivo reale è la fonte di verità e i registri sono fatti per corrispondergli.
Un record inverso per ogni indirizzo. Ogni indirizzo che assegniamo a un'interfaccia, a un loopback, a un servizio o a un host riceve un PTR nel nostro DNS autoritativo, nella stessa sessione. Un traceroute attraverso la nostra rete si legge come una frase che nomina il dispositivo, il suo ruolo e la sua sede.
Il piano di gestione, e l'air gap
Il traffico dei clienti e il traffico di gestione non condividono nulla: non una porta, non uno switch, non un indirizzo, non una rotta.
C'è esattamente un cavo in rame rimasto nei nostri armadi: la porta di gestione del controller lights-out di ogni server. È anche il cavo isolato con più cura in tutto l'edificio.
Gestione out-of-band su ogni macchina
Ogni server che gestiamo è un vero server enterprise con un vero controller lights-out: iDRAC Enterprise con licenza Datacenter su Dell, iLO Advanced su HPE, entrambi pilotati via Redfish, e ogni chassis blade attraverso il suo Onboard Administrator. Non una scheda madre white box la cui idea di gestione remota è un pulsante di accensione e nessuna console.
Sugli chassis blade l'Onboard Administrator raggiunge ogni controller dell'enclosure attraverso il backplane, ed è esso stesso una coppia ridondata con failover automatico.
In pratica. Quando un rack di chassis blade ha avuto bisogno della licenza iLO Advanced, e di un account di gestione creato su ogni blade, non abbiamo fatto login su un singolo blade. L'abbiamo spinto attraverso l'Onboard Administrator di ciascuno chassis e il rack era finito in pochi minuti, compresi i blade montati quella settimana che non avevano ancora credenziali proprie. È un runbook.
La rete di gestione non è la rete di produzione
Il controller ha la propria porta fisica e il proprio cavo verso il proprio switching. Non partizioniamo una scheda di rete di produzione lasciando che il controller ne prenda in prestito una fetta, che è la scorciatoia abituale e il motivo abituale per cui la gestione finisce a un errore dall'internet. La gestione vive sui propri switch, o su proprie VLAN su fabric che non trasportano nient'altro, in spazio di indirizzi privato che non è instradato da o verso alcuna rete di un cliente e non è mai annunciato a internet.
Lo chiamiamo air gap perché è così che si comporta. Una macchina virtuale di un cliente, anche completamente compromessa, che scansiona a velocità di linea per una settimana, non può vedere affatto un iLO o un iDRAC. Non rifiutato, non filtrato: assente. Non c'è nessun posto in cui i pacchetti possano andare. Vale anche nell'altra direzione, e conta altrettanto: nessun traffico di gestione viaggia su una VLAN di un cliente, così le nostre sessioni di console, il monitoraggio e i backup non entrano mai nel dominio di broadcast di un cliente né competono per la sua banda. L'isolamento è abbastanza reale da essere scomodo per noi, ed è questa la prova che è reale: un controller su una VLAN di gestione non può raggiungere con disinvoltura un web server interno per scaricare un'immagine firmware, perché nulla è permesso che non sia stato richiesto e messo per iscritto. L'ingegnere fa il passo in più.
I backup viaggiano allo stesso modo. Vengono presi sulla rete out-of-band, mai attraverso un segmento di produzione.
In pratica. Un'unica access list di gestione canonica è applicata su ogni piattaforma che gestiamo, sulle linee di login dei Cisco Nexus, per istanza di routing sui router, per interfaccia per SSH e HTTPS sui firewall, permettendo solo le subnet di gestione nominate, con il control plane policing che limita in hardware tutto ciò che resta.
Il piano di gestione in sé
Il piano di gestione è una rete a pieno titolo e l'abbiamo costruito come tale. Gira sulla nostra dorsale cifrata multi-sede: Cisco DMVPN, IPsec a AES-256, BGP trasportato sui tunnel, che unisce Atene, Amsterdam e Toronto alla nostra sede centrale a Cipro, che per scelta non si trova in nessuno degli edifici che gestisce. Gli hub sono ridondati, con percorsi equal-cost tra di essi e su circuiti diversi, e un rilevamento dei guasti che si accorge di un percorso morto in ben meno di un secondo.
Il personale lo raggiunge in un solo modo: attraverso gateway VPN e firewall che possediamo e gestiamo noi stessi, su OPNsense e Cisco Firepower, e poi attraverso jump host dentro il piano anziché direttamente dal laptop di un ingegnere. Livelli di fiducia diversi non condividono mai un oggetto del firewall, così allargare l'accesso di un gruppo non può allargare silenziosamente quello di un altro.
Verso i piani di backup e di disaster recovery la politica è deny by default e i dati scorrono in una sola direzione. La produzione non spinge mai verso il backup. È il lato backup a prelevare. Questo è imposto con regole di deny esplicite sulle appliance firewall, non con un firewall host che una macchina compromessa potrebbe modificare, e i segmenti di backup non hanno alcuna rotta verso internet. Solo l'intervallo di gestione li raggiunge. Se una macchina di produzione viene presa completamente, l'attaccante non ottiene alcuna conoscenza dell'infrastruttura di backup e nessun percorso verso di essa. Da dove si trova, non esiste.
Le modifiche alla dorsale sono verificate dal vivo sul sistema in esecuzione, una metà di una coppia ridondata alla volta, ed è per questo che possiamo lavorare sulla dorsale nel mezzo di una giornata lavorativa.
In pratica. Abbiamo spostato l'intero parco VPN site-to-site di un cliente da un paese a un altro in una sola sessione, prima di una scadenza fissa. L'hub è stato clonato, trasferito e acceso in parallelo con l'originale, così entrambi erano attivi nello stesso momento e c'era sempre un posto in cui i tunnel potessero stare. I router delle filiali sono stati spostati uno alla volta, ciascuno verificato attivo prima di toccare il successivo, ciascuno con un failover pulito lungo il percorso. Nessuno ha viaggiato verso una filiale.
La baseline di hardening su ogni host
Ogni macchina che costruiamo parte dalla stessa baseline, e la baseline non è negoziabile. SELinux è in enforcing, e non lo spegniamo per far collaborare un'applicazione, scriviamo invece la policy. I filesystem sono XFS.
Le patch non dipendono da nessun altro. Gestiamo il nostro mirror di pacchetti nel nostro datacenter, con i repository da cui installa la nostra flotta, firme upstream intatte, raggiungibile solo dai nostri intervalli di indirizzi. Un mirror pubblico che ha una brutta giornata non è un evento qui, e un server deliberatamente incapace di parlare con internet è ancora un server che possiamo aggiornare completamente.
In pratica. Quando è stata pubblicata una vulnerabilità critica in un runtime molto diffuso, i pacchetti corretti erano in produzione su ogni server interessato lo stesso giorno, prima della fine della stessa notte. Non a mano e non di fretta: il rollout fa un backup, aggiorna un host alla volta, campiona siti reali su quell'host per una risposta sana prima e dopo, e interrompe automaticamente l'intera operazione se uno non torna correttamente. Veloce e accurato non sono opposti se costruite la cosa che lo fa per voi.
I log delle macchine entrano, e nulla può tacere
Le severità serie vanno direttamente nella chat operativa dove l'ingegnere reperibile si trova già, raggiungendo una persona in pochi secondi, e sappiamo che sono secondi perché li abbiamo cronometrati con un allarme reale. All'edge, sensori dedicati leggono il traffico in mirror dai router di confine e osservano continuamente i pattern volumetrici e di denial of service.
Un dispositivo può sembrare perfettamente sano dalla sua riga di comando mentre in silenzio non manda nulla al collector, quindi «il logging è configurato» qui non è una prova. Confermiamo che il log arrivi, all'altro capo, nello stream a cui appartiene, dopo ogni modifica che avrebbe potuto disturbarlo. I sistemi di monitoraggio hanno i propri watchdog su macchine separate, così «la cosa che stava osservando ha smesso di osservare» è a sua volta un allarme. Il silenzio non è mai una buona notizia.
In pratica. Il nostro controllo di salute di routine verifica anche due cose che la maggior parte dei controlli salta: se ogni dispositivo sta ancora davvero spedendo i suoi log, e se la sua configurazione viene ancora davvero salvata. Quei due sono i guasti che nascondono gli altri.
Analisi in tempo reale sulle nostre NVIDIA A100
La maggior parte dei provider raccoglie i log in un contenitore e lo interroga dopo che qualcosa si è già rotto. Noi mettiamo lo stream al lavoro. Regole di base eliminano prima il rumore conosciuto, poi tutto ciò che resta, da router, switch, firewall, array di storage e server, viene analizzato all'arrivo da modelli AI che girano su un array di nostre GPU NVIDIA A100, dentro il nostro datacenter.
I modelli leggono attraverso i dispositivi, non una riga di log alla volta: un errore di percorso dello storage, un'interfaccia che oscilla e una temperatura in aumento sullo stesso rack diventano una sola storia invece di tre messaggi scollegati. Colgono i pattern che una regola statica non coglierà mai, la deriva lenta e la combinazione insolita che precede un guasto, e ogni allarme raggiunge l'ingegnere con un secondo parere già allegato. I dati delle macchine smettono di essere una pila di testo da scorrere con grep e diventano un preavviso.
Nulla di tutto questo lascia la nostra rete. I modelli, le GPU e i dati sono tutti nostri, e nessuna riga di log viene mai inviata a un servizio AI esterno.
Un CTO che ci valuta è il benvenuto a chiedere l'access list, il runbook e l'instradamento degli allarmi. Vi mostreremo tutti e tre.
Ricambi in sede
I ricambi, fino a interi chassis, stanno nello stesso cage delle macchine che ne avranno bisogno, non sul contratto di consegna di un vendor.
Un ricambio non si guadagna il posto su quello scaffale arrivando. I dischi vanno su un banco di prova, vengono formattati a basso livello nel formato di settore dell'array che serviranno, e vengono messi a scorta solo quando riportano zero difetti sopraggiunti e nessun errore non corretto di lettura, scrittura o verifica. Un ricambio che fallisce la notte in cui vi serve non è mai stato un ricambio.
Sostituire presto, aggiornare in tempo
Qui l'hardware va in pensione sulla base di evidenze, non di guasti.
Vulnerabilità critiche, lo stesso giorno. Quando viene divulgata una falla di massima gravità in qualcosa da cui dipendiamo, costruiamo pacchetti corretti lo stesso giorno in cui la correzione è pubblicata. La configurazione protettiva viene applicata immediatamente. Se non esiste ancora un pacchetto corretto per la piattaforma che usiamo, lo costruiamo noi, compilato in un container pulito dalla specifica del maintainer, verificato rispetto ai sorgenti pubblicati dal progetto, installato host per host con controlli prima e dopo. L'ultima volta che è servito, la correzione era in produzione circa tre ore dopo la pubblicazione dei sorgenti. Gestiamo il nostro mirror di pacchetti per la stessa ragione.
La documentazione come infrastruttura
Molte aziende hanno della documentazione. Noi la trattiamo come parte dell'impianto.
Ogni cavo porta un identificativo stampato univoco da un unico registro che non può emettere lo stesso numero due volte e non ne riutilizza mai uno, nemmeno dopo che il cavo è stato rimosso. L'etichetta nomina entrambe le estremità, rack, dispositivo e porta per ciascuna. Ventidue anni di cablaggio si possono ancora rintracciare dall'etichetta, al registro, alla porta dello switch, e ritorno.
Un servizio non è finito quando funziona. È finito quando il suo indirizzo, la sua regola firewall, il suo record di inventario e il suo DNS diretto e inverso esistono tutti e sono stati verificati dall'esterno della nostra rete.
I nostri strumenti rifiutano il comando quando la regola non è stata rispettata, che è una guardia migliore delle buone intenzioni.
È questo che conta alle tre di notte. La domanda allora non è mai quale sia la soluzione ingegnosa. È cosa è cambiato, e come lo rimettiamo a posto.
Certificati, e sottoposti ad audit
Tutti e quattro sono stati rilasciati a settembre 2026 da un organismo di certificazione accreditato a livello nazionale, con il campo di applicazione scritto come «Managed datacenter hosting service». È il servizio che comprate davvero, non un angolo dell'azienda scelto per rendere facile un audit.
I vostri dati restano dove li mettete, e nelle nostre sedi europee significa dentro l'UE, su hardware di nostra proprietà, senza alcun public cloud sotto. Firmiamo un accordo sul trattamento dei dati, e il nostro documento sulle misure tecniche e organizzative è disponibile su richiesta.
Ingegneri, non livelli
Niente bot, e nessuna prima risposta da copione.
Gli ingegneri che scelgono l'hardware, lo montano in rack, lo cablano e lo etichettano sono gli stessi ingegneri che rispondono al vostro ticket, e lo firmano con il proprio nome. Funziona perché le persone qui conoscono la vostra configurazione per nome e sono abbastanza senior da non avere bisogno di un copione.
Nell'intero storico dei nostri ticket la prima risposta mediana è di tre minuti, e l'87 percento dei ticket viene risolto entro l'ora. Una buona parte la apriamo noi anziché voi: il nostro monitoraggio osserva tutto ciò di cui siamo responsabili 24 ore su 24, fino alle vostre pagine reali, e gli allarmi arrivano in un canale che gli ingegneri leggono.
Sempre uguali
Stessi standard. Stessa ingegneria con le mani in pasta. Ancora nessun investitore, ancora nessun piano di uscita, e ancora la regola con cui abbiamo iniziato in una sala di colocation ad Amsterdam: comprare la macchina migliore.
Offriamo visite accompagnate al datacenter di Atene: il cage, la fibra, le ottiche nei loro vassoi, i ricambi sullo scaffale. Vi accompagneremo noi stessi, perché siamo noi ad averlo costruito. Portate un ingegnere.
Il vostro prossimo partner per l'infrastruttura
Volete vederlo?
Raccontateci cosa fate girare. Un ingegnere risponde, e la visita al datacenter la offriamo noi.
+357 222 32280
Partiamo dalla vostra infrastruttura.
Un po' di contesto ci aiuta a iniziare la conversazione giusta.