

Seit 2004: Keine Kompromisse
2004 war EuroVPS eine Maschine. Keine billige.
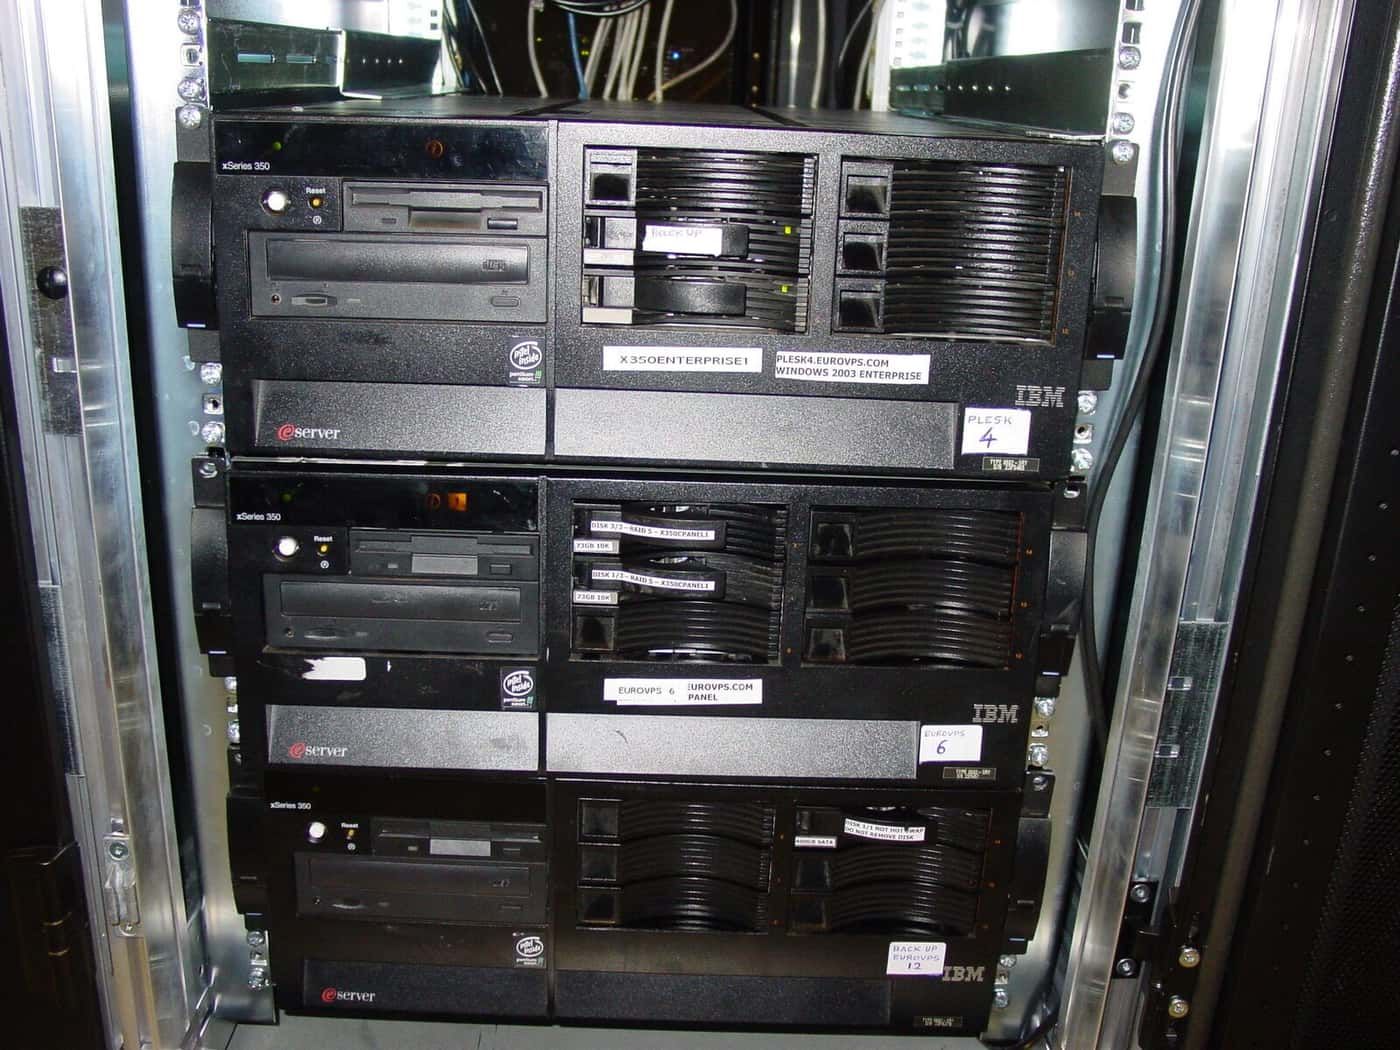
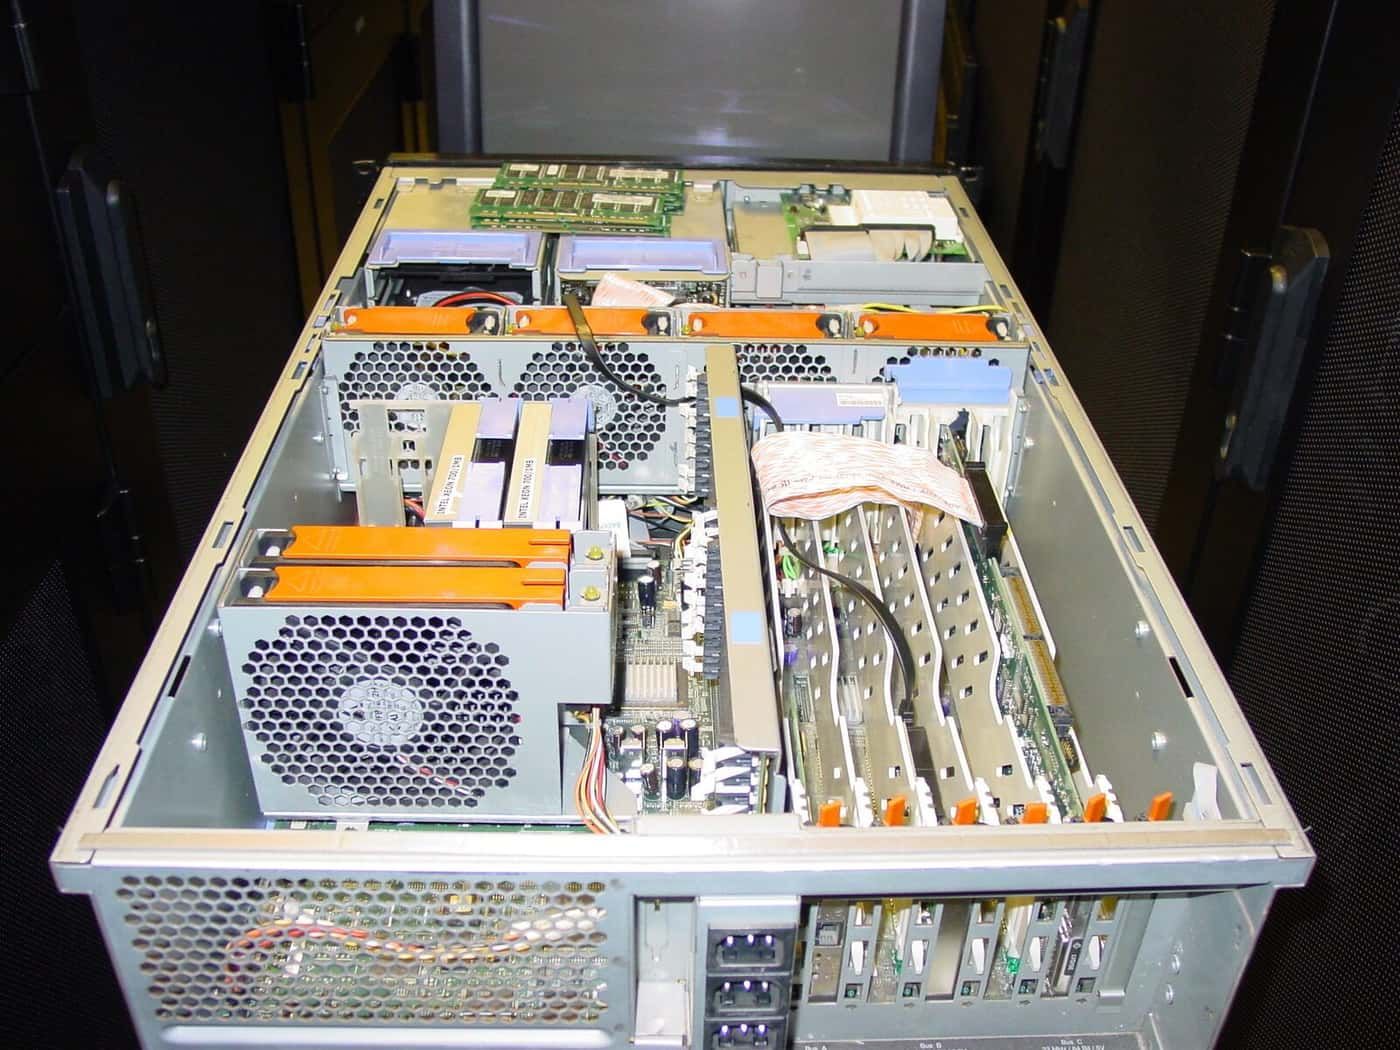
Es war ein IBM xSeries 350: ein Server mit vier Sockeln, Enterprise-Klasse, bar gekauft und von Hand in einen Colocation-Saal in Amsterdam getragen. Die billigste Maschine, die den Job gemacht hätte, kostete einen Bruchteil dessen, was wir bezahlt haben. Wir haben den xSeries trotzdem gekauft, und der Grund ist die einzige Unternehmensrichtlinie, die wir je hatten: Fang mit der besten Maschine an, die du dir leisten kannst, nicht mit der billigsten, die funktioniert.
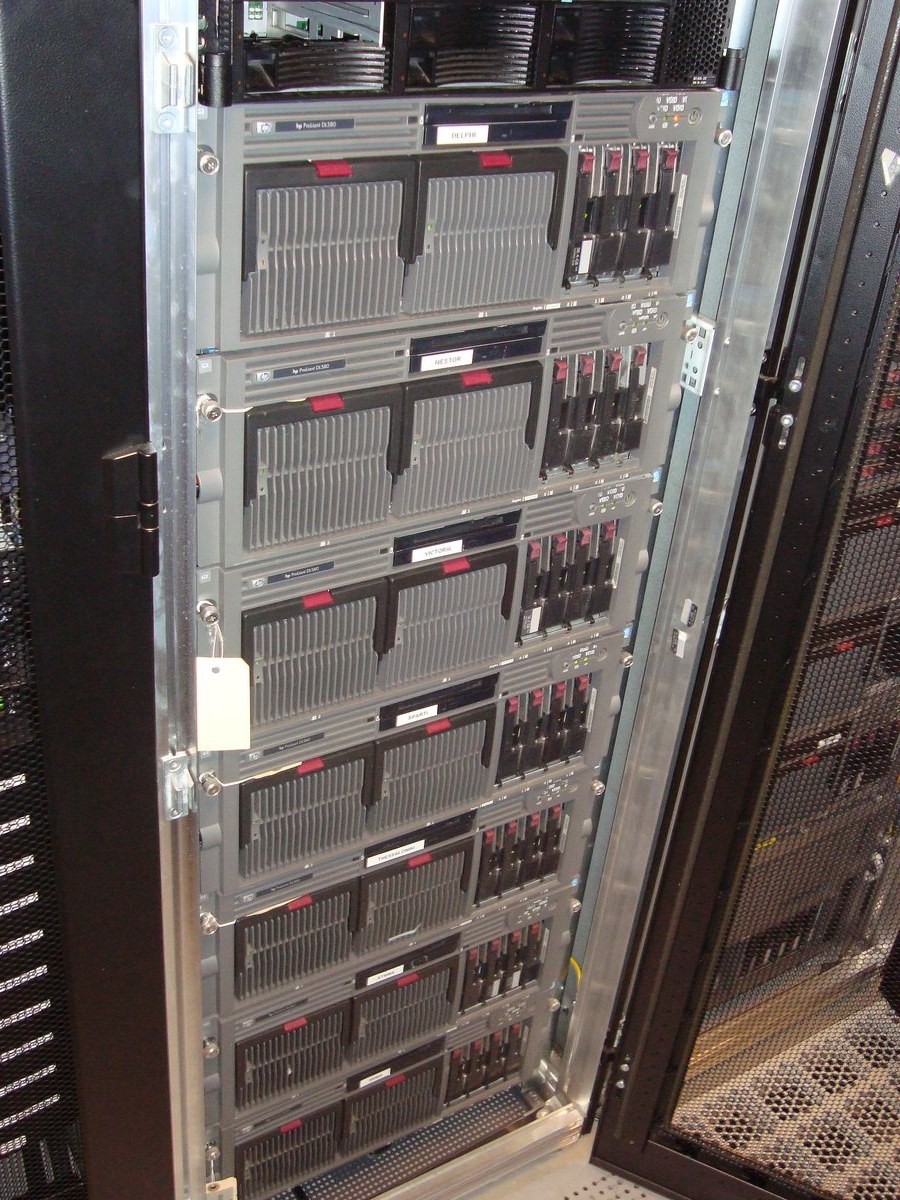
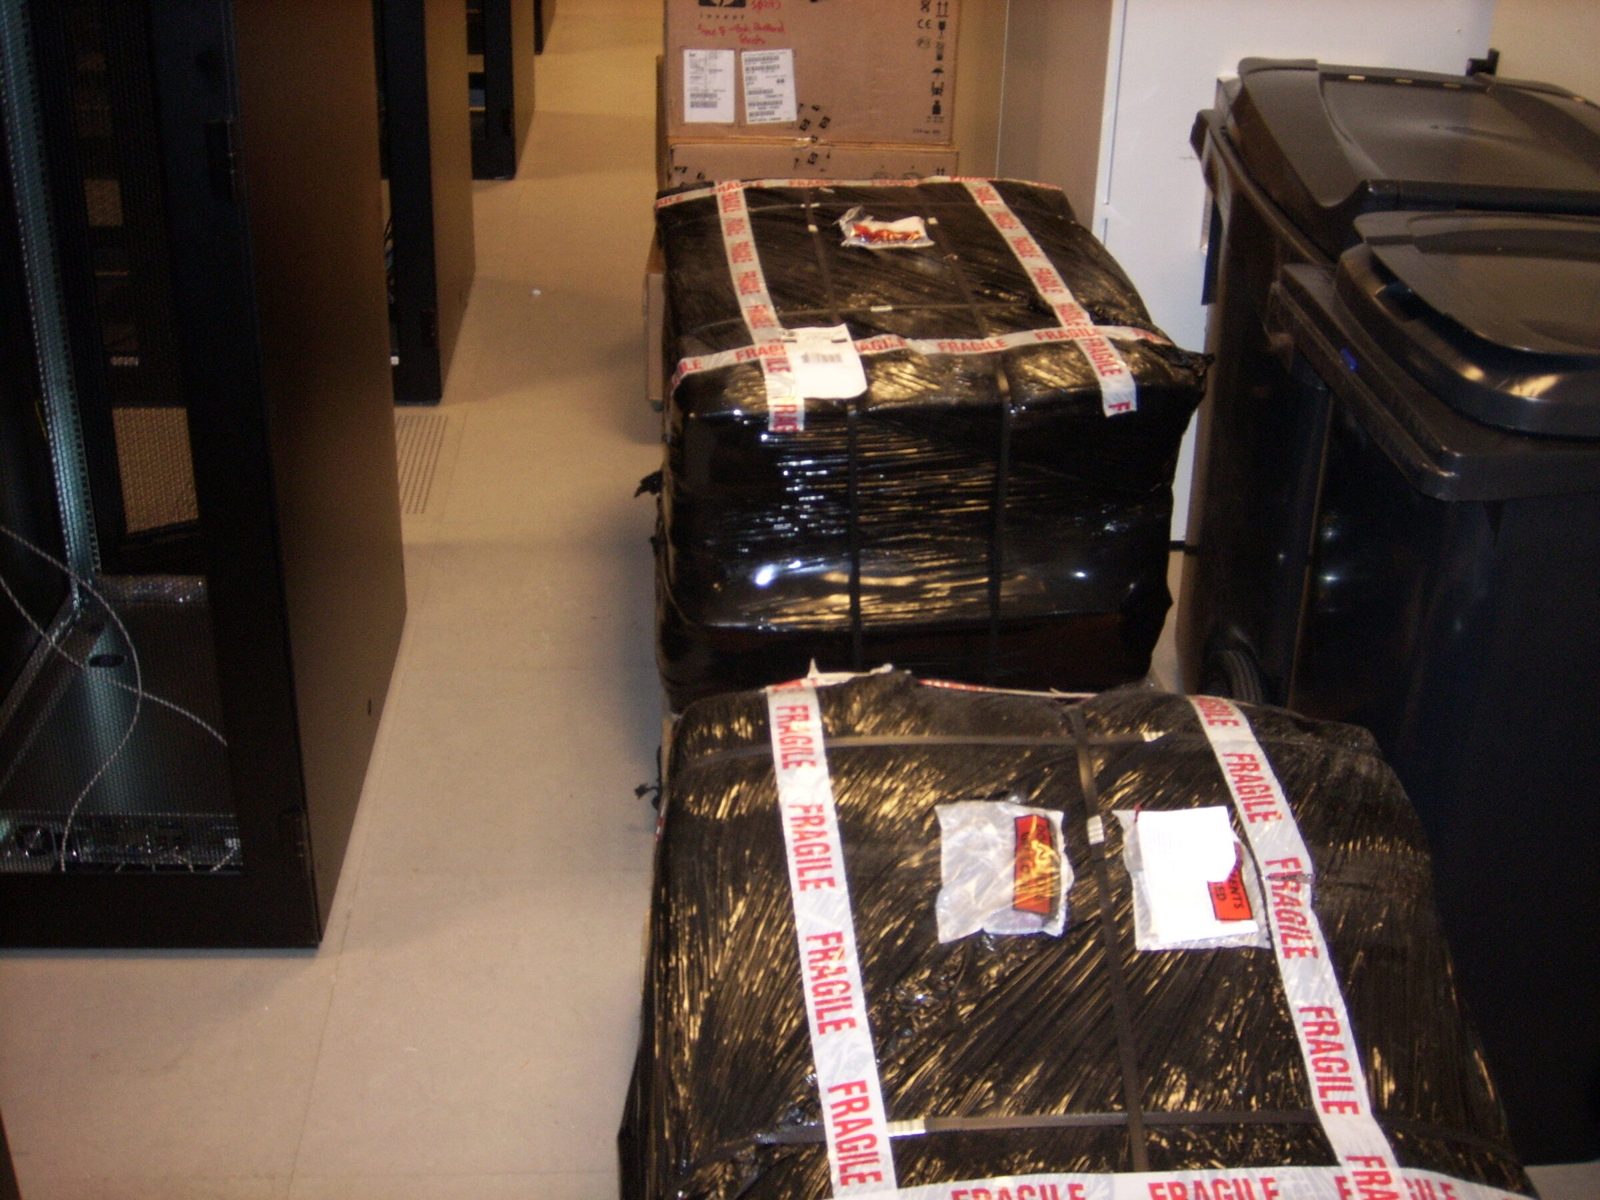
Darauf lief Plesk. Die Etiketten, die wir für die Front dieses ersten Stacks gedruckt haben, sind auf den Fotos noch lesbar: der Hostname auf jeder Maschine, das RAID-Layout über die Laufwerksschächte, und ein Chassis mit der Aufschrift BACK UP. Ein Server, schon Schacht für Schacht beschriftet, mit einer separaten Maschine, die bereits Backups lief. Nichts an der Art, wie wir heute arbeiten, ist eine spätere Erfindung. Es sind dieselben Gewohnheiten, mit mehr Hardware.
Die Amsterdamer Jahre
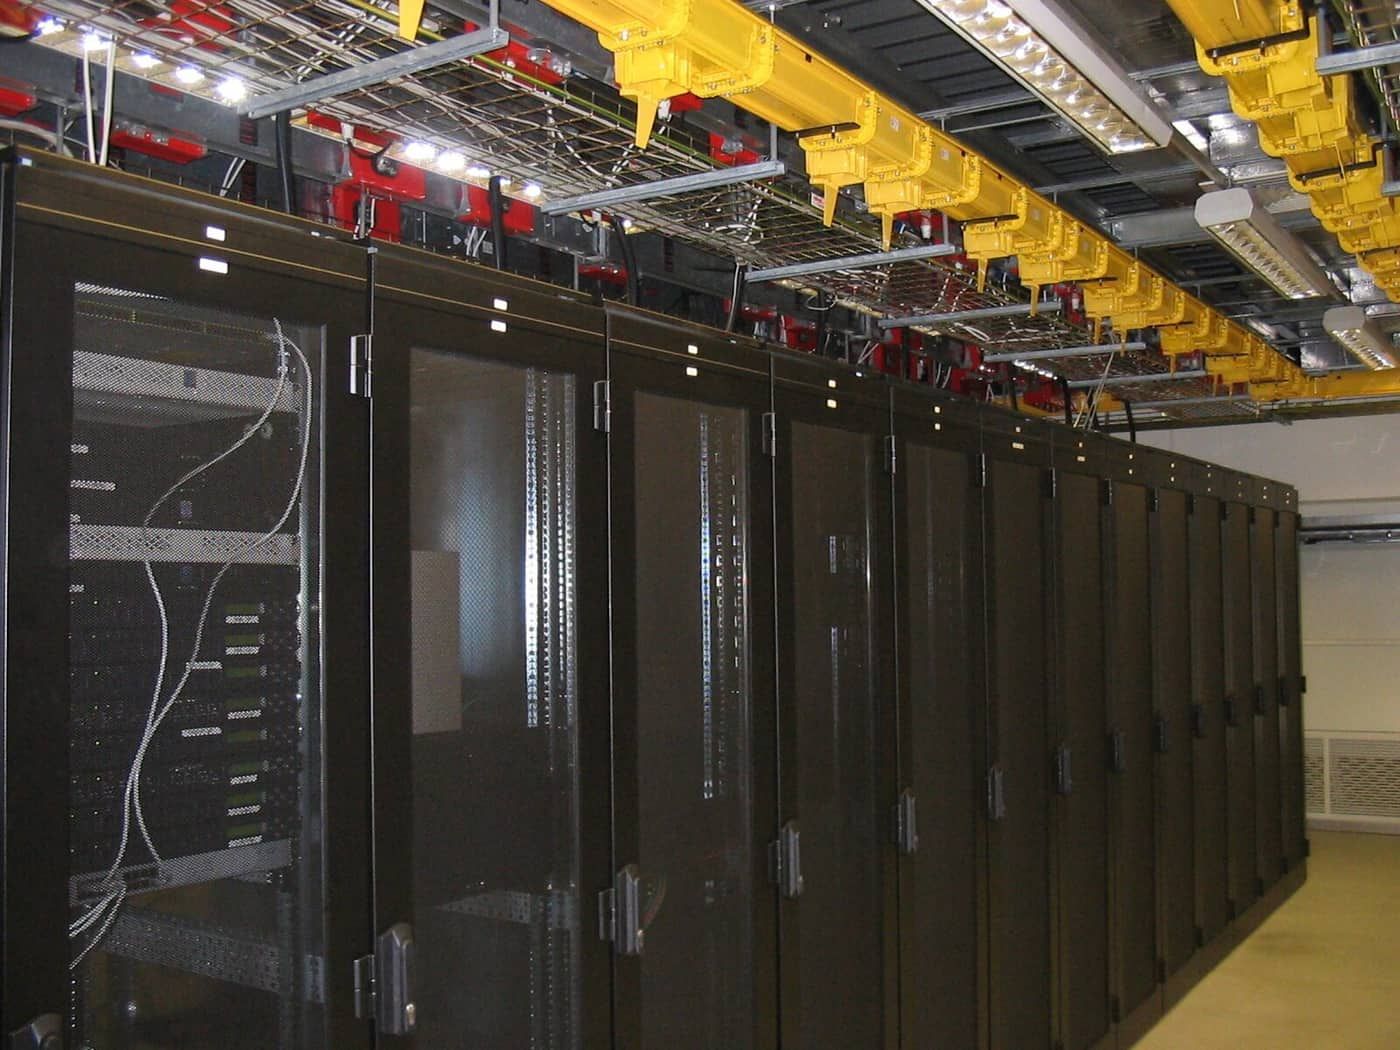
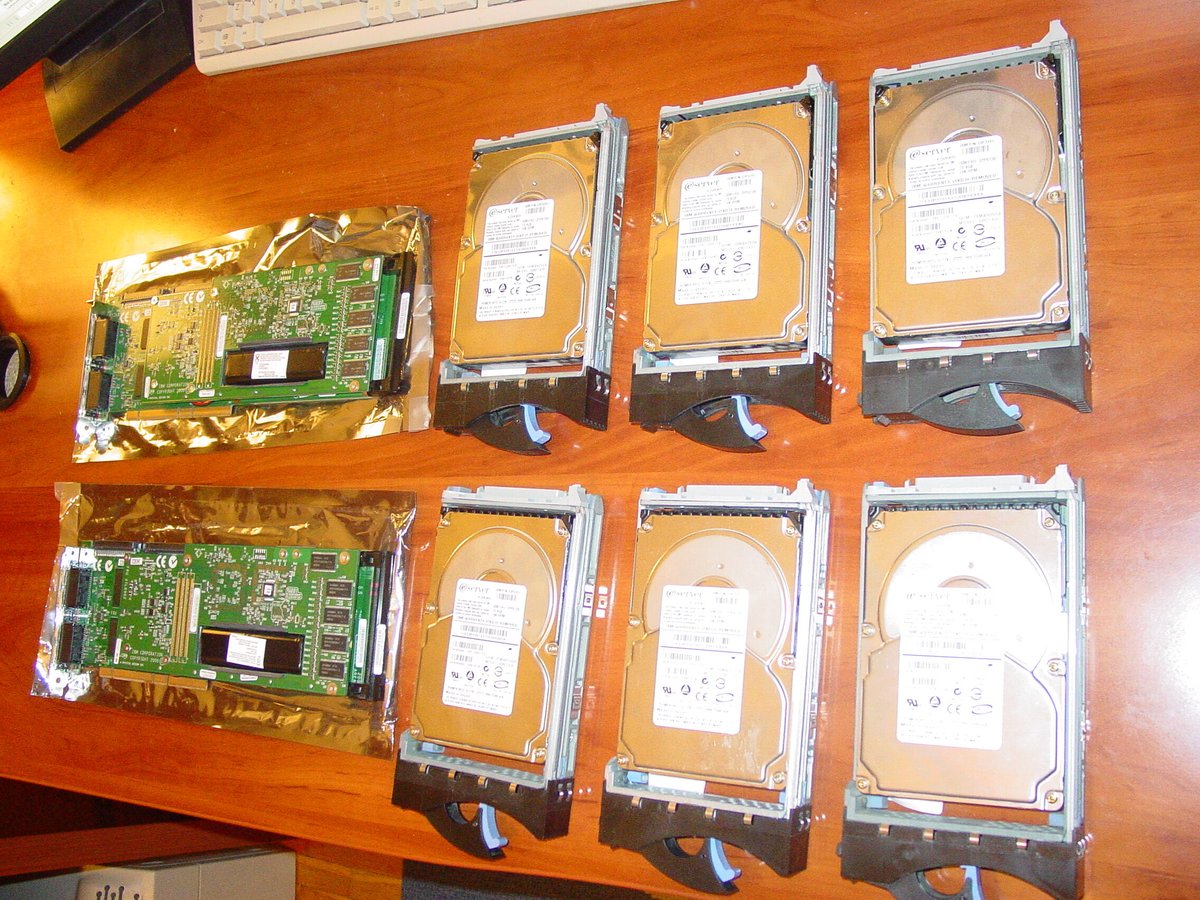
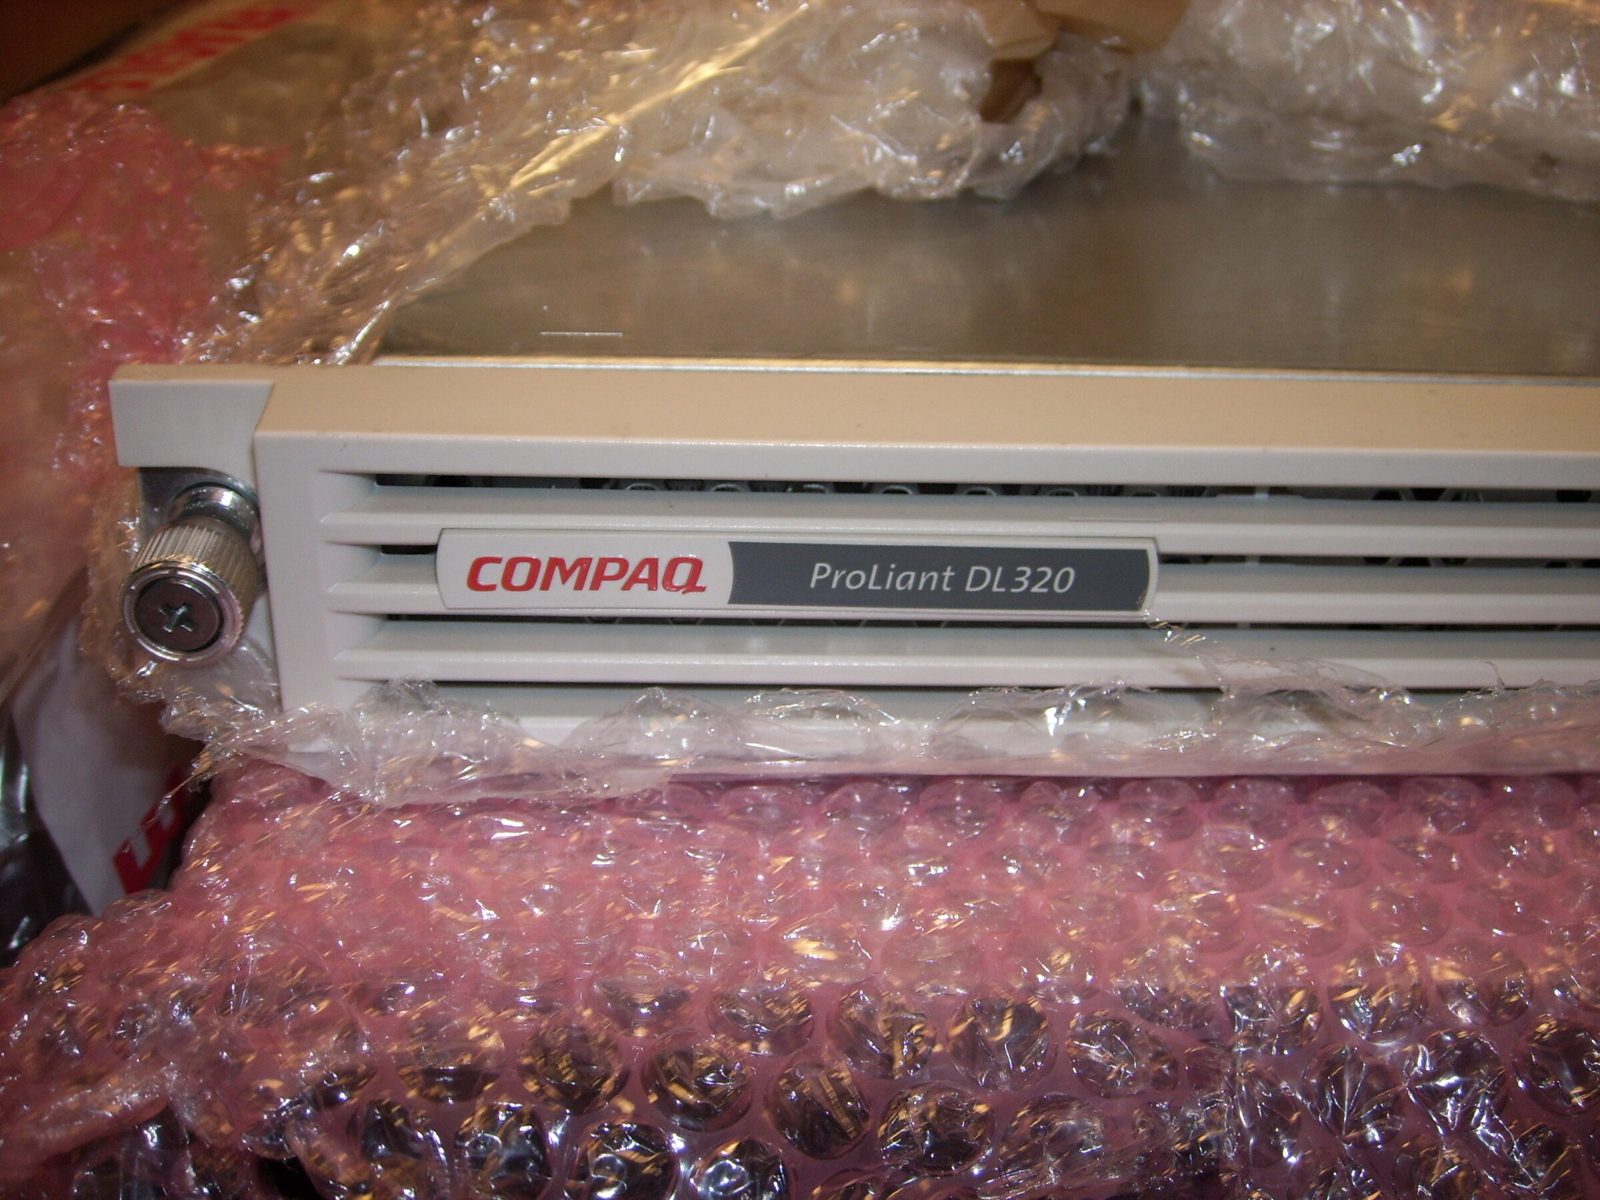
Die frühen Jahre waren ein Gang, ein Crash Cart und ein Laptop auf dem Boden. Zuerst IBM xSeries, dann Compaq und HP ProLiant Seite an Seite für den größten Teil des Jahrzehnts, neu gekauft und zwischen den Schränken ausgepackt. Der Storage zog früh auf Enterprise-Arrays um, EMC CLARiiON über doppelte Fibre-Channel-Fabrics, mit Cisco im Core, weil wir lieber für den zweiten Pfad zahlen, als eines Tages zu erklären, warum es keinen gab. Blade-Chassis folgten, dann ganze Spalten davon, und der Bestand wuchs in unsere eigenen Cages bei Iron Mountain.

Athen, Amsterdam, Toronto
Das Flaggschiff heute ist unser eigener Cage bei Digital Realty Athens: unsere eigenen Router, All-Flash-Storage, Glasfaser an jedem Port, gebaut, wie das erste Rack gebaut wurde, von uns. Amsterdam läuft weiter, mit Athen über privates Layer 2 verbunden, sodass sich die beiden wie ein Netzwerk verhalten und Sie zwischen ihnen umziehen können, ohne irgendetwas umzuadressieren. Toronto deckt Nordamerika von Cogent aus ab. Unser Firmensitz ist in Zypern.

Ein Betriebssystem, den ganzen Weg
Unser erster Server lief mit Red Hat Enterprise Linux, und wir sind seitdem durch jedes Major Release dabei geblieben. Nicht, weil es modern war: Ein Betriebssystem mit veröffentlichtem Lebenszyklus, signierten Paketen, SELinux im Enforcing-Modus und einem Hersteller, der hinter jedem Update steht, ist die Entscheidung, die wir nie wieder überdenken müssen.
Zwei Jahrzehnte auf einer Plattform sind eine Investition eigener Art. Jeder Build, jede Härtungsregel und jedes Upgrade-Runbook, das wir besitzen, wurde einmal geschrieben und seitdem verbessert, statt mit jeder neuen Distribution des Monats weggeworfen zu werden.
Wir haben auch etwas zurückgegeben. Ab 2005 betrieben wir einen öffentlichen Mirror für das CentOS-Projekt, kostenlos, aus unserem eigenen Netzwerk, damit jeder auf der Welt CentOS über EuroVPS-Bandbreite installieren und aktualisieren konnte.
Ja, wir sponsern einen Desktop. Derzeit stellen wir dem KDE-Projekt drei HPE-ProLiant-Server zur Verfügung. Unsere Ingenieure betreiben KDE Plasma auf Red Hat Enterprise Linux länger, als manche unserer Kunden im Geschäft sind. Wenn den Menschen, die die Hardware auswählen, ein Werkzeug so viel bedeutet, bekommt es Server.
Qualität vor Profit
Wir kommen aus einer Zeit, bevor die Margenmaximierung zum Mantra wurde.
EuroVPS hat kein Risikokapital, keine externen Investoren und keinen Exit-Plan. Niemand hat uns je gesagt, wir sollten eine Plattform um einen Kostenpunkt erleichtern, damit ein Quartal besser aussieht, denn es gibt kein Quartal, das besser aussehen muss, und niemanden, für den es das müsste. Das Unternehmen wird von den Menschen geführt, die es aufgebaut haben, Server für Server, mit ihren eigenen Händen.
Das ist kein Sentiment, das ist ein Entscheidungsprozess. Jede technische Wahl hier wird nach technischem Verdienst getroffen und danach, was es uns kostet, nachts geweckt zu werden, nicht danach, was sie mit einer Marge macht. Wenn ein Hosting-Unternehmen Geld von außen nimmt, muss es irgendwann etwas zurückgeben, und was zurückgegeben wird, ist fast immer der Teil, den Sie nicht sehen: die zweite Stromzuführung, die Originaloptik, das Ersatzteil im Regal, der Senior-Ingenieur um drei Uhr nachts. Wir haben alle vier behalten, weil die Menschen, die hier entscheiden, dieselben sind, die alarmiert werden.
Was wir uns weigern zu kaufen
Wir sind ein Hosting-Unternehmen, also ist Hardware keine Kostenzeile, die wir zu drücken versuchen. Sie ist das Produkt. Fast alles, was billiges Hosting billig macht, läuft auf eine kurze Liste von Komponenten hinaus, und keine davon kommt unter eine Kunden-Workload von uns.
SATA-Festplatten
Ein Port, ein Pfad, ein Controller: ein Single Point of Failure per Konstruktion, und keine Softwareschicht darüber kann einen zweiten Weg erfinden. SATA hat flache Warteschlangen und erholt sich schlecht von Fehlern, sodass ein Laufwerk der Desktop-Klasse an einem schwachen Sektor hängen und immer wieder lesen kann, während alles darüber wartet. Enterprise-SAS hat zwei Ports, meldet seine Fehlerzähler ehrlich und gibt die Kontrolle schnell genug zurück, damit die RAID-Schicht ihre Arbeit tun kann.
SATA-SSDs
Derselbe einzelne Port, dieselbe flache Warteschlange, auf einer Schnittstelle, die für drehende Platten gebaut wurde. Flash hinter SATA zu setzen heißt, für das Medium zu zahlen und dann das meiste von dem wegzuwerfen, was es bietet. Dieser Markt ist außerdem überwiegend ein Verbrauchermarkt: geringe Haltbarkeit, kein zweiter Port, oft kein Schutz bei Stromausfall.
Consumer-M.2-NVMe-Sticks
Consumer-Sticks haben in der Regel keine Kondensatoren zum Schutz bei Stromausfall, sodass ein Schreibvorgang, der gerade läuft, wenn der Strom weg ist, ein Schreibvorgang ist, den Sie vielleicht nie wiedersehen, und ihre Haltbarkeit ist für einen Desktop spezifiziert, nicht für eine Datenbank, die den ganzen Tag schreibt. Wir betreiben reichlich NVMe, als Enterprise-U.2- und U.3-Laufwerke mit Schutz bei Stromausfall in Hot-Plug-Trägern. Nie als Stick, der auf ein Board geklebt ist und die einzige Kopie hält.
Single-Socket-Boards der Desktop-Klasse
Ein Sockel, ein Netzteil, kein Out-of-Band-Management, das den Namen verdient, und zu wenige PCIe-Lanes, um einen Dual-Port-Fibre-Channel-HBA und redundantes Networking gleichzeitig zu tragen. Es gibt auch keine Hot-Plug-Backplane, also ist jeder Komponentenausfall ein Herunterfahren. Das Design sagt eines: Wenn das kaputtgeht, bleibt der Dienst kaputt, bis jemand hinfährt.
Ein einzelnes Netzteil
Ein Netzteil macht aus geplanten Arbeiten im Rechenzentrum einen Kundenausfall.
Nicht-ECC-Speicher
Wir betreiben keine Workload auf Speicher, der uns nicht sagen kann, dass er ausfällt.
Software-RAID als Ausfallsicherheitskonzept, und White-Box-Server
Wir legen Kundendaten nicht auf das Software-RAID einer einzelnen Kiste, mit ungeschütztem Schreibcache und Parität, die auf der Host-CPU neu berechnet wird. Ausfallsicherheit gehört ins Array und in redundante Fabrics, wo sie den vollständigen Verlust des Servers überlebt. White Box bekommt dieselbe Antwort: kein Firmware-Lebenszyklus, keine Ersatzteile im Regal, niemand, den man anrufen kann.
In der Praxis. Wir nehmen nichts auf Treu und Glauben von einem Gerätenamen oder einem Kernel-Standardwert: Wir befragen den RAID-Controller und die Laufwerke direkt, über zwei unabhängige Pfade, und tunen nach dem, was jedes Gerät tatsächlich meldet.
Was wir stattdessen kaufen
HPE ProLiant und Dell PowerEdge: ProLiant DL380 Gen10 und Gen11, DL385 Gen11 und BL460c-Gen10-Blades; PowerEdge R740, R750 und R7525, und C6400 für dichte Rechenleistung. Dieselbe Grundausstattung auf jedem einzelnen.
- Zwei Hot-Plug-Netzteile an zwei unabhängigen Stromzuführungen.
- ECC-Speicher durchgehend, mit überwachten Zählern für korrigierbare Fehler.
- Hardware-RAID mit batterie- oder flashgepuffertem Schreibcache überall dort, wo ein Server lokale Laufwerke hält, damit ein Stromereignis keinen bestätigten Schreibvorgang kosten kann.
- Enterprise-SAS-12G-SSDs und Enterprise-NVMe, dort eingesetzt, wo die Messung sagt, dass sie hingehören.
- Out-of-Band-Management auf jeder Kiste, in einem physisch getrennten (air-gapped) Management-Netzwerk, das von seinem eigenen, völlig separaten autonomen System geroutet wird.
Hosts, die vom SAN booten und nichts halten
Unsere Hypervisoren booten von einem Volume auf dem Array, bereitgestellt über zwei physisch getrennte Fibre-Channel-Fabrics. Der Server selbst hält keine Kundendaten, also kostet uns ein ausgefallenes Blade ein Blade: Der Ersatz bootet dasselbe Volume. Das ist ein Teiletausch, keine Datenrettung.
Maschinen, die nie einen Sockel überschreiten
Hausregel, und nicht verhandelbar: Eine virtuelle Maschine bekommt nie mehr vCPUs, als ein Sockel physische Kerne hat, und nie mehr Speicher, als ein NUMA-Knoten bedient. Über zwei Sockel gespannt wird ein Teil des Speicherverkehrs entfernt, bei etwa dem 1,7-Fachen der lokalen Latenz, noch vor dem Cache-Kohärenz-Verkehr über die Sockelverbindung. Der Nachteil verstärkt sich, statt sich auszumitteln, weshalb eine Maschine, die über die Sockelgrenze hinaus dimensioniert ist, oft langsamer läuft als die kleinere, die sie ersetzt hat.
Enterprise-Flash ist kein RAM
Unsere virtuellen Maschinen bekommen keinen Swap. Swap auf einer VM drückt den Speicherdruck nach unten aufs Array und verbraucht Flash-Schreibhaltbarkeit, die dazu da ist, echte Daten zu bedienen. Wenn eine Anwendung mehr Speicher braucht, ist die ehrliche Antwort mehr Speicher, oder eine Korrektur in der Anwendung. Wir sagen Ihnen, welches von beiden.
Getunt, nicht mit Standardwerten ausgeliefert
Flash-gestützte Volumes bekommen den richtigen Scheduler, das richtige Read-Ahead und die richtige Queue Depth, keine Heuristiken, die für drehende Platten geschrieben wurden. Kleine, dauerhafte Gewinne, auf jedem Build.
Storage: HPE 3PAR, All-Flash, alles doppelt
Kundendaten liegen auf HPE 3PAR, All-Flash, in SSD-RAID-6-Provisioning-Groups. RAID 6, weil der Rebuild eines großen Flash-Laufwerks ein Zeitfenster ist, und wir verbringen es nicht einen Ausfall vom Datenverlust entfernt.

Zwei Controller, zwei Fabrics, viele Pfade
Doppelte Controller pro Array. Jeder Host ist über zwei physisch getrennte Brocade-Fibre-Channel-Fabrics angebunden, ein HBA-Port in jede, und mit der richtigen Persona registriert, damit Multipathing und ALUA sich so verhalten, wie das Betriebssystem es erwartet. Ein Controller, eine Fabric, eine Optik oder ein HBA-Port kann wegfallen, und das Volume bleibt online.
Thin, das die Wahrheit sagt, Volumes, die im Betrieb umziehen
Volumes sind thin mit automatischer Zero-Erkennung, sodass eine voll provisionierte Gast-Festplatte physisch fast nichts kostet, bis echte Daten ankommen. Die Arrays sind in Federation, also migrieren wir ein laufendes Volume von einem Array auf ein anderes, während der Host weiter darauf liest und schreibt. Für geclusterte Datenbanken gehen wir weiter und legen jedes Mitglied auf ein anderes physisches Array, sodass der Verlust eines ganzen Arrays ein Replikat kostet und das Quorum hält.
Laufwerkshygiene, und Disziplin bei Schreibvorgängen
Ein Laufwerk, das einen korrigierten Fehler meldet, ist ein Laufwerk, dessen interne Fehlerkorrektur bereits arbeitet, unter laufendem Kundenverkehr. Wir warten nicht, bis es ausfällt: Es wird auf null geleert, entfernt, durch ein sauberes Laufwerk ersetzt, und das Array nimmt das neue automatisch auf.
Backups werden geholt, und die Wiederherstellung passt zum Dienst
Backups sind Pull-only. Die geschützten Systeme haben keine Route zur Backup-Infrastruktur und keine Zugangsdaten dafür, sodass eine Kompromittierung auf der Produktionsseite die Backups nicht erreichen kann. Die sichere Seite greift zu und holt, was sie braucht, nie umgekehrt. Wiederherstellungsziele werden pro Dienst festgelegt, nicht als eine Hausnummer: Eine statische Website und eine transaktionale Datenbank verdienen nicht dieselbe Antwort.
Ein Anbieter kann Storage, Server und Software später ersetzen. Was sich nachträglich nicht reparieren lässt, sind die Verkabelung, die Optiken und die Router, auf denen es gebaut wurde, also haben wir die zuerst richtig gemacht.
Glasfaser von Ende zu Ende
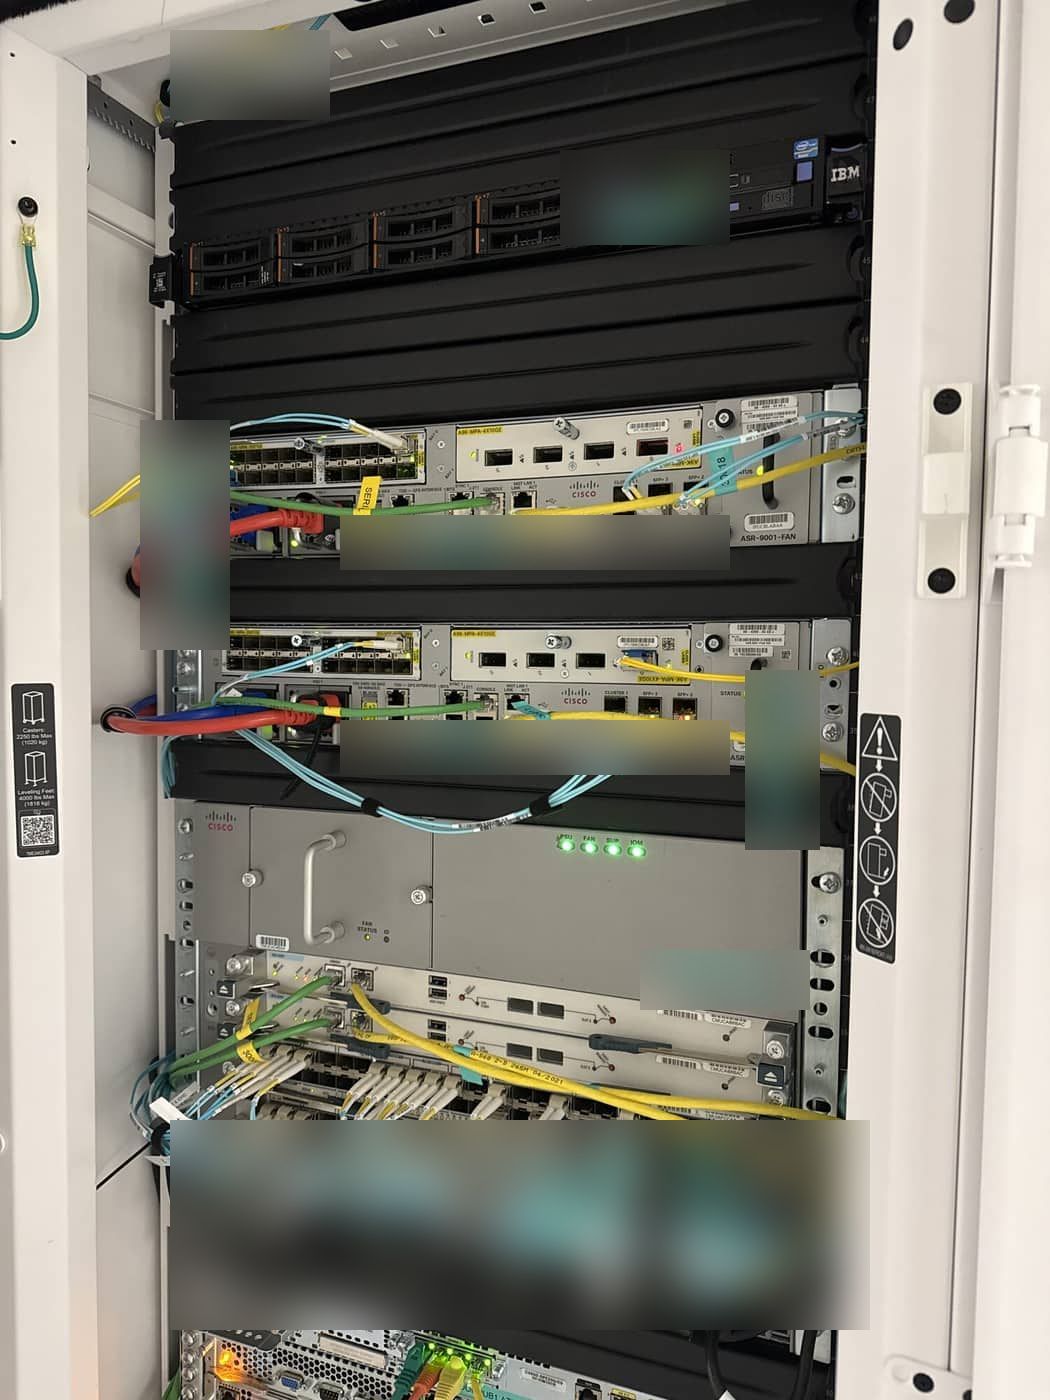
In unserem Cage in Athen gibt es keine Kupfer-Datenverkabelung. Jeder Server, jedes Blade-Chassis, jedes Storage-Array, jeder Switch und jeder Router ist über Glasfaser angebunden. Das einzige Kupfer, das in einem Schrank übrig ist, ist die kurze Strecke zum Lights-out-Management-Port eines Servers, und das ist Absicht: Es ist die eine Schnittstelle, deren Aufgabe es ist zu funktionieren, wenn alles andere aus ist.
Glas gewinnt auf jeder Achse, die in einem Schrank zählt. Einer optischen Verbindung sind elektrisches Rauschen oder die Stromleitung daneben egal, also ist eine Verbindung entweder in Ordnung oder nicht vorhanden, nie rätselhaft grenzwertig, und eine Strecke durchquert das Rack, die Reihe und den Saal mit derselben Spezifikation. Hochgeschwindigkeitskupfer ist dick, schwer und biegt sich ungern, und diese Masse hängt am Ende an dem Switch, den sie bedient, vor seiner Abluft; Glasfaser ist dünn und leicht, also bleiben die Schränke sauber. Und wenn die nächste Generation von Geschwindigkeiten kommt, bleibt die Anlage, wo sie ist: Wir tauschen den Transceiver an jedem Ende und behalten das Kabel.
In der Praxis. Vor dem Start neuer Kundenplattformen haben wir die gesamte Glasfaser- und Port-Channel-Topologie eines Blade-Racks gebaut, bevor die meisten Blades existierten. Der Starttag war ein Einschalten, keine Verkabelungsarbeit.

Nur Originaloptiken
Jedes SFP, SFP+ und QSFP in unseren Racks ist das Originalteil des Herstellers, passend zu dem Switch oder Router, in dem es sitzt, und unterstützt vom Hersteller, dessen Name auf dem Chassis steht. Wir haben nie einen generischen Transceiver gekauft, und wir fangen nicht damit an.
Die Ersparnis ist klein und kauft vier Probleme: optische Messwerte, die vielleicht nichts bedeuten, womit Sie die beste Diagnose in einem optischen Netzwerk verlieren, den Live-Lichtpegel an jedem Ende; ein Modul, das auf einem Software-Release funktioniert und auf dem nächsten Fehler macht, weil niemand diese Kombination getestet hat; einen legitimen Grund für einen Hersteller, den Supportfall zu schließen, den Sie in der Nacht eröffnen, in der Sie ihn am dringendsten brauchen; und eine Verbindung, die unter Last flattert, aus Gründen, die niemand reproduzieren kann. Also kaufen wir das richtige Teil, und wir kaufen Ersatz: Trays mit Optiken im Regal im Rechenzentrum, sodass ein Austausch ein Gang durch die Reihe ist statt einer Bestellung.
In der Praxis. Unsere routinemäßigen Gesundheitschecks lesen die Schnittstellen- und Optikfehlerzähler über die ganze Fabric, und weil jedes Modul das Original des Herstellers ist, lässt sich auf das, was sie melden, reagieren: Ein Transceiver, der aus der Spezifikation driftet, ist ein geplanter Tausch aus dem Tray, nach unserem Zeitplan.


Die Fabric: Leaf und Spine, EVPN und VXLAN
Im Rechenzentrum hängt alles an einer Cisco-Nexus-9000-Leaf-und-Spine-Fabric mit BGP EVPN und VXLAN. Die Spines sind reine Route Reflectors, mit Absicht ohne Tunnel-Endpunkte. Leaves sind als Virtual-Port-Channel-Paare gebaut, sodass jeder Host über einen logischen Bond an zwei Switches angebunden ist, und das Gateway eines Kundensubnetzes ist auf jedem Leaf dieselbe Anycast-Adresse. Broadcast-Verkehr wird von BGP repliziert statt von einem Multicast-Baum, und BFD läuft dort, wo schnelle Erkennung zählt. Weil jedes VLAN auf jedem Leaf liegen kann, können wir das Layer 2 eines Kunden zwischen unseren Rechenzentren erweitern und seine Server beim Umzug ihre Adressen behalten lassen.
Der Netzwerk-Identifier jedes Layer-2-Segments wird nach einer festen Regel aus seinem lokalen VLAN abgeleitet, und diese Regel ist keine Konvention in einem Dokument. Eine automatisierte Prüfung liest die Zuordnung von jedem Leaf, bestätigt, dass die Leaves identisch sind und der Regel folgen, und vergleicht einen kryptografischen Fingerabdruck der gesamten Zuordnung mit einer signierten Baseline in der Versionskontrolle. Sie läuft, bevor eine Änderung gespeichert wird, und danach nach Zeitplan, Abweichung alarmiert einen Ingenieur, und eine beabsichtigte Änderung muss neu signiert werden, sodass jede Fabric-Änderung einen Autor und eine Prüfspur trägt.
In der Praxis. In einem kontrollierten Ausfalltest haben wir einen Cluster-Knoten neu gestartet, während er der bevorzugte Pfad für eine öffentliche Live-Adresse war. Die Fabric konvergierte in etwa drei Sekunden auf einen gesunden Knoten, und die Adresse verließ nie die Routing-Tabelle.

Der Edge: unsere eigenen autonomen Systeme
Wir betreiben unseren eigenen Internet-Edge, auf unseren eigenen, bei RIPE registrierten autonomen Systemen und mit eigenem IPv4- und IPv6-Adressraum, mit Kundenproduktion und Plattformdiensten auf getrennten autonomen Systemen, sodass ein Problem auf dem einen das andere nicht erreichen kann. Die Router sind Carrier-Klasse: Cisco ASR 9000 Series in Athen, ein ASR 9006 an der Front des Produktions-Edge, und Juniper MX204 in Amsterdam, jeder mit der vollständigen Internet-Routing-Tabelle, die er mit seinem Geschwisterrouter austauscht.
Wir kaufen Transit von mehreren Carriern, statt einen Port von demjenigen zu mieten, dem das Gebäude gehört: OTE Globe, Cogent und Hurricane Electric in Athen, Arelion, NTT, Deutsche Telekom und Telecom Italia auf der Amsterdamer Seite, wobei die beiden Standorte über privates Layer 2 verbunden sind, sodass sich der Bestand wie ein Netzwerk verhält. Wir peeren direkt am GR-IX und am NetIX und fügen bilaterale Sessions eine nach der anderen hinzu, mit den Netzwerken, mit denen unsere Kunden tatsächlich sprechen.
IPv6 ist überall nativ: Dual-Stack von den Edge-Routern bis zu Ihrem Gateway, ohne Tunnel und ohne Übersetzung im Pfad.
In der Praxis. Unsere Fabric in Athen ging an einem einzigen Arbeitstag auf Dual-Stack, vom Internet-Edge durch die Fabric bis zu einem laufenden, gemeinsam genutzten Kunden-VLAN.

Fibre Channel: zwei Fabrics, nie ein Pfad
Das Netzwerk zwischen Servern und Storage ist Fibre Channel, nicht Ethernet, gebaut als zwei vollständig unabhängige Brocade-Fabrics. Jeder Server und jedes Array ist an beide angebunden, jede Fabric mit eigenem Core-Switching und eigenem Switch in jedem Blade-Enclosure, sodass kein einzelner Switch, kein Kabel, kein Port und kein Softwarefehler auf beiden Seiten des Pfads eines Hosts existiert.
In der Praxis. Weil jeder Host bereits Live-Pfade zu jedem Array seiner Federation über beide Fabrics hält, können wir ein ganzes Storage-Array leeren, für Wartung oder einen Umzug, ohne eine Kundenmaschine neu zu starten und ohne Wartungsfenster.
Das verschlüsselte Backbone zwischen unseren Standorten
Unsere Rechenzentren in Athen, Amsterdam und Toronto, unser Firmensitz in Zypern und unsere regionalen Präsenzpunkte sind durch ein Cisco-DMVPN-Overlay verbunden: Multipoint-GRE-Tunnel, geschützt durch IPsec mit AES-256, authentifiziertes NHRP, BFD und BGP über die Tunnel. Jedes Rechenzentrum hat redundante Hubs, und weil das Overlay von BGP geroutet wird statt von statischen Tabellen, ist der Verlust eines Hubs oder einer Leitung ein Routenrückzug, der von selbst konvergiert.
Ein Standort mit zwei WAN-Leitungen betreibt eine zweite DMVPN-Cloud auf demselben Router, sodass die zweite Leitung keine neue öffentliche Adresse und keine Änderung an den Hubs braucht, und BGP-Multipath verteilt den Verkehr auf beide, mit einem Forwarding-Hash, der Ports einschließt, damit parallele Flows sich wirklich aufteilen. Wir dimensionieren nach dem, was die Verschlüsselungs-Engine tatsächlich leistet, etwa 11 Gbit/s pro Hub, nicht nach der Zahl auf einer Lizenz, und skalieren mit Equal-Cost-Multipath über Hubs auf 30 bis 40 Gbit/s, wenn ein Kunde es braucht.
In der Praxis. An einem Standort mit zwei Leitungen hat ein Durchsatztest in jeder Richtung mehr gemessen, als eine der beiden Leitungen allein tragen konnte. Das ist der einzige akzeptable Beweis dafür, dass Equal-Cost-Multipath funktioniert und nicht bloß konfiguriert ist.
Die Disziplin, die dazugehört
Bonds, die beide Links nutzen. Der Linux-Bonding-Standard hasht auf MAC-Adressen, was in einem Rechenzentrum die Flows auf ein Mitglied eines Bonds häuft und das andere untätig lässt. Jeder gebondete Server, den wir bauen, hasht auf Layer 3 und Layer 4, mit passend eingestellter Switch-Seite. Wir prüfen die Zähler pro Port auf jedem Build, um zu beweisen, dass beide Links Verkehr tragen.
Jeder Port erfasst. Nicht ein Name in einer Zeile: der Port mit seiner echten MAC-Adresse, der Link zum Switch-Port der Gegenseite mit seiner Kabel-ID, die Rack-Position, die Adressen und die Management-Schnittstelle. Das laufende Gerät ist die Quelle der Wahrheit, und die Aufzeichnungen werden so gemacht, dass sie ihm entsprechen.
Ein Reverse-Eintrag für jede Adresse. Jede Adresse, die wir einer Schnittstelle, einem Loopback, einem Dienst oder einem Host zuweisen, bekommt in derselben Sitzung einen PTR in unserem eigenen autoritativen DNS. Ein Traceroute durch unser Netzwerk liest sich wie ein Satz, der das Gerät, seine Rolle und seinen Standort nennt.
Die Management-Ebene, und der Air Gap
Kundenverkehr und Management-Verkehr teilen sich nichts: keinen Port, keinen Switch, keine Adresse, keine Route.
Es gibt genau ein Kupferkabel, das in unseren Schränken übrig ist: der Management-Port des Lights-out-Controllers jedes Servers. Es ist auch das am sorgfältigsten isolierte Kabel im Gebäude.
Out-of-Band-Management auf jeder Maschine
Jeder Server, den wir betreiben, ist ein echter Enterprise-Server mit einem echten Lights-out-Controller: iDRAC Enterprise mit Datacenter-Lizenz bei Dell, iLO Advanced bei HPE, beide über Redfish angesteuert, und jedes Blade-Chassis über seinen Onboard Administrator. Kein White-Box-Mainboard, dessen Vorstellung von Fernwartung ein Einschaltknopf und keine Konsole ist.
Auf dem Blade-Chassis erreicht der Onboard Administrator jeden Controller im Enclosure über die Backplane und ist selbst ein redundantes Paar mit automatischem Failover.
In der Praxis. Als ein Rack voller Blade-Chassis iLO Advanced lizenziert bekommen musste, und auf jedem Blade darin ein Management-Konto angelegt, haben wir uns an keinem einzigen Blade angemeldet. Wir haben es über den Onboard Administrator jedes Chassis ausgerollt, und das Rack war in Minuten fertig, einschließlich Blades, die in derselben Woche eingebaut worden waren und noch keine eigenen Zugangsdaten hatten. Es ist ein Runbook.
Das Management-Netzwerk ist nicht das Produktionsnetzwerk
Der Controller hat seinen eigenen physischen Port und sein eigenes Kabel zu seinem eigenen Switching. Wir partitionieren keine Produktions-Netzwerkkarte, damit sich der Controller eine Scheibe davon leiht, was die übliche Abkürzung ist und der übliche Grund, warum Management am Ende einen Fehler vom Internet entfernt ist. Management lebt auf eigenen Switches, oder auf eigenen VLANs auf Fabrics, die sonst nichts tragen, in privatem Adressraum, der zu keinem Kundennetzwerk hin oder von ihm weg geroutet und nie ins Internet announciert wird.
Wir nennen es Air Gap, weil es sich so verhält. Eine virtuelle Kundenmaschine, selbst eine vollständig kompromittierte, die eine Woche lang mit Leitungsgeschwindigkeit scannt, kann ein iLO oder ein iDRAC überhaupt nicht sehen. Nicht abgewiesen, nicht gefiltert: nicht vorhanden. Es gibt nirgendwo, wohin die Pakete gehen könnten. Das gilt auch in die andere Richtung, und das zählt genauso: Kein Management-Verkehr fährt über ein Kunden-VLAN, also betreten unsere Konsolensitzungen, unser Monitoring und unsere Backups nie die Broadcast-Domäne eines Kunden und konkurrieren nicht um seine Bandbreite. Die Isolation ist real genug, um uns unbequem zu sein, und das ist der Beweis, dass sie real ist: Ein Controller in einem Management-VLAN kann nicht einfach einen internen Webserver erreichen, um ein Firmware-Image zu holen, weil nichts erlaubt ist, was nicht beantragt und aufgeschrieben wurde. Der Ingenieur geht den zusätzlichen Schritt.
Backups reisen auf demselben Weg. Sie werden über das Out-of-Band-Netzwerk gezogen, nie über ein Produktionssegment.
In der Praxis. Eine kanonische Management-Zugriffsliste ist auf jeder Plattform gebunden, die wir betreiben, auf den Login-Lines der Cisco Nexus, pro Routing-Instanz auf den Routern, pro Schnittstelle für SSH und HTTPS auf den Firewalls, und erlaubt nur benannte Management-Subnetze, während Control Plane Policing alles Übrige in Hardware begrenzt.
Die Management-Ebene selbst
Die Management-Ebene ist ein eigenständiges Netzwerk, und wir haben sie wie eines gebaut. Sie läuft auf unserem eigenen verschlüsselten Multi-Site-Backbone: Cisco DMVPN, IPsec mit AES-256, BGP über die Tunnel, und verbindet Athen, Amsterdam und Toronto mit unserem Firmensitz in Zypern, der bewusst in keinem der Gebäude liegt, die er verwaltet. Die Hubs sind redundant, mit Equal-Cost-Pfaden über sie und über diverse Leitungen, und einer Ausfallerkennung, die einen toten Pfad in deutlich unter einer Sekunde bemerkt.
Mitarbeiter erreichen sie auf einem Weg: über VPN-Gateways und Firewalls, die wir selbst besitzen und betreiben, auf OPNsense und Cisco Firepower, dann über Jump Hosts innerhalb der Ebene statt direkt vom Laptop eines Ingenieurs. Verschiedene Vertrauensstufen teilen sich nie ein Firewall-Objekt, sodass die Erweiterung des Zugriffs einer Gruppe nicht stillschweigend den einer anderen erweitern kann.
Gegenüber den Backup- und Disaster-Recovery-Ebenen ist die Richtlinie Deny by Default, und die Daten fließen in eine Richtung. Die Produktion schiebt nie zum Backup. Die Backup-Seite holt. Das wird mit expliziten Deny-Regeln auf den Firewall-Appliances durchgesetzt, nicht mit einer Host-Firewall, die ein kompromittierter Host ändern könnte, und die Backup-Segmente haben überhaupt keine Route ins Internet. Nur der Management-Bereich erreicht sie. Wenn eine Produktionsmaschine vollständig übernommen wird, erlangt der Angreifer kein Wissen über die Backup-Infrastruktur und keinen Pfad dorthin. Von dort, wo er steht, existiert sie nicht.
Backbone-Änderungen werden live gegen das laufende System verifiziert, eine Hälfte eines redundanten Paars nach der anderen, weshalb wir mitten an einem Arbeitstag am Backbone arbeiten können.
In der Praxis. Wir haben den gesamten Site-to-Site-VPN-Bestand eines Kunden in einer einzigen Sitzung von einem Land in ein anderes verlegt, vor einer festen Frist. Der Hub wurde geklont, hinübergetragen und parallel zum Original hochgefahren, sodass beide gleichzeitig live waren und die Tunnel immer irgendwo sein konnten. Die Zweigstellen-Router wurden einer nach dem anderen umgezogen, jeder als erreichbar verifiziert, bevor der nächste angefasst wurde, jeder mit sauberem Failover unterwegs. Niemand ist in eine Zweigstelle gefahren.
Die Hardening-Baseline auf jedem Host
Jede Maschine, die wir bauen, startet von derselben Baseline, und die Baseline steht nicht zur Verhandlung. SELinux ist im Enforcing-Modus, und wir schalten es nicht ab, damit eine Anwendung mitspielt, wir schreiben stattdessen die Policy. Dateisysteme sind XFS.
Das Patchen hängt von niemand anderem ab. Wir betreiben unseren eigenen Paket-Mirror in unserem eigenen Rechenzentrum, mit den Repositories, aus denen unsere Flotte installiert, Upstream-Signaturen intakt, nur aus unseren eigenen Adressbereichen erreichbar. Ein öffentlicher Mirror, der einen schlechten Tag hat, ist hier kein Ereignis, und ein Server, der absichtlich nicht mit dem Internet sprechen kann, ist immer noch ein Server, den wir vollständig patchen können.
In der Praxis. Als eine kritische Schwachstelle in einer weit verbreiteten Laufzeitumgebung veröffentlicht wurde, waren die korrigierten Pakete noch am selben Tag auf jedem betroffenen Server in Produktion, vor dem Ende derselben Nacht. Nicht von Hand und nicht in Eile: Der Rollout nimmt ein Backup, aktualisiert einen Host nach dem anderen, prüft echte Websites auf diesem Host vorher und nachher auf eine gesunde Antwort und stoppt den gesamten Durchlauf automatisch, wenn eine nicht korrekt zurückkommt. Schnell und sorgfältig sind keine Gegensätze, wenn man das Werkzeug baut, das es für einen erledigt.
Maschinenlogs rein, und nichts darf verstummen
Die ernsten Schweregrade gehen direkt in den Betriebs-Chat, in dem der Bereitschaftsingenieur ohnehin ist, und erreichen in Sekunden einen Menschen, und wir wissen, dass es Sekunden sind, weil wir es mit einem echten Alarm gestoppt haben. Am Edge lesen dedizierte Sensoren gespiegelten Verkehr von den Border-Routern und achten kontinuierlich auf volumetrische und Denial-of-Service-Muster.
Ein Gerät kann von seiner eigenen Kommandozeile aus völlig gesund aussehen, während es still nichts an den Collector sendet, also ist «Logging ist konfiguriert» hier kein Beweis. Wir bestätigen, dass das Log ankommt, am anderen Ende, in dem Stream, zu dem es gehört, nach jeder Änderung, die es gestört haben könnte. Die Monitoring-Systeme haben ihre eigenen Watchdogs auf separaten Maschinen, sodass «das, was zugesehen hat, hat aufgehört zuzusehen» selbst ein Alarm ist. Stille ist nie eine gute Nachricht.
In der Praxis. Unser routinemäßiger Gesundheitscheck prüft auch zwei Dinge, die die meisten Checks auslassen: ob jedes Gerät seine Logs noch wirklich verschickt, und ob seine Konfiguration noch wirklich gesichert wird. Diese beiden sind die Ausfälle, die die anderen verstecken.
Echtzeitanalyse auf unseren eigenen NVIDIA A100
Die meisten Anbieter sammeln Logs in einem Bucket und durchsuchen ihn, nachdem etwas bereits kaputtgegangen ist. Wir setzen den Stream an die Arbeit. Einfache Regeln entfernen zuerst das bekannte Rauschen, dann wird alles, was übrig bleibt, von Routern, Switches, Firewalls, Storage-Arrays und Servern, beim Eintreffen von KI-Modellen analysiert, die auf einem Verbund unserer eigenen NVIDIA-A100-GPUs laufen, in unserem eigenen Rechenzentrum.
Die Modelle lesen geräteübergreifend, nicht eine Logzeile nach der anderen: Ein Storage-Pfadfehler, eine flatternde Schnittstelle und eine steigende Temperatur im selben Rack werden zu einer Geschichte statt zu drei unzusammenhängenden Meldungen. Sie erkennen die Muster, die eine statische Regel nie erkennen wird, die langsame Drift und die ungewöhnliche Kombination, die einem Ausfall vorausgeht, und jeder Alarm erreicht den Ingenieur mit einer bereits angehängten zweiten Meinung. Maschinendaten hören auf, ein Haufen Text zum Durchsuchen zu sein, und werden zu einer Frühwarnung.
Nichts davon verlässt unser Netzwerk. Die Modelle, die GPUs und die Daten gehören alle uns, und keine Logzeile wird je an einen externen KI-Dienst gesendet.
Ein CTO, der uns bewertet, darf gern nach der Zugriffsliste, dem Runbook und dem Alarm-Routing fragen. Wir zeigen Ihnen alle drei.
Ersatzteile vor Ort
Ersatzteile, bis hin zu ganzen Chassis, liegen im selben Cage wie die Maschinen, die sie brauchen werden, nicht in einem Liefervertrag eines Herstellers.
Ein Ersatzteil verdient sich seinen Platz in diesem Regal nicht dadurch, dass es ankommt. Laufwerke kommen auf eine Testbank, werden auf das Sektorformat des Arrays, dem sie dienen sollen, low-level-formatiert und erst eingelagert, wenn sie null gewachsene Defekte und keine unkorrigierten Lese-, Schreib- oder Verifizierungsfehler melden. Ein Ersatzteil, das in der Nacht ausfällt, in der man es braucht, war nie ein Ersatzteil.
Früh ersetzen, rechtzeitig aufrüsten
Hardware wird hier auf Grundlage von Belegen ausgemustert, nicht erst beim Ausfall.
Kritische Schwachstellen, noch am selben Tag. Wenn eine Schwachstelle höchster Stufe in etwas offengelegt wird, worauf wir angewiesen sind, bauen wir gepatchte Pakete am selben Tag, an dem die Korrektur veröffentlicht wird. Schützende Konfiguration kommt sofort drauf. Wenn es für die Plattform, die wir betreiben, noch kein korrigiertes Paket gibt, bauen wir es selbst, kompiliert in einem sauberen Container aus der eigenen Spezifikation des Maintainers, gegen die veröffentlichte Quelle des Projekts verifiziert, Host für Host installiert, mit Prüfungen vorher und nachher. Als das zuletzt nötig war, war die Korrektur etwa drei Stunden nach Veröffentlichung der Quelle in Produktion. Aus demselben Grund betreiben wir unseren eigenen Paket-Mirror.
Dokumentation als Infrastruktur
Viele Unternehmen haben Dokumentation. Wir behandeln sie als Teil der Anlage.
Jedes Kabel trägt eine eindeutige gedruckte Kennung aus einem einzigen Register, das dieselbe Nummer nicht zweimal ausgeben kann und nie eine wiederverwendet, auch nicht, nachdem das Kabel gezogen wurde. Das Etikett nennt beide Enden, Rack, Gerät und Port an jedem. Zweiundzwanzig Jahre Verkabelung lassen sich noch immer vom Etikett zum Eintrag zum Switch-Port und zurück verfolgen.
Ein Dienst ist nicht fertig, wenn er funktioniert. Er ist fertig, wenn seine Adresse, seine Firewall-Regel, sein Inventareintrag und sein Forward- und Reverse-DNS alle existieren und von außerhalb unseres Netzwerks verifiziert wurden.
Unsere Werkzeuge verweigern den Befehl, wenn die Regel nicht erfüllt ist, was ein besserer Schutz ist als gute Vorsätze.
Das ist es, was um drei Uhr nachts zählt. Die Frage ist dann nie, was die clevere Lösung ist. Sie lautet: Was hat sich geändert, und wie stellen wir es wieder her.
Zertifiziert, und auditiert
Alle vier wurden im September 2026 von einer national akkreditierten Zertifizierungsstelle ausgestellt, mit dem Geltungsbereich «Managed datacenter hosting service». Das ist der Dienst, den Sie tatsächlich kaufen, nicht eine Ecke des Unternehmens, die ausgewählt wurde, um ein Audit leicht zu machen.
Ihre Daten bleiben dort, wo Sie sie hingelegt haben, und an unseren europäischen Standorten heißt das: in der EU, auf Hardware in unserem Eigentum, ohne Public Cloud darunter. Wir unterzeichnen einen Auftragsverarbeitungsvertrag, und unser Dokument zu den technischen und organisatorischen Maßnahmen ist auf Anfrage erhältlich.
Ingenieure, keine Stufen
Keine Bots, und keine vorgefertigte erste Antwort.
Die Ingenieure, die die Hardware auswählen, einbauen, verkabeln und beschriften, sind dieselben Ingenieure, die Ihr Ticket beantworten, und sie unterschreiben es mit ihrem eigenen Namen. Das funktioniert, weil die Menschen hier Ihre Konfiguration beim Namen kennen und erfahren genug sind, kein Skript zu brauchen.
Über unsere gesamte Ticket-Historie liegt unsere mediane erste Reaktionszeit bei drei Minuten, und 87 Prozent der Tickets werden innerhalb einer Stunde gelöst. Ein guter Teil wird von uns eröffnet statt von Ihnen: Unser Monitoring beobachtet rund um die Uhr alles, wofür wir verantwortlich sind, bis hinunter zu Ihren tatsächlichen Seiten, und Alarme landen in einem Kanal, den Ingenieure lesen.
Noch immer dieselben
Gleiche Standards. Gleiche Ingenieursarbeit mit eigenen Händen. Noch immer keine Investoren, noch immer kein Exit-Plan, und noch immer die Regel, mit der wir in einem Colocation-Saal in Amsterdam angefangen haben: Kauf die bessere Maschine.
Wir bieten begleitete Besuche im Rechenzentrum Athen: der Cage, die Glasfaser, die Optiken in ihren Trays, die Ersatzteile im Regal. Wir führen Sie selbst hindurch, weil wir diejenigen sind, die es gebaut haben. Bringen Sie einen Ingenieur mit.
Ihr nächster Infrastrukturpartner
Möchten Sie es sehen?
Erzählen Sie uns, was Sie betreiben. Ein Ingenieur antwortet, und der Besuch im Rechenzentrum geht auf uns.
+357 222 32280
Beginnen wir mit Ihrer Umgebung.
Ein wenig Kontext hilft uns, das richtige Gespräch zu beginnen.