

Cosa facciamo · Storage e compute: Disaster recovery e repliche tra siti
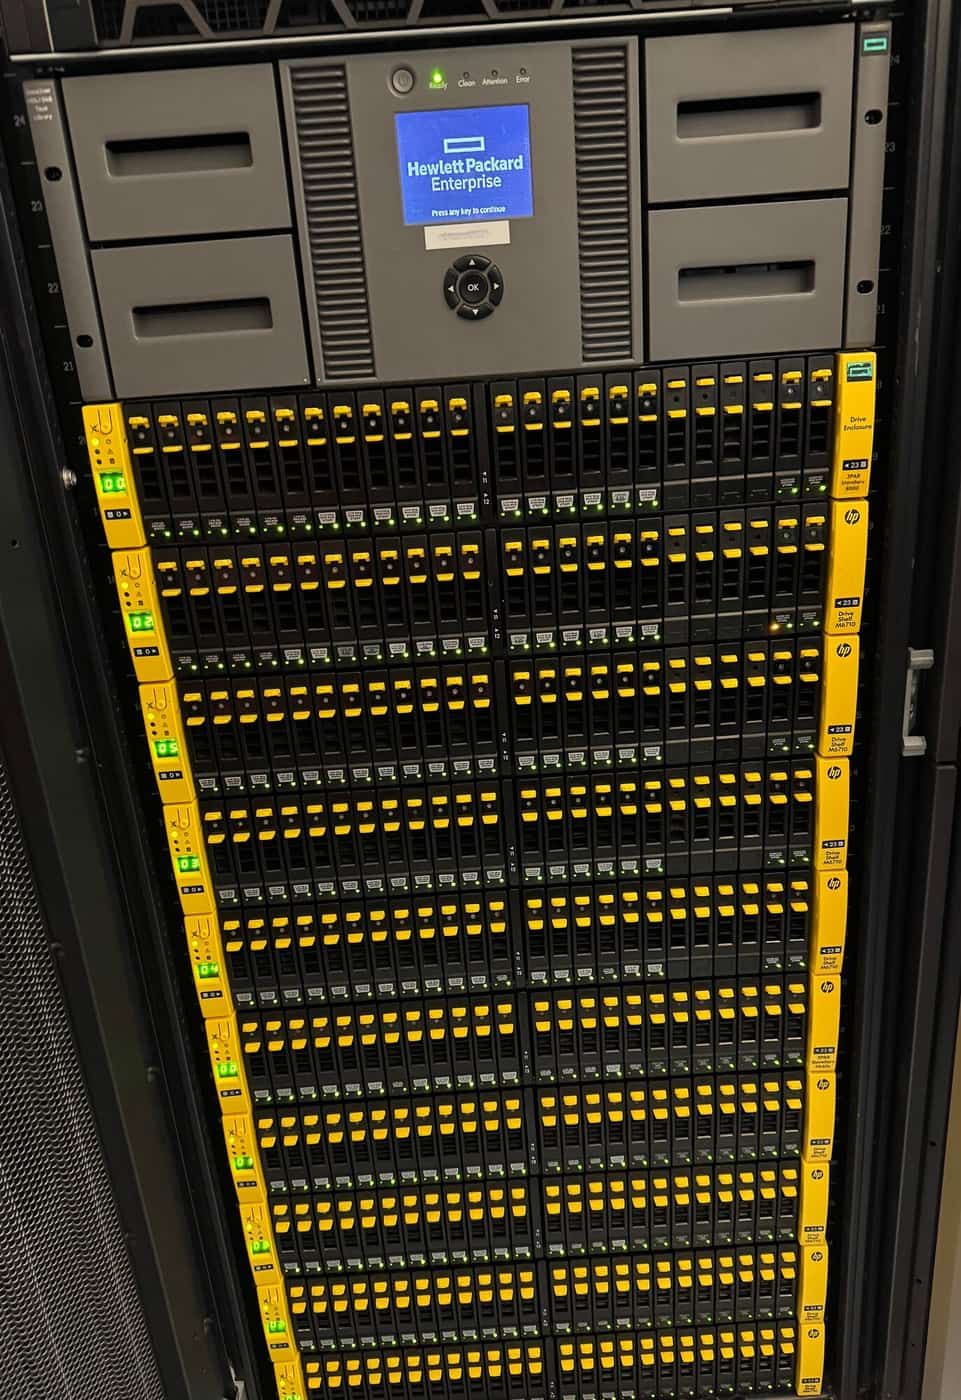
Per i sistemi critici manteniamo una copia aggiornata di continuo in un secondo sito, così il ripristino è un failover e non un restore, e progettiamo il percorso di replica, la postura del firewall intorno a esso e il monitoraggio che ci avvisa nel momento in cui la copia resta indietro.
Cos'è
Un progetto di ripristino commisurato al servizio che ordinate. Un servizio piccolo e semplice riceve backup solidi e una via di ritorno collaudata. Una piattaforma che non può fermarsi riceve repliche live in un altro datacenter, storage replicato tra array e un front end che continua a servire mentre il back end si riprende. Il recovery point e il recovery time seguono il servizio, e i vostri li mettiamo per iscritto.
Come lo costruiamo
Repliche live dei database in un secondo sito. Un database di produzione replica in continuo, per global transaction ID, verso una replica in sola lettura in un altro datacenter, attraverso il nostro backbone privato cifrato.
Pull-only, imposto sul firewall. Il lato protetto non fa mai push. I sistemi di replica e di backup entrano in produzione e prendono ciò che serve, e i backup vengono effettuati attraverso la nostra rete out-of-band completamente isolata (air-gapped), mai attraverso un segmento di produzione; la produzione non ha alcun percorso di rete verso di essi né credenziali per raggiungerli. Solo la nostra rete di gestione può raggiungere i sistemi di ripristino, e tutto il resto è esplicitamente negato sulle appliance firewall, non soltanto sugli host.
Storage replicato tra paesi. Sotto, i volumi possono replicare array verso array tra array HPE 3PAR ad Atene e Amsterdam, su porte dedicate, così una copia a livello di blocco della vostra piattaforma esiste già nell'altro datacenter. All'interno di ogni sito, i sistemi in cluster tengono ogni membro su un array fisico diverso.
I dati UE restano nell'UE. Repliche e backup dei dati ospitati nell'UE restano all'interno della nostra infrastruttura europea.
Cifrati a riposo, cancellati con certificato. La cifratura a riposo è disponibile per impostazione predefinita. I dischi che escono dal servizio vengono sanificati con Blancco, e conserviamo il certificato PDF di cancellazione per ogni disco che cancelliamo.
Attenti al drift. Lo stato della replica viene controllato ogni pochi minuti, e ogni cambiamento di stato, interrotta, in ritardo o ripristinata, genera un allarme agli ingegneri di turno.
Servire durante un'interruzione del back end. Per le proprietà web pubbliche, lo strato di cache è configurato per continuare a servire contenuti quando il livello applicativo è giù, così un guasto del back end non diventa un'interruzione pubblica mentre ripristiniamo.
I backup sotto a tutto
Eseguiamo il backup di macchine virtuali, server bare metal Linux e Windows, server SQL e nodi cPanel e Plesk con Veeam, e dei dati file e database Linux con un hub di backup deduplicante che preleva via SSH usando chiavi limitate e append-only. I repository girano su XFS con fast cloning e un livello di repository blindato che riceve i job di copia. Le pianificazioni sono definite dai tempi di esecuzione misurati, così i job grandi non collidono mai; la copertura è verificata contro l'inventario reale, non dedotta dallo stato dei job; e i restore sono testati regolarmente, anche ogni settimana.
Da cosa vi protegge
- Perdere l'host primario del database o il sito primario.
- Un ransomware o un intruso che cancella i backup dal server compromesso.
- Il drift delle repliche: lo stato di ogni replica è controllato ogni pochi minuti.
- Un'interruzione dell'applicazione che diventa un'interruzione pubblica.
- Lacune nella copertura dei backup: ogni macchina che deve essere salvata lo è, e lo verifichiamo contro ciò che è in esecuzione.
In pratica
Un sito di notizie che ha continuato a servire con il back end spento. Per un editore di notizie abbiamo configurato il livello di cache per servire contenuti stale in caso di errore per un giorno intero, poi lo abbiamo dimostrato: il back end è stato marcato come guasto di proposito e le pagine in cache hanno continuato a tornare normalmente ai lettori.
Un cluster di database progettato per perdere un array. Per un cliente di analytics, il volume dati di ogni membro del cluster risiede su un array fisico diverso, così la perdita di un intero array costa una replica e il database continua a servire senza alcun failover.
Perché EuroVPS
- Backup e replica pull-only, imposti sul firewall, senza eccezioni.
- Ripristino progettato e documentato per ogni servizio.
- Repliche e backup monitorati per freschezza, non dati per scontati.
- Replica array verso array tra Atene e Amsterdam, con i dati UE mantenuti nell'UE.
- Progetto allineato alle indicazioni di ISO 27001, NIS2 e NIST sulla protezione dei perimetri.
Domande frequenti
- Quali RPO e RTO ottengo? Dipende dal servizio che ordinate. I servizi di base ricevono backup e un percorso di restore definito; i servizi con copertura tra siti ricevono repliche live e failover. I vostri li mettiamo per iscritto.
- Perché pull-only? Se la produzione potesse fare push verso il backup, un attaccante in produzione potrebbe raggiungere il backup. Con il pull-only quel percorso non esiste.
- La mia replica può risiedere in un altro paese? Sì. Atene e Amsterdam replicano l'una verso l'altra, array verso array e database verso database, sulla nostra rete privata. I dati ospitati nell'UE restano nella nostra infrastruttura europea.
- Testate i restore? Sì, regolarmente, anche ogni settimana, e verifichiamo la copertura contro ciò che è davvero in esecuzione, non contro ciò che dice il job di backup.
- I miei dati sono cifrati a riposo? Sì, per impostazione predefinita. E quando un disco esce dal servizio viene sanificato con Blancco, con un certificato di cancellazione conservato per quel disco.
- closing line: Il ripristino si progetta prima del giorno brutto, non durante. Parlate con un ingegnere di ciò di cui i vostri servizi hanno bisogno.
- CTA: Parla con un ingegnere
Il vostro prossimo partner per l'infrastruttura
Guardiamo la vostra infrastruttura.
Raccontateci cosa fate girare oggi e cosa deve migliorare. Un ingegnere esaminerà la vostra richiesta e vi aiuterà a pianificare il passo successivo.
+357 222 32280
Partiamo dalla vostra infrastruttura.
Un po' di contesto ci aiuta a iniziare la conversazione giusta.