Il blog di EuroVPS
Note dal campo.
Dalla sala macchine.
Decisioni, indagini e lezioni dalla gestione di infrastrutture di produzione. Scritte dalle persone che se ne prendono cura.
L'archivio
Altro dal team.
Una migrazione è un progetto, non un ticket.
Il gruppo di testate ad alto traffico di un grande editore doveva cambiare datacenter, ed è stato riprogettato per scalare lungo la strada verso il nostro bare metal. Abbiamo progettato la piattaforma, l'abbiamo testata sotto carico e abbiamo fatto il cutover in un'operazione di due ore con una finestra visibile di circa cinque minuti e un percorso di rollback su ogni fase.
Coerenza read-after-write su un cluster Galera
Un cluster Galera o Percona XtraDB certifica una scrittura al commit e la applica sugli altri nodi un attimo dopo, e una lettura instradata in quell'intervallo vede il passato.
Hanno smesso di chiamarci quando qualcosa si rompe.
I clienti hanno smesso di chiamarci quando qualcosa si rompe e hanno iniziato a chiamarci per costruire quello che viene dopo: release engineering, ambienti di staging, accesso sicuro e migrazioni gestite come progetti riempiono ormai la nostra coda di ingegneria. La prova non è una testimonianza. È il lavoro stesso.
Export e mount NFS che falliscono in sicurezza
I default di NFS che mordono i contenuti condivisi: export aperti, accesso root, soft mount e blocchi al boot, più le impostazioni e i controlli che li risolvono.
Un backup GitLab che non si può ripristinare è solo un file grande
L'archivio di backup di GitLab esclude i file che lo rendono ripristinabile. Cosa copiare accanto a lui, come tirarlo in sicurezza, e come dimostrare che un restore funziona.
503 o 403 istantaneo: guardate prima sopra l'applicazione
Una pagina di errore che arriva senza alcuna latenza è stata servita prima che la vostra applicazione girasse, quindi la checklist parte dall'edge e scende fino al codice per ultimo.
Come vengono compromessi davvero i siti, e come non essere il bersaglio facile.
Nella sicurezza, la causa presunta dal cliente è di solito «non c'è niente che non va». Ecco come vengono compromessi davvero i siti, perché la cima della lista è prevenibile, e come dimostriamo che una porta è chiusa prima di dichiararla chiusa.
Uno switch può morire e il vostro storage continua a servire
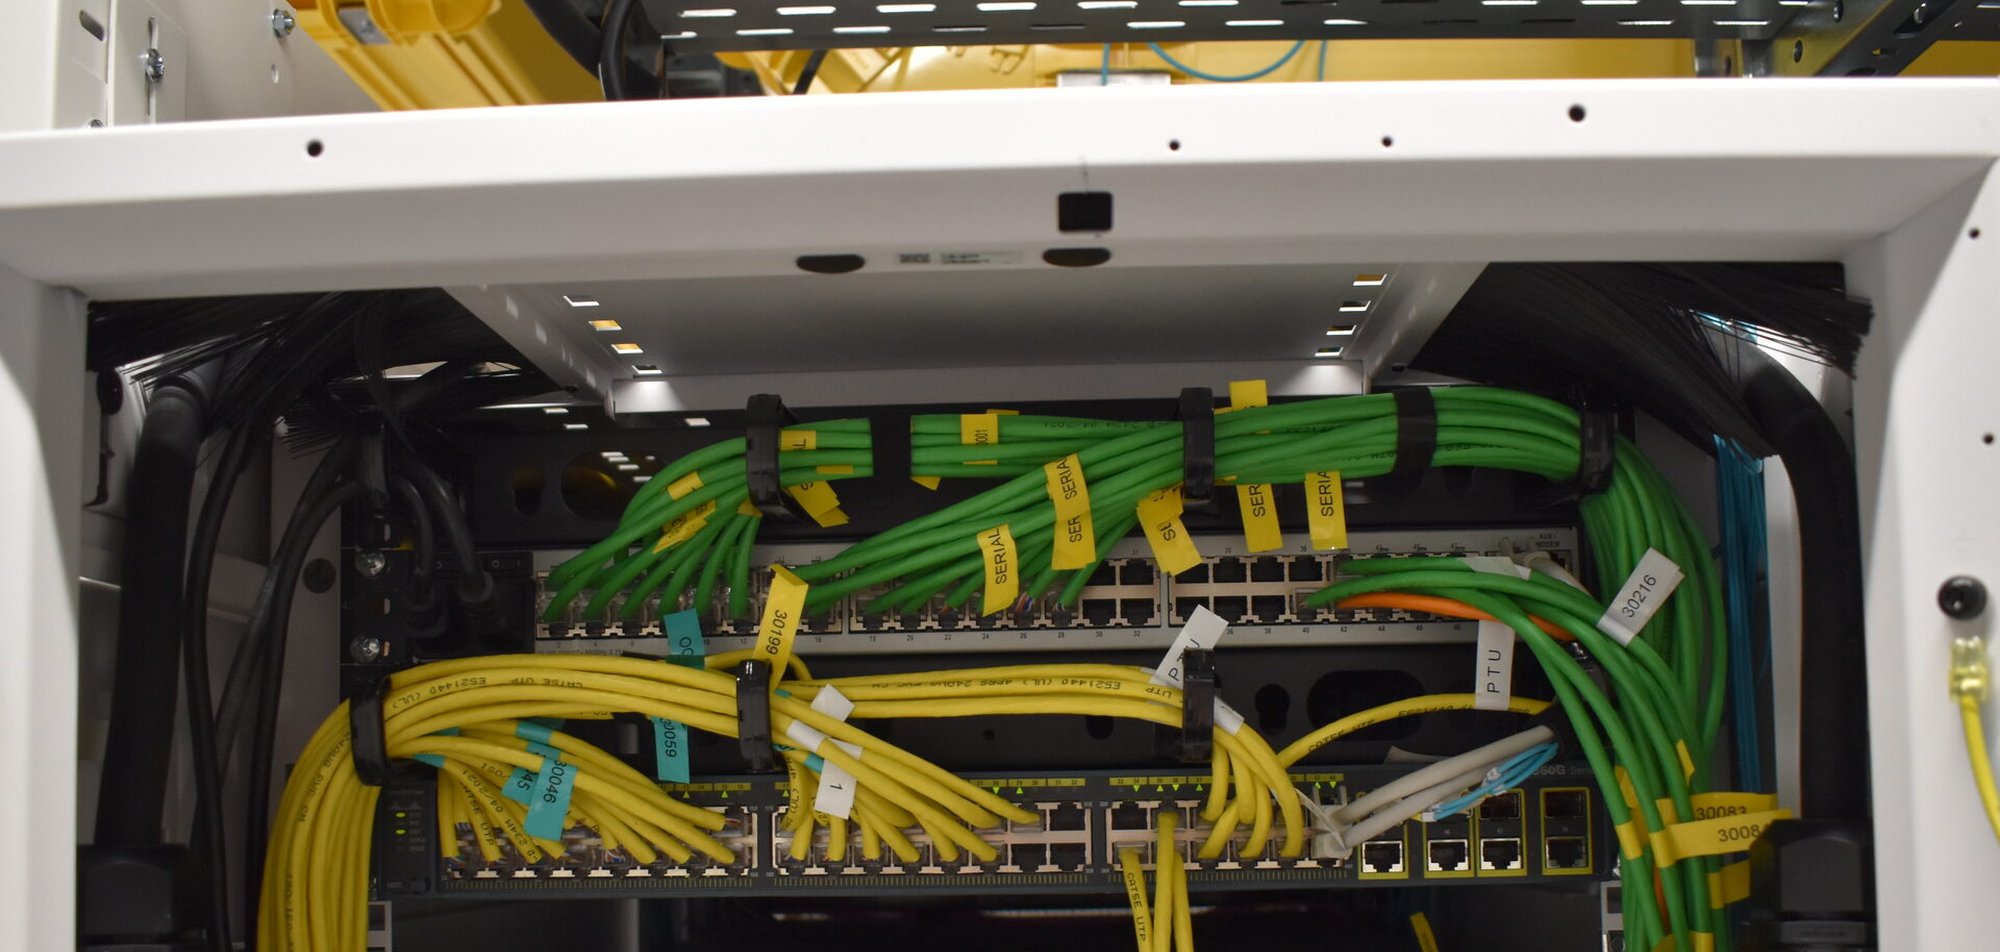
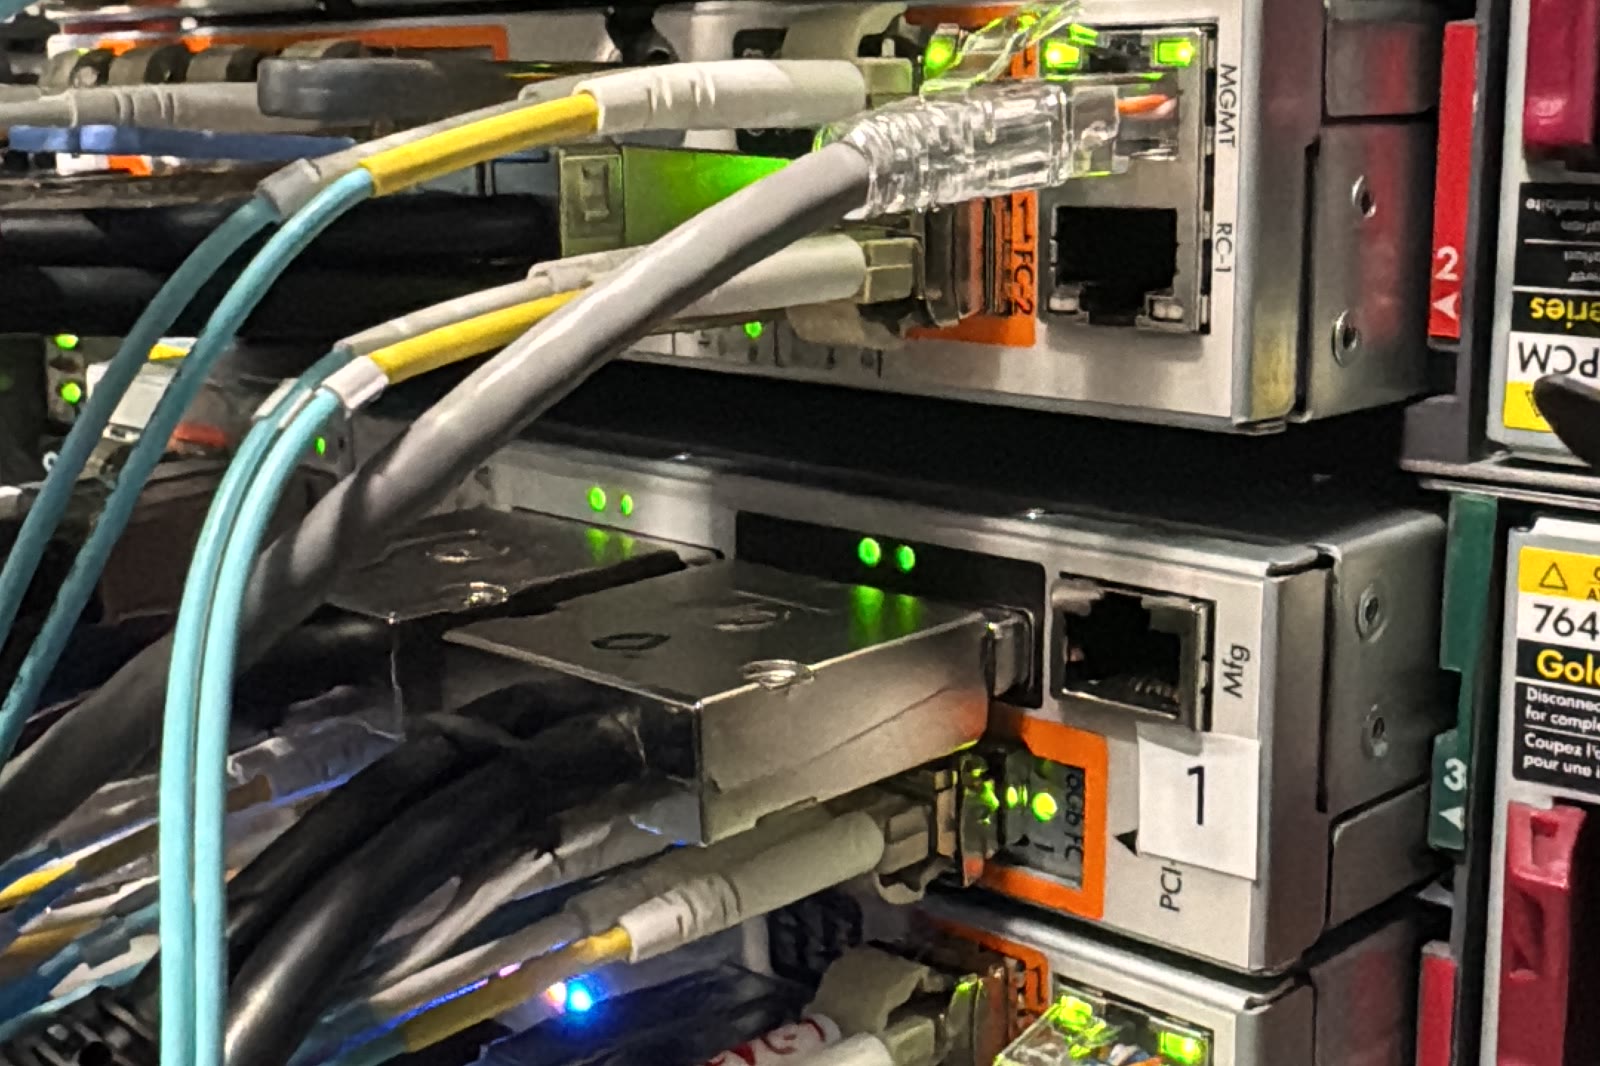
Cosa vi dà il multipath su due fabric Fibre Channel indipendenti, perché il RAID dentro un server protegge molto meno di quanto sembri, e perché la manutenzione su un fabric non è un evento per il carico di lavoro.
Il vostro provider dovrebbe aprire il ticket per primo.
Sul nostro desk, molti ticket li apriamo noi, dal monitoraggio e dal rilevamento di sicurezza, prima che il cliente segnali qualcosa. Le quattro mosse di un team che agisce in prima linea, e il confine che rende «fully managed» un modello descritto invece di un aggettivo.
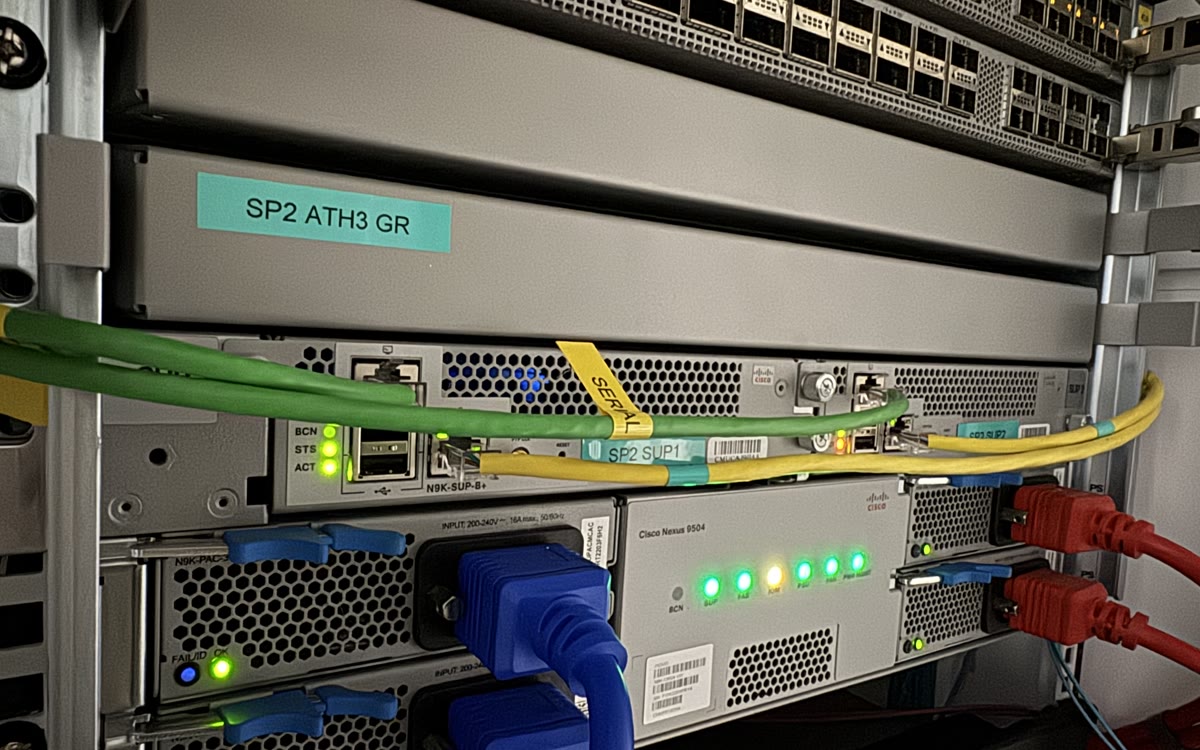
Due circuiti, un router. DMVPN dual-cloud che usa entrambi i collegamenti
Costruite un secondo cloud DMVPN con tunnel key, fate girare BGP multipath su entrambi i circuiti WAN, e dimensionate la capacità cifrata a partire dal crypto engine, non dalla licenza.
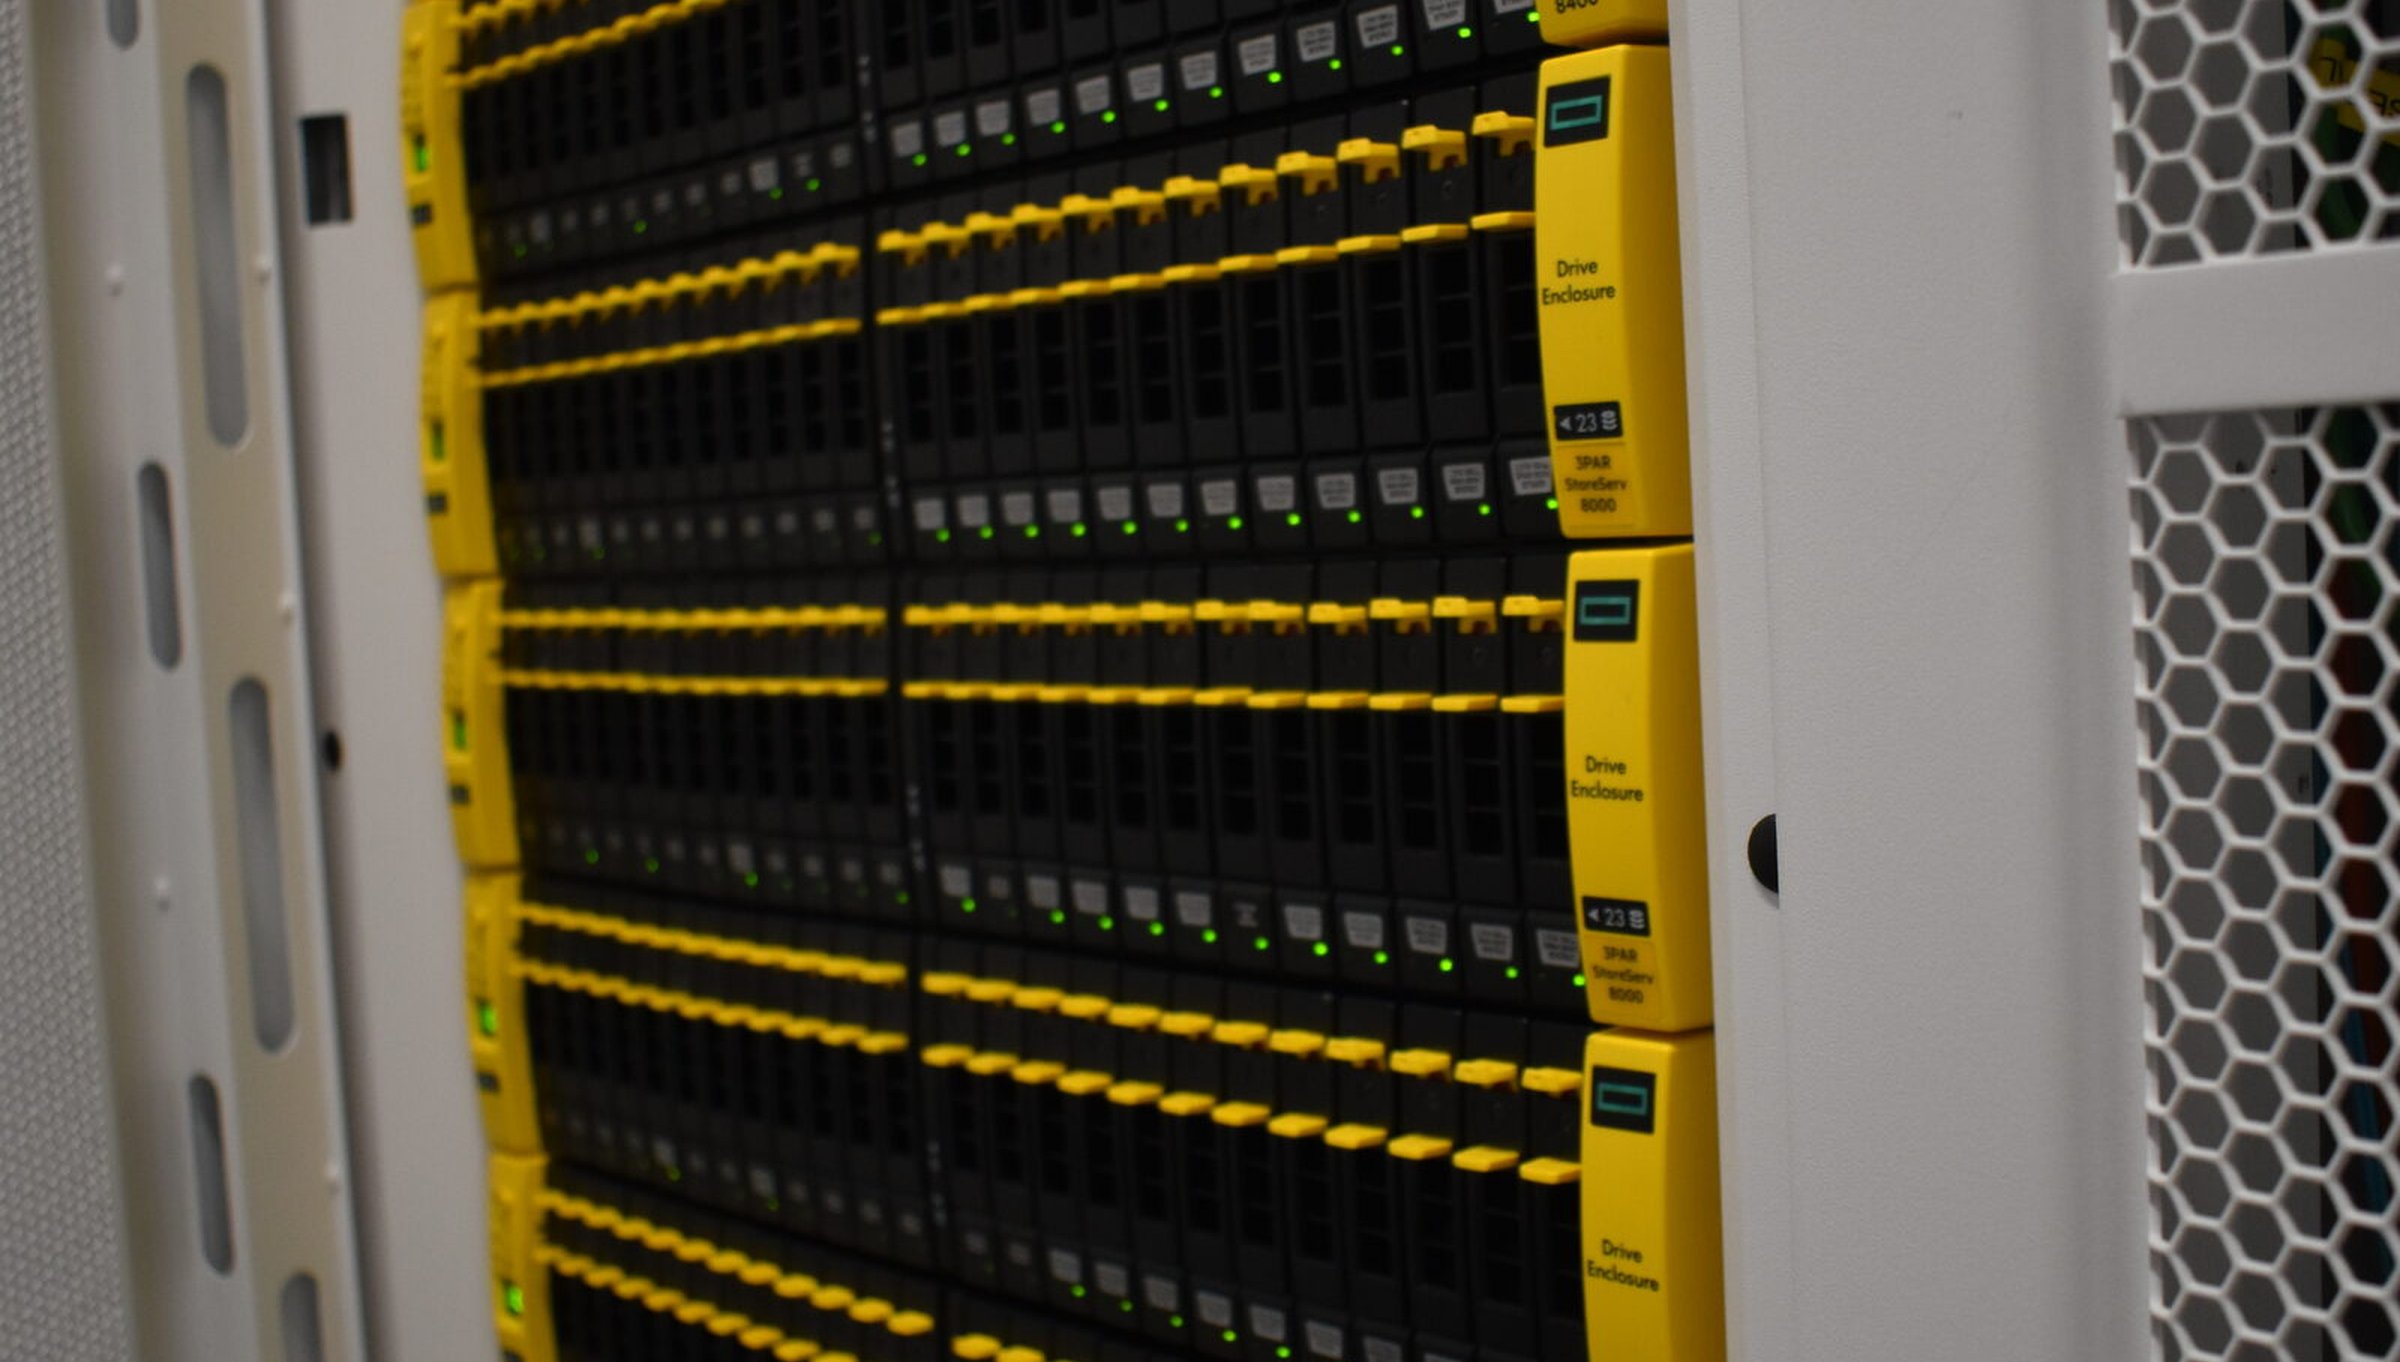
Perché abbiamo standardizzato su HPE 3PAR all-flash
Una sola famiglia di array, scelta e padroneggiata, batte un menu di vendor con livelli di storage. L'argomento della standardizzazione per lo storage, con l'architettura, dagli atti pubblici, come ricevuta.
Cercare in decenni di email: prima le parole chiave, poi il significato
Cercare in un archivio email funziona se i dati sono puliti: dedup, thread, testo citato separato, due indici combinati e una citazione per ogni risposta.
Finestre di manutenzione: cosa si fa sotto carico invece
Gran parte del lavoro pianificato su infrastruttura ridondante avviene mentre questa serve. Le modifiche che richiedono una finestra sono progettate, delimitate e concordate prima con voi.
L'aritmetica della state table: dimensionare un firewall per i flood, non per le medie
La state table si riempie prima della banda: la legge di Little, timeout adattivi, SYN cookie, regole stateless per l'UDP ad alto volume.
ERR_TOO_MANY_REDIRECTS dietro un CDN: le due impostazioni che fanno loop insieme.
Il redirect loop che non lascia nulla nell'access log: un SSL mode del CDN che raggiunge l'origin in HTTP, e un redirect sull'origin che non è proxy-aware. Riproducetelo con una richiesta e correggete entrambi i capi.
Come testare un restore, non solo un backup
Un job di backup verde prova che il job è girato. Un test di restore prova che potete recuperare: controlli di copertura, tre livelli di restore, un lab isolato, i tempi.
Limitate il percorso costoso, non il crawler
Trovate gli URL che costano lavoro reale al vostro sito, poi limitate lì i crawler con le stick table di HAProxy e un 429, senza danneggiare la ricerca o i visitatori.
Perché un account root compromesso significa ricostruire il server, non pulirlo.
Su Unix, root è un numero, non un nome. Un account UID 0 senza log di creazione non è stato fatto con alcuno strumento, è stato scritto a mano nel file degli utenti. Come trovarlo, perché un singolo controllo superato non è una prova, e perché root per qualsiasi finestra di tempo significa ricostruire, non ripulire.
Il nostro prezzo non cambia quando cambia il vostro traffico.
Egress per gigabyte, assistenza per livelli, burst prezzato solo dopo che è successo. Ecco come si legge la vostra fattura una volta che la macchina sotto è vostra.
Non fermatevi al primo guasto.
La modalità di guasto che questo post uccide: il vostro sito collassa, qualcuno trova un guasto plausibile, lo sistema, dichiara vittoria, e il sito resta giù. Nei giorni peggiori ci sono altri quattro guasti dietro il primo. Ecco il metodo per districarli, una regola alla volta, con l'indizio che smaschera ciascun tipo di guasto.
Ogni integrazione tra sistemi di ticket consegna due volte. Costruitela per questo.
Webhook che ritentano, partner che reinviano, reti che perdono risposte. Come costruire un bridge tra sistemi di ticket firmato, idempotente, senza loop e con permessi limitati, con codice che potete riutilizzare.
I più letti
Le guide a cui i lettori tornano- 0110 motivi per cui il vostro sito si carica lentamente (e come risolverli)
- 02Importanti file di log Linux da monitorare su RHEL 9 e 10
- 03Configurare WordPress Multisite con nginx e PHP-FPM su RHEL 9 e 10
- 04Archimede e il paranco: come un uomo mosse una nave
- 05Guida completa ai codici di stato HTTP: la serie 300
- 06Guida completa ai codici di stato HTTP: la serie 400
- 07Quanta RAM, CPU, storage e IOPS servono davvero al vostro VPS?
Mettete la lettura al lavoro
Avete in mente un carico di lavoro?
Partite dai numeri.
Gli strumenti di dimensionamento trasformano i vostri requisiti in una configurazione proposta e in una fascia di prezzo indicativa. Un ingegnere può aiutarvi a valutare cosa fa al caso vostro.