

Infrastruttura GPU gestita: Il vostro modello.
La vostra macchina.
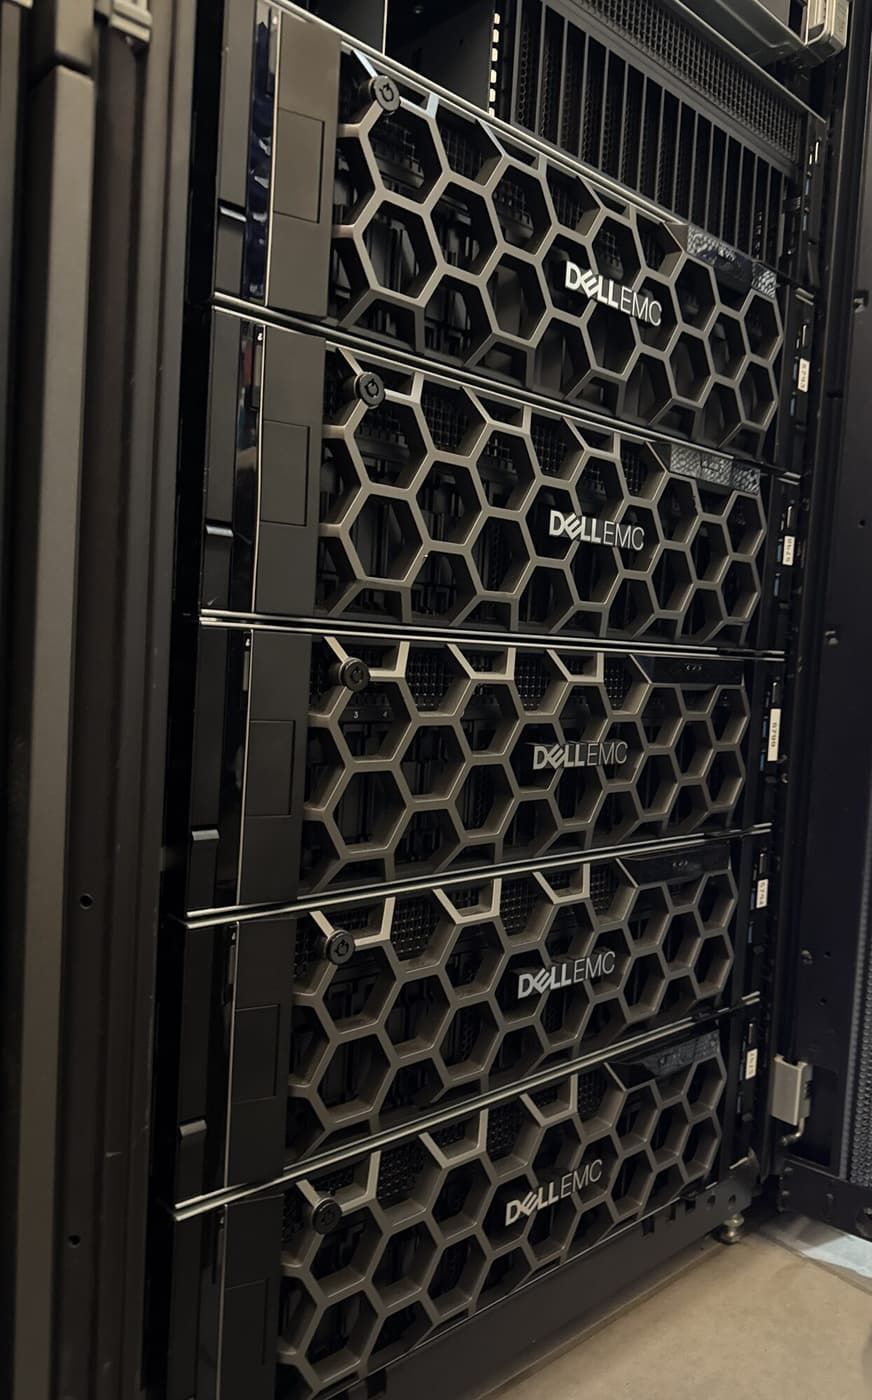
GPU dedicateCapacità riservata a voi
Un endpoint privatoAccesso progettato intorno alla vostra applicazione
Atene e AmsterdamDigital Realty, nell'UE
Gestita da ingegneriDalla messa in produzione alle operazioni
L'hardware
Qualsiasi GPU possiamo acquistare.
Nel nostro datacenter entro 48 ore.
NVIDIA L4, L40, L40S, A100, H100 e il resto della gamma attuale, dimensionate sul modello e sul carico di lavoro. Le vostre GPU private, nei nostri datacenter Digital Realty ad Atene e Amsterdam, nell'UE.
Modello e macchina, considerati insieme
Un modello. Una macchina.
Un piano.
Esplorate alcuni punti di partenza per un endpoint privato. Concordiamo il modello esatto, i requisiti di serving e l'hardware intorno a ciò che dovete far girare.
Una connessione privata al modello su infrastruttura dedicata.
Architettura illustrativaUn punto di partenza per la conversazione
Llama
- Il modello
- Un modello testuale di classe 70B, release corrente concordata con voi. Lo valutiamo rispetto alle esigenze di lingua, qualità e tempi di risposta della vostra applicazione.
- Il dimensionamento
- Testiamo insieme precisione, lunghezza del contesto e richieste concorrenti prima di scegliere la capacità GPU e la configurazione di serving.
- Versione e termini
- Llama è distribuito con la community license di Meta, che ha le proprie condizioni di uso e di scala; confermiamo che la release esatta sia adatta al vostro uso prima della messa in produzione.
Un punto di partenza per la conversazione
Mistral
- Il modello
- Un modello di dimensioni medie, release corrente concordata con voi, è un'opzione da valutare per un assistente privato o un endpoint applicativo.
- Il dimensionamento
- Concordiamo la precisione e il contesto di cui avete bisogno, poi testiamo il carico di serving. La dimensione del modello da sola non garantisce la compatibilità con la GPU.
- Versione e termini
- Mistral pubblica alcuni pesi con licenza Apache 2.0 e altri con i propri termini di ricerca o commerciali; confermiamo quale si applica alla release che scegliete.
Un punto di partenza per la conversazione
Qwen
- Il modello
- Una famiglia di modelli di varie dimensioni. Scegliamo una release specifica da testare sulla vostra applicazione, anziché dimensionare l'hardware sul nome della famiglia.
- Il dimensionamento
- Partite dal modello selezionato e dai vostri prompt. Contesto, precisione e obiettivi di traffico guidano la configurazione finale.
- Versione e termini
- Esaminate i termini del modello e della dimensione esatti. La model card del 72B collegata è un esempio, non una licenza per l'intera famiglia.
Progettato insieme a voi
DeepSeek
- Il modello
- Un grande modello mixture-of-experts, release corrente concordata con voi. Richiede un'architettura di serving ragionata e una valutazione del carico di lavoro.
- Il dimensionamento
- Progettato insieme a voi. Valutiamo memoria GPU, interconnessioni e opzioni di deployment prima di concordare una configurazione o un prezzo.
- Versione e termini
- I termini del modello sono separati dalla licenza del codice del repository. Esaminate la release scelta prima della messa in produzione.
Un punto di partenza per la conversazione
Non ancora deciso
- Il modello
- Partite da ciò che l'applicazione deve fare. Vi aiutiamo a selezionare una rosa di modelli da testare sui vostri prompt e documenti.
- Il dimensionamento
- Esaminiamo con voi qualità delle risposte, tempi di risposta e traffico atteso, poi concordiamo insieme modello e hardware.
- Versione e termini
- La rosa include le versioni esatte dei modelli e i loro termini, così la decisione di deployment si prende con i dettagli sotto gli occhi.
Configurazione finale e prezzo concordati dopo il dimensionamento.
L'ingegneria è parte del servizio
Noi facciamo l'ingegneria.
Voi chiamate un endpoint.
Un solo team per l'hardware, lo stack di serving e l'operatività quotidiana. Voi portate il carico di lavoro; noi lavoriamo ai dettagli insieme a voi.
Conosci il tuo team di assistenzaUn modello e una macchina che si adattano
Esaminiamo modello, memoria e concorrenza attesa, poi testiamo la configurazione proposta con i vostri prompt.
Lo stack di serving, configurato
Driver GPU, runtime di inferenza e configurazione dell'endpoint. I nostri ingegneri si occupano dell'infrastruttura intorno al vostro modello.
Accesso alle vostre condizioni
Un endpoint privato con accesso di rete e logging configurati intorno alle vostre applicazioni e ai vostri requisiti sui dati.
Gestito oltre il deployment
Il team che configura la macchina resta responsabile delle operazioni, indagando sui problemi lungo tutto l'host e lo stack di serving.
Aggiornamenti, con un piano
Mantenete una versione scelta del modello, poi validiamo le modifiche e concordiamo la finestra di aggiornamento prima di passare alla successiva.
Capacità che segue la domanda
Esaminiamo con voi memoria, lunghezza del contesto e concorrenza man mano che l'uso cresce, e aggiungiamo GPU o un secondo host quando i numeri lo dicono.
Cosa farete girare?
Quattro carichi di lavoro illustrativi. Modelliamo il modello, l'accesso privato e la capacità intorno alla vostra applicazione.
RAG su documenti privati
Portate retrieval e inferenza su un'infrastruttura gestita. Costruite risposte a partire da documenti approvati, con citazioni che rimandano alla fonte.
- Modello, embedding e database vettoriale insieme
- Accesso ai documenti via VPN o rete privata
Un assistente interno
Date al vostro team un assistente sulla conoscenza interna approvata, con accesso e logging dei prompt configurati intorno alla vostra organizzazione.
- Inferenza dedicata per il vostro team
- Logging e conservazione concordati con voi
Funzionalità AI nel vostro prodotto
Servite le risposte del modello attraverso un endpoint chiamato dalla vostra applicazione. Concordate la versione del modello e dimensionate la capacità su prompt reali e domanda attesa.
- Inferenza sulla vostra infrastruttura GPU gestita
- Capacità e concorrenza testate per la vostra applicazione
Assistenza al codice su sorgenti private
Fate girare un modello per il codice con il contesto dei repository approvati e accesso privato. Tenete inferenza e codice sorgente su un'infrastruttura gestita, con i completamenti restituiti al vostro team.
- File selezionati e codice recuperato come contesto
- Accesso ai repository limitato agli utenti autorizzati
Una installazione AI privata
Cartelle cliniche
analizzate senza lasciare Atene.
Un cliente aveva bisogno di AI per analizzare cartelle cliniche: entrano i fascicoli dei pazienti, esce un report strutturato e con citazioni, e ogni passaggio gira su modelli locali sulle GPU private del cliente dentro Digital Realty Athens. I dati non toccano mai un cloud pubblico.
Prima della messa in produzione
Il modello
è solo l'inizio.
Memoria, accesso, costi e operatività continua. Esaminiamo insieme di cosa ha bisogno il vostro endpoint.
Chiedi a un ingegnereLavoriamo con modelli open-weight tra cui Llama, Mistral, Qwen e DeepSeek. Release esatta, software di serving, esigenze hardware e termini di licenza vengono esaminati per il vostro deployment. Se non avete ancora scelto un modello, possiamo selezionare una rosa di opzioni e testarle sui vostri prompt.
Il vostro prossimo partner per l'infrastruttura
Portateci il modello che
volete far girare.
Raccontateci del vostro modello, dei dati e del carico di lavoro atteso. Lavoriamo insieme a voi su hardware, stack di serving e deployment.
+357 222 32280
Partiamo dalla vostra infrastruttura.
Un po' di contesto ci aiuta a iniziare la conversazione giusta.
Dal team di ingegneria
Il ragionamento dietro l'endpoint.
AI Hosting · 8 min read
A 70B model really does fit on a 48GB card, once you count what quantization costs.
Read the articleAI Hosting · 6 min read
Your AI endpoint doesn't have to be on the internet.
Read the articleAI Hosting · 5 min read