

Керована GPU-інфраструктура: Ваша модель.
Ваша машина.
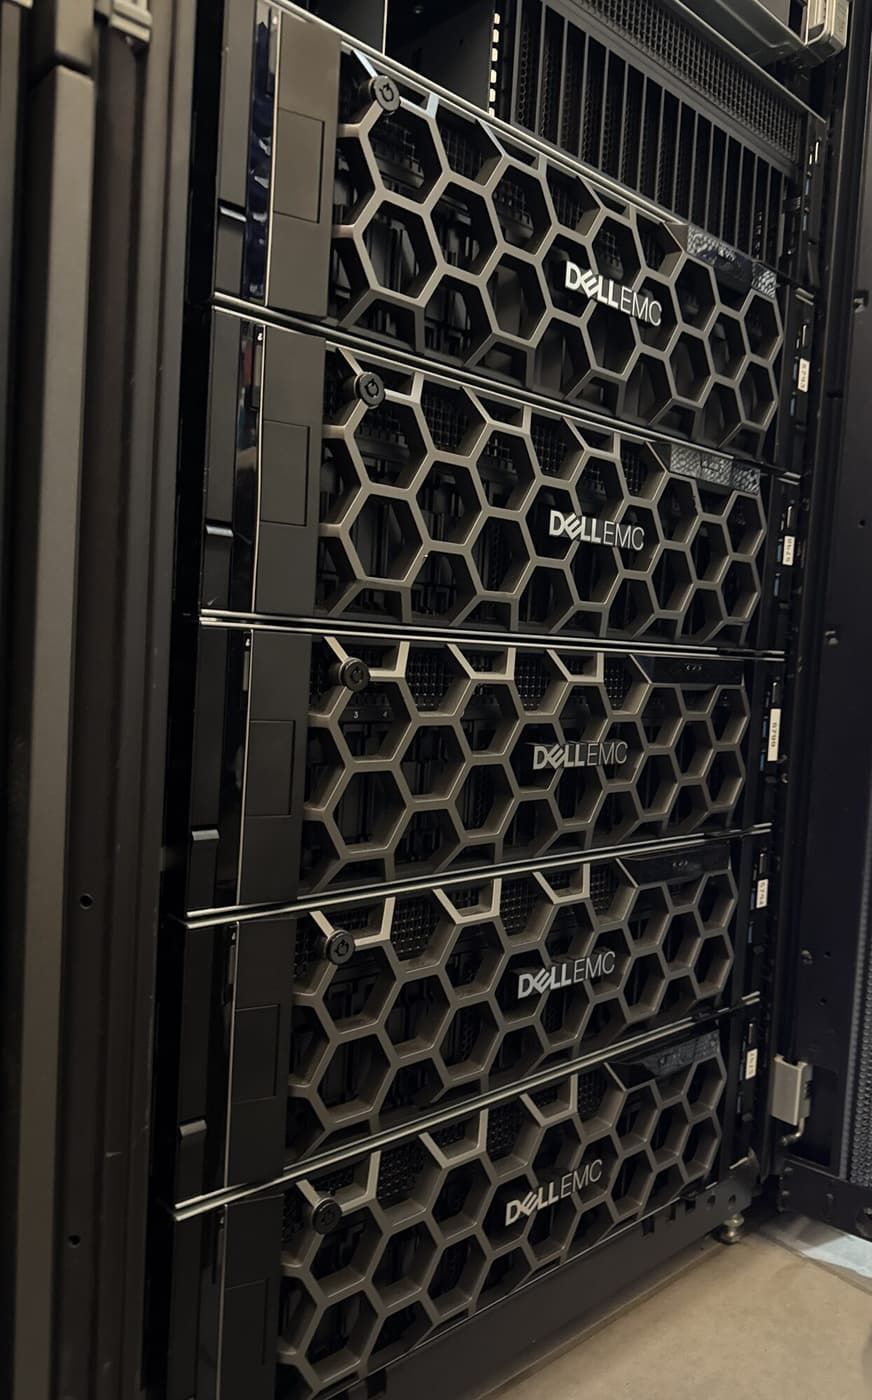
Виділені GPUЄмність, зарезервована для вас
Приватний endpointДоступ, спроєктований під ваш застосунок
Афіни та АмстердамDigital Realty, у межах ЄС
Під керуванням інженерівВід розгортання до експлуатації
Обладнання
Будь-який GPU, який ми можемо купити.
У нашому дата-центрі протягом 48 годин.
NVIDIA L4, L40, L40S, A100, H100 та решта поточного модельного ряду, розраховані під модель і навантаження. Ваші власні приватні GPU в наших дата-центрах Digital Realty в Афінах та Амстердамі, у межах ЄС.
Модель і машина, розглянуті разом
Модель. Машина.
План.
Перегляньте кілька відправних точок для приватного endpoint. Точну модель, вимоги до serving та обладнання ми узгоджуємо під те, що вам потрібно запускати.
Приватне з’єднання з моделлю на виділеній інфраструктурі.
Ілюстративна архітектураВідправна точка для розмови
Llama
- Модель
- Текстова модель класу 70B, поточний випуск узгоджується з вами. Ми оцінюємо її відповідно до вимог вашого застосунку до мови, якості та часу відповіді.
- Підбір конфігурації
- Ми разом тестуємо точність (precision), довжину контексту та одночасні запити, перш ніж обрати GPU-ємність і схему serving.
- Версія та умови
- Llama постачається за community license від Meta, яка має власні умови використання та масштабування. Ми підтверджуємо, що точний випуск відповідає вашому використанню, до розгортання.
Відправна точка для розмови
Mistral
- Модель
- Модель середнього розміру, поточний випуск узгоджується з вами, є одним з варіантів для оцінки як приватний асистент або endpoint застосунку.
- Підбір конфігурації
- Ми узгоджуємо потрібні вам precision і контекст, а потім тестуємо навантаження serving. Розмір моделі сам по собі не гарантує, що вона вміститься на GPU.
- Версія та умови
- Mistral публікує частину ваг (weights) за ліцензією Apache 2.0, а частину за власними дослідницькими або комерційними умовами. Ми підтверджуємо, які саме застосовуються до обраного вами випуску.
Відправна точка для розмови
Qwen
- Модель
- Сімейство моделей різних розмірів. Ми обираємо конкретний випуск для тестування з вашим застосунком, а не підбираємо обладнання під назву сімейства.
- Підбір конфігурації
- Починаємо з обраної моделі та ваших власних prompt. Контекст, precision і цільовий трафік визначають остаточну конфігурацію.
- Версія та умови
- Перевірте умови для точної моделі та розміру. Model card 72B за посиланням є прикладом, а не ліцензією на все сімейство.
Проєктується разом з вами
DeepSeek
- Модель
- Велика модель типу mixture-of-experts, поточний випуск узгоджується з вами. Вона потребує продуманої архітектури serving та оцінки навантаження.
- Підбір конфігурації
- Проєктується разом з вами. Ми оцінюємо пам’ять GPU, з’єднання та варіанти розгортання, перш ніж узгодити конфігурацію або ціну.
- Версія та умови
- Умови моделі є окремими від ліцензії на код репозиторію. Перевірте обраний випуск до розгортання.
Відправна точка для розмови
Ще не знаємо
- Модель
- Почніть з того, що має робити застосунок. Ми допоможемо скласти короткий список моделей для тестування на ваших власних prompt і документах.
- Підбір конфігурації
- Ми разом з вами опрацьовуємо якість відповідей, час відповіді та очікуваний трафік, а потім разом узгоджуємо модель і обладнання.
- Версія та умови
- Короткий список містить точні версії моделей та їхні умови, тож рішення про розгортання ухвалюється з усіма деталями перед очима.
Остаточна конфігурація та ціна узгоджуються після підбору.
Інженерна робота є частиною послуги
Ми робимо інженерну роботу.
Ви викликаєте endpoint.
Одна команда для обладнання, serving-стека та щоденної експлуатації. Ви приносите навантаження, ми опрацьовуємо деталі разом з вами.
Познайомтеся з вашою командою підтримкиМодель і машина, що підходять одна одній
Ми опрацьовуємо модель, пам’ять та очікувану одночасність, а потім тестуємо запропоновану конфігурацію на ваших prompt.
Serving-стек, налаштований
Драйвери GPU, inference runtime та конфігурація endpoint. Наші інженери беруть на себе інфраструктуру навколо вашої моделі.
Доступ на ваших умовах
Приватний endpoint з мережевим доступом і логуванням, налаштованими під ваші застосунки та вимоги до даних.
Керування після розгортання
Команда, яка налаштовує машину, залишається відповідальною за експлуатацію та досліджує проблеми по всьому хосту та serving-стеку.
Оновлення, за планом
Ви зберігаєте обрану версію моделі. Зміни перевіряються, а вікно оновлення узгоджується, перш ніж переходити до наступної.
Ємність, що йде за попитом
Ми переглядаємо з вами пам’ять, довжину контексту та одночасність у міру зростання використання і додаємо GPU або другий хост, коли цього вимагають цифри.
Що ви будете запускати?
Чотири ілюстративні навантаження. Ми формуємо модель, приватний доступ і ємність під ваш застосунок.
RAG над приватними документами
Перенесіть retrieval та inference на керовану інфраструктуру. Будуйте відповіді на основі затверджених документів, з посиланнями на джерело.
- Модель, embeddings і векторна база даних разом
- Доступ до документів через VPN або приватну мережу
Внутрішній асистент
Дайте вашій команді асистента на основі затверджених внутрішніх знань, з доступом і логуванням prompt, налаштованими під вашу організацію.
- Виділений inference для вашої команди
- Логування та зберігання, узгоджені з вами
AI-функції у вашому продукті
Віддавайте відповіді моделі через endpoint, який викликає ваш застосунок. Ми узгоджуємо версію моделі та розраховуємо ємність на реальних prompt і очікуваному попиті.
- Inference на вашій керованій GPU-інфраструктурі
- Ємність і одночасність, протестовані для вашого застосунку
Допомога з кодом над приватним вихідним кодом
Запустіть модель для коду із затвердженим контекстом з ваших репозиторіїв та приватним доступом. Тримайте inference і вихідний код на керованій інфраструктурі, а доповнення повертаються вашій команді.
- Вибрані файли та знайдений код як контекст
- Доступ до репозиторіїв обмежено авторизованими користувачами
Приватне AI-рішення
Медичні записи
аналізуються, не покидаючи Афіни.
Клієнту потрібен був AI для аналізу медичних записів: на вході папки пацієнтів, на виході структурований звіт з посиланнями, і кожен крок виконується на локальних моделях на приватних GPU самого клієнта всередині Digital Realty Athens. Дані ніколи не торкаються публічної хмари.
Перед розгортанням
Модель є
лише початком.
Пам’ять, доступ, вартість і постійна експлуатація. Розберімо разом, що потрібно вашому endpoint.
Запитайте інженераМи працюємо з моделями з відкритими вагами (open-weight), зокрема Llama, Mistral, Qwen і DeepSeek. Точний випуск, програмне забезпечення serving, вимоги до обладнання та умови ліцензії перевіряються для вашого розгортання. Якщо ви ще не обрали модель, ми можемо скласти короткий список варіантів і протестувати їх на ваших prompt.
Ваш наступний партнер з інфраструктури
Принесіть нам модель,
яку хочете запустити.
Розкажіть нам про вашу модель, дані та очікуване навантаження. Ми опрацюємо з вами обладнання, serving-стек і розгортання.
+357 222 32280
Почнімо з вашої інфраструктури.
Трохи контексту допомагає нам почати правильну розмову.
Від команди інженерів
Логіка за endpoint.
AI Hosting · 8 min read
A 70B model really does fit on a 48GB card, once you count what quantization costs.
Read the articleAI Hosting · 6 min read
Your AI endpoint doesn't have to be on the internet.
Read the articleAI Hosting · 5 min read