

Managed GPU-Infrastruktur: Ihr Modell.
Ihre Maschine.
Dedizierte GPUsKapazität, für Sie reserviert
Ein privater EndpunktZugriff, entworfen rund um Ihre Anwendung
Athen und AmsterdamDigital Realty, innerhalb der EU
Von Ingenieuren verwaltetVon der Bereitstellung bis zum Betrieb
Die Hardware
Jede GPU, die wir kaufen können.
Innerhalb von 48 Stunden in unserem Rechenzentrum.
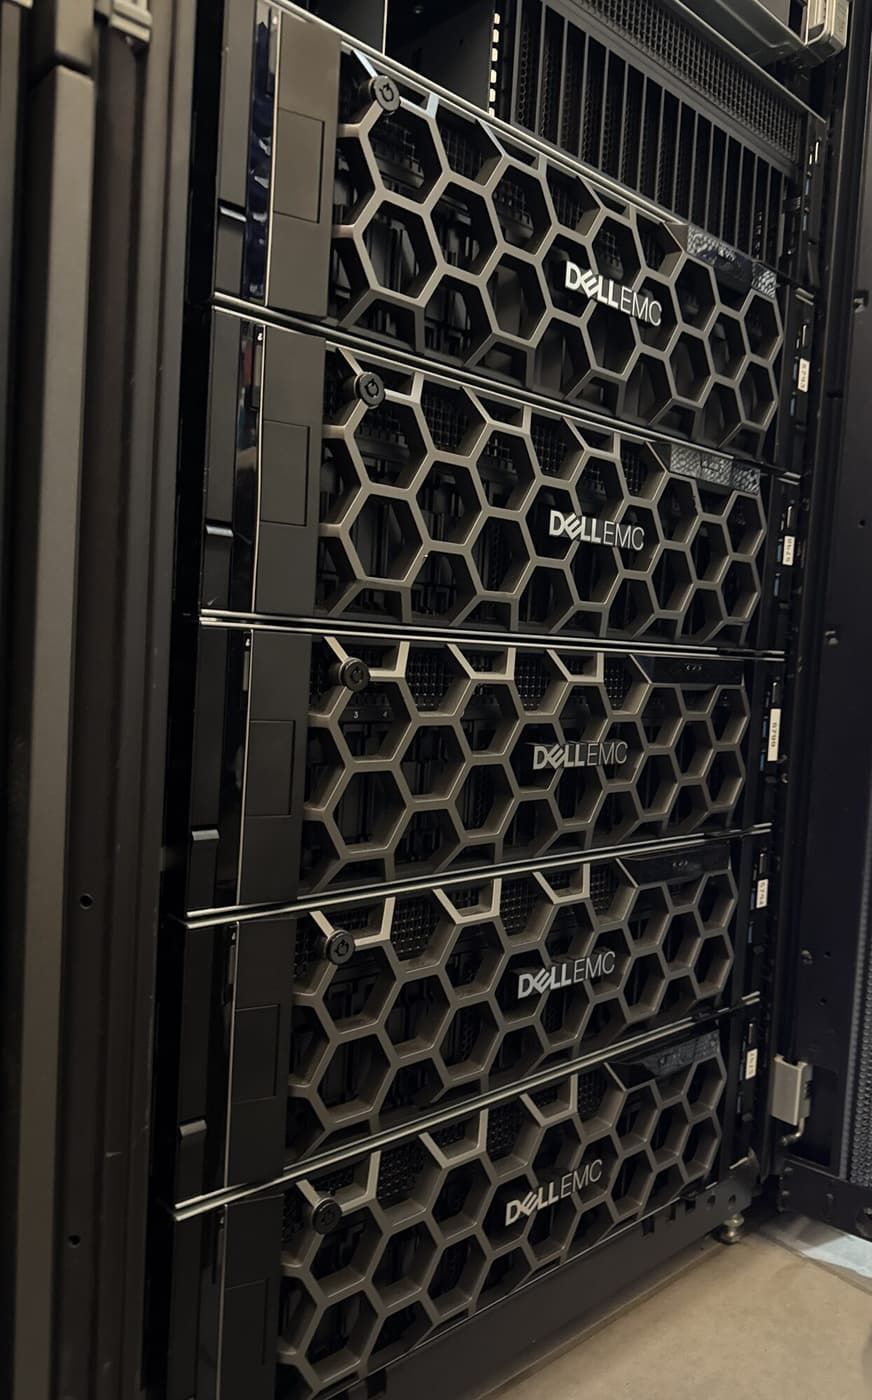
NVIDIA L4, L40, L40S, A100, H100 und der Rest des aktuellen Sortiments, dimensioniert für Modell und Workload. Ihre eigenen privaten GPUs, in unseren Digital-Realty-Rechenzentren in Athen und Amsterdam, innerhalb der EU.
Modell und Maschine, zusammen betrachtet
Ein Modell. Eine Maschine.
Ein Plan.
Sehen Sie sich einige Ausgangspunkte für einen privaten Endpunkt an. Das genaue Modell, die Serving-Anforderungen und die Hardware vereinbaren wir rund um das, was Sie betreiben müssen.
Eine private Verbindung zum Modell auf dedizierter Infrastruktur.
Illustrative ArchitekturEin Ausgangspunkt für das Gespräch
Llama
- Das Modell
- Ein Textmodell der 70B-Klasse, die aktuelle Version wird mit Ihnen vereinbart. Wir bewerten es anhand der Anforderungen Ihrer Anwendung an Sprache, Qualität und Antwortzeit.
- Die Dimensionierung
- Wir testen Präzision (Precision), Kontextlänge und gleichzeitige Anfragen zusammen, bevor wir GPU-Kapazität und Serving-Aufbau wählen.
- Version und Bedingungen
- Llama erscheint unter der Community-Lizenz von Meta, die eigene Nutzungs- und Skalierungsbedingungen hat. Wir bestätigen vor der Bereitstellung, dass die genaue Version zu Ihrer Nutzung passt.
Ein Ausgangspunkt für das Gespräch
Mistral
- Das Modell
- Ein mittelgroßes Modell, die aktuelle Version wird mit Ihnen vereinbart, ist eine Option zur Bewertung für einen privaten Assistenten oder einen Anwendungs-Endpunkt.
- Die Dimensionierung
- Wir vereinbaren Präzision und Kontext, die Sie brauchen, und testen dann die Serving-Workload. Die Modellgröße allein garantiert nicht, dass es auf die GPU passt.
- Version und Bedingungen
- Mistral veröffentlicht manche Gewichte (Weights) unter Apache 2.0 und manche unter eigenen Forschungs- oder kommerziellen Bedingungen. Wir bestätigen, welche für die Version gelten, die Sie wählen.
Ein Ausgangspunkt für das Gespräch
Qwen
- Das Modell
- Eine Familie von Modellgrößen. Wir wählen eine bestimmte Version zum Test mit Ihrer Anwendung, statt Hardware für den Familiennamen zu dimensionieren.
- Die Dimensionierung
- Beginnen Sie mit dem gewählten Modell und Ihren eigenen Prompts. Kontext, Präzision und Verkehrsziele bestimmen die endgültige Konfiguration.
- Version und Bedingungen
- Prüfen Sie die Bedingungen für das genaue Modell und die Größe. Die verlinkte Model Card des 72B ist ein Beispiel, keine Lizenz für die ganze Familie.
Gemeinsam mit Ihnen entworfen
DeepSeek
- Das Modell
- Ein großes Mixture-of-Experts-Modell, die aktuelle Version wird mit Ihnen vereinbart. Es verlangt eine durchdachte Serving-Architektur und eine Bewertung der Workload.
- Die Dimensionierung
- Gemeinsam mit Ihnen entworfen. Wir bewerten GPU-Speicher, Interconnects und Bereitstellungsoptionen, bevor wir Konfiguration oder Preis vereinbaren.
- Version und Bedingungen
- Die Modellbedingungen sind von der Code-Lizenz des Repositorys getrennt. Prüfen Sie die gewählte Version vor der Bereitstellung.
Ein Ausgangspunkt für das Gespräch
Noch nicht entschieden
- Das Modell
- Beginnen Sie mit dem, was die Anwendung leisten muss. Wir helfen Ihnen, eine kurze Liste von Modellen zusammenzustellen, die Sie an Ihren eigenen Prompts und Dokumenten testen.
- Die Dimensionierung
- Wir gehen Antwortqualität, Antwortzeit und erwarteten Datenverkehr mit Ihnen durch und vereinbaren dann gemeinsam Modell und Hardware.
- Version und Bedingungen
- Die kurze Liste enthält die genauen Modellversionen und ihre Bedingungen, damit die Bereitstellungsentscheidung mit allen Details vor Augen getroffen wird.
Endgültige Konfiguration und Preis werden nach der Dimensionierung vereinbart.
Das Engineering ist Teil des Angebots
Wir machen das Engineering.
Sie rufen einen Endpunkt auf.
Ein Team für Hardware, Serving-Stack und den täglichen Betrieb. Sie bringen die Workload, wir arbeiten die Details mit Ihnen durch.
Ihr Support-Team kennenlernenEin Modell und eine Maschine, die zusammenpassen
Wir gehen Modell, Speicher und erwartete Parallelität durch und testen dann den vorgeschlagenen Aufbau mit Ihren Prompts.
Der Serving-Stack, eingerichtet
GPU-Treiber, die Inference-Runtime und die Endpunkt-Konfiguration. Unsere Ingenieure übernehmen die Infrastruktur rund um Ihr Modell.
Zugriff zu Ihren Bedingungen
Ein privater Endpunkt mit Netzwerkzugriff und Logging, konfiguriert rund um Ihre Anwendungen und Datenanforderungen.
Verwaltet über die Bereitstellung hinaus
Das Team, das die Maschine einrichtet, bleibt für den Betrieb verantwortlich und untersucht Probleme über Host und Serving-Stack hinweg.
Updates, mit Plan
Sie behalten eine gewählte Modellversion. Änderungen werden validiert und das Update-Fenster vereinbart, bevor Sie zur nächsten wechseln.
Kapazität, die der Nachfrage folgt
Wir prüfen Speicher, Kontextlänge und Parallelität mit Ihnen, wenn die Nutzung wächst, und ergänzen GPUs oder einen zweiten Host, wenn die Zahlen es sagen.
Was werden Sie betreiben?
Vier illustrative Workloads. Modell, privaten Zugriff und Kapazität formen wir rund um Ihre Anwendung.
RAG über private Dokumente
Bringen Sie Retrieval und Inference auf verwaltete Infrastruktur. Bauen Sie Antworten aus freigegebenen Dokumenten, mit Quellenangaben zurück zur Quelle.
- Modell, Embeddings und Vektordatenbank zusammen
- Dokumentenzugriff über VPN oder ein privates Netzwerk
Ein interner Assistent
Geben Sie Ihrem Team einen Assistenten über freigegebenem internem Wissen, mit Zugriff und Prompt-Logging, konfiguriert rund um Ihre Organisation.
- Dedizierte Inference für Ihr Team
- Logging und Aufbewahrung mit Ihnen vereinbart
KI-Funktionen in Ihrem Produkt
Liefern Sie Modellantworten über einen Endpunkt aus, den Ihre Anwendung aufruft. Wir vereinbaren die Modellversion und dimensionieren die Kapazität anhand echter Prompts und erwarteter Nachfrage.
- Inference auf Ihrer verwalteten GPU-Infrastruktur
- Kapazität und Parallelität für Ihre Anwendung getestet
Code-Assistenz über privaten Quellcode
Betreiben Sie ein Code-Modell mit freigegebenem Repository-Kontext und privatem Zugriff. Halten Sie Inference und Quelldaten auf verwalteter Infrastruktur, mit Vervollständigungen, die an Ihr Team zurückgehen.
- Ausgewählte Dateien und abgerufener Code als Kontext
- Repository-Zugriff beschränkt auf autorisierte Nutzer
Eine private KI-Installation
Medizinische Akten, analysiert,
ohne Athen zu verlassen.
Ein Kunde brauchte KI für die Analyse medizinischer Akten: Patientenakten gehen hinein, ein strukturierter Bericht mit Quellenangaben kommt heraus, und jeder Schritt läuft auf lokalen Modellen auf den eigenen privaten GPUs des Kunden innerhalb von Digital Realty Athens. Die Daten berühren nie eine Public Cloud.
Vor der Bereitstellung
Das Modell ist
nur der Anfang.
Speicher, Zugriff, Kosten und laufender Betrieb. Gehen wir gemeinsam durch, was Ihr Endpunkt braucht.
Einen Ingenieur fragenWir arbeiten mit Open-Weight-Modellen wie Llama, Mistral, Qwen und DeepSeek. Die genaue Version, die Serving-Software, der Hardwarebedarf und die Lizenzbedingungen werden für Ihre Bereitstellung geprüft. Wenn Sie noch kein Modell gewählt haben, können wir Optionen in die engere Wahl nehmen und sie an Ihren Prompts testen.
Ihr nächster Infrastrukturpartner
Bringen Sie uns das
Modell, das Sie betreiben wollen.
Erzählen Sie uns von Ihrem Modell, Ihren Daten und der erwarteten Workload. Hardware, Serving-Stack und Bereitstellung arbeiten wir mit Ihnen durch.
+357 222 32280
Beginnen wir mit Ihrer Umgebung.
Ein wenig Kontext hilft uns, das richtige Gespräch zu beginnen.
Vom Engineering-Team
Die Überlegungen hinter dem Endpunkt.
AI Hosting · 8 min read
A 70B model really does fit on a 48GB card, once you count what quantization costs.
Read the articleAI Hosting · 6 min read
Your AI endpoint doesn't have to be on the internet.
Read the articleAI Hosting · 5 min read