

Pourquoi nous avons standardisé sur HPE 3PAR all-flash
Nous faisons tourner le block storage sur une seule plateforme, HPE 3PAR all-flash en Fibre Channel, et nous l'avons apprise en profondeur, à dessein. C'est cette profondeur qui permet à l'ingénieur d'astreinte de lire la télémétrie de la baie elle-même au lieu d'ouvrir un ticket chez le constructeur.
Dans cet article 5 sections
- Nous avons standardisé le block storage sur HPE 3PAR all-flash en Fibre Channel, une seule famille de baies choisie et maîtrisée, plutôt qu'un menu de paliers venant des constructeurs les mieux placés en prix ce trimestre-là.
- Une seule plateforme signifie que la profondeur se cumule : chaque incident, chaque pièce de rechange et chaque runbook alimente la même bibliothèque de pannes, et l'ingénieur d'astreinte a déjà vu cette baie précise tomber en panne.
- Cette profondeur est la raison pour laquelle les personnes qui répondent savent distinguer une baie malade d'un chemin malade, à partir des compteurs de la baie elle-même et de la télémétrie des chemins.
- La plateforme mérite cette profondeur : des contrôleurs mesh-active, la conception en chunklets qui répartit chaque volume sur chaque disque, un ASIC qui fait le gros du travail, et une preuve de benchmark indépendante de 545 164 IOPS à 0,80 ms.
- Nous ne dévions que quand un travail le mérite réellement. Une base connue est ce qui rend une vraie exception sûre à construire.
Notre block storage tourne sur des baies HPE 3PAR all-flash, accessibles en Fibre Channel. Cette phrase décrit une décision plus qu'un produit : une seule famille de baies, choisie délibérément et apprise en profondeur, au lieu d'un menu de paliers de stockage assemblé à partir de ce que le canal proposait. Cet article est le plaidoyer pour cette décision, et pour la question à poser à tout hébergeur que vous évaluez : en a-t-il jamais pris une de ce genre ?
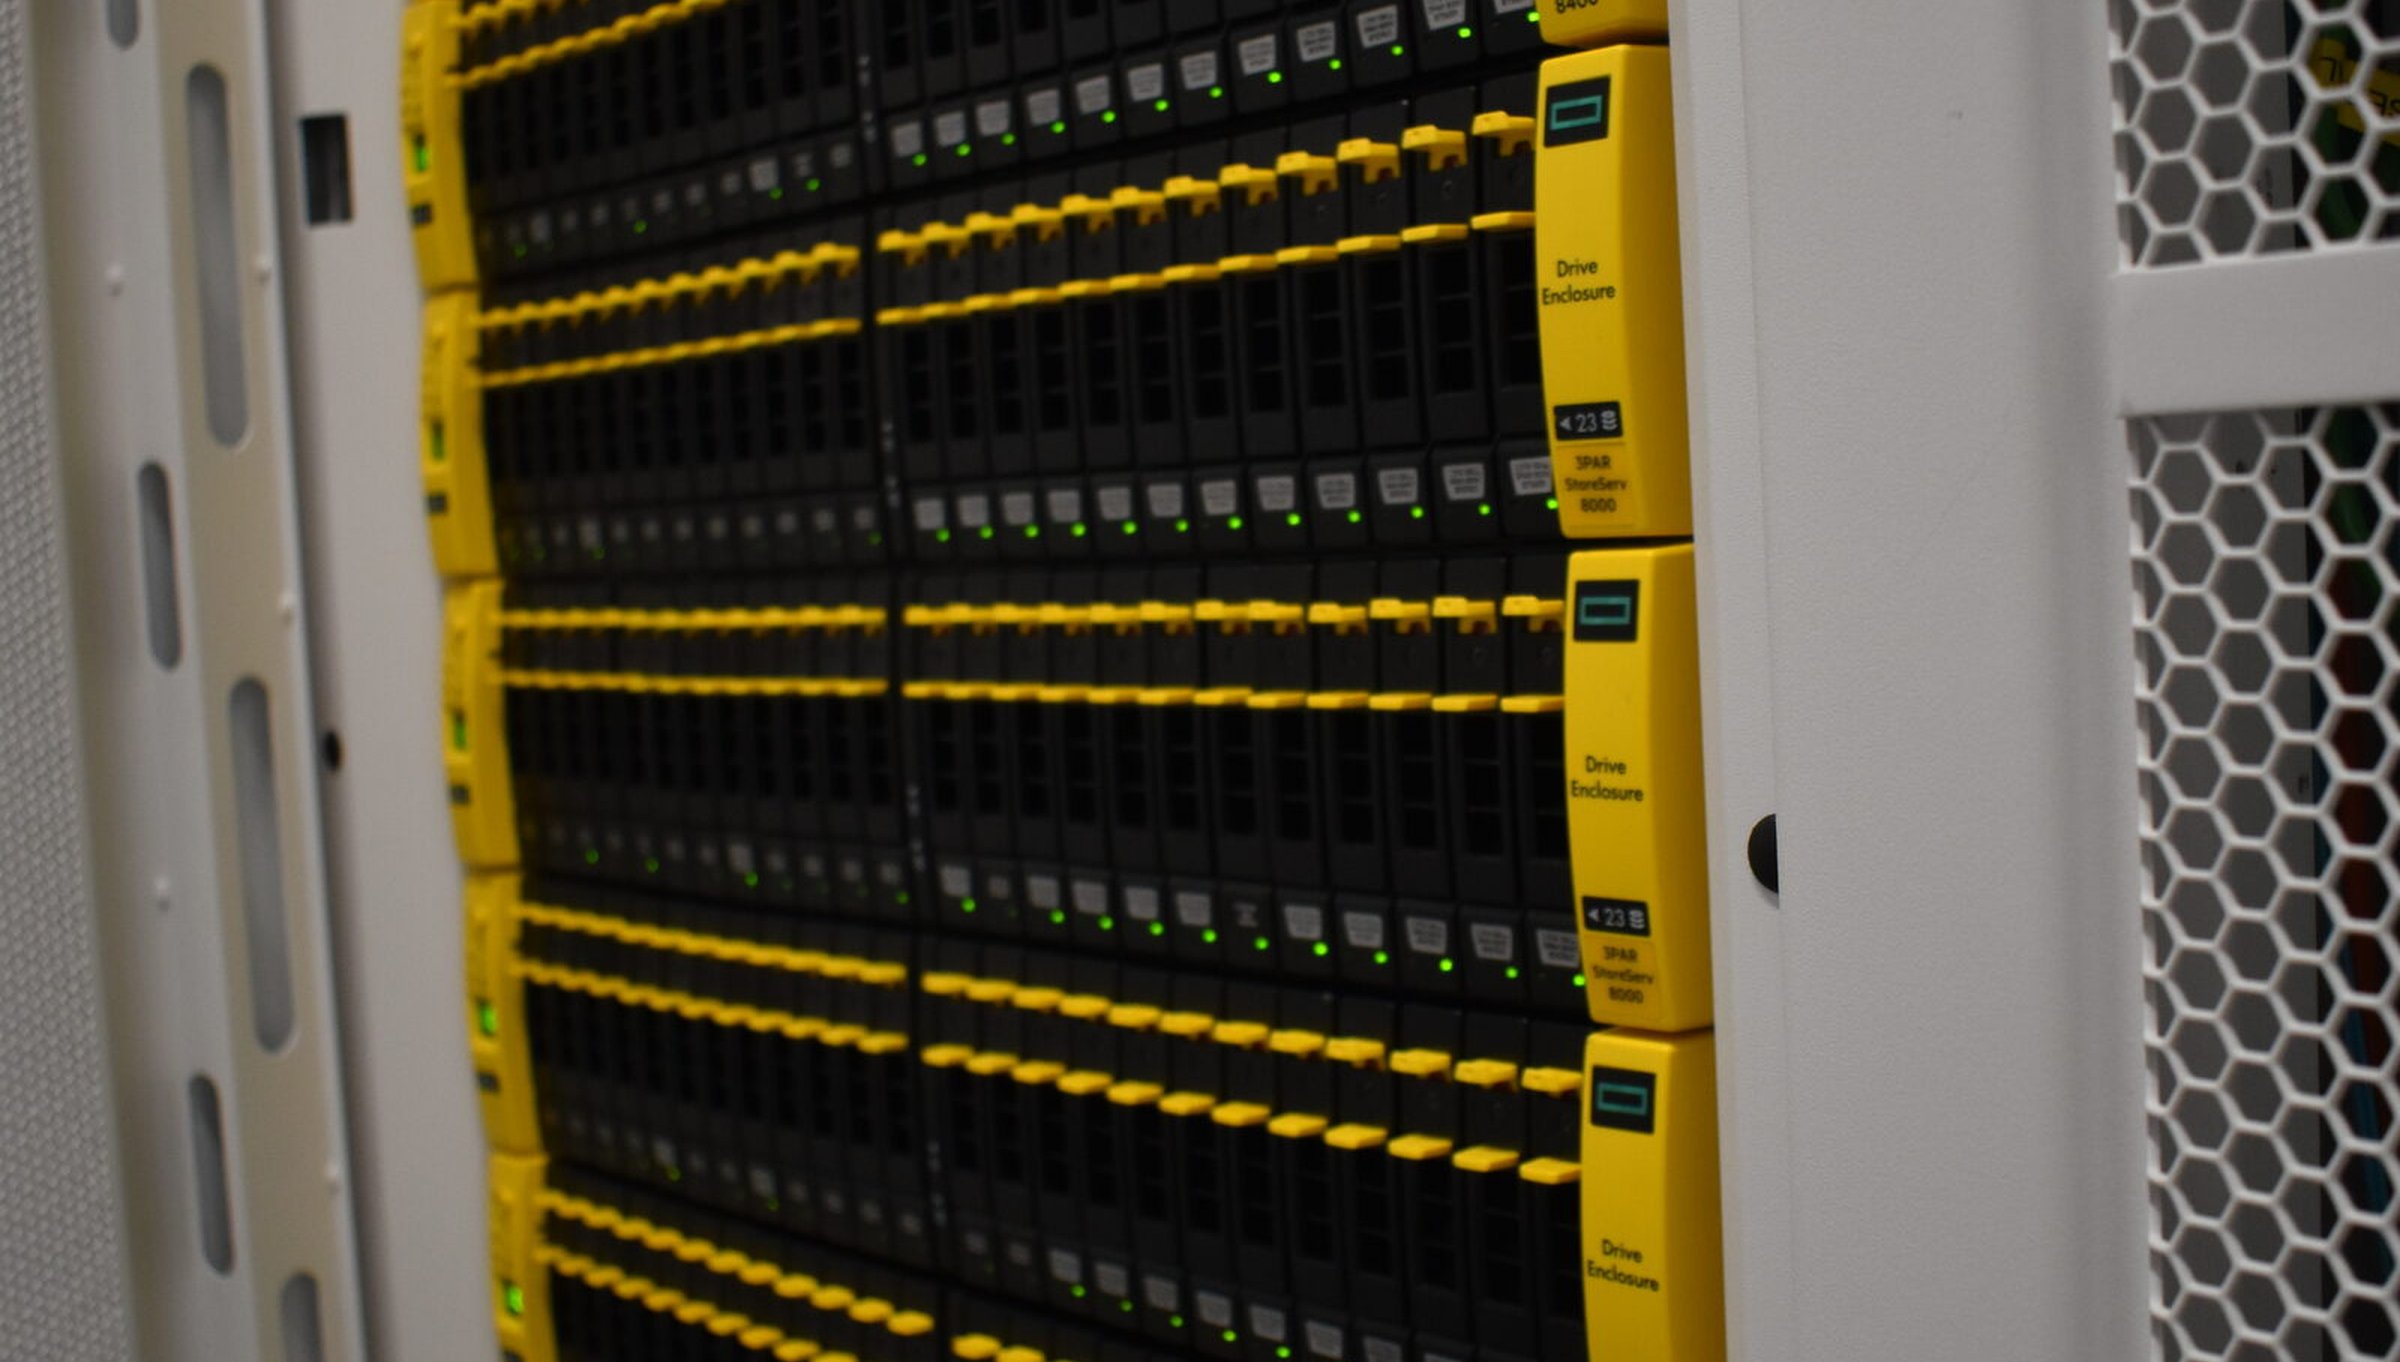
Cinq paliers de stockage sur un menu, c'est cinq plateformes exploitées en surface
Ouvrez les pages de commande de la plupart des fournisseurs et le stockage est une liste déroulante : un palier SATA, un palier SSD, un palier NVMe, parfois un palier performance sans architecture derrière les mots. Chaque ligne de ce menu est une plateforme distincte que quelqu'un doit exploiter, avec ses propres contrôleurs, ses propres modes de panne, sa propre télémétrie et son propre chemin de mise à jour du firmware. Un menu de cinq lignes est un argument commercial. C'est aussi une décision d'effectifs, parce que l'attention des ingénieurs se divise par le nombre de plateformes qu'elle doit couvrir.
L'attention divisée est de la profondeur perdue. Une équipe qui exploite cinq familles de baies détient cinq fines tranches d'expérience, et quand l'une de ces plateformes se comporte mal à 3 heures du matin, les chances que la personne d'astreinte ait déjà traité cette panne précise sur cette machine précise baissent avec chaque ligne supplémentaire du menu. Nous avons réduit le menu à la place.
La profondeur se cumule quand chaque incident atterrit sur la même plateforme
La maîtrise d'une plateforme est un inventaire de travail autant qu'un inventaire mental : des runbooks écrits sur la télémétrie réelle de cette plateforme plutôt que sur un manuel générique, et des ingénieurs dans l'équipe capables de lire les entrailles de la baie et de la diagnostiquer jusqu'au firmware.
Le cumul est le but. Chaque incident traité par n'importe qui dans l'équipe devient partie d'une bibliothèque de pannes partagée pour la même machine, de sorte que la dixième rencontre avec une classe de panne commence par la mémoire plutôt que par la documentation. Répartissez les mêmes incidents sur un catalogue de cinq plateformes et la bibliothèque se fragmente : la plupart des pannes sont rencontrées par quelqu'un qui les voit pour la première fois, et une panne rencontrée pour la première fois prend le plus de temps exactement au moment où votre charge peut le moins se le permettre.
- Cinq paliers, cinq plateformes, cinq ensembles de modes de panne à apprendre
- La connaissance des incidents se fragmente. La plupart des pannes sont rencontrées à froid
- Pièces de rechange et expertise firmware éparpillées sur tout le catalogue
- Quand une baie se comporte mal, la réponse est un ticket constructeur et une attente
- Une seule famille de baies, apprise jusqu'à son firmware
- Chaque incident alimente la même bibliothèque de pannes
- Des runbooks et une mémoire musculaire pour une machine connue
- L'ingénieur qui répond a déjà vu cette baie précise tomber en panne
Ce que la profondeur achète, au quotidien
HPE 3PAR Peer Persistence garde les volumes en ligne si une baie tombe, et nos ingénieurs lisent les temps de service et la télémétrie des chemins sur les baies en routine, donc une question de stockage reçoit sa réponse de la baie, pas d'une file constructeur. Distinguer une baie malade d'un chemin malade demande cette profondeur, détenue par les mêmes personnes qui exploitent le SAN chaque jour.
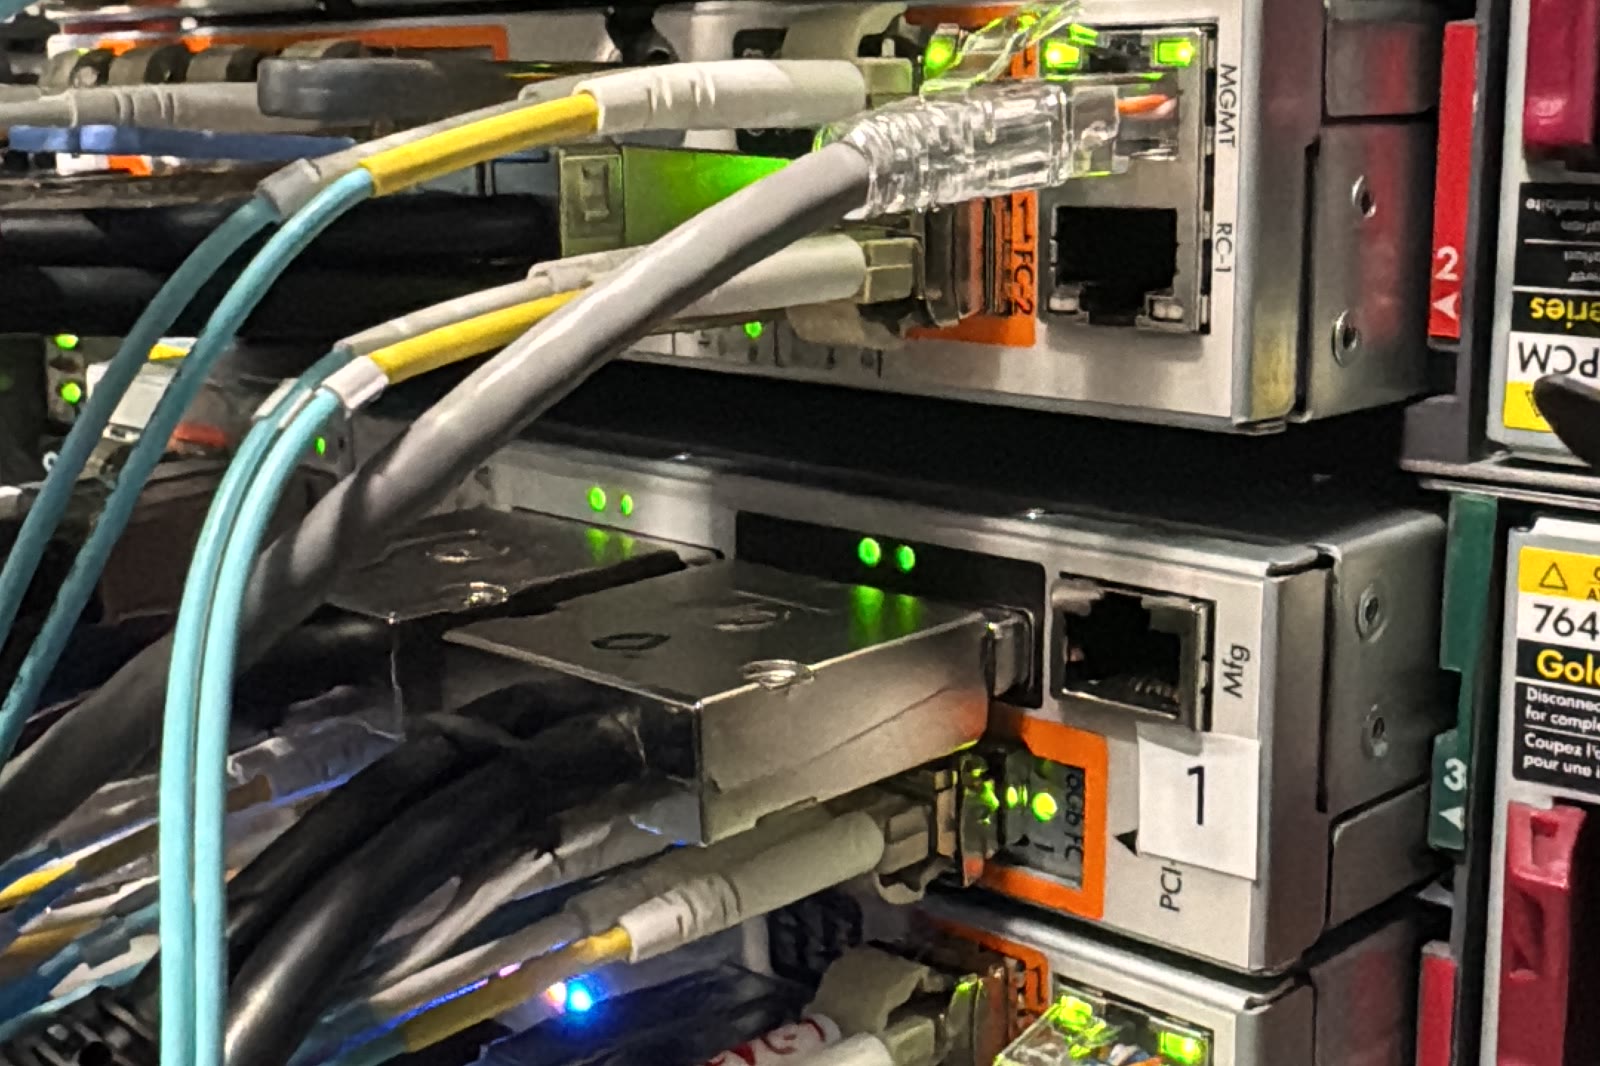
La machine elle-même, d'après le dossier public
Un bref tour de ce sur quoi nous avons standardisé, chaque affirmation venant du dossier public. Le HPE 3PAR 8450 est le modèle all-flash de la famille 8000 : deux à quatre nœuds contrôleurs sur un fond de panier passif full-mesh, une conception que HPE appelle Mesh-Active parce que chaque volume est actif sur chaque contrôleur en même temps. Il n'y a pas de contrôleur principal depuis lequel basculer. La famille est sortie fin 2015, mais le pedigree est plus ancien et meilleur : 3PAR a été fondée en 1999 par des architectes systèmes de Sun Microsystems, le nom signifie littéralement 3 Partners, et la société a été pionnière du thin provisioning. En 2010, HP et Dell se sont livré une bataille d'enchères publique pour l'acquérir, de l'offre d'ouverture de Dell à $18 l'action à l'offre gagnante de HP à $33, environ $2,35 milliards. Des gens sérieux voulaient très fort cette machine.
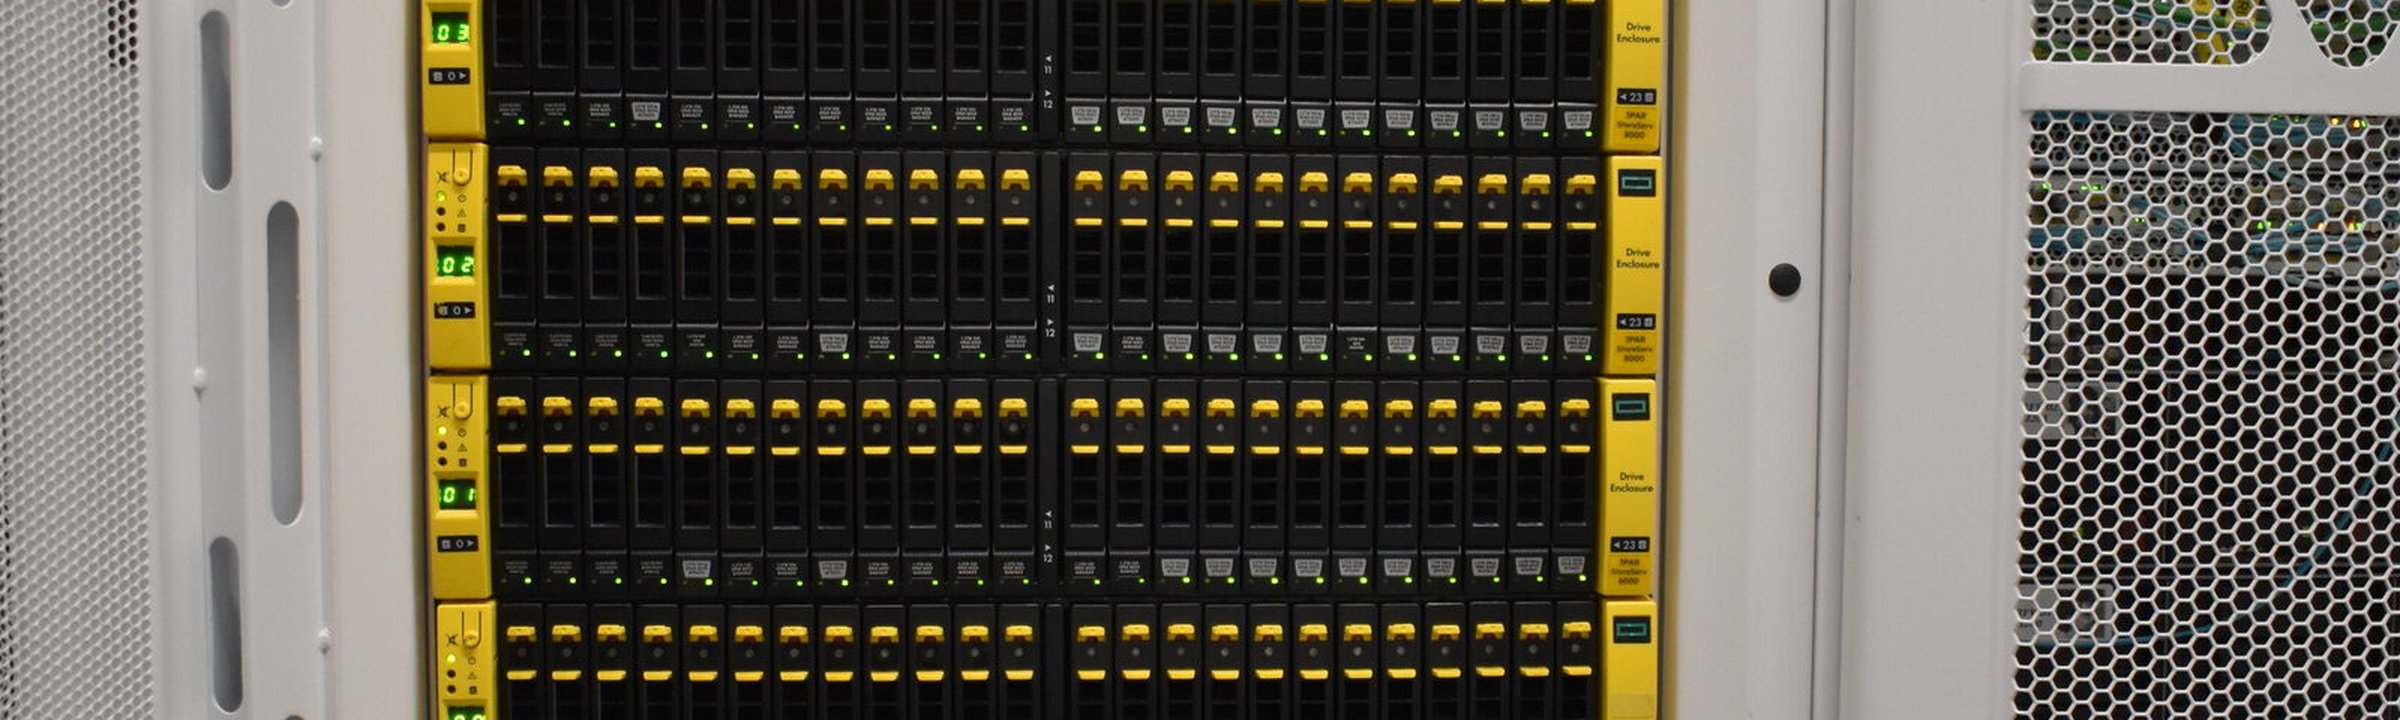
L'idée qui a rendu 3PAR célèbre est le chunklet, le terme officiel du document d'architecture de HPE. Le système d'exploitation découpe chaque disque en chunklets de 1 GiB et construit le RAID à partir d'eux plutôt qu'à partir de disques entiers, de sorte que chaque volume finit réparti sur chaque disque, derrière chaque contrôleur et chaque port. Deux choses en découlent. Les performances : il n'y a pas de disque chaud, parce qu'aucun volume ne vit sur un disque en particulier. Et les reconstructions : la capacité de réserve est dispersée sur toute la baie au lieu d'être garée sur un disque de secours inactif, donc une reconstruction, ce sont de nombreux disques qui aident en même temps plutôt qu'un seul disque qui boit avec une paille.
Chaque contrôleur embarque aussi l'ASIC Thin Express de HPE, de cinquième génération dans le 8450, à côté du CPU, qui fait en silicium le travail pour lequel les baies logicielles brûlent des cœurs : détecter et supprimer les flux de zéros à la volée, hacher les blocs pour la déduplication, calculer la parité RAID, et apposer des checksums de bout en bout, du port hôte jusqu'au disque. Cette puce est une grande part de la raison pour laquelle la baie déplace des I/O bloc sans drame.
Deux à quatre nœuds contrôleurs sur un fond de panier passif full-mesh
Chaque disque découpé en chunklets de 1 GiB, chaque volume réparti sur tous
Capacité de réserve dispersée sur la baie, pas garée sur un disque inactif
ASIC Thin Express, 5e génération, qui fait RAID et checksums en silicium
- un contrôleur meurt, configuration à quatre nœuds
- le cache d'écriture se re-mirrore sur les nœuds survivants, sans ramper en write-through
- un port ou un chemin tombe
- la baie déplace le port elle-même, l'hôte ne remarque rien
- un disque meurt
- reconstruction plusieurs vers plusieurs depuis des réserves dispersées sur la baie
Ce sont des affirmations de HPE, tirées du document d'architecture, pas des résultats de notre laboratoire. Celle qui mérite d'être soulignée est la première : le document de HPE lui-même signale que les baies à deux contrôleurs tombent en cache write-through quand un contrôleur meurt, ce qui est une façon polie de dire qu'elles rampent. Un 3PAR à quatre nœuds garde son cache d'écriture en miroir et continue. C'est la différence entre une panne de contrôleur qui apparaît sur votre graphique de latence et une qui n'apparaît pas.
545 164
IOPS SPC-1 à 0,80 ms de réponse moyenne, mesurés sur un 8450 sous le benchmark de stockage standard du secteur
Une note de bas de page honnête sur ce chiffre. Les brochures de HPE annoncent la famille 8000 au-delà du million d'IOPS dans les configurations les plus hautes, et les plus gros 3PAR vont encore plus haut. Les 545 mille sont ce qu'un 8450 a réellement affiché sous le benchmark indépendant, grille de prix jointe : 23 cents par IOPS SPC-1, la moins chère des dix baies les plus rapides de la liste à l'époque. Le mesuré bat la brochure, donc le chiffre mesuré est celui que nous citons.
Une décennie en production signifie que le firmware est stabilisé, que les modes de panne sont documentés, que les pièces sont abondantes, et que rien de ce que fait cette machine ne surprend les ingénieurs qui l'ont maîtrisée. C'est notre doctrine en une phrase, et elle a son propre article : achetez la machine sérieuse.
Nous ne dévions que quand le travail le mérite
Une standardisation sans clause de sortie est un dogme, alors voici la nôtre : nous ne dévions que quand un travail le mérite réellement. La version générale de cet argument, y compris pourquoi une base connue est ce qui rend une vraie exception sûre à concevoir, couvre nos décisions sur le réseau, le calcul et le fabric aux côtés du stockage dans nous avons des avis tranchés sur le matériel, pour que vous n'ayez pas à en avoir. Ceci est le chapitre du stockage.
Si vous évaluez un hébergeur, les questions de stockage qui valent la peine d'être posées, y compris celles auxquelles la plupart des fournisseurs ne savent pas répondre, sont dans ce que le mot SSD cache du stockage de votre hébergeur.
Réponses directes
Standardiser sur un seul constructeur de stockage, n'est-ce pas un risque de lock-in ?+
C'est une dépendance que nous avons choisie les yeux ouverts. Quelle que soit la plateforme qu'un hébergeur exploite, vous êtes liés à sa capacité à l'exploiter, et un menu de cinq constructeurs étale la même dépendance sur cinq plateformes sans garder la profondeur d'aucune. Nous préférons être liés à une plateforme que nous savons diagnostiquer jusqu'au firmware plutôt que libres de choisir entre des plateformes que nous connaissons en surface.
Qu'est-ce que change l'usage d'une seule famille de baies ?+
Chaque incident, chaque pièce de rechange et chaque runbook s'ajoute à la connaissance de l'équipe sur la même plateforme. L'argument ici est la profondeur opérationnelle : des ingénieurs dans l'équipe capables de lire les entrailles de la baie et de reconnaître ses modes de panne.
Que signifie « maîtrisée » en pratique ?+
Des runbooks pour une machine connue, et une astreinte où la personne qui répond a déjà traité les pannes de cette plateforme. Quand le stockage se comporte mal, c'est la différence entre un diagnostic en cours et un ticket ouvert chez le constructeur pour votre compte.
Posez vos questions de stockage aux personnes qui exploitent la baie
Les ingénieurs stockage et fabric qui exploitent notre SAN au quotidien sont les mêmes qui répondent. Demandez-leur ce dont votre charge a besoin en dessous.
Parler à un ingénieurVous êtes arrivé à la fin.
Mettez la lecture en pratique
Que faites-vous tourner ?
Parlez-nous de la charge de travail, du trafic et des exigences de reprise. Commencez par le configurateur de serveur, ou passez en revue les détails avec un ingénieur.
Écrit par les ingénieurs qui construisent et exploitent l'infrastructure qu'il décrit.Parler à un ingénieur