

Por qué estandarizamos en HPE 3PAR all-flash
Ejecutamos el block storage en una sola plataforma, HPE 3PAR all-flash sobre Fibre Channel, y la aprendimos a fondo a propósito. Esa profundidad es lo que permite al ingeniero de guardia leer la telemetría de la propia cabina en lugar de abrir un caso al fabricante.
En este artículo 5 secciones
- Estandarizamos el block storage en HPE 3PAR all-flash sobre Fibre Channel, una familia de cabinas elegida y dominada, en lugar de un menú de niveles de los fabricantes que tuvieran buen precio ese trimestre.
- Una sola plataforma significa que la profundidad se acumula: cada incidente, repuesto y runbook alimenta la misma biblioteca de fallos, y el ingeniero de guardia ya ha visto fallar exactamente esta cabina.
- Esa profundidad es la razón de que quienes responden puedan distinguir una cabina enferma de una ruta enferma, a partir de los propios contadores de la cabina y de la telemetría de rutas.
- La plataforma se merece la profundidad: controladoras mesh-active, el diseño de chunklets que reparte cada volumen por todos los discos, un ASIC que hace el trabajo pesado, y una prueba de benchmark independiente de 545.164 IOPS a 0,80 ms.
- Nos desviamos solo cuando un trabajo se lo merece de verdad. Una base conocida es lo que hace segura de construir una excepción real.
Nuestro block storage corre en cabinas HPE 3PAR all-flash, accesibles por Fibre Channel. Esa frase describe una decisión más que un producto: una familia de cabinas, elegida deliberadamente y aprendida a fondo, en lugar de un menú de niveles de storage montado con lo que ofreciera el canal. Este artículo es el argumento a favor de esa decisión, y a favor de preguntar a cualquier proveedor que evalúe si alguna vez tomó una parecida.
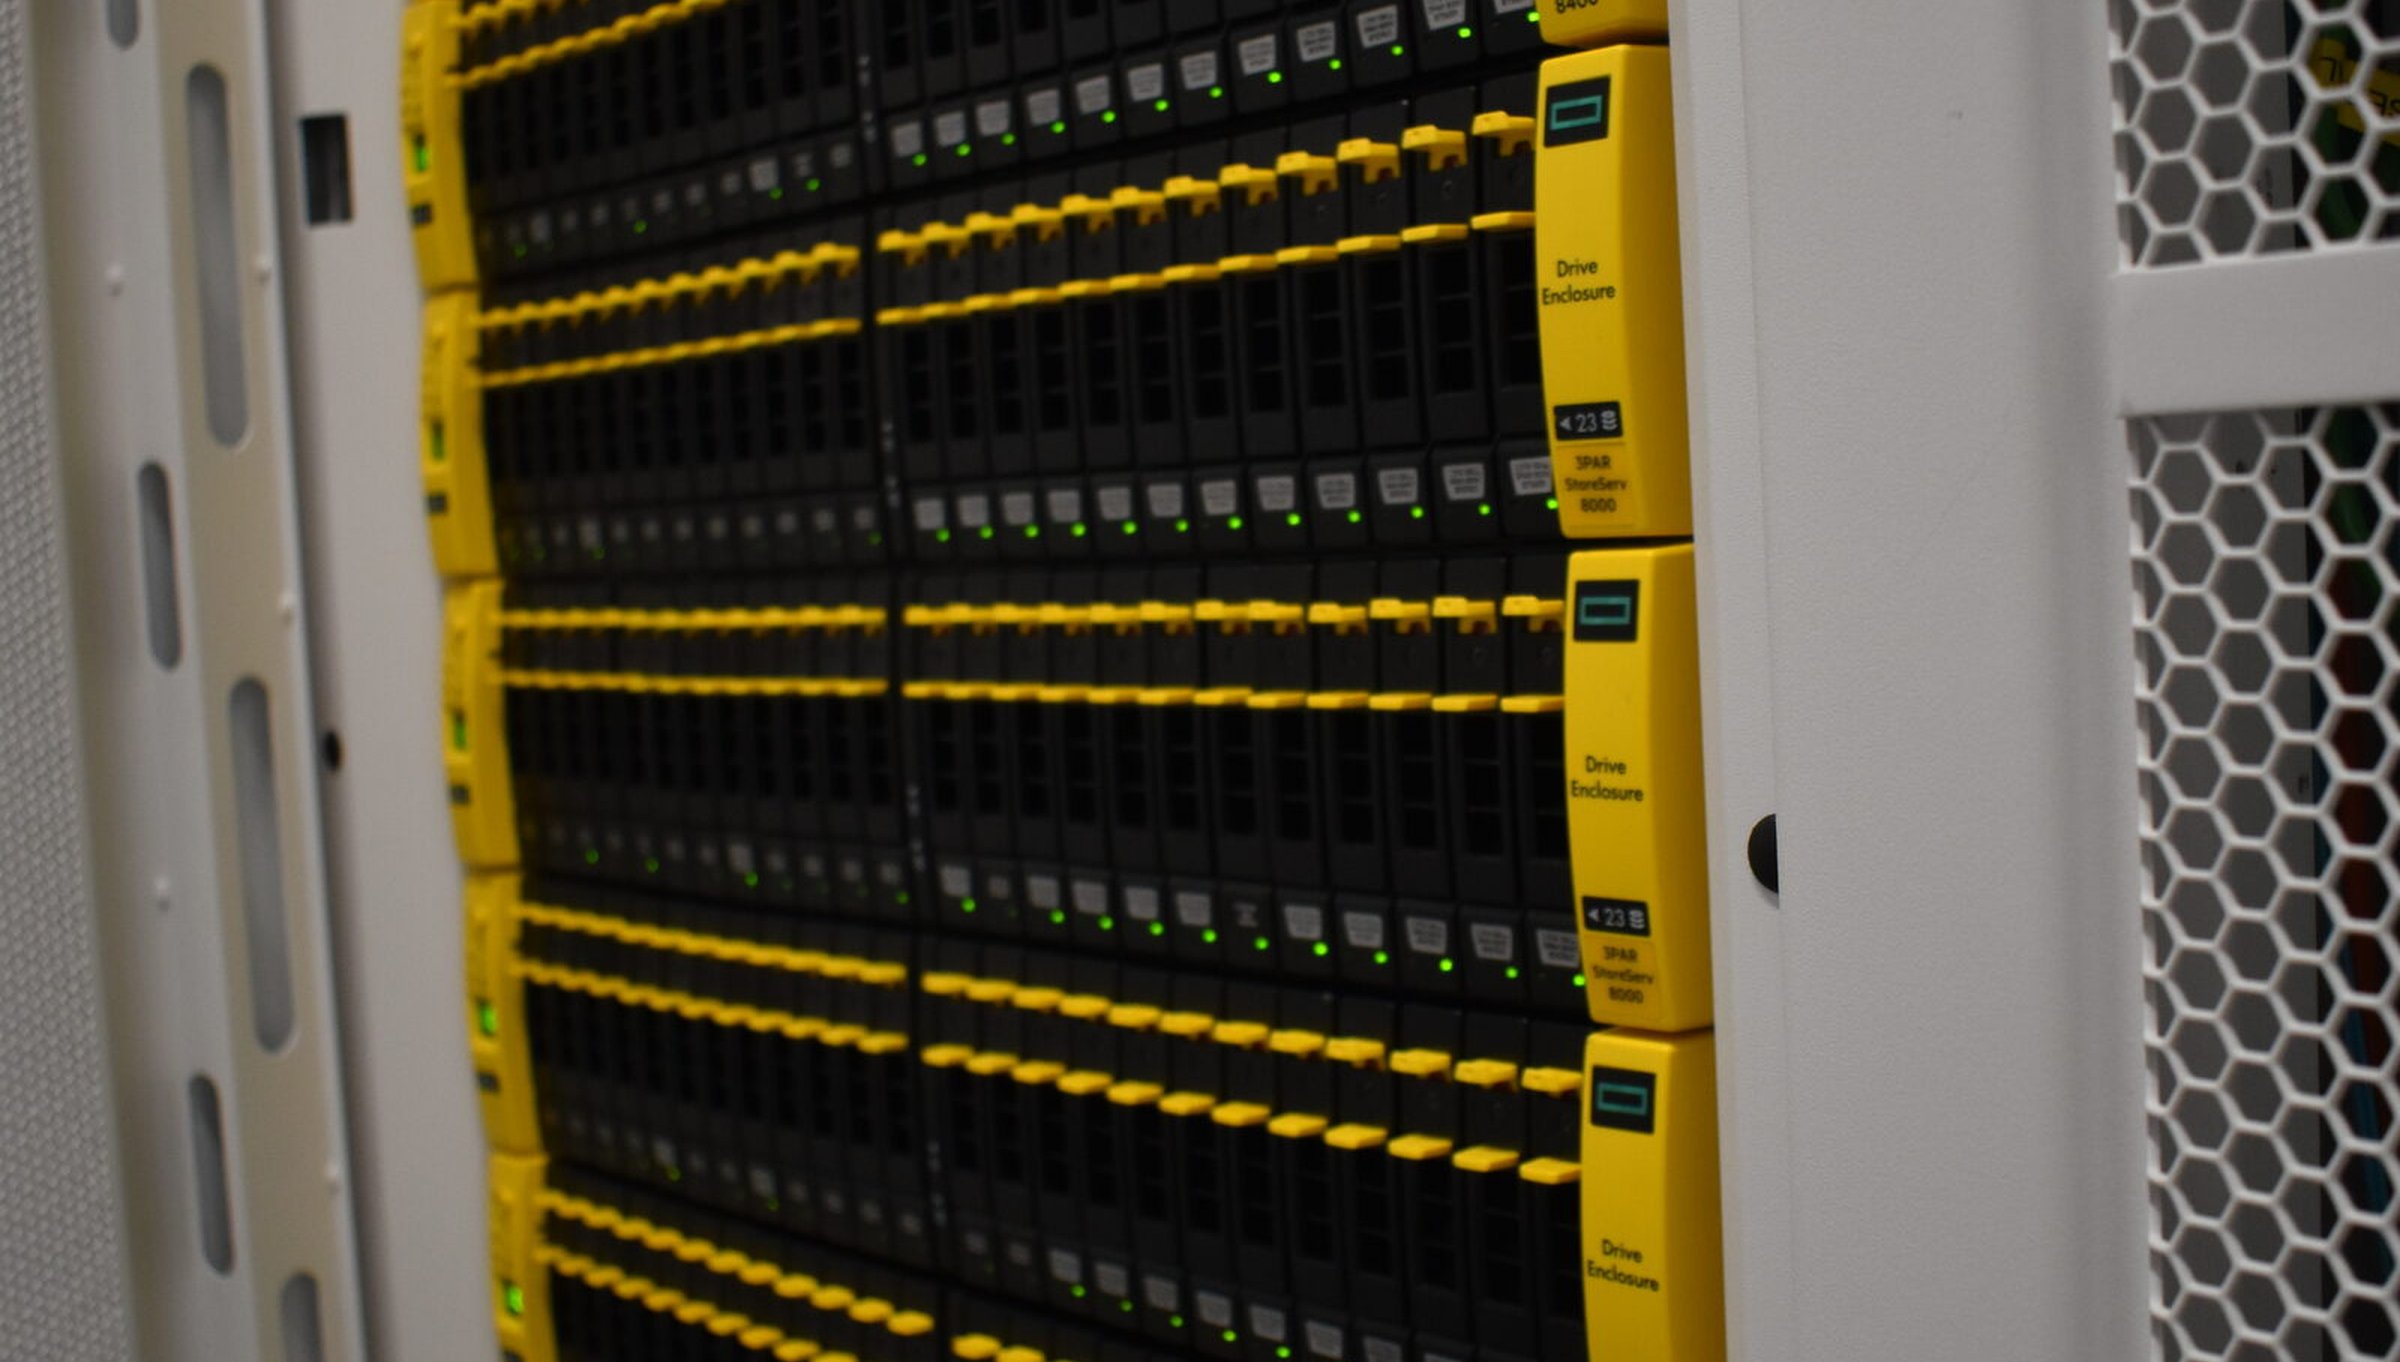
Cinco niveles de storage en un menú son cinco plataformas operadas superficialmente
Abra las páginas de pedido de la mayoría de los proveedores y el storage es un desplegable: un nivel SATA, un nivel SSD, un nivel NVMe, a veces un nivel performance sin ninguna arquitectura detrás de las palabras. Cada fila de ese menú es una plataforma distinta que alguien tiene que operar, con sus propias controladoras, sus propios modos de fallo, su propia telemetría y su propia ruta de actualización de firmware. Un menú de cinco filas es una característica de compras. También es una decisión de plantilla, porque la atención de ingeniería se divide por el número de plataformas que tiene que cubrir.
La atención dividida es profundidad perdida. Un equipo que opera cinco familias de cabinas conserva cinco finas láminas de experiencia, y cuando una de esas plataformas se comporta de forma extraña a las 3 de la madrugada, la probabilidad de que la persona de guardia haya trabajado exactamente ese fallo en exactamente esa máquina baja con cada fila extra del menú. Nosotros colapsamos el menú.
La profundidad se acumula cuando cada incidente cae en la misma plataforma
El dominio de una plataforma es un inventario de trabajo tanto como uno mental: runbooks escritos sobre la telemetría real de esa plataforma en lugar de sobre un manual genérico, e ingenieros en plantilla capaces de leer las entrañas de la cabina y diagnosticarla a nivel de firmware.
La acumulación es el objetivo. Cada incidente que trabaja cualquiera del equipo pasa a formar parte de una biblioteca de fallos compartida para la misma máquina, de modo que el décimo encuentro con una clase de fallo parte de la memoria en lugar de la documentación. Reparta los mismos incidentes entre un catálogo de cinco plataformas y la biblioteca se fragmenta: la mayoría de los fallos los encuentra alguien por primera vez, y un fallo encontrado por primera vez es el que más tarda justo en el momento en que su carga de trabajo menos puede permitírselo.
- Cinco niveles, cinco plataformas, cinco conjuntos de modos de fallo que aprender
- El conocimiento de incidentes se fragmenta. La mayoría de los fallos se encuentran en frío
- Repuestos y conocimiento de firmware repartidos a lo largo del catálogo
- Cuando una cabina se comporta de forma extraña, la jugada es un ticket al fabricante y esperar
- Una familia de cabinas, aprendida hasta su firmware
- Cada incidente alimenta la misma biblioteca de fallos
- Runbooks y memoria muscular para una máquina conocida
- El ingeniero que responde ya ha visto fallar exactamente esta cabina
Lo que compra la profundidad, en el día a día
HPE 3PAR Peer Persistence mantiene los volúmenes online si una cabina se cae, y nuestros ingenieros leen tiempos de servicio y telemetría de rutas en las cabinas como rutina, así que una pregunta sobre storage la responde la cabina, no una cola del fabricante. Distinguir una cabina enferma de una ruta enferma exige esa profundidad, en manos de las mismas personas que operan la SAN cada día.
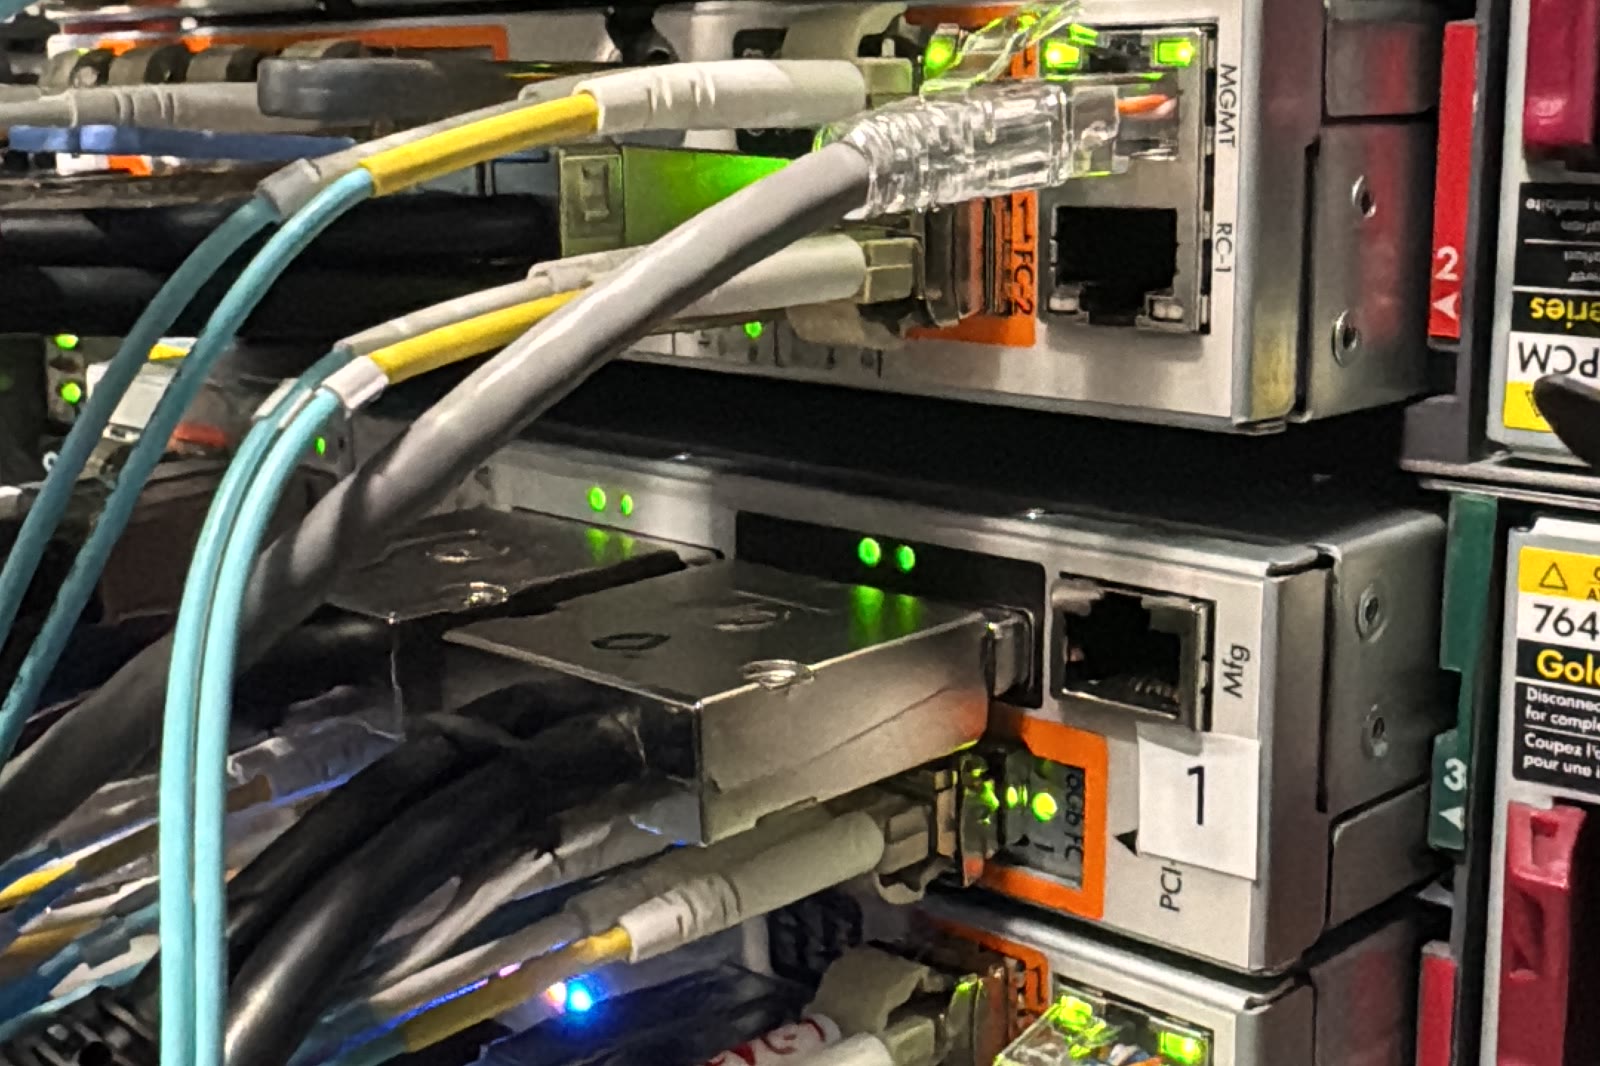
La máquina en sí, según el registro público
Un breve recorrido por aquello en lo que estandarizamos, con cada afirmación tomada del registro público. El HPE 3PAR 8450 es el modelo all-flash de la familia 8000: de dos a cuatro nodos controladores sobre un backplane full-mesh pasivo, un diseño que HPE llama Mesh-Active porque cada volumen está vivo en todas las controladoras a la vez. No hay una controladora principal desde la que hacer failover. La familia salió a finales de 2015, pero el linaje es más antiguo y mejor: 3PAR la fundaron en 1999 arquitectos de sistemas de Sun Microsystems, el nombre significa literalmente 3 Partners, y la empresa fue pionera del thin provisioning. En 2010 HP y Dell libraron una guerra pública de ofertas por ella, desde la oferta inicial de Dell a $18 por acción hasta la ganadora de HP a $33, unos $2,35 mil millones. Gente seria quería esta máquina con muchas ganas.
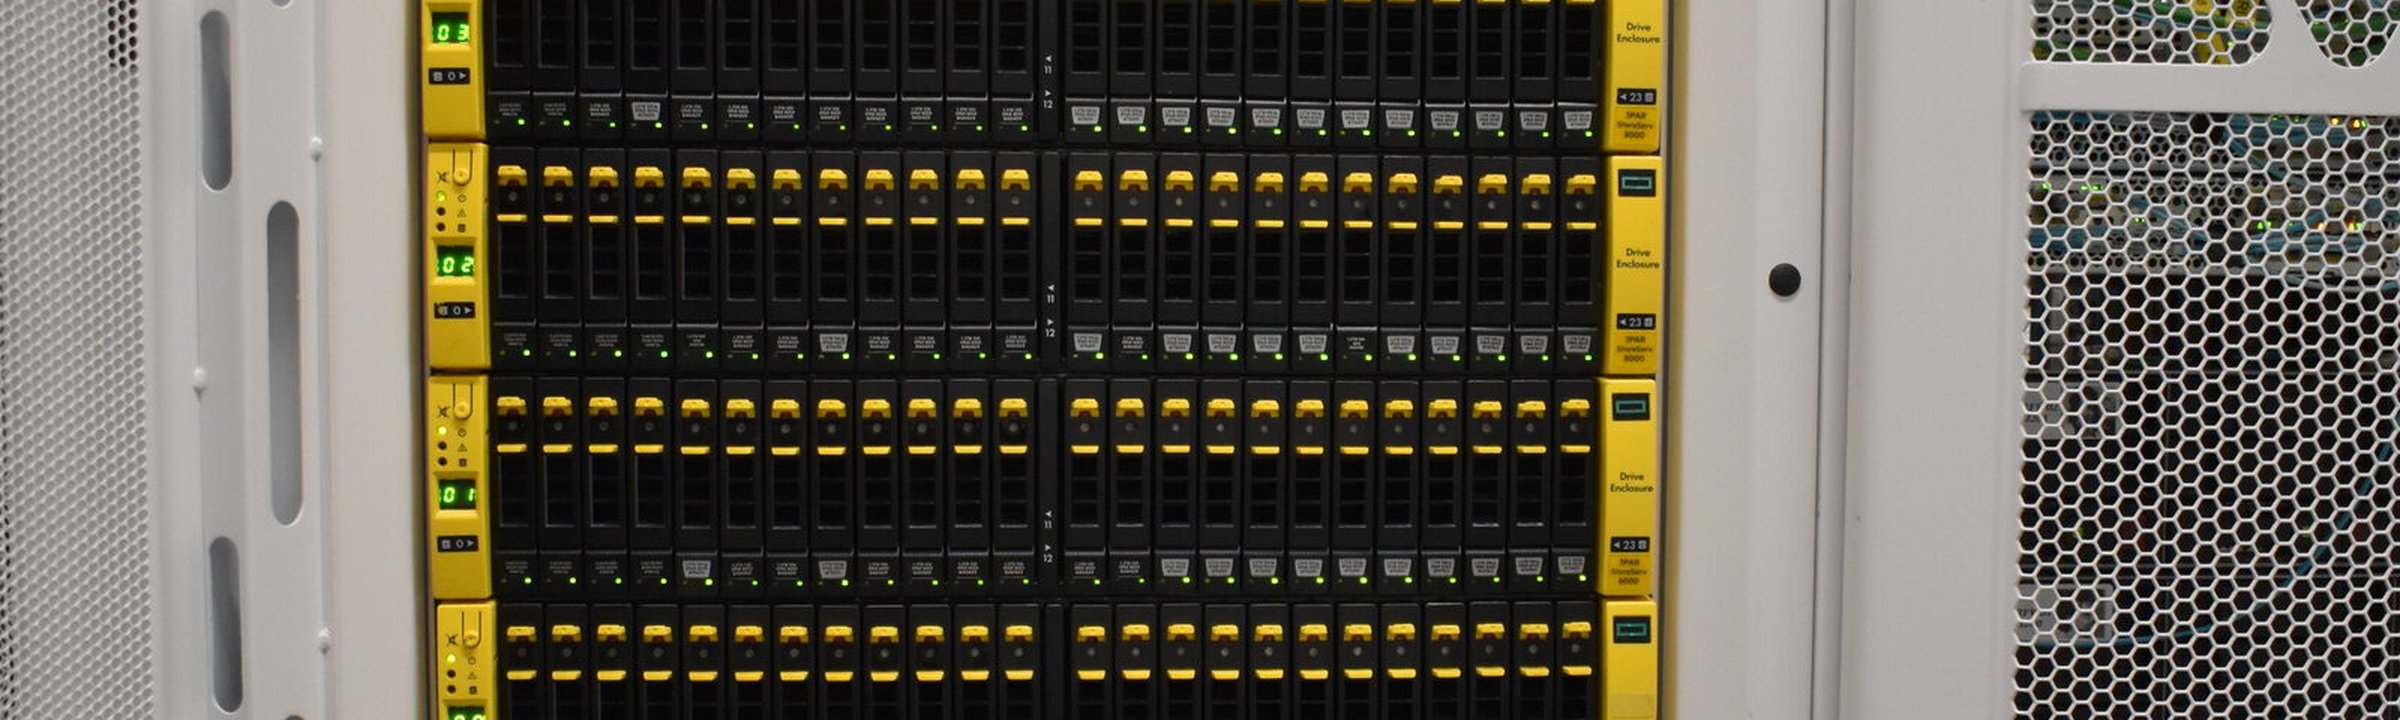
La idea que hizo famosa a 3PAR es el chunklet, el término oficial en el documento de arquitectura de HPE. El sistema operativo trocea cada disco en chunklets de 1 GiB y construye el RAID a partir de ellos en lugar de a partir de discos enteros, de modo que cada volumen acaba repartido por todos los discos, detrás de todas las controladoras y de todos los puertos. De ahí se derivan dos cosas. Rendimiento: no hay disco caliente, porque ningún volumen vive en un disco concreto. Y reconstrucciones: la capacidad de reserva está dispersa por toda la cabina en lugar de aparcada en un disco de repuesto inactivo, así que una reconstrucción son muchos discos ayudando a la vez en lugar de un solo disco bebiendo con una pajita.
Cada controladora lleva además el ASIC Thin Express de HPE, de quinta generación en el 8450, junto a la CPU, que hace en silicio el trabajo en el que las cabinas por software queman núcleos: detectar y descartar inline los flujos de ceros, calcular hashes de bloques para la deduplicación, calcular la paridad RAID y sellar checksums de extremo a extremo, del puerto del host al disco. Ese chip es gran parte del motivo de que la cabina mueva I/O de bloques sin dramatismo.
De dos a cuatro nodos controladores sobre un backplane full-mesh pasivo
Cada disco troceado en chunklets de 1 GiB, cada volumen repartido por todos ellos
Capacidad de reserva dispersa por la cabina, no aparcada en un disco inactivo
ASIC Thin Express, 5.ª generación, que hace RAID y checksums en silicio
- muere una controladora, configuración de cuatro nodos
- la caché de escritura vuelve a replicarse en los nodos supervivientes, sin arrastrarse en write-through
- cae un puerto o una ruta
- la cabina mueve el puerto por sí misma, el host no lo nota
- muere un disco
- reconstrucción muchos a muchos desde reservas dispersas por la cabina
Esas son afirmaciones de HPE, del documento de arquitectura, no resultados de nuestro laboratorio. La que merece subrayarse es la primera: el propio documento de HPE señala que las cabinas de doble controladora caen en caché write-through cuando muere una controladora, que es una forma educada de decir que se arrastran. Un 3PAR de cuatro nodos mantiene su caché de escritura replicada y sigue adelante. Esa es la diferencia entre un fallo de controladora que aparece en su gráfica de latencia y uno que no.
545.164
IOPS SPC-1 a 0,80 ms de respuesta media, medidos en un 8450 bajo el benchmark de storage estándar del sector
Una nota honesta sobre esa cifra. Los folletos de HPE citan la familia 8000 escalando por encima del millón de IOPS en las configuraciones más altas, y los 3PAR más grandes llegan aún más arriba. Los 545 mil son lo que un 8450 registró realmente en el benchmark independiente, con la hoja de precios adjunta: 23 centavos por IOPS SPC-1, la más barata de las diez cabinas más rápidas de la lista en aquel momento. Lo medido gana al folleto, así que la cifra medida es la que citamos.
Una década en producción significa que el firmware está asentado, los modos de fallo están documentados, los repuestos abundan y nada de lo que hace esta máquina sorprende a los ingenieros que la dominaron. Esa es nuestra doctrina en una frase, y tiene su propio artículo: comprar la máquina seria.
Nos desviamos solo cuando el trabajo se lo merece
La estandarización sin cláusula de salida es dogma, así que esta es la nuestra: nos desviamos solo cuando un trabajo se lo merece de verdad. La versión general de este argumento, incluido por qué una base conocida es lo que hace segura de diseñar una excepción real, cubre nuestras decisiones de red, cómputo y fabric junto con el storage en tenemos opiniones firmes sobre el hardware. Este es el capítulo del storage.
Si está evaluando un proveedor, las preguntas sobre storage que merece la pena hacer, incluidas las que la mayoría de los proveedores no pueden responder, están en el secreto sucio de su proveedor es su storage.
Respuestas directas
¿Estandarizar en un solo fabricante de storage no es un riesgo de lock-in?+
Es una dependencia que elegimos con los ojos abiertos. Sea cual sea la plataforma que opere un proveedor, usted está atado a su capacidad de operarla, y un menú de cinco fabricantes reparte esa misma dependencia entre cinco plataformas sin conservar la profundidad de ninguna. Preferimos estar atados a una plataforma que podemos diagnosticar a nivel de firmware que ser libres de elegir entre plataformas que conocemos superficialmente.
¿Qué cambia usar una sola familia de cabinas?+
Cada incidente, repuesto y runbook suma al conocimiento del equipo sobre la misma plataforma. El argumento aquí es la profundidad operativa: ingenieros en plantilla capaces de leer las entrañas de la cabina y reconocer sus modos de fallo.
¿Qué significa «dominada» en la práctica?+
Runbooks para una máquina conocida, y una rotación de guardia en la que la persona que responde ya ha trabajado los fallos de esta plataforma. Cuando el storage se comporta de forma extraña, esa es la diferencia entre un diagnóstico en marcha y un ticket abierto al fabricante en su nombre.
Haga sus preguntas sobre storage a las personas que operan la cabina
Los ingenieros de storage y de fabric que operan nuestra SAN cada día son los mismos que responden. Pregúnteles qué necesita su carga de trabajo por debajo.
Hable con un ingenieroHa llegado al final.
Ponga la lectura a trabajar
¿Qué está ejecutando?
Cuéntenos la carga de trabajo, el tráfico y los requisitos de recuperación. Empiece por el configurador de servidores o repase los detalles con un ingeniero.
Escrito por los ingenieros que construyen y operan la infraestructura que describe.Hable con un ingeniero