

Warum wir auf All-Flash HPE 3PAR standardisiert haben
Wir betreiben Block-Storage auf einer Plattform, HPE 3PAR All-Flash über Fibre Channel, und wir haben sie mit Absicht in der Tiefe gelernt. Diese Tiefe ist es, die dem Ingenieur in Bereitschaft erlaubt, die eigene Telemetrie des Arrays zu lesen, statt einen Fall beim Hersteller zu eröffnen.
In diesem Artikel 5 Abschnitte
- Wir haben Block-Storage auf HPE 3PAR All-Flash über Fibre Channel standardisiert, eine Array-Familie, gewählt und beherrscht, statt eines Menüs von Klassen von den Herstellern, die in diesem Quartal gerade gut im Preis lagen.
- Eine Plattform heißt, dass sich Tiefe aufbaut: Jeder Vorfall, jedes Ersatzteil und jedes Runbook speist dieselbe Fehlerbibliothek, und der Ingenieur in Bereitschaft hat genau dieses Array schon einmal ausfallen sehen.
- Diese Tiefe ist der Grund, warum die Menschen, die antworten, ein krankes Array von einem kranken Pfad unterscheiden können, aus den eigenen Zählern des Arrays und der Pfad-Telemetrie.
- Die Plattform verdient die Tiefe: Mesh-Active-Controller, das Chunklet-Design, das jedes Volume über jedes Laufwerk verteilt, ein ASIC, das die schwere Arbeit übernimmt, und ein unabhängiger Benchmark-Beleg von 545.164 IOPS bei 0,80 ms.
- Wir weichen nur ab, wenn eine Aufgabe es wirklich verdient. Eine bekannte Basis ist das, was eine echte Ausnahme sicher baubar macht.
Unser Block-Storage läuft auf HPE 3PAR All-Flash-Arrays, erreichbar über Fibre Channel. Dieser Satz beschreibt mehr eine Entscheidung als ein Produkt: eine Array-Familie, bewusst gewählt und in der Tiefe gelernt, statt eines Menüs von Storage-Klassen, zusammengestellt aus dem, was der Handel gerade anbot. Dieser Beitrag ist das Plädoyer für diese Entscheidung, und dafür, jeden Anbieter, den Sie prüfen, zu fragen, ob er je eine solche getroffen hat.
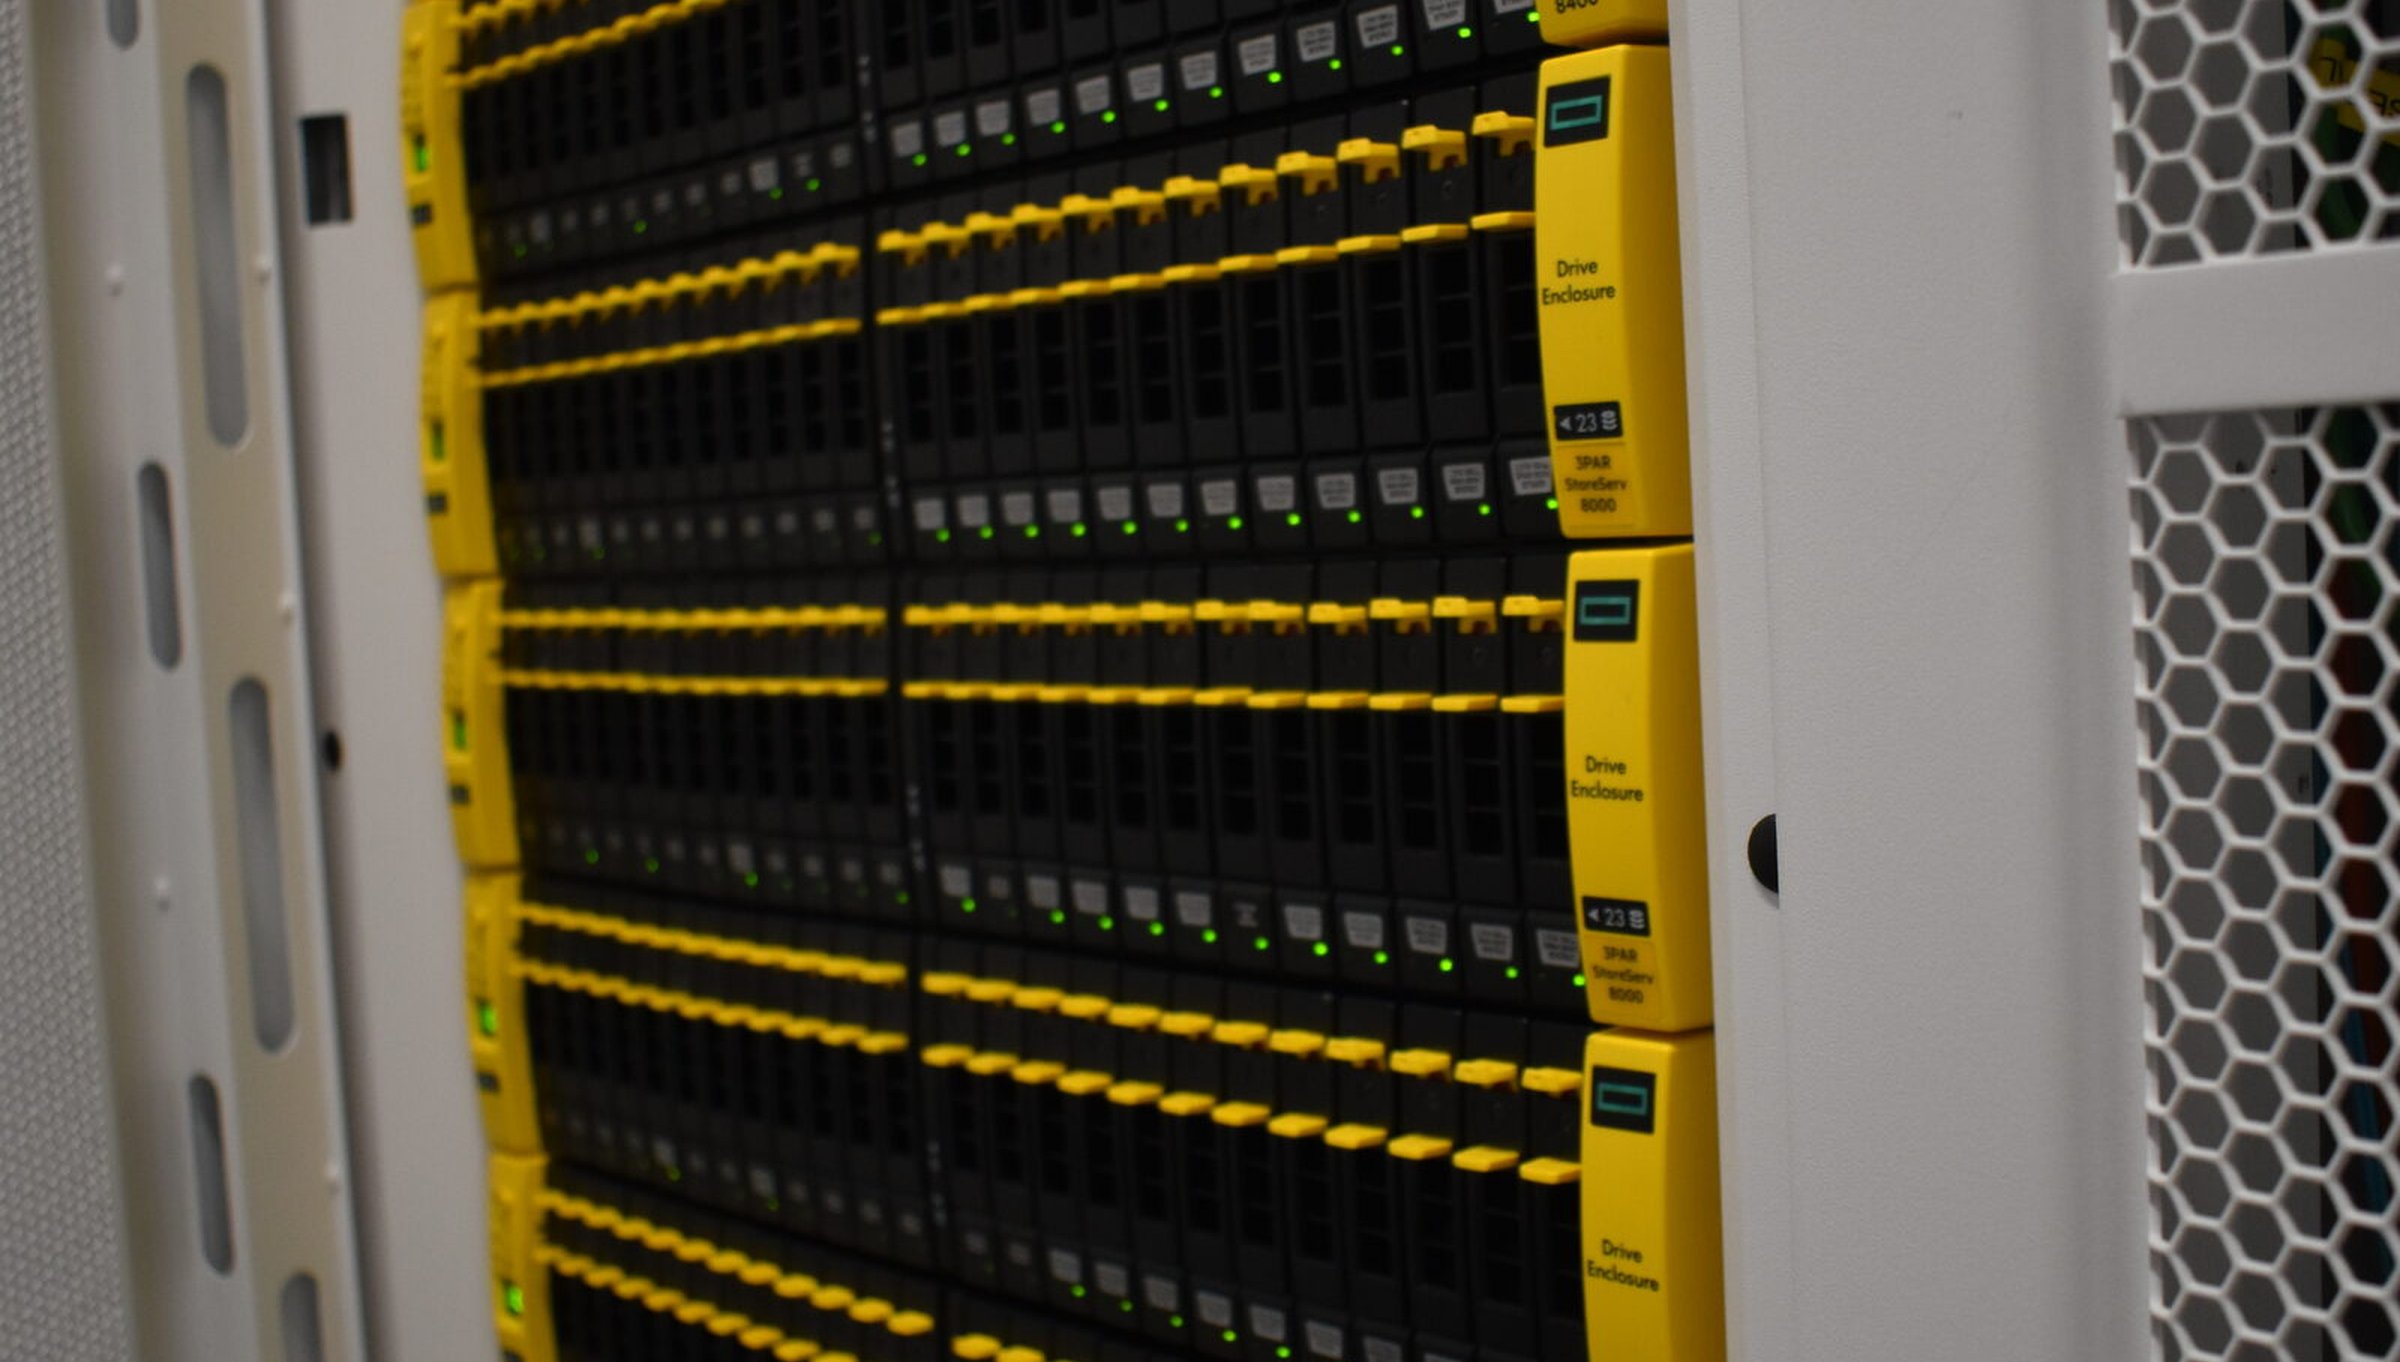
Fünf Storage-Klassen auf einem Menü heißen fünf Plattformen, die flach betrieben werden
Öffnen Sie die Bestellseiten der meisten Anbieter, und Storage ist ein Dropdown: eine SATA-Klasse, eine SSD-Klasse, eine NVMe-Klasse, manchmal eine Performance-Klasse ohne Architektur hinter den Worten. Jede Zeile auf diesem Menü ist eine eigene Plattform, die jemand betreiben muss, mit eigenen Controllern, eigenen Fehlerbildern, eigener Telemetrie und eigenem Pfad für Firmware-Updates. Ein Menü mit fünf Zeilen ist eine Einkaufsfunktion. Es ist auch eine Personalentscheidung, denn die Aufmerksamkeit der Ingenieure teilt sich durch die Zahl der Plattformen, die sie abdecken muss.
Geteilte Aufmerksamkeit ist verlorene Tiefe. Ein Team, das fünf Array-Familien betreibt, hält fünf dünne Scheiben Erfahrung, und wenn eine dieser Plattformen um 3 Uhr morgens Ärger macht, sinkt mit jeder zusätzlichen Zeile auf dem Menü die Wahrscheinlichkeit, dass die Person in Bereitschaft genau diesen Fehler auf genau dieser Maschine schon bearbeitet hat. Wir haben das Menü stattdessen reduziert.
Tiefe baut sich auf, wenn jeder Vorfall auf derselben Plattform landet
Die Beherrschung einer Plattform ist ebenso ein Arbeitsbestand wie ein mentaler: Runbooks, geschrieben gegen die echte Telemetrie dieser Plattform statt gegen ein generisches Handbuch, und Ingenieure im Team, die das Innenleben des Arrays lesen und es bis auf Firmware-Tiefe diagnostizieren können.
Der Aufbau ist der Punkt. Jeder Vorfall, den irgendjemand im Team bearbeitet, wird Teil einer gemeinsamen Fehlerbibliothek für dieselbe Maschine, sodass die zehnte Begegnung mit einer Fehlerklasse aus dem Gedächtnis beginnt statt aus der Dokumentation. Verteilen Sie dieselben Vorfälle über einen Katalog von fünf Plattformen, und die Bibliothek zersplittert: Die meisten Fehler trifft jemand zum ersten Mal, und ein zum ersten Mal angetroffener Fehler dauert am längsten, genau in dem Moment, in dem Ihre Workload es sich am wenigsten leisten kann.
- Fünf Klassen, fünf Plattformen, fünf Sätze von Fehlerbildern zu lernen
- Das Wissen über Vorfälle zersplittert. Die meisten Fehler werden unvorbereitet angetroffen
- Ersatzteile und Firmware-Kompetenz dünn über den Katalog verteilt
- Wenn ein Array Ärger macht, ist der Zug ein Ticket beim Hersteller und Warten
- Eine Array-Familie, gelernt bis hinunter zu ihrer Firmware
- Jeder Vorfall speist dieselbe Fehlerbibliothek
- Runbooks und Routine für eine bekannte Maschine
- Der Ingenieur, der antwortet, hat genau dieses Array schon einmal ausfallen sehen
Was die Tiefe im Alltag bringt
HPE 3PAR Peer Persistence hält Volumes online, wenn ein Array ausfällt, und unsere Ingenieure lesen Servicezeiten und Pfad-Telemetrie auf den Arrays als Routine, sodass eine Storage-Frage vom Array beantwortet wird, nicht aus einer Warteschlange beim Hersteller. Ein krankes Array von einem kranken Pfad zu unterscheiden braucht diese Tiefe, gehalten von denselben Menschen, die das SAN jeden Tag betreiben.
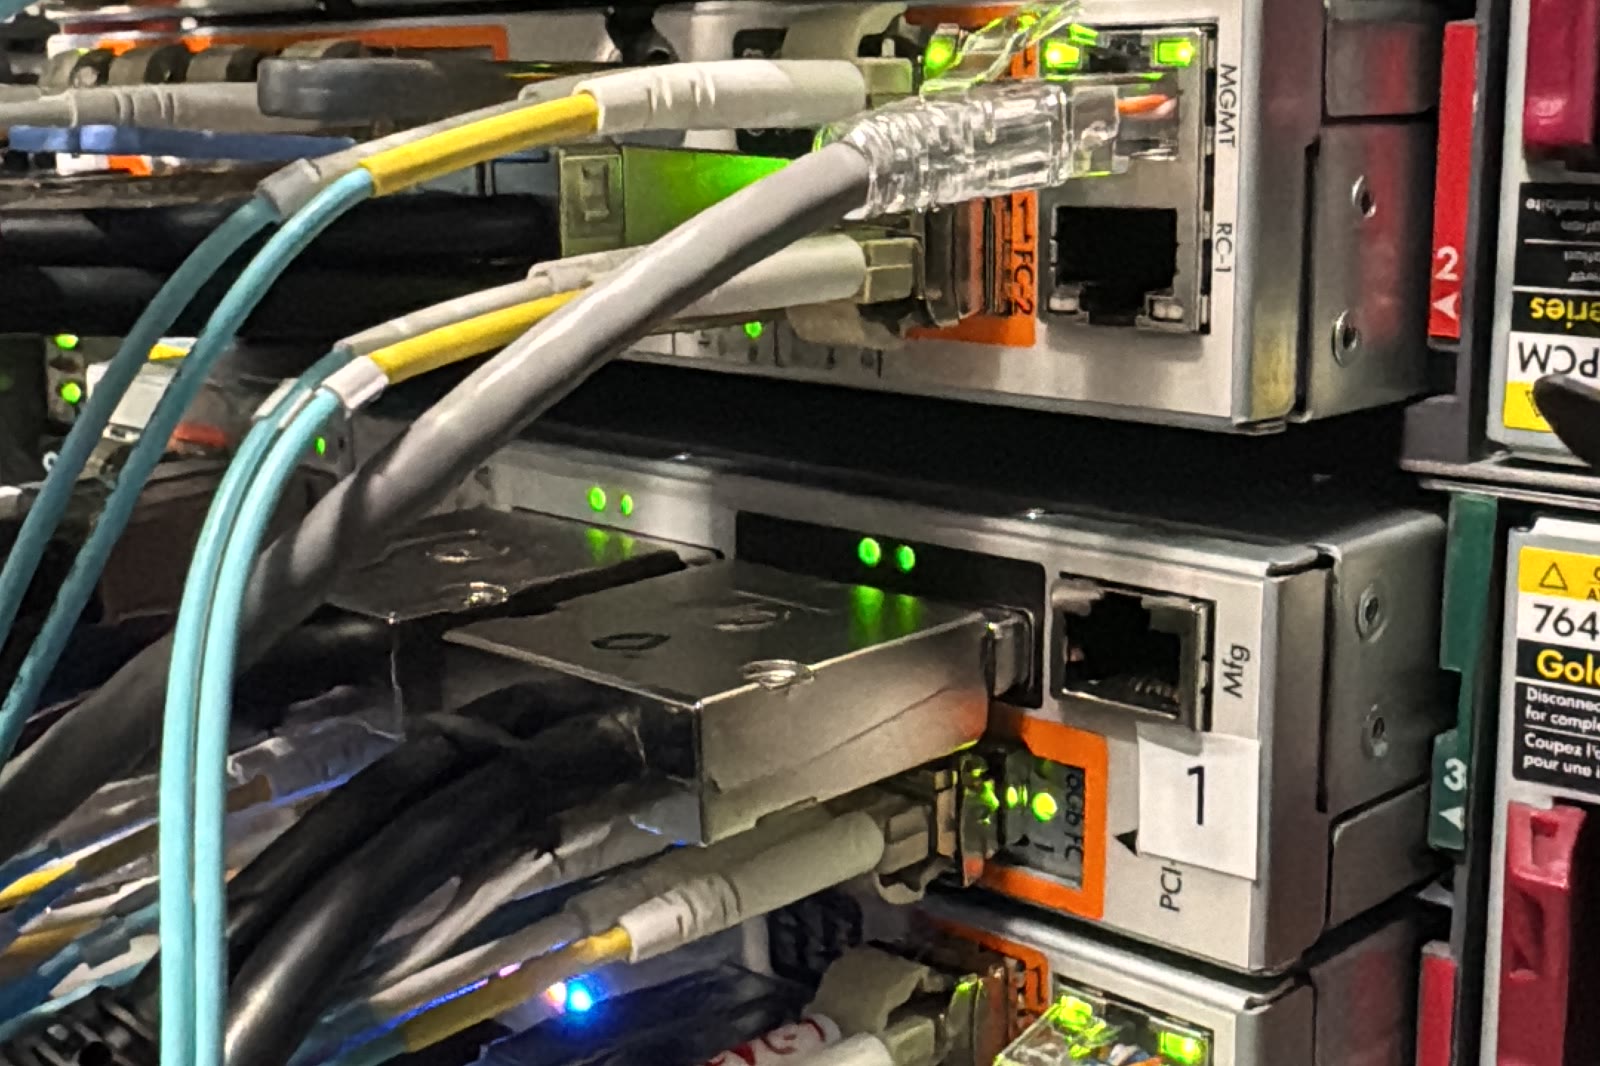
Die Maschine selbst, aus den öffentlichen Unterlagen
Ein kurzer Rundgang durch das, worauf wir standardisiert haben, mit jeder Aussage aus den öffentlichen Unterlagen. Die HPE 3PAR 8450 ist das All-Flash-Modell der 8000-Familie: zwei bis vier Controller-Knoten auf einer passiven Full-Mesh-Backplane, ein Design, das HPE Mesh-Active nennt, weil jedes Volume auf jedem Controller gleichzeitig live ist. Es gibt keinen primären Controller, von dem ein Failover nötig wäre. Die Familie kam Ende 2015 auf den Markt, aber die Herkunft ist älter und besser: 3PAR wurde 1999 von Systemarchitekten von Sun Microsystems gegründet, der Name bedeutet wörtlich 3 Partners, und das Unternehmen war Pionier des Thin Provisioning. 2010 lieferten sich HP und Dell einen öffentlichen Bieterkampf darum, vom Eröffnungsangebot von Dell mit 18 $ je Aktie bis zum siegreichen Gebot von HP mit 33 $, rund 2,35 Milliarden $. Ernsthafte Leute wollten diese Maschine unbedingt.
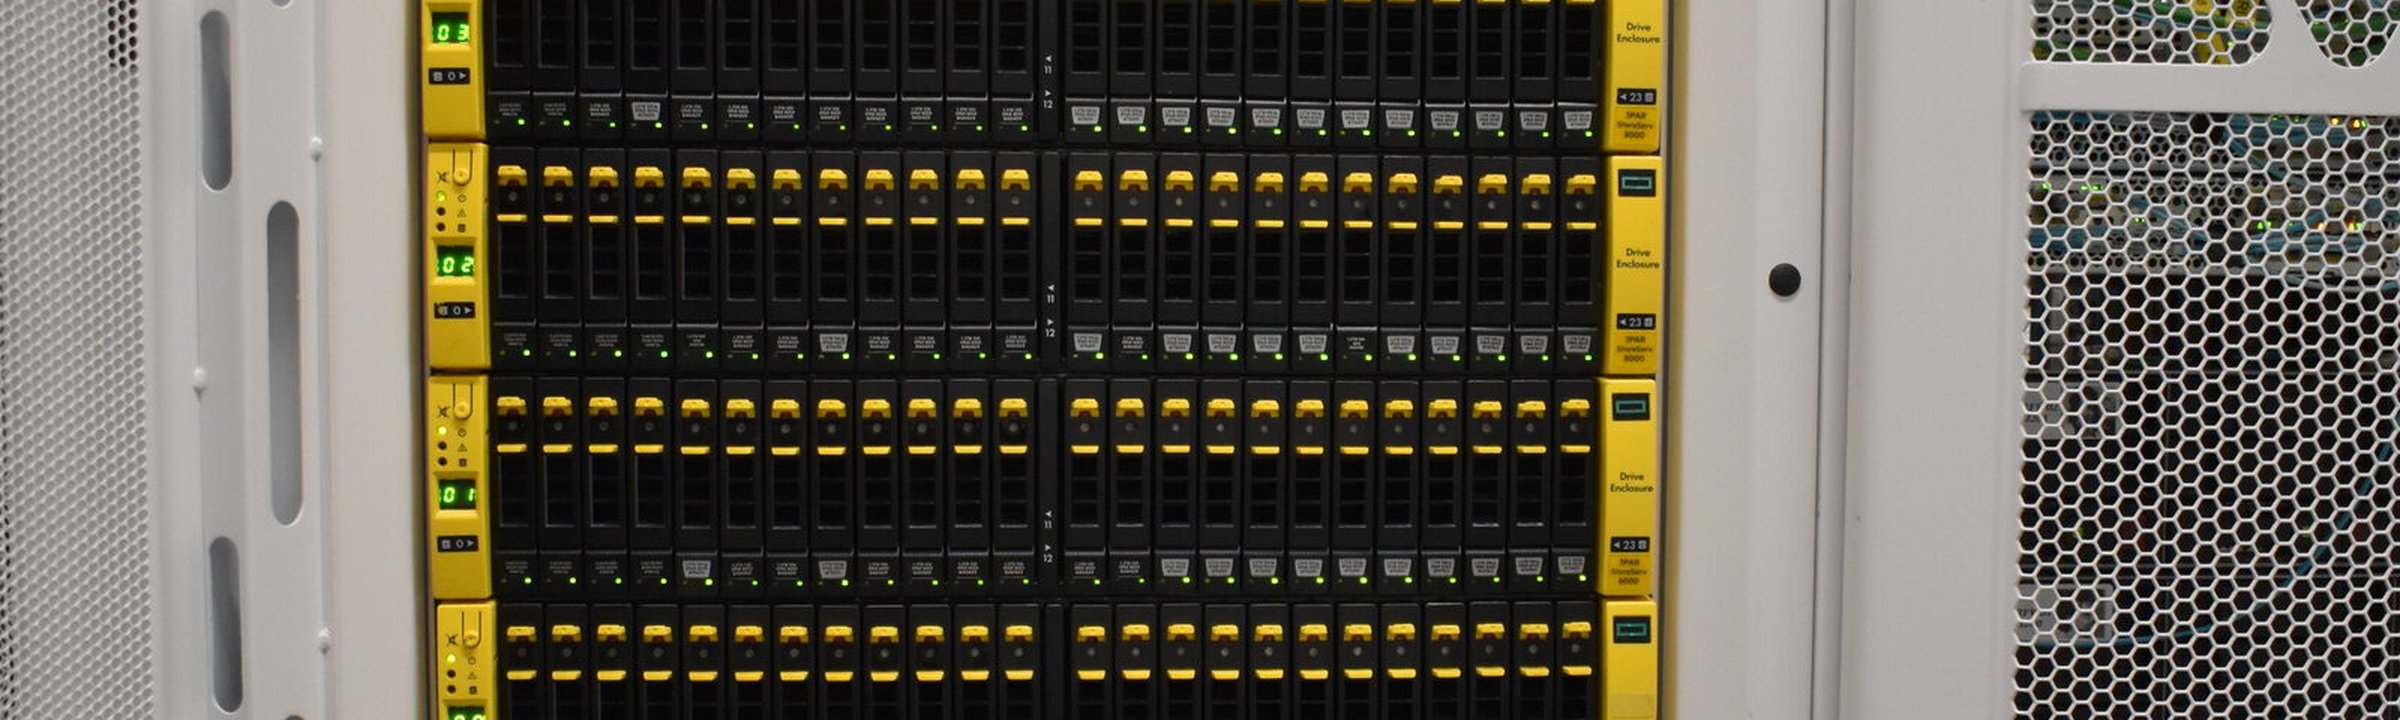
Die Idee, die 3PAR berühmt gemacht hat, ist das Chunklet, der offizielle Begriff im Architekturpapier von HPE. Das Betriebssystem zerlegt jedes Laufwerk in Chunklets von 1 GiB und baut RAID daraus statt aus ganzen Platten, sodass jedes Volume am Ende über jedes Laufwerk verteilt ist, hinter jedem Controller und jedem Port. Daraus folgen zwei Dinge. Performance: Es gibt kein heißes Laufwerk, weil kein Volume auf einer bestimmten Platte liegt. Und Rebuilds: Die Reservekapazität ist über das gesamte Array verstreut statt auf einem untätigen Ersatzlaufwerk geparkt, sodass ein Rebuild viele Laufwerke sind, die gleichzeitig helfen, statt eines Laufwerks, das durch einen Strohhalm trinkt.
Jeder Controller trägt außerdem HPEs Thin Express ASIC, in der 8450 in fünfter Generation, neben der CPU, und erledigt in Silizium die Arbeit, für die Software-Arrays Kerne verbrennen: Nullströme inline erkennen und verwerfen, Blöcke für die Deduplizierung hashen, RAID-Parität berechnen und Ende-zu-Ende-Prüfsummen vom Host-Port bis zum Laufwerk stempeln. Dieser Chip ist ein großer Teil des Grundes, warum das Array Block-I/O ohne Drama bewegt.
Zwei bis vier Controller-Knoten auf einer passiven Full-Mesh-Backplane
Jedes Laufwerk in Chunklets von 1 GiB zerlegt, jedes Volume über alle verteilt
Reservekapazität über das Array verstreut, nicht auf einer untätigen Platte geparkt
Thin Express ASIC, 5. Generation, erledigt RAID und Prüfsummen in Silizium
- ein Controller fällt aus, Konfiguration mit vier Knoten
- der Write-Cache spiegelt sich neu auf die verbleibenden Knoten, kein Kriechen im Write-Through
- ein Port oder Pfad fällt weg
- das Array verlagert den Port selbst, der Host bemerkt es nicht
- ein Laufwerk fällt aus
- Rebuild viele zu vielen aus über das Array verstreuten Reserven
Das sind Aussagen von HPE, aus dem Architekturpapier, nicht unsere Laborergebnisse. Die, die man unterstreichen sollte, ist die erste: HPEs eigenes Papier weist darauf hin, dass Arrays mit zwei Controllern in den Cache-Write-Through fallen, wenn ein Controller ausfällt, was eine höfliche Art ist zu sagen, dass sie kriechen. Eine 3PAR mit vier Knoten hält ihren Write-Cache gespiegelt und macht weiter. Das ist der Unterschied zwischen einem Controller-Ausfall, der in Ihrem Latenzgraphen auftaucht, und einem, der es nicht tut.
545.164
SPC-1 IOPS bei 0,80 ms mittlerer Antwortzeit, gemessen auf einer 8450 unter dem Standard-Storage-Benchmark der Branche
Eine ehrliche Fußnote zu dieser Zahl. HPEs Broschüren geben an, dass die 8000-Familie in Spitzenkonfigurationen über eine Million IOPS skaliert, und die größeren 3PARs gehen noch höher. Die 545 Tausend sind das, was eine 8450 unter dem unabhängigen Benchmark tatsächlich erreicht hat, mit angehängter Preisliste: 23 Cent pro SPC-1 IOPS, das günstigste der zehn schnellsten Arrays auf der Liste zu jener Zeit. Gemessen schlägt Broschüre, also ist die gemessene Zahl die, die wir nennen.
Ein Jahrzehnt in Produktion bedeutet, dass die Firmware ausgereift ist, die Fehlerbilder dokumentiert sind, die Teile reichlich vorhanden sind und nichts, was diese Maschine tut, die Ingenieure überrascht, die sie beherrschen. Das ist unsere Doktrin in einem Satz, und sie hat ihren eigenen Beitrag: Kaufen Sie die ernsthafte Maschine.
Wir weichen nur ab, wenn die Aufgabe es verdient
Standardisierung ohne Ausstiegsklausel ist Dogma, also hier unsere: Wir weichen nur ab, wenn eine Aufgabe es wirklich verdient. Die allgemeine Fassung dieses Arguments, einschließlich der Frage, warum eine bekannte Basis das ist, was eine echte Ausnahme sicher konstruierbar macht, behandelt neben Storage auch unsere Entscheidungen zu Netzwerk, Compute und Fabric in Wir haben eine Meinung zur Hardware. Dies ist das Storage-Kapitel.
Wenn Sie einen Anbieter prüfen, stehen die Storage-Fragen, die sich zu stellen lohnen, einschließlich derer, die die meisten Anbieter nicht beantworten können, in Das schmutzige Geheimnis Ihres Hosters ist sein Storage.
Klare Antworten
Ist die Standardisierung auf einen Storage-Hersteller nicht ein Lock-in-Risiko?+
Es ist eine Abhängigkeit, die wir mit offenen Augen gewählt haben. Welche Plattform ein Anbieter auch betreibt, Sie sind an seine Fähigkeit gebunden, sie zu betreiben, und ein Menü mit fünf Herstellern verteilt dieselbe Abhängigkeit auf fünf Plattformen, ohne die Tiefe einer einzigen zu halten. Wir sind lieber an eine Plattform gebunden, die wir bis auf Firmware-Tiefe diagnostizieren können, als frei in der Wahl zwischen Plattformen, die wir nur oberflächlich kennen.
Was ändert die Nutzung einer einzigen Array-Familie?+
Jeder Vorfall, jedes Ersatzteil und jedes Runbook erweitert das Wissen des Teams über dieselbe Plattform. Das Argument hier ist betriebliche Tiefe: Ingenieure im Team, die das Innenleben des Arrays lesen und seine Fehlerbilder erkennen können.
Was heißt «beherrscht» in der Praxis?+
Runbooks für eine bekannte Maschine und ein Bereitschaftsdienst, in dem die Person, die antwortet, die Ausfälle dieser Plattform schon bearbeitet hat. Wenn Storage Ärger macht, ist das der Unterschied zwischen einer laufenden Diagnose und einem Ticket, das in Ihrem Namen beim Hersteller eröffnet wurde.
Stellen Sie Ihre Storage-Fragen den Menschen, die das Array betreiben
Die Storage- und Fabric-Ingenieure, die unser SAN Tag für Tag betreiben, sind dieselben Menschen, die antworten. Fragen Sie sie, was Ihre Workload darunter braucht.
Mit einem Ingenieur sprechenSie haben das Ende erreicht.
Setzen Sie das Gelesene um
Was betreiben Sie?
Erzählen Sie uns von Workload, Traffic und Anforderungen an die Wiederherstellung. Beginnen Sie mit dem Server-Konfigurator oder besprechen Sie die Details mit einem Ingenieur.
Geschrieben von den Ingenieuren, die die beschriebene Infrastruktur bauen und betreiben.Mit einem Ingenieur sprechen