

Nous avons des avis tranchés sur le matériel, pour que vous n'ayez pas à en avoir.
Standardiser les décisions d'infrastructure ennuyeuses, c'est le service. Cela fait de votre charge de travail la seule variable qui reste dans la pièce.
Dans cet article 4 sections
- Nous avons standardisé les couches qui ne devraient jamais se jouer à pile ou face : stockage HPE 3PAR all-flash, double Brocade Fibre Channel, notre propre réseau, notre propre calcul.
- Standardiser n'est pas être rigide. Nous ne dévions que lorsque votre travail le mérite, et nous construisons l'exception parce que la base est connue par cœur.
- Une stack bien comprise fait corriger les pannes plus vite que dix stacks improvisées. C'est pour cela que cela se voit dans votre uptime.
Ouvrez un bon de commande de serveur typique et comptez les décisions qu'il vous demande de prendre. Classe de stockage. Niveau RAID. Agrégation des cartes réseau. Backplane. Hyperviseur. Cible de sauvegarde. Mode de réplication. Chacune est un embranchement, et chaque embranchement qu'on vous remet est un devoir à la maison.
h2 (#choice-is-a-cost): Le choix est un coût
Un long configurateur a l'air généreux, mais chaque case qu'il contient vous appartient. Vous choisissez la classe de stockage, et si les IOPS se révèlent inadaptés à votre base de données, c'est votre choix. Chaque option que vous retenez devient la vôtre à expliquer quand l'alerte se déclenche à 3 heures du matin.
Nous pensons que c'est à l'envers. L'infrastructure sous votre application n'est pas l'endroit où exprimer votre individualité. C'est l'endroit où vous voulez le moins de surprises. Nous avons donc pris ces décisions une fois, délibérément, et nous assumons chacune d'elles. Ce que vous configurez avec nous, c'est votre charge de travail. Tout ce qui est en dessous, nous l'avons déjà réglé.
Les décisions que nous avons retirées de votre assiette sont celles qui échouent en silence pendant des mois, puis toutes à la fois. Les standardiser n'est pas de l'inflexibilité de notre part. C'est prendre à notre charge un risque qu'il nous revient de chiffrer.
h2 (#what-we-standardized): Ce que nous avons standardisé, et pourquoi
h3 (#storage): Stockage : HPE 3PAR all-flash
Le stockage bloc vit sur du HPE 3PAR all-flash, actif-actif au sein du site avec Peer Persistence, et répliqué vers un second site. Pas une classe vers laquelle on monte en gamme. Le bon stockage est le seul stockage. Vous le voyez sur la page private cloud, et le mur de disques est sur les photos de notre page à propos, parce que c'est notre mur, pas celui d'une banque d'images.
h3 (#fabric): Fabric : double Brocade Fibre Channel
Le stockage atteint le calcul par un double Brocade Fibre Channel, en multipath. Les fabrics Brocade font partie de la doctrine depuis plus de dix ans et n'en sont jamais sortis.
h3 (#network): Réseau : le nôtre
Votre trafic voyage sur notre propre réseau : notre propre système autonome, un peering bilatéral au GR-IX, des Cisco ASR 9000 series en edge et du Nexus 9000 leaf-spine en dessous, avec EVPN/VXLAN qui découpe un vrai fabric par tenant sur notre propre silicium.
h3 (#compute): Calcul : nos propres serveurs
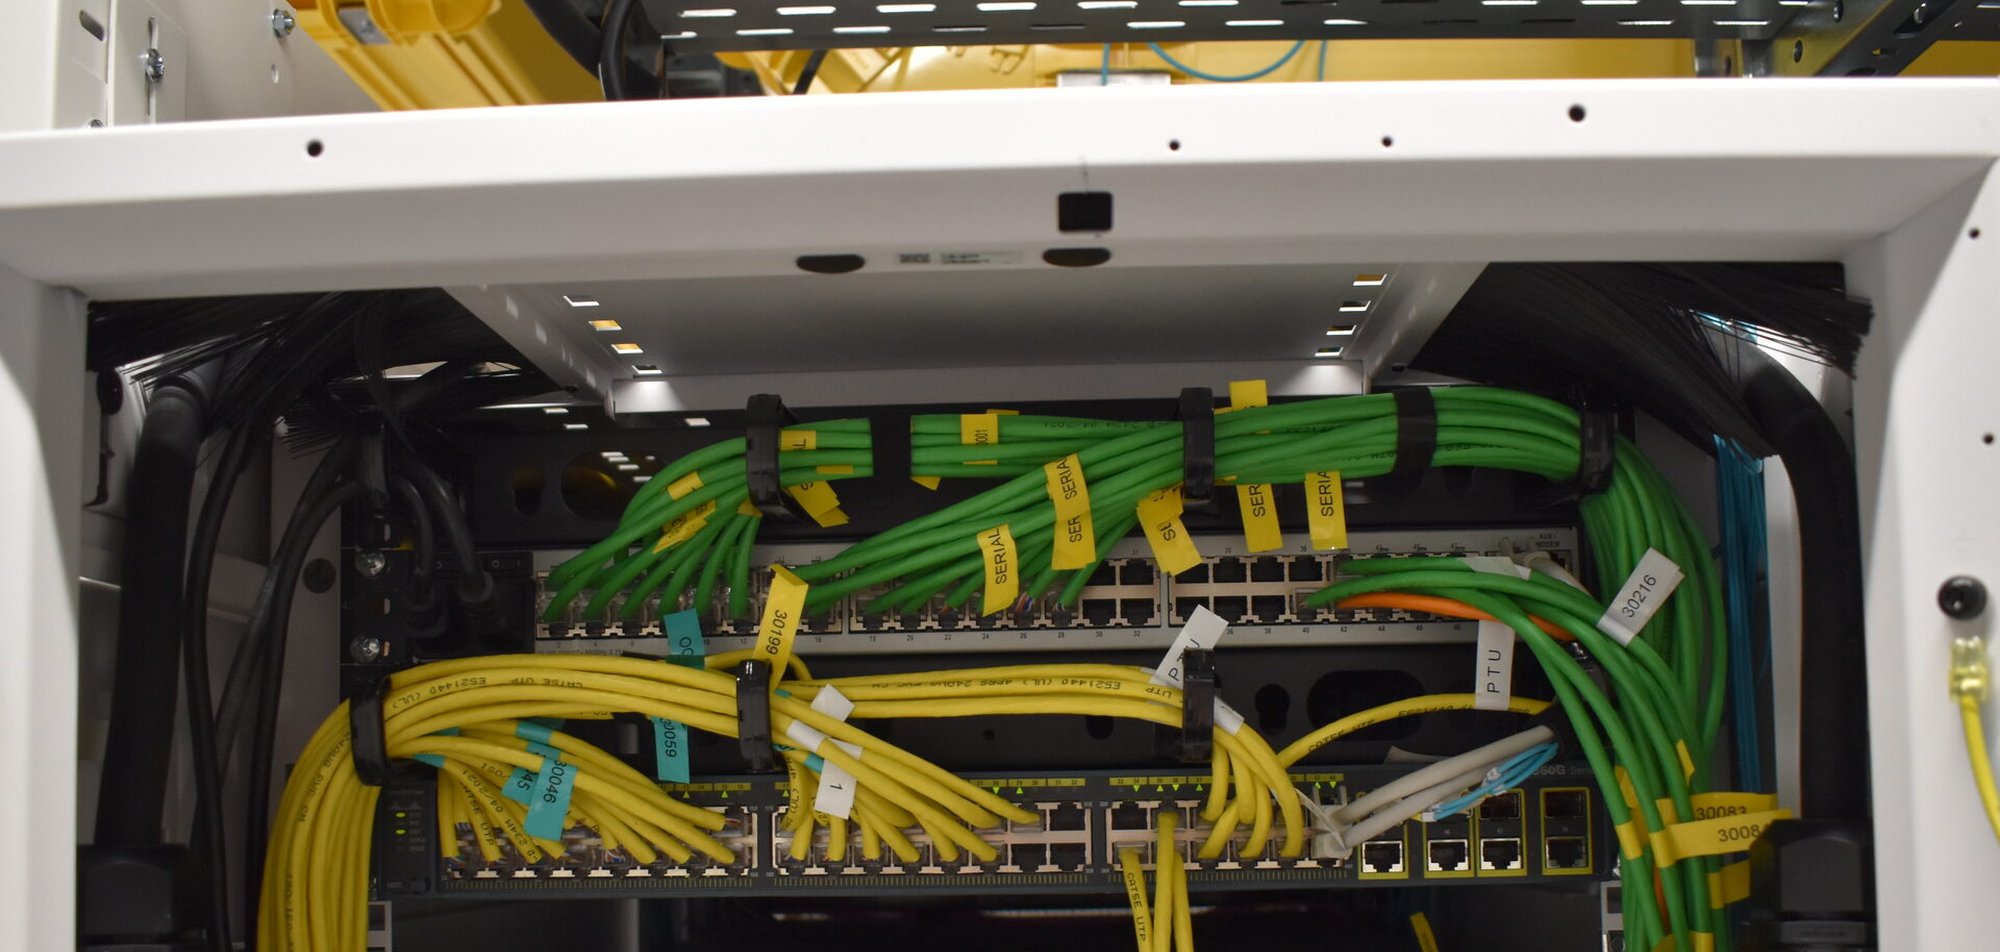
Les machines sont les nôtres : du calcul HPE et Dell dans une cage que nous avons construite et étiquetée nous-mêmes. Posséder l'équipement est ce qui nous permet d'assumer la fiabilité que nous vendons, et le nôtre nous appartient depuis 2004.
- RÉSEAU EN PROPRE
- notre propre système autonome, de l'edge au spine
- PEERING AU GR-IX
- bilatéral, à l'exchange
- FÉDÉRATION HPE 3PAR
- all-flash, actif-actif sur site, répliqué vers un second site
- FABRIC PAR TENANT
- EVPN/VXLAN, isolé par tenant
h2 (#deviate-when-earned): Nous ne dévions que lorsque votre travail le mérite
Rien de tout cela ne veut dire que la réponse est toujours la même machine. Cela veut dire que le point de départ l'est. La standardisation est ce qui rend possible une vraie exception : parce que nous savons exactement comment la base se comporte, nous pouvons dire précisément où votre charge de travail la quitte et construire l'écart à dessein, pas à l'aveugle. Quatre sockets quand le travail en demande quatre. Un private cloud sur mesure quand l'objectif de fiabilité le mérite. L'exception est conçue, pas improvisée, et ce n'est vrai que lorsque la règle est solide.
h2 (#shows-up-in-uptime): Pourquoi cela se voit dans votre uptime
La fiabilité n'est pas un composant que l'on achète. C'est ce qui se produit quand une panne rencontre une stack que l'ingénieur d'astreinte comprend déjà.
Une alerte se déclenche à 3 heures du matin. Que regarde l'ingénieur d'astreinte ?
Une première rencontre, chaque fois
Chaque client a improvisé une stack différente, donc chaque panne est une première rencontre, et les premières rencontres sont lentes.
Une panne qu'il a déjà corrigée
Même fabric, même stockage et même réseau sous tout le monde. L'ingénieur a déjà vu exactement cette classe de panne. La surface est familière, donc la correction est rapide.
Réponses directes
Puis-je apporter ma propre préférence en matériel ?+
Vous pouvez nous dire ce dont le travail a besoin et nous construirons pour cela, jusqu'à la machine de référence et au-delà. Ce que vous ne pouvez pas faire, c'est dégrader les parties que nous avons standardisées pour réduire le coût, parce que ce sont les parties qui tombent en panne sans prévenir et emportent votre uptime avec elles. Nous dévions quand la charge de travail le mérite, pas quand cela rogne un angle.
Faites-vous tourner du stockage qui ne soit pas du 3PAR ?+
La fédération 3PAR est la base pour tout ce qui exige une fiabilité réelle, et c'est ce que nous photographions et publions. Si une charge de travail n'a vraiment pas besoin de stockage bloc fédéré, nous le dirons et nous vous ferons un prix sans, plutôt que de vous vendre un stockage que vous n'utiliserez pas. La réponse honnête pointe parfois vers le bas.
Ma machine est-elle partagée avec quelqu'un ?+
Sur du matériel dédié, non. Le numéro de série est sur votre facture, et vos cœurs sont vos cœurs. Sur un private cloud, le fabric de votre tenant est isolé par EVPN/VXLAN. Dans les deux cas, l'isolation est réelle, pas un réglage.
Alors, que me reste-t-il vraiment à décider ?+
Votre charge de travail : la taille du travail, la façon dont il grandit, et l'objectif de fiabilité qu'il doit atteindre. C'est le seul embranchement qui a toujours été le vôtre. Le guide de dimensionnement dédié vous propose plus petit si vous visez trop haut, et le parcours private cloud existe pour quand l'objectif de fiabilité le mérite.
Nous avons des avis tranchés sur le matériel pour une raison : pour que vous n'ayez jamais à en avoir. Dimensionnez votre charge de travail et laissez le reste réglé. Le parcours private cloud est là quand l'objectif de fiabilité le mérite, et le pedigree derrière tout cela se trouve sur la page à propos.
Voyez le métal sur lequel nous nous sommes standardisés.
La configuration de référence, le matériel derrière elle, et le prix qui sera le même l'an prochain.
Voir le métalVous êtes arrivé à la fin.
Mettez la lecture en pratique
Que faites-vous tourner ?
Parlez-nous de la charge de travail, du trafic et des exigences de reprise. Commencez par le configurateur de serveur, ou passez en revue les détails avec un ingénieur.
Écrit par les ingénieurs qui construisent et exploitent l'infrastructure qu'il décrit.Parler à un ingénieur