

Perché abbiamo standardizzato su HPE 3PAR all-flash
Facciamo girare il block storage su una sola piattaforma, HPE 3PAR all-flash su Fibre Channel, e l'abbiamo imparata in profondità di proposito. Quella profondità è ciò che permette all'ingegnere reperibile di leggere la telemetria dell'array stesso invece di aprire un case al vendor.
In questo articolo 5 sezioni
- Abbiamo standardizzato il block storage su HPE 3PAR all-flash su Fibre Channel, una sola famiglia di array scelta e padroneggiata invece di un menu di livelli da qualunque vendor avesse un buon prezzo quel trimestre.
- Una sola piattaforma significa che la profondità si accumula: ogni incidente, ricambio e runbook alimenta la stessa libreria di guasti, e l'ingegnere reperibile ha già visto guastarsi esattamente questo array.
- Quella profondità è il motivo per cui le persone che rispondono sanno distinguere un array malato da un percorso malato, dai contatori dell'array stesso e dalla telemetria dei percorsi.
- La piattaforma si merita quella profondità: controller mesh-active, il design a chunklet che distribuisce ogni volume su ogni disco, un ASIC che fa il lavoro pesante, e la ricevuta di un benchmark indipendente di 545.164 IOPS a 0,80 ms.
- Deviamo solo quando un lavoro se lo merita davvero. Una baseline nota è ciò che rende sicura da costruire una vera eccezione.
Il nostro block storage gira su array HPE 3PAR all-flash, raggiunti su Fibre Channel. Quella frase descrive una decisione più che un prodotto: una sola famiglia di array, scelta deliberatamente e imparata in profondità, invece di un menu di livelli di storage assemblato da qualunque cosa offrisse il canale. Questo articolo è il caso a favore di quella decisione, e a favore del chiedere a qualsiasi provider che valutate se ne abbia mai presa una simile.
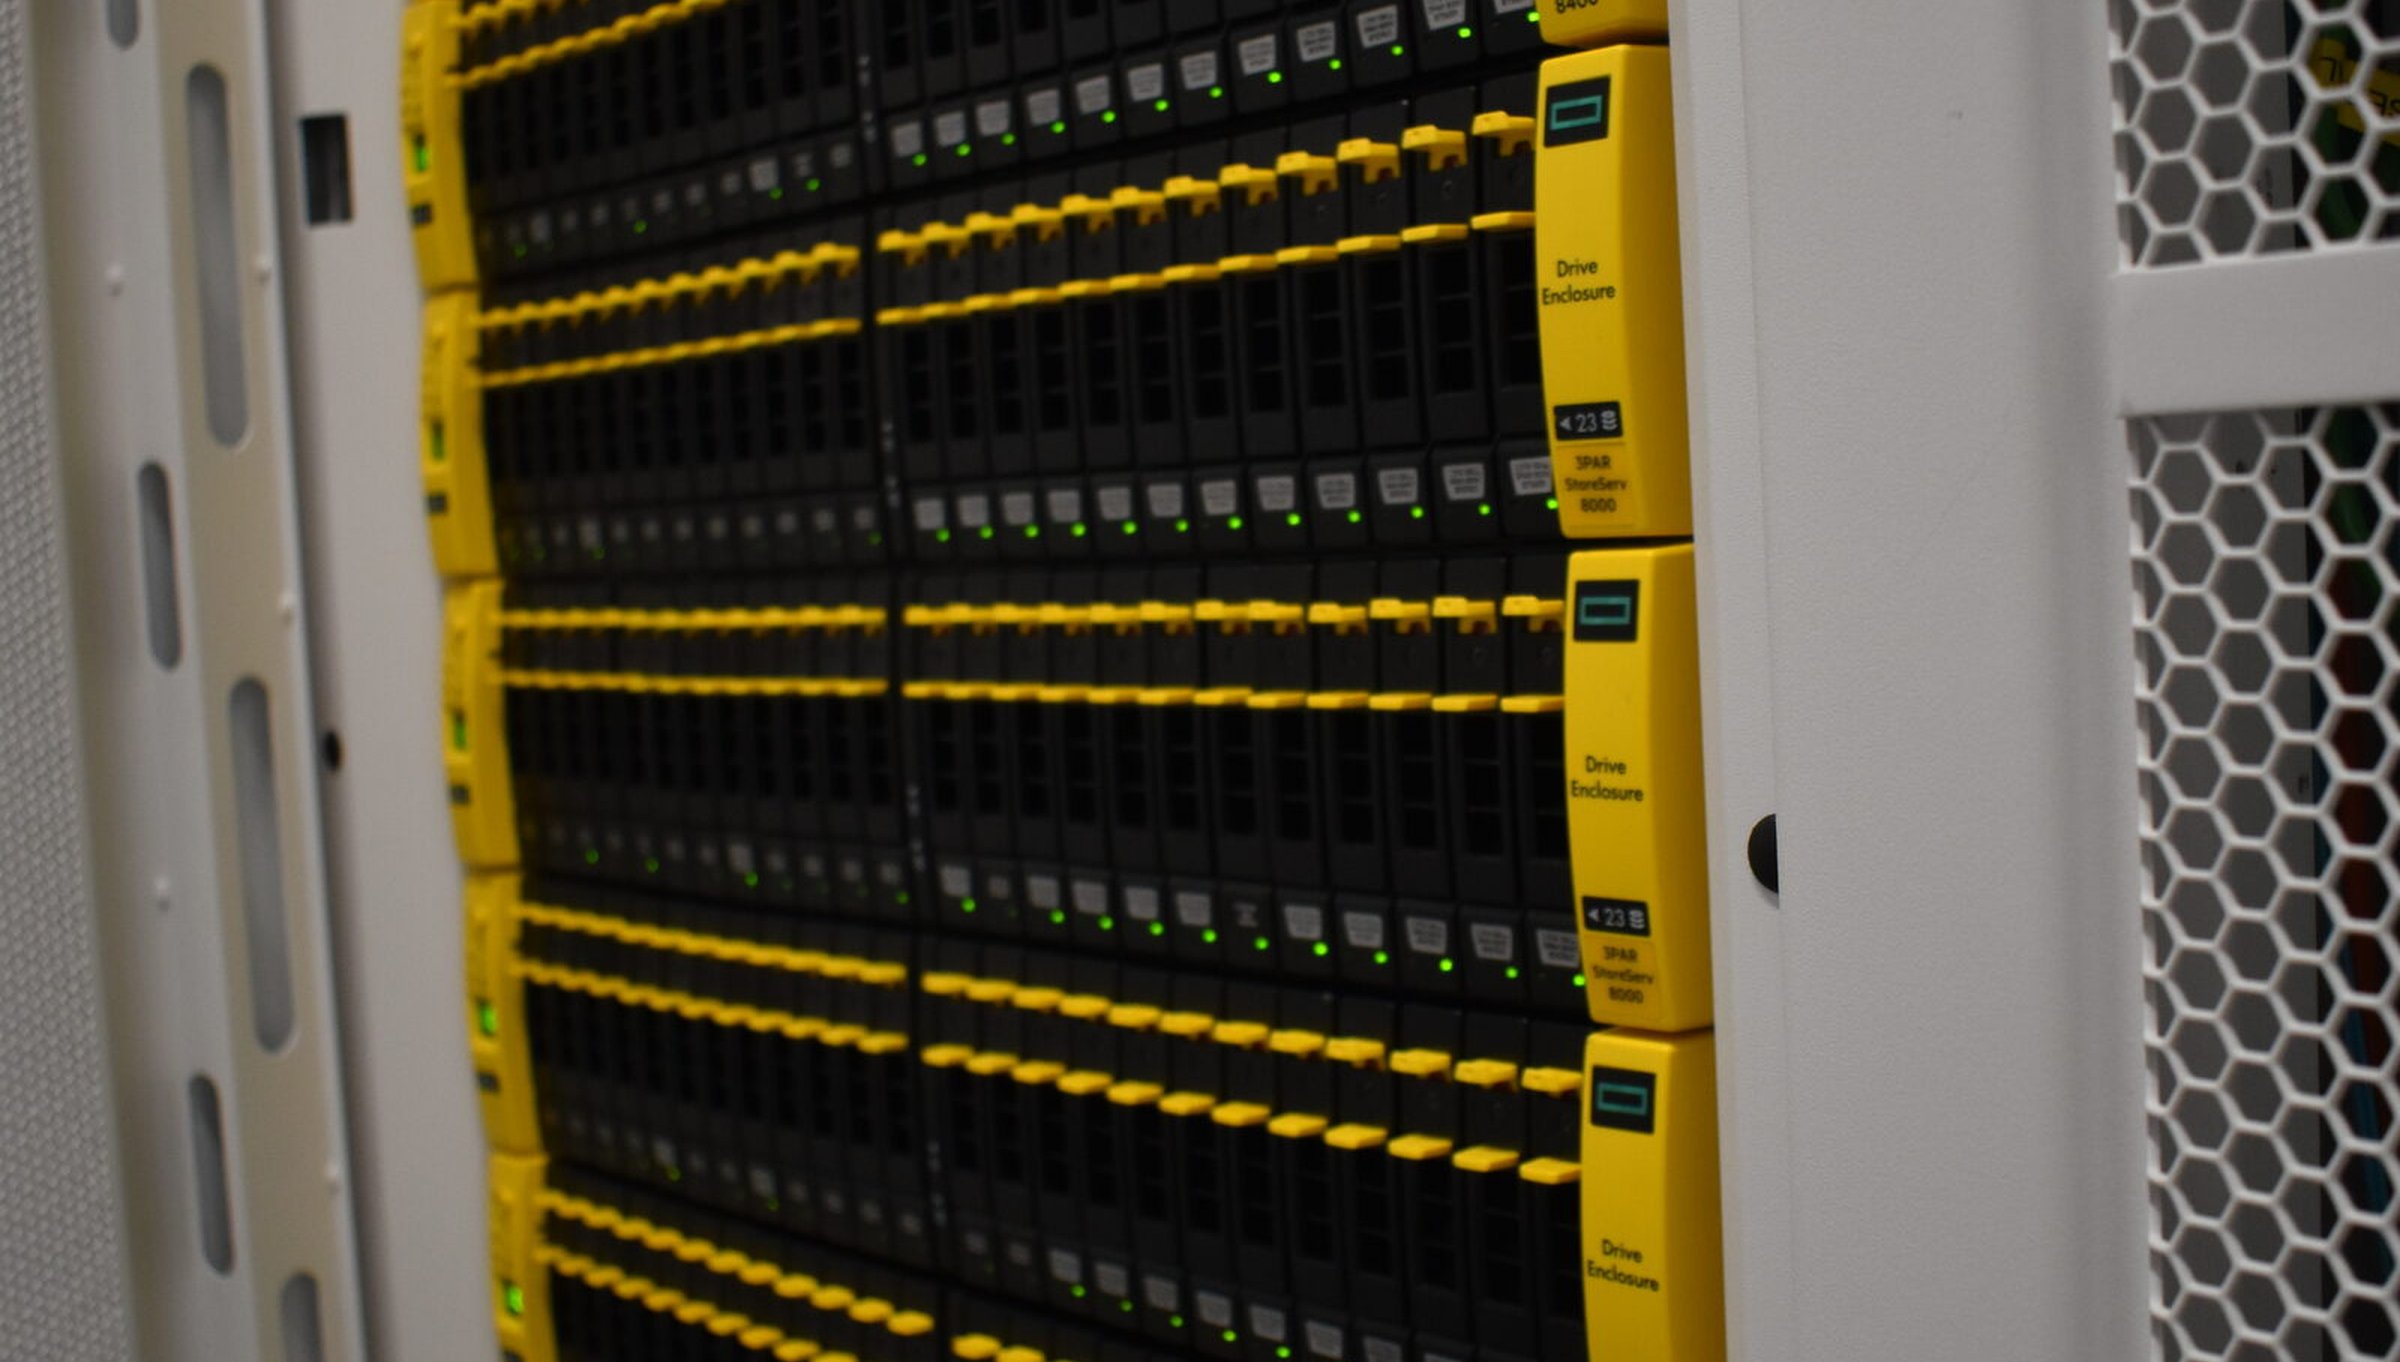
Cinque livelli di storage su un menu significano cinque piattaforme gestite in superficie
Aprite le pagine d'ordine della maggior parte dei provider e lo storage è un menu a tendina: un livello SATA, un livello SSD, un livello NVMe, a volte un livello performance senza alcuna architettura legata alle parole. Ogni riga di quel menu è una piattaforma distinta che qualcuno deve gestire, con i propri controller, i propri modi di guasto, la propria telemetria e il proprio percorso di aggiornamento firmware. Un menu a cinque righe è una funzione commerciale. È anche una decisione sul personale, perché l'attenzione ingegneristica si divide per il numero di piattaforme che deve coprire.
L'attenzione divisa è profondità perduta. Un team che gestisce cinque famiglie di array possiede cinque sottili fette di esperienza, e quando una di quelle piattaforme si comporta male alle 3 di notte, le probabilità che la persona reperibile abbia già lavorato esattamente a questo guasto su esattamente questa macchina calano con ogni riga in più nel menu. Noi abbiamo ridotto il menu, invece.
La profondità si accumula quando ogni incidente atterra sulla stessa piattaforma
La padronanza di una piattaforma è un inventario di lavoro oltre che mentale: runbook scritti sulla telemetria reale di questa piattaforma invece che su un manuale generico, e ingegneri in organico in grado di leggere gli interni dell'array e diagnosticarlo a livello di firmware.
L'accumulo è il punto. Ogni incidente che chiunque nel team lavora diventa parte di una libreria di guasti condivisa per la stessa macchina, così il decimo incontro con una classe di guasto parte dalla memoria invece che dalla documentazione. Distribuite gli stessi incidenti su un catalogo di cinque piattaforme e la libreria si frammenta: la maggior parte dei guasti viene affrontata da qualcuno che li vede per la prima volta, e un guasto affrontato per la prima volta richiede più tempo esattamente nel momento in cui il vostro carico può permetterselo meno.
- Cinque livelli, cinque piattaforme, cinque insiemi di modi di guasto da imparare
- La conoscenza degli incidenti si frammenta. La maggior parte dei guasti viene affrontata a freddo
- Ricambi e competenza sul firmware spalmati sottili su tutto il catalogo
- Quando un array si comporta male, la mossa è un ticket al produttore e un'attesa
- Una sola famiglia di array, imparata fino al suo firmware
- Ogni incidente alimenta la stessa libreria di guasti
- Runbook e memoria muscolare per una macchina nota
- L'ingegnere che risponde ha già visto guastarsi esattamente questo array
Cosa compra la profondità, giorno per giorno
HPE 3PAR Peer Persistence mantiene i volumi online se un array va giù, e i nostri ingegneri leggono tempi di servizio e telemetria dei percorsi sugli array come routine, così una domanda sullo storage trova risposta dall'array, non da una coda del vendor. Distinguere un array malato da un percorso malato richiede quella profondità, posseduta dalle stesse persone che gestiscono il SAN ogni giorno.
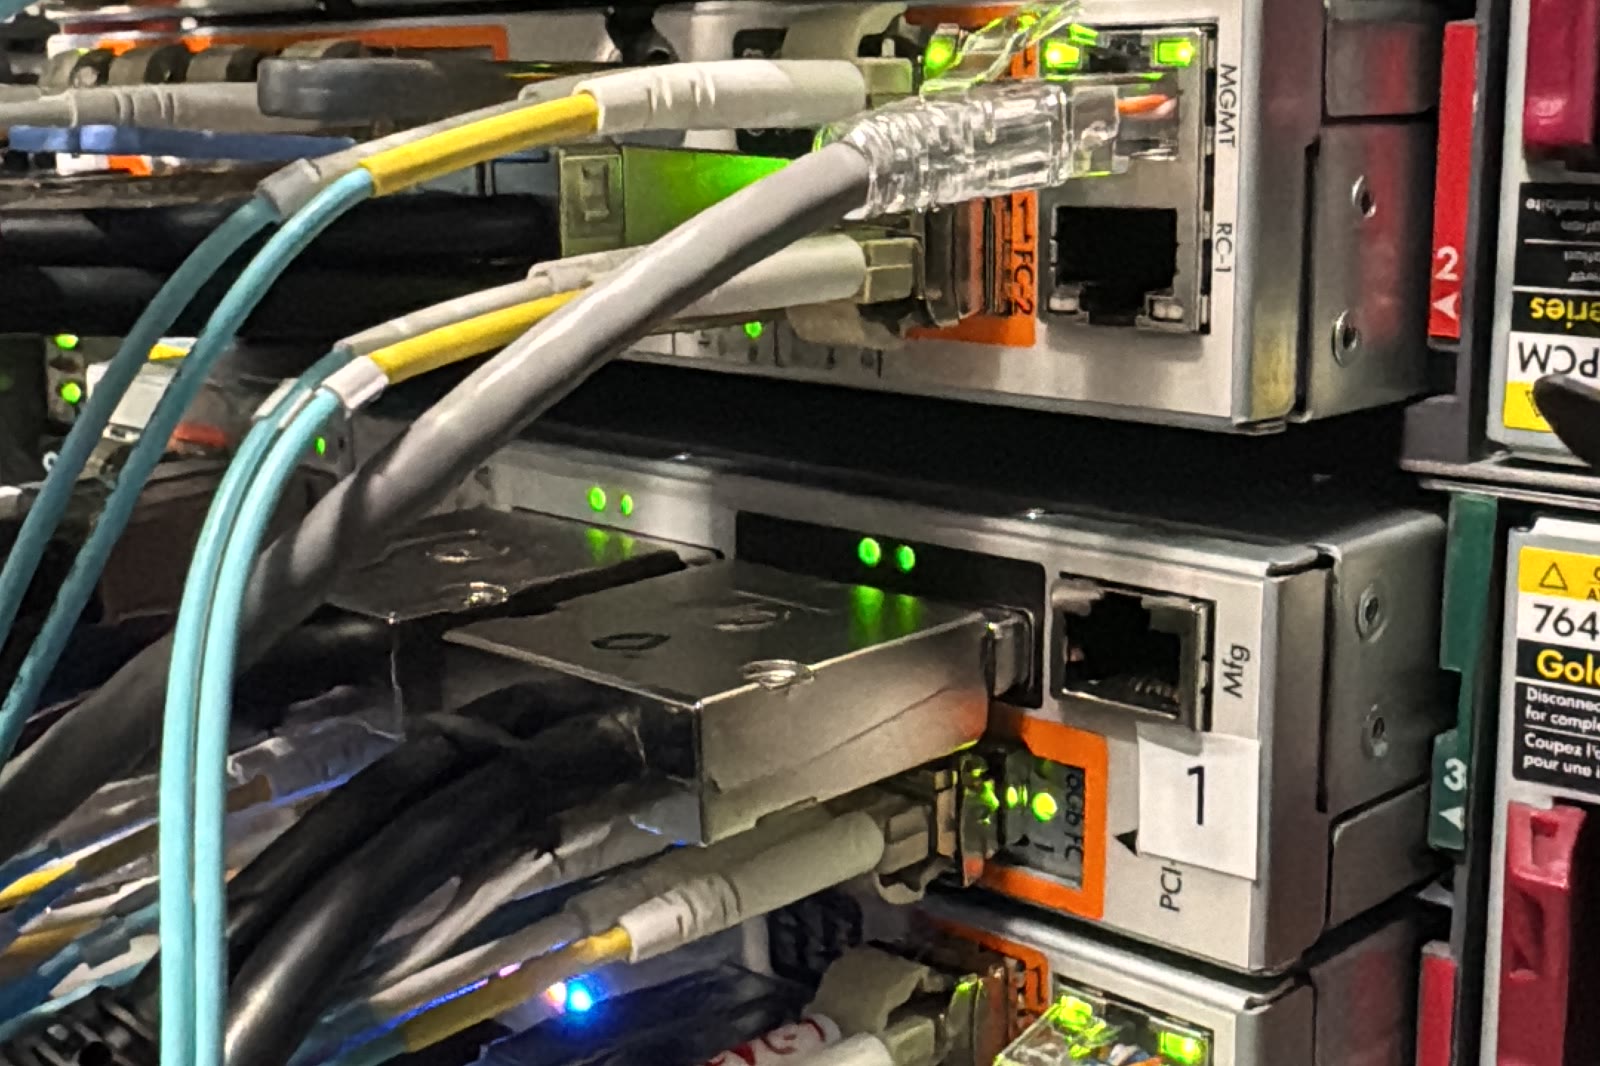
La macchina in sé, dagli atti pubblici
Un breve giro di ciò su cui abbiamo standardizzato, con ogni affermazione presa dagli atti pubblici. L'HPE 3PAR 8450 è il modello all-flash della famiglia 8000: da due a quattro nodi controller su un backplane passivo full-mesh, un design che HPE chiama Mesh-Active perché ogni volume è attivo su ogni controller contemporaneamente. Non c'è un controller primario da cui fare failover. La famiglia è uscita a fine 2015, ma il pedigree è più vecchio e migliore: 3PAR è stata fondata nel 1999 da architetti di sistema di Sun Microsystems, il nome significa letteralmente 3 Partners, e l'azienda ha aperto la strada al thin provisioning. Nel 2010 HP e Dell si sono contese pubblicamente l'azienda a colpi di offerte, dai 18 $ per azione iniziali di Dell ai 33 $ vincenti di HP, circa 2,35 miliardi di dollari. Persone serie volevano questa macchina con forza.
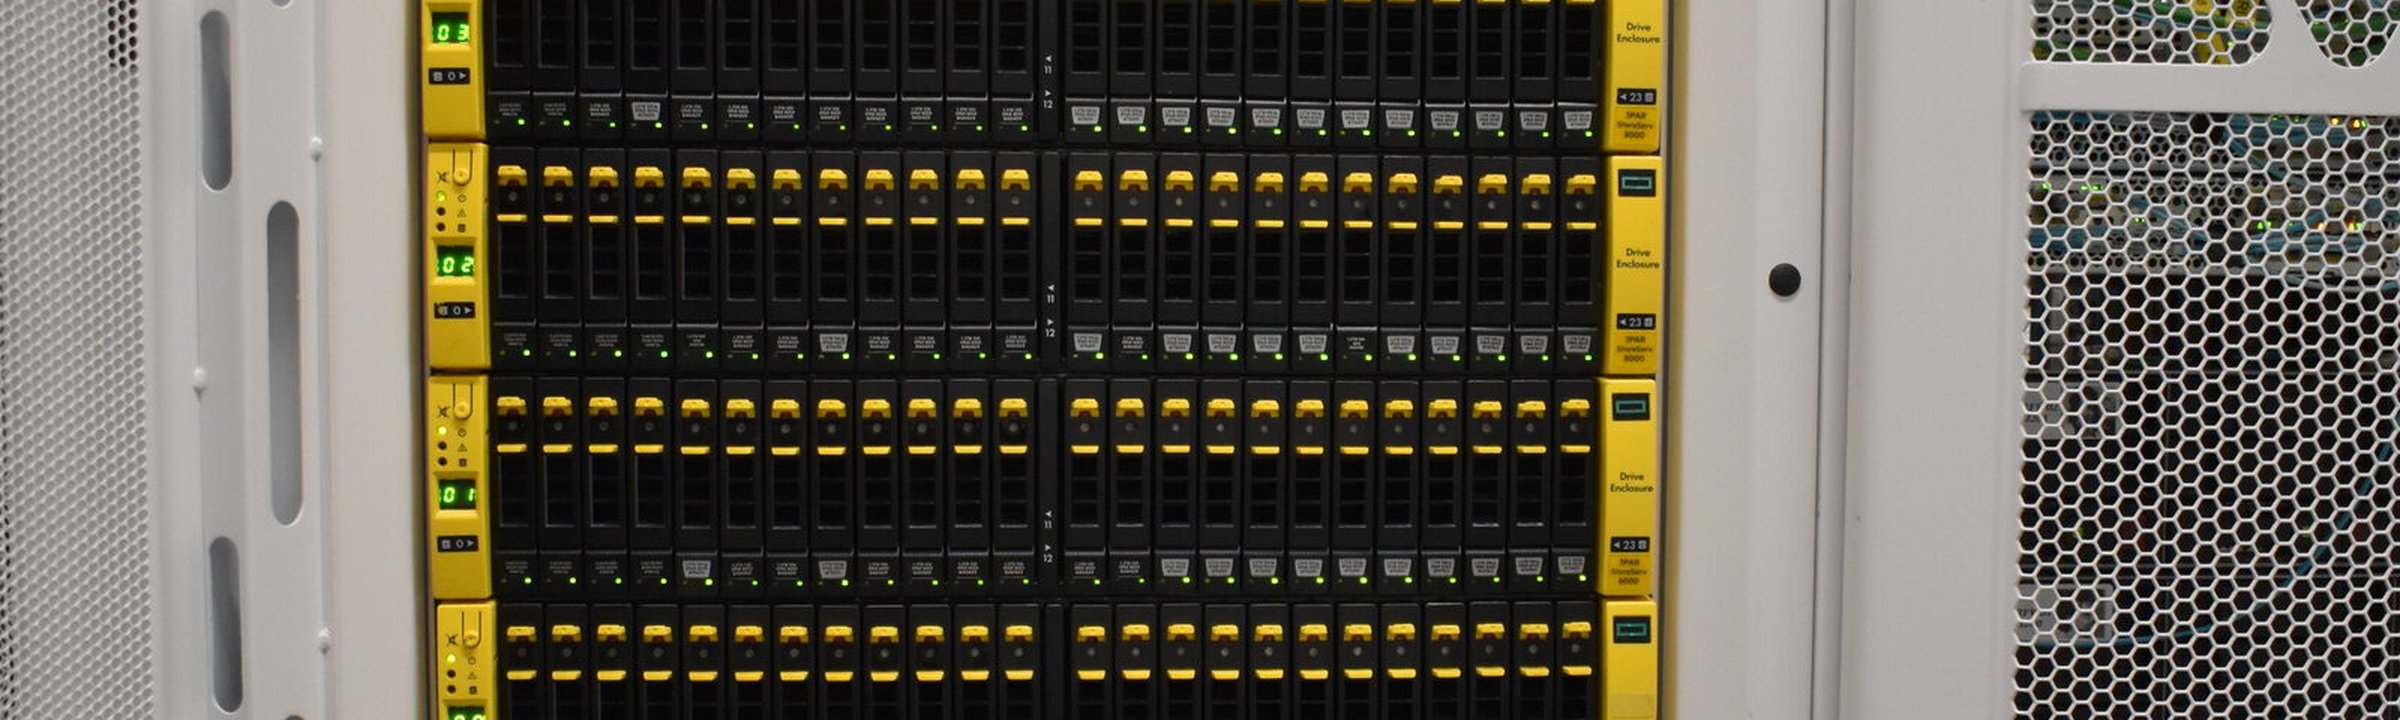
L'idea che ha reso famosa 3PAR è il chunklet, il termine ufficiale nel documento di architettura di HPE. Il sistema operativo taglia ogni disco in chunklet da 1 GiB e costruisce il RAID a partire da quelli invece che da dischi interi, così ogni volume finisce distribuito su ogni disco, dietro ogni controller e ogni porta. Ne discendono due cose. Prestazioni: non c'è un disco caldo, perché nessun volume vive su un disco in particolare. E ricostruzioni: la capacità di riserva è sparsa su tutto l'array invece che parcheggiata su un disco di scorta inattivo, così una ricostruzione è molti dischi che aiutano insieme invece di un disco che beve da una cannuccia.
Ogni controller porta anche il Thin Express ASIC di HPE, quinta generazione nell'8450, seduto accanto alla CPU e che fa in silicio il lavoro per cui gli array software bruciano core: rilevare e scartare flussi di zeri inline, calcolare hash dei blocchi per la deduplica, calcolare la parità RAID e apporre checksum end-to-end dalla porta host al disco. Quel chip è gran parte del motivo per cui l'array muove I/O a blocchi senza drammi.
Da due a quattro nodi controller su un backplane passivo full-mesh
Ogni disco tagliato in chunklet da 1 GiB, ogni volume distribuito su tutti
Capacità di riserva sparsa sull'array, non parcheggiata su un disco inattivo
Thin Express ASIC, 5ª generazione, che fa RAID e checksum in silicio
- muore un controller, configurazione a quattro nodi
- la write cache si rispecchia sui nodi superstiti, nessun rallentamento in write-through
- cade una porta o un percorso
- l'array sposta la porta da solo, l'host non se ne accorge
- muore un disco
- rebuild molti a molti dalle riserve sparse sull'array
Quelle sono affermazioni di HPE, dal documento di architettura, non risultati del nostro laboratorio. Quella che vale la pena sottolineare è la prima: il documento stesso di HPE fa notare che gli array a doppio controller cadono in cache write-through quando un controller muore, che è un modo educato di dire che si trascinano. Un 3PAR a quattro nodi mantiene la write cache in mirror e continua. È la differenza tra un guasto di controller che compare nel vostro grafico di latenza e uno che non compare.
545.164
IOPS SPC-1 a 0,80 ms di risposta media, misurati su un 8450 nel benchmark storage standard del settore
Una nota onesta su quel numero. Le brochure di HPE citano la famiglia 8000 che scala oltre il milione di IOPS nelle configurazioni di punta, e i 3PAR più grandi vanno ancora più in alto. I 545 mila sono ciò che un 8450 ha effettivamente registrato nel benchmark indipendente, con il listino prezzi allegato: 23 centesimi per IOPS SPC-1, il più economico tra i dieci array più veloci della lista all'epoca. Il misurato batte la brochure, quindi il numero misurato è quello che citiamo.
Un decennio in produzione significa che il firmware è assestato, i modi di guasto sono documentati, i ricambi abbondano, e nulla di ciò che fa questa macchina sorprende gli ingegneri che l'hanno padroneggiata. È la nostra dottrina in una frase, e ha il suo articolo: comprate la macchina seria.
Deviamo solo quando il lavoro se lo merita
La standardizzazione senza una clausola di uscita è dogma, quindi ecco la nostra: deviamo solo quando un lavoro se lo merita davvero. La versione generale di questo argomento, compreso il perché una baseline nota sia ciò che rende sicura da ingegnerizzare una vera eccezione, copre le nostre decisioni su rete, compute e fabric accanto allo storage in abbiamo opinioni forti sull'hardware. Questo è il capitolo sullo storage.
Se state valutando un provider, le domande sullo storage che vale la pena fare, comprese quelle a cui la maggior parte dei provider non sa rispondere, sono in il segreto sporco del vostro provider è il suo storage.
Risposte dirette
Standardizzare su un solo vendor di storage non è un rischio di lock-in?+
È una dipendenza che abbiamo scelto a occhi aperti. Qualunque piattaforma faccia girare un provider, siete legati alla sua capacità di gestirla, e un menu di cinque vendor spalma quella stessa dipendenza su cinque piattaforme senza possedere la profondità di nessuna. Preferiamo essere legati a una piattaforma che sappiamo diagnosticare a livello di firmware piuttosto che essere liberi di scegliere tra piattaforme che conosciamo in superficie.
Cosa cambia usare una sola famiglia di array?+
Ogni incidente, ricambio e runbook si aggiunge alla conoscenza del team sulla stessa piattaforma. L'argomento qui è la profondità operativa: ingegneri in organico in grado di leggere gli interni dell'array e riconoscerne i modi di guasto.
Cosa significa «padroneggiato» in pratica?+
Runbook per una macchina nota, e una rotazione di reperibilità in cui chi risponde ha già lavorato sui guasti di questa piattaforma. Quando lo storage si comporta male, è la differenza tra una diagnosi in corso e un ticket aperto al produttore per conto vostro.
Fate le vostre domande sullo storage alle persone che gestiscono l'array
Gli ingegneri storage e fabric che gestiscono il nostro SAN giorno per giorno sono le stesse persone che rispondono. Chiedete loro di cosa ha bisogno il vostro carico sotto di sé.
Parla con un ingegnereSiete arrivati alla fine.
Mettete la lettura al lavoro
Cosa fate girare?
Raccontateci il carico di lavoro, il traffico e i requisiti di ripristino. Partite dal configuratore di server, oppure discutete i dettagli con un ingegnere.
Scritto dagli ingegneri che costruiscono e gestiscono l'infrastruttura che descrive.Parla con un ingegnere