

Чому ми стандартизувалися на all-flash HPE 3PAR
Ми тримаємо блокове сховище на одній платформі, HPE 3PAR all-flash через Fibre Channel, і вивчили її глибоко навмисно. Ця глибина є тим, що дозволяє черговому інженеру читати власну телеметрію масиву замість того, щоб відкривати кейс у вендора.
У цій статті 5 розділів
- Ми стандартизували блокове сховище на HPE 3PAR all-flash через Fibre Channel, одна сім’я масивів, обрана й опанована, замість меню рівнів від тих вендорів, хто того кварталу дав гарну ціну.
- Одна платформа означає, що глибина накопичується: кожен інцидент, запасна частина й runbook живлять ту саму бібліотеку відмов, і черговий інженер уже бачив, як саме цей масив відмовляє.
- Ця глибина є причиною, чому люди, які відповідають, можуть відрізнити хворий масив від хворого шляху за власними лічильниками масиву і телеметрією шляхів.
- Платформа заслуговує на глибину: контролери mesh-active, дизайн chunklet, який розподіляє кожен том по всіх дисках, ASIC, що робить важку роботу, і незалежне підтвердження бенчмарком: 545 164 IOPS при 0,80 мс.
- Ми відхиляємося лише тоді, коли завдання справді цього заслуговує. Відома базова лінія є тим, що робить справжній виняток безпечним для побудови.
Наше блокове сховище працює на all-flash масивах HPE 3PAR, досяжних через Fibre Channel. Це речення описує радше рішення, ніж продукт: одна сім’я масивів, обрана свідомо й вивчена глибоко, замість меню рівнів сховища, зібраного з того, що пропонував канал. Ця стаття є аргументом за це рішення і за те, щоб питати будь-якого хоста, якого ви оцінюєте, чи ухвалював він коли-небудь подібне.
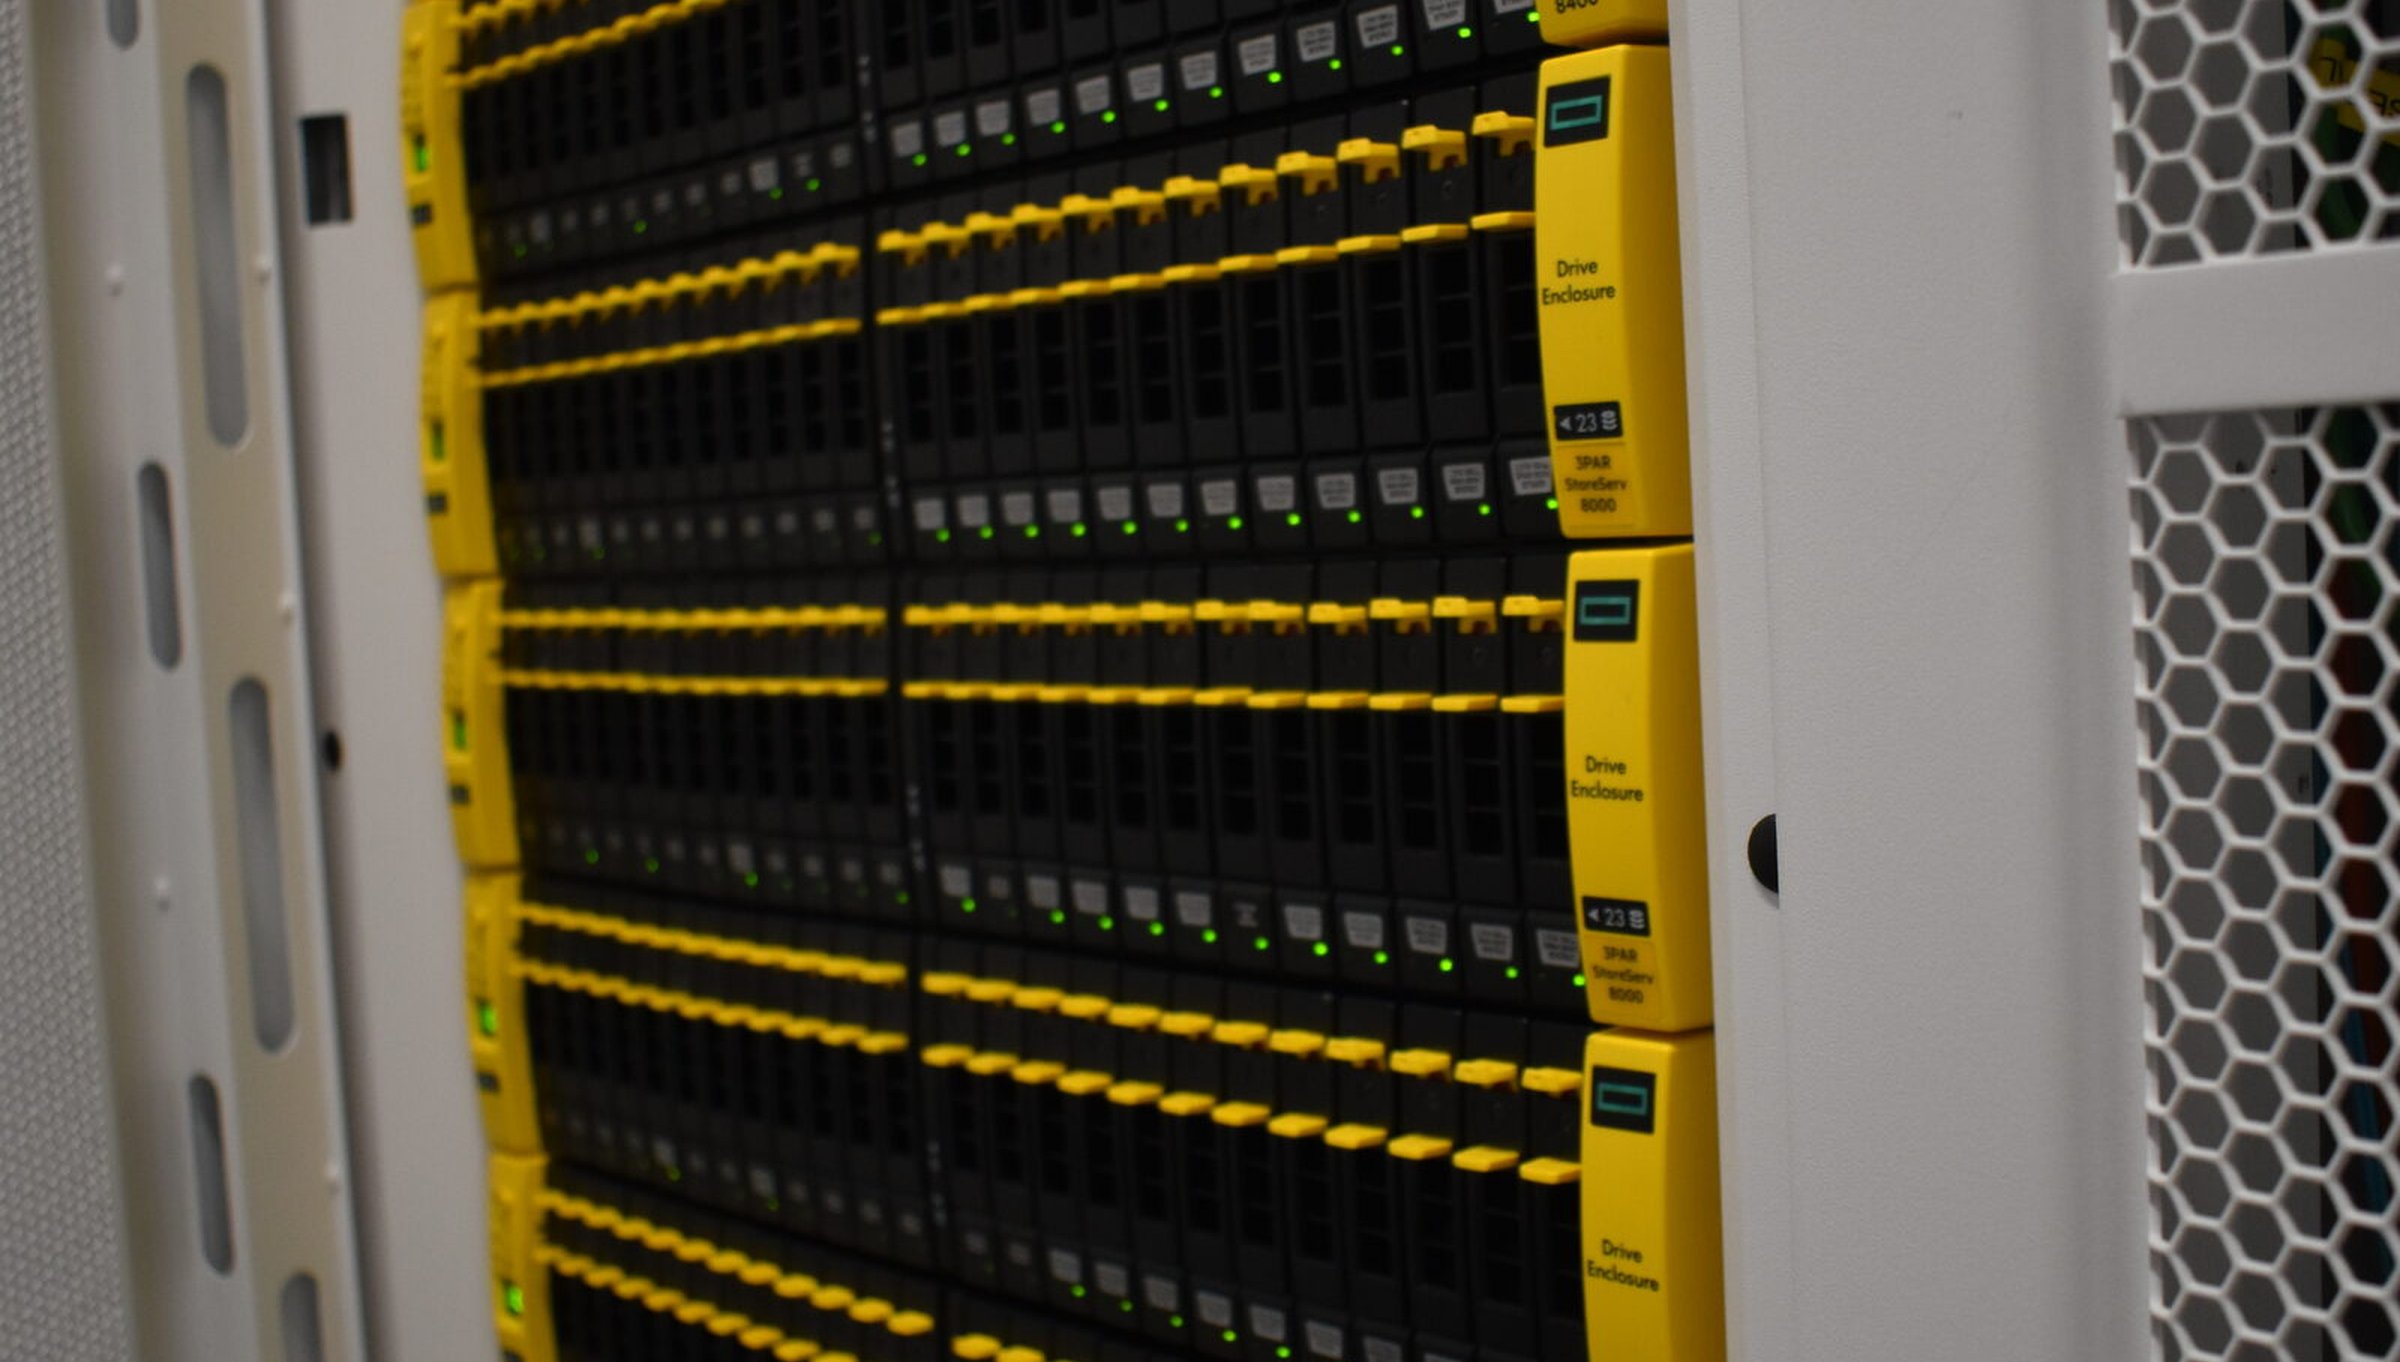
П’ять рівнів сховища в меню означають п’ять платформ, що експлуатуються поверхово
Відкрийте сторінки замовлення більшості провайдерів, і сховище є випадним списком: рівень SATA, рівень SSD, рівень NVMe, іноді рівень performance без жодної архітектури за словами. Кожен рядок у цьому меню є окремою платформою, яку хтось має експлуатувати, з власними контролерами, власними режимами відмов, власною телеметрією і власним шляхом оновлення firmware. Меню на п’ять рядків є функцією для закупівель. Воно також є кадровим рішенням, бо інженерна увага ділиться на кількість платформ, які вона має покривати.
Розділена увага є втраченою глибиною. Команда, яка експлуатує п’ять сімей масивів, тримає п’ять тонких скибок досвіду, і коли одна з цих платформ поводиться погано о 3-й ночі, шанси на те, що черговий уже працював саме з цією відмовою саме на цій машині, падають з кожним зайвим рядком у меню. Ми натомість згорнули меню.
Глибина накопичується, коли кожен інцидент потрапляє на ту саму платформу
Опанування платформи є робочим інвентарем не менше, ніж ментальним: runbooks, написані за реальною телеметрією цієї платформи, а не за загальним посібником, та інженери у штаті, які можуть читати нутрощі масиву й діагностувати його на глибині firmware.
Накопичення і є суттю. Кожен інцидент, який опрацьовує будь-хто з команди, стає частиною спільної бібліотеки відмов тієї самої машини, тож десята зустріч із класом відмови починається з пам’яті, а не з документації. Розмажте ті самі інциденти по каталогу з п’яти платформ, і бібліотека фрагментується: більшість відмов зустрічає хтось, хто бачить їх уперше, а відмова, яку зустріли вперше, займає найбільше часу саме в той момент, коли ваше навантаження найменше може собі це дозволити.
- П’ять рівнів, п’ять платформ, п’ять наборів режимів відмов, які треба вивчити
- Знання про інциденти фрагментуються; більшість відмов зустрічають непідготовленими
- Запчастини й експертиза з firmware розмазані тонко по каталогу
- Коли масив поводиться погано, план є тікетом у виробника й очікуванням
- Одна сім’я масивів, вивчена до її firmware
- Кожен інцидент живить ту саму бібліотеку відмов
- Runbooks і м’язова пам’ять для однієї відомої машини
- Інженер, який відповідає, уже бачив, як саме цей масив відмовляє
Що купує глибина, день у день
HPE 3PAR Peer Persistence тримає томи online, якщо масив виходить з ладу, а наші інженери читають час обслуговування і телеметрію шляхів на масивах як рутину, тож питання про сховище отримує відповідь від масиву, а не з черги вендора. Відрізнити хворий масив від хворого шляху потребує саме цієї глибини, якою володіють ті самі люди, що експлуатують SAN щодня.
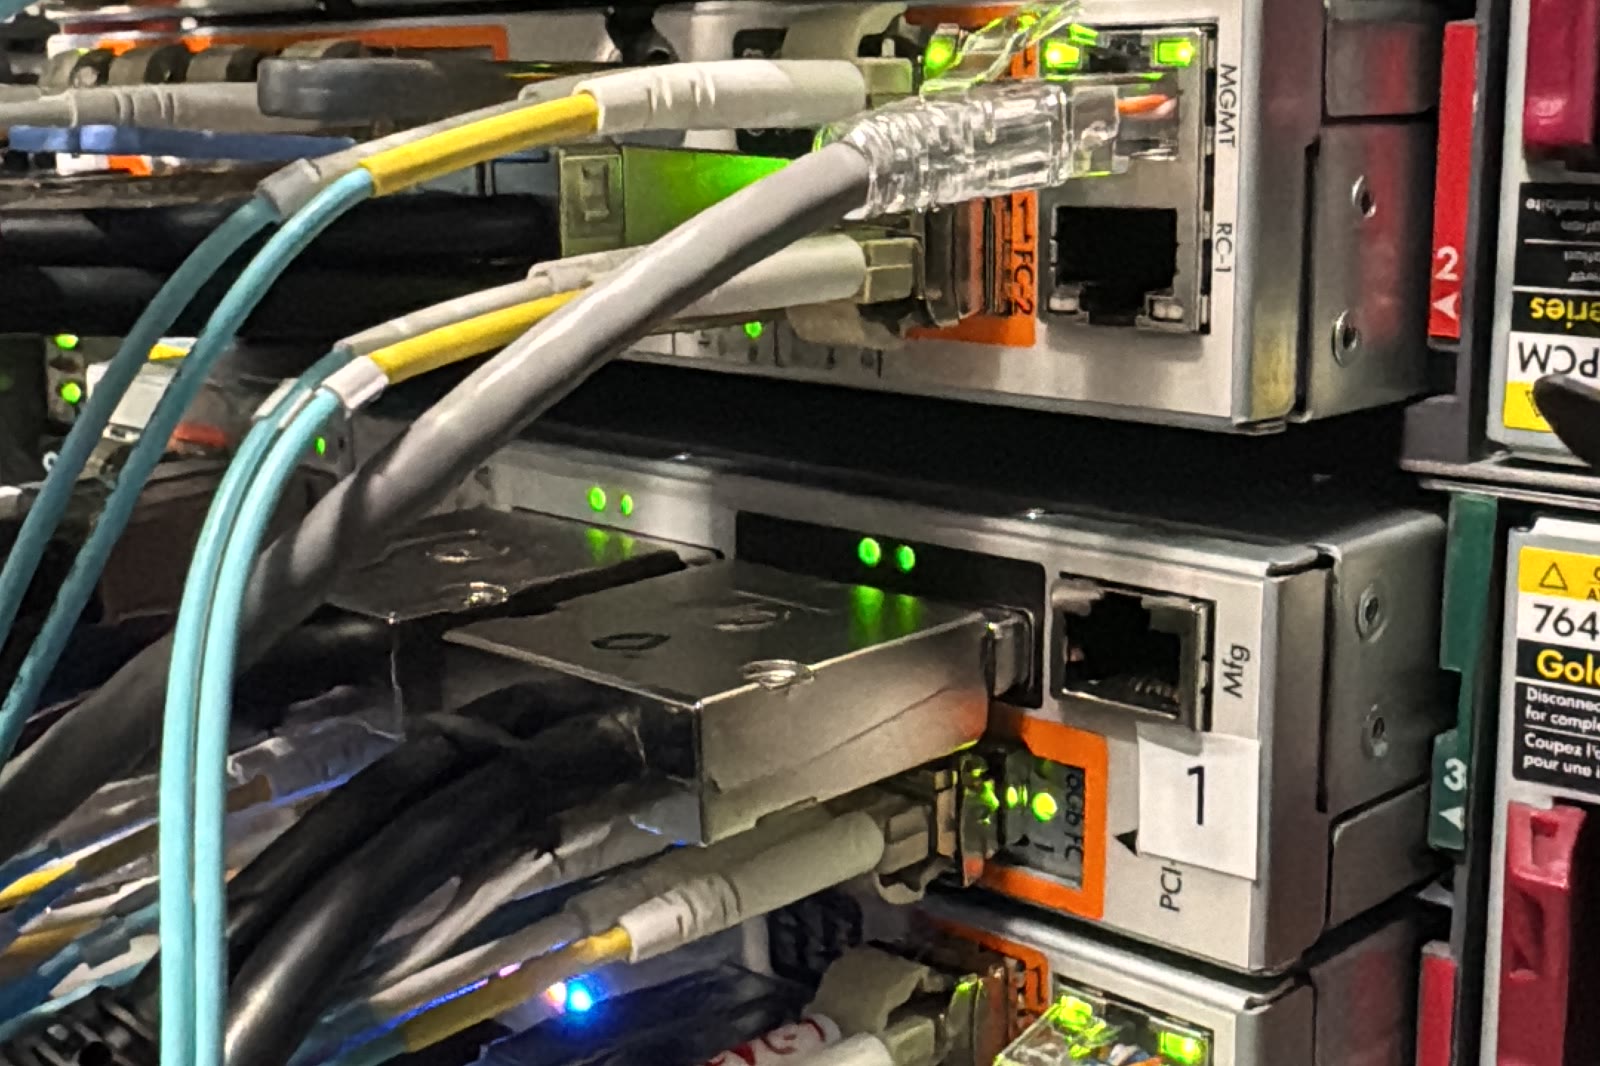
Сама машина, на публічному записі
Короткий огляд того, на чому ми стандартизувалися, з кожним твердженням з публічного запису. HPE 3PAR 8450 є all-flash моделлю сім’ї 8000: від двох до чотирьох вузлів-контролерів на пасивному full-mesh backplane, дизайн, який HPE називає Mesh-Active, бо кожен том живий на кожному контролері одночасно. Немає основного контролера, з якого треба перемикатися. Сім’я вийшла наприкінці 2015 року, але родовід старший і кращий: 3PAR заснували в 1999 році системні архітектори Sun Microsystems, назва буквально означає 3 Partners, і компанія була піонером thin provisioning. У 2010 році HP і Dell вели публічну війну ставок за неї, від стартових 18 $ за акцію від Dell до переможних 33 $ від HP, приблизно 2,35 млрд $. Серйозні люди дуже хотіли цю машину.
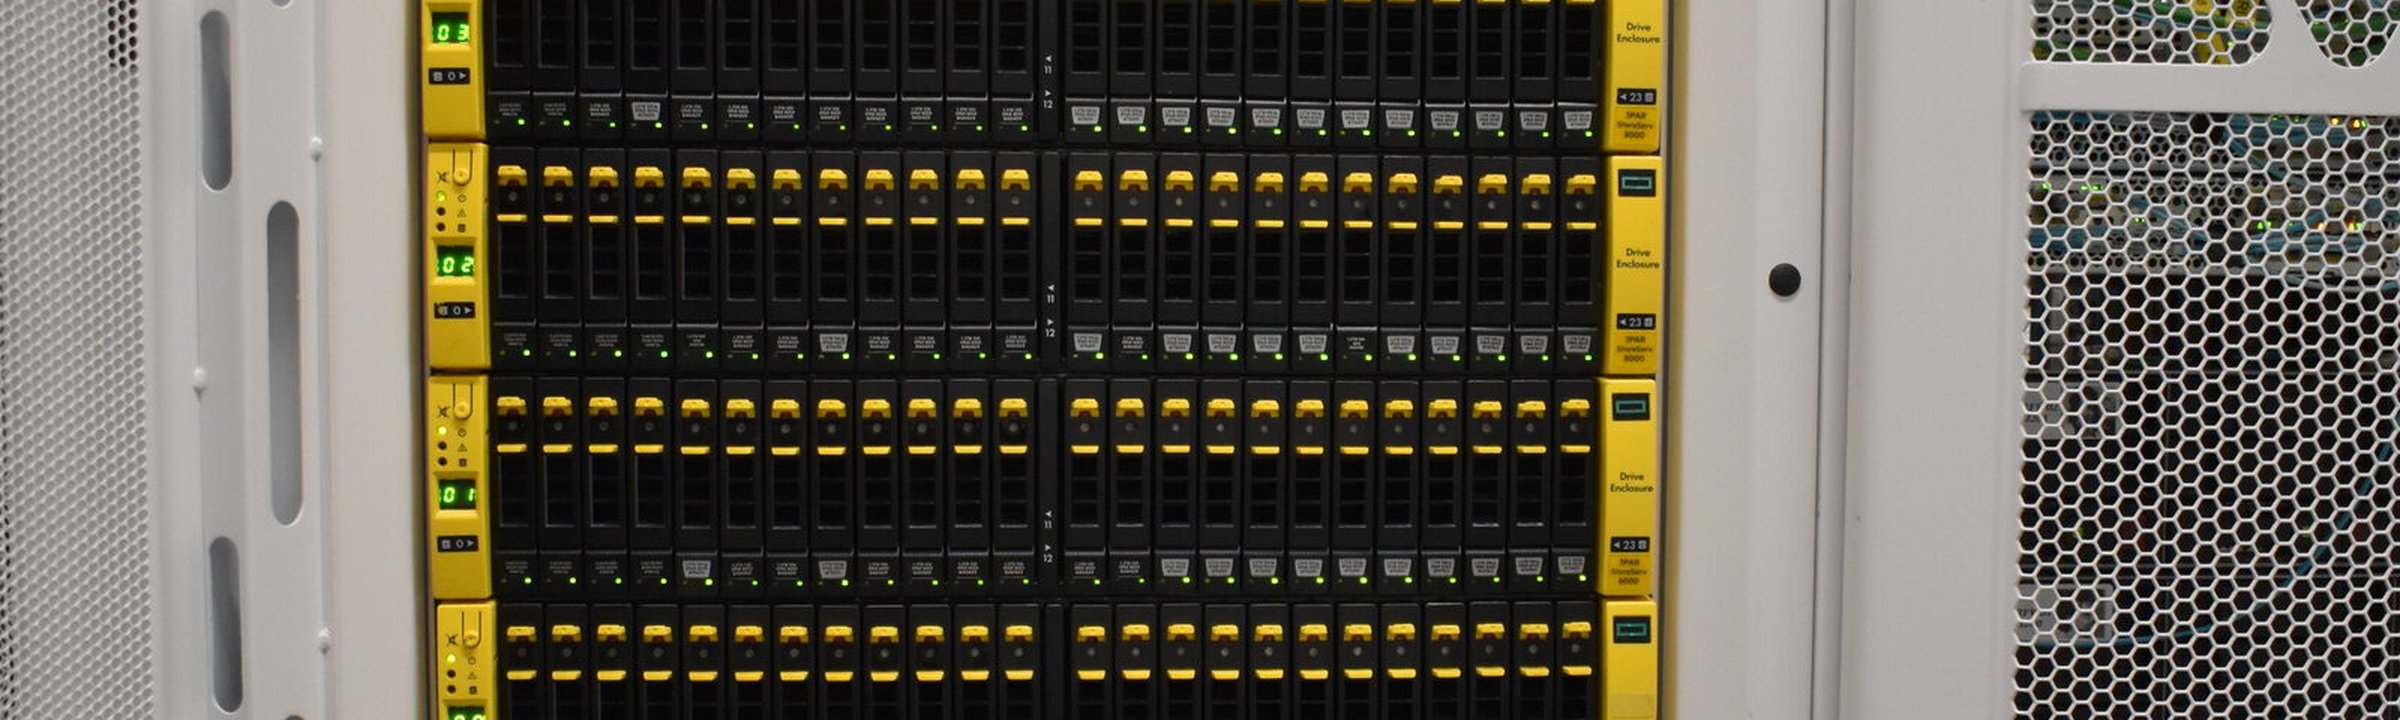
Ідея, яка зробила 3PAR відомим, це chunklet, офіційний термін з архітектурного документа HPE. Операційна система ріже кожен диск на chunklets по 1 GiB і будує RAID з них замість цілих дисків, тож кожен том у підсумку розподілений по кожному диску, за кожним контролером і кожним портом. З цього випливають дві речі. Продуктивність: гарячого диска немає, бо жоден том не живе на якомусь конкретному диску. І відбудови: запасна ємність розкидана по всьому масиву замість того, щоб стояти на бездіяльному запасному диску, тож відбудова є багатьма дисками, що допомагають одночасно, а не одним диском, що п’є через соломинку.
Кожен контролер також несе ASIC Thin Express від HPE, п’ятого покоління у 8450, який сидить поруч із CPU і робить у кремнії роботу, на яку програмні масиви спалюють ядра: виявлення і відкидання потоків нулів на льоту, хешування блоків для дедуплікації, обчислення парності RAID і проставляння наскрізних контрольних сум від порту хоста до диска. Цей чип є великою частиною того, чому масив рухає блоковий I/O без драми.
Від двох до чотирьох вузлів-контролерів на пасивному full-mesh backplane
Кожен диск порізаний на chunklets по 1 GiB, кожен том розподілений по всіх
Запасна ємність розкидана по масиву, а не на одному бездіяльному диску
ASIC Thin Express 5-го покоління робить RAID і контрольні суми в кремнії
- помирає контролер, конфігурація з чотирма вузлами
- кеш запису перевіддзеркалюється на вузли, що лишилися, без повзання у write-through
- падає порт або шлях
- масив сам переносить порт, хост не помічає
- помирає диск
- відбудова багато-до-багатьох із запасів, розкиданих по масиву
Це твердження HPE з архітектурного документа, а не результати нашої лабораторії. Те, що варто підкреслити, є першим: власний документ HPE зазначає, що масиви з двома контролерами падають у режим write-through кешу, коли помирає контролер, що є ввічливим способом сказати, що вони повзуть. 3PAR з чотирма вузлами тримає кеш запису віддзеркаленим і продовжує працювати. У цьому різниця між відмовою контролера, яка з’являється на вашому графіку затримки, і тією, яка не з’являється.
545 164
SPC-1 IOPS при середньому часі відгуку 0,80 мс, виміряно на 8450 за стандартним галузевим бенчмарком сховищ
Одна чесна примітка до цього числа. Брошури HPE наводять для сім’ї 8000 масштабування понад мільйон IOPS у топових конфігураціях, а більші 3PAR ідуть ще вище. 545 тисяч є тим, що 8450 насправді показав за незалежним бенчмарком, із прикладеним прайсом: 23 центи за SPC-1 IOPS, найдешевший із десяти найшвидших масивів у списку на той час. Виміряне б’є брошуру, тож виміряне число є тим, яке ми наводимо.
Десятиліття в production означає, що firmware усталене, режими відмов задокументовані, частин удосталь, і ніщо з того, що робить ця машина, не дивує інженерів, які її опанували. Це наша доктрина одним реченням, і вона має власну статтю: купуйте серйозну машину.
Ми відхиляємося лише тоді, коли завдання цього заслуговує
Стандартизація без умови виходу є догмою, тож ось наша: ми відхиляємося лише тоді, коли завдання справді цього заслуговує. Загальна версія цього аргументу, включно з тим, чому відома базова лінія є тим, що робить справжній виняток безпечним для інженерії, покриває наші рішення щодо мережі, обчислень і fabric поряд зі сховищем у ми маємо власну думку про обладнання. Це розділ про сховище.
Якщо ви оцінюєте хоста, питання про сховище, які варто ставити, включно з тими, на які більшість провайдерів не можуть відповісти, є у брудна таємниця вашого хоста: його сховище.
Прямі відповіді
Хіба стандартизація на одному вендорі сховища не є ризиком lock-in?+
Це залежність, яку ми обрали з відкритими очима. Хоч би яку платформу експлуатував хост, ви прив’язані до його здатності її експлуатувати, а меню з п’яти вендорів розмазує ту саму залежність по п’яти платформах, не тримаючи глибини в жодній. Ми радше будемо прив’язані до платформи, яку можемо діагностувати на глибині firmware, ніж вільними обирати серед платформ, які знаємо поверхово.
Що змінює використання однієї сім’ї масивів?+
Кожен інцидент, запасна частина і runbook додаються до знань команди про ту саму платформу. Аргумент тут є операційною глибиною: інженери у штаті, які можуть читати нутрощі масиву і впізнавати його режими відмов.
Що означає «опанована» на практиці?+
Runbooks для однієї відомої машини і чергування on-call, у якому людина, що відповідає, уже працювала з відмовами цієї платформи. Коли сховище поводиться погано, це різниця між діагнозом у процесі й тікетом, відкритим у виробника від вашого імені.
Ставте свої питання про сховище людям, які експлуатують масив
Інженери сховища і fabric, які експлуатують наш SAN щодня, є тими самими людьми, які відповідають. Запитайте їх, що потрібно вашому навантаженню під сподом.
Поговоріть з інженеромВи дійшли до кінця.
Застосуйте прочитане на практиці
Що ви запускаєте?
Розкажіть нам про навантаження, трафік і вимоги до відновлення. Почніть з конструктора сервера або обговоріть деталі з інженером.
Написано інженерами, які будують і експлуатують інфраструктуру, про яку йдеться.Поговоріть з інженером