

Porque normalizámos em HPE 3PAR all-flash
Corremos block storage numa única plataforma, HPE 3PAR all-flash sobre Fibre Channel, e aprendemo-la em profundidade de propósito. É essa profundidade que permite ao engenheiro de prevenção ler a telemetria do próprio array em vez de abrir um case no fabricante.
Neste artigo 5 secções
- Normalizámos o block storage em HPE 3PAR all-flash sobre Fibre Channel, uma família de arrays escolhida e dominada, em vez de um menu de níveis dos fabricantes que tivessem bom preço nesse trimestre.
- Uma plataforma significa que a profundidade se acumula: cada incidente, peça sobresselente e runbook alimenta a mesma biblioteca de falhas, e o engenheiro de prevenção já viu exatamente este array falhar.
- Essa profundidade é a razão pela qual as pessoas que atendem conseguem distinguir um array doente de um caminho doente, a partir dos próprios contadores do array e da telemetria dos caminhos.
- A plataforma merece a profundidade: controladores mesh-active, o design de chunklets que distribui cada volume por todos os discos, um ASIC a fazer o trabalho pesado, e um comprovativo de benchmark independente de 545.164 IOPS a 0,80 ms.
- Só nos desviamos quando um trabalho o merece genuinamente. Uma base conhecida é o que torna seguro construir uma verdadeira exceção.
O nosso block storage corre em arrays HPE 3PAR all-flash, acedidos sobre Fibre Channel. Esta frase descreve mais uma decisão do que um produto: uma família de arrays, escolhida deliberadamente e aprendida em profundidade, em vez de um menu de níveis de storage montado a partir do que o canal oferecia. Este artigo é a defesa dessa decisão, e da ideia de perguntar a qualquer fornecedor que avalie se alguma vez tomou uma assim.
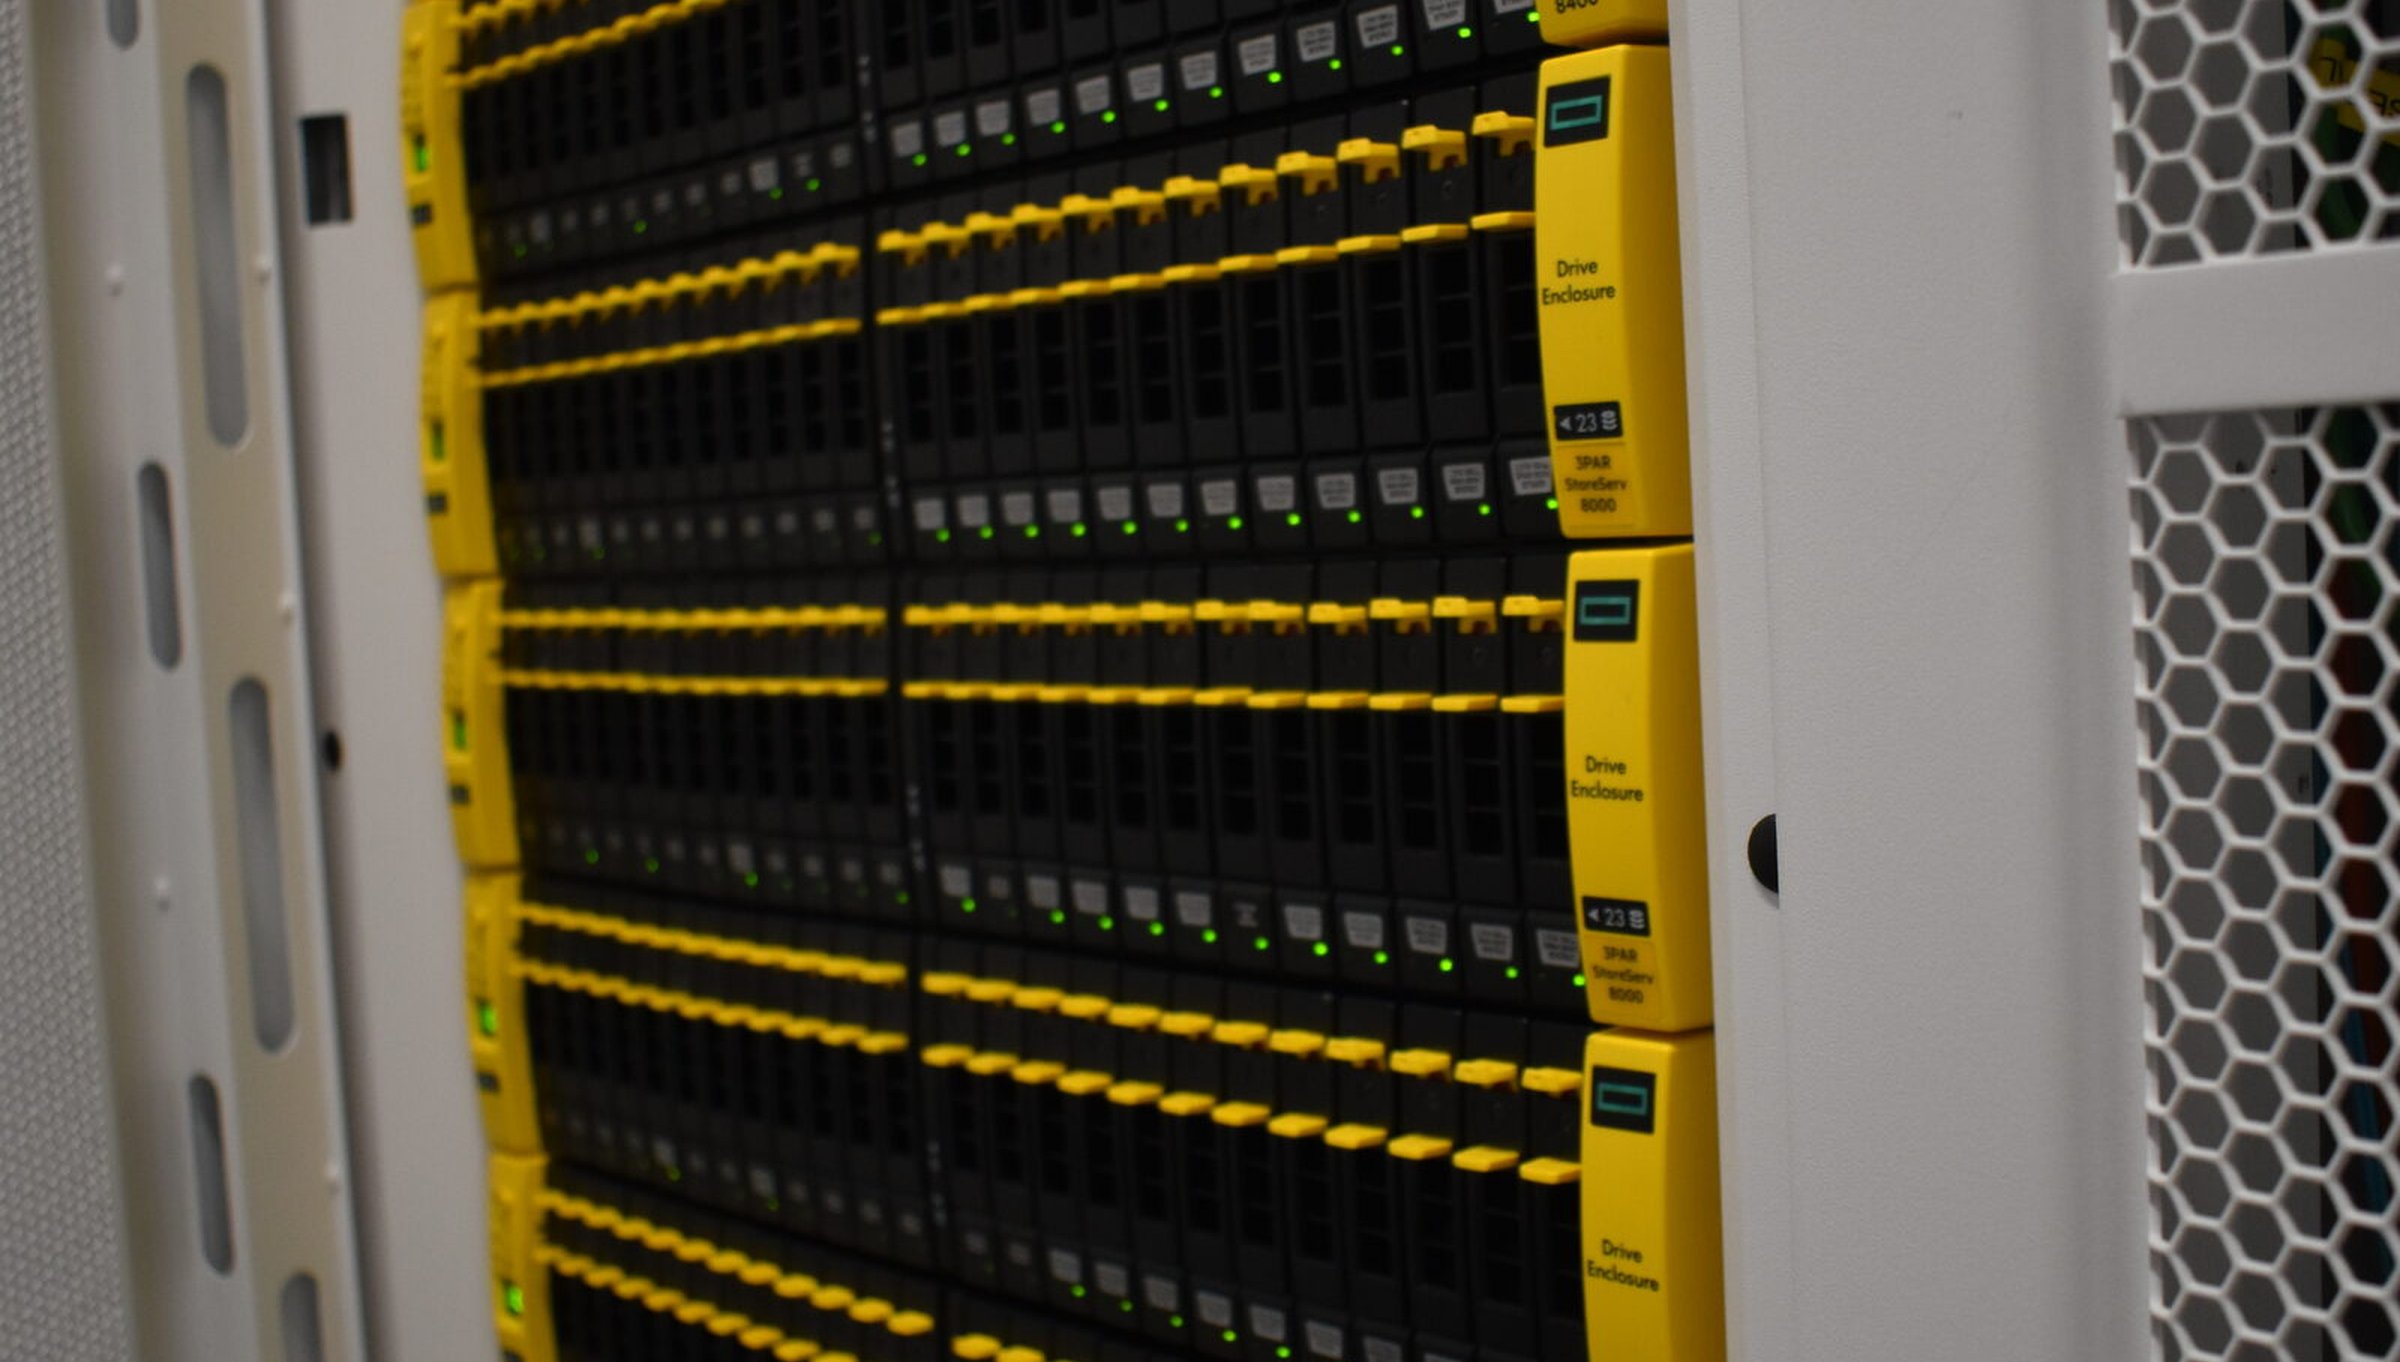
Cinco níveis de storage num menu significam cinco plataformas operadas de forma superficial
Abra as páginas de encomenda da maioria dos fornecedores e o storage é um dropdown: um nível SATA, um nível SSD, um nível NVMe, às vezes um nível de desempenho sem arquitetura nenhuma por trás das palavras. Cada linha desse menu é uma plataforma distinta que alguém tem de operar, com os seus próprios controladores, os seus próprios modos de falha, a sua própria telemetria e o seu próprio percurso de atualização de firmware. Um menu de cinco linhas é uma funcionalidade de compras. É também uma decisão de pessoal, porque a atenção da engenharia divide-se pelo número de plataformas que tem de cobrir.
Atenção dividida é profundidade perdida. Uma equipa que opera cinco famílias de arrays detém cinco fatias finas de experiência, e quando uma dessas plataformas se porta mal às 3 da manhã, a probabilidade de a pessoa de prevenção já ter trabalhado exatamente esta avaria exatamente nesta máquina cai a cada linha extra do menu. Nós reduzimos o menu.
A profundidade acumula-se quando todos os incidentes caem na mesma plataforma
Dominar uma plataforma é tanto um inventário de trabalho como um inventário mental: runbooks escritos sobre a telemetria real desta plataforma em vez de um manual genérico, e engenheiros no quadro que conseguem ler o interior do array e diagnosticá-lo ao nível do firmware.
A acumulação é o objetivo. Cada incidente que qualquer pessoa da equipa trabalha passa a fazer parte de uma biblioteca de falhas partilhada para a mesma máquina, de modo que o décimo encontro com uma classe de avaria começa da memória em vez da documentação. Espalhe os mesmos incidentes por um catálogo de cinco plataformas e a biblioteca fragmenta-se: a maioria das avarias é enfrentada por alguém que as vê pela primeira vez, e uma avaria vista pela primeira vez demora mais tempo exatamente no momento em que a sua carga de trabalho menos o pode suportar.
- Cinco níveis, cinco plataformas, cinco conjuntos de modos de falha para aprender
- O conhecimento dos incidentes fragmenta-se. A maioria das avarias é enfrentada sem preparação
- Peças sobresselentes e conhecimento de firmware espalhados por todo o catálogo
- Quando um array se porta mal, a jogada é um ticket no fabricante e uma espera
- Uma família de arrays, aprendida até ao firmware
- Cada incidente alimenta a mesma biblioteca de falhas
- Runbooks e memória muscular para uma máquina conhecida
- O engenheiro que atende já viu exatamente este array falhar
O que a profundidade compra, no dia a dia
O HPE 3PAR Peer Persistence mantém os volumes online se um array for abaixo, e os nossos engenheiros leem tempos de serviço e telemetria de caminhos nos arrays por rotina, por isso uma pergunta sobre storage é respondida a partir do array, não a partir de uma fila do fabricante. Distinguir um array doente de um caminho doente exige essa profundidade, nas mãos das mesmas pessoas que operam a SAN todos os dias.
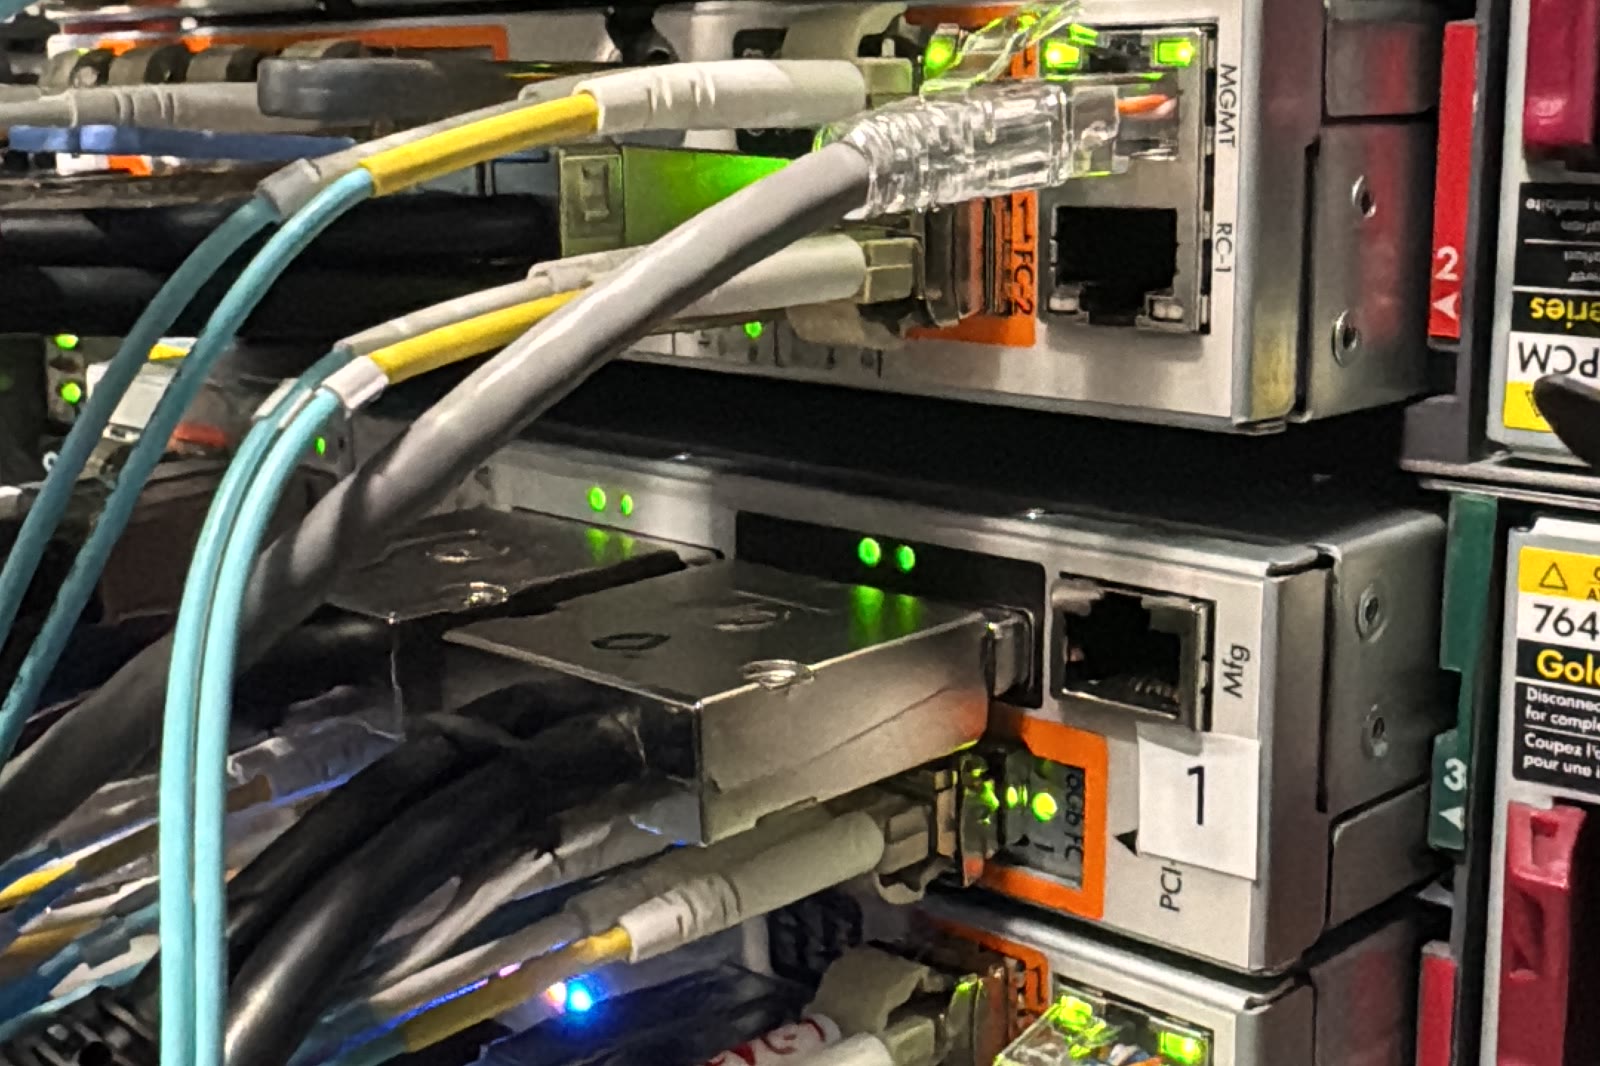
A máquina em si, no registo público
Uma visita curta àquilo em que normalizámos, com todas as afirmações retiradas do registo público. O HPE 3PAR 8450 é o modelo all-flash da família 8000: dois a quatro nós controladores num backplane passivo full-mesh, um design a que a HPE chama Mesh-Active porque cada volume está ativo em todos os controladores ao mesmo tempo. Não há um controlador primário a partir do qual fazer failover. A família saiu no final de 2015, mas a linhagem é mais antiga e melhor: a 3PAR foi fundada em 1999 por arquitetos de sistemas da Sun Microsystems, o nome significa literalmente 3 Partners, e a empresa foi pioneira do thin provisioning. Em 2010 a HP e a Dell travaram uma guerra pública de ofertas por ela, da oferta inicial da Dell a $18 por ação até à oferta vencedora da HP a $33, cerca de $2,35 mil milhões. Gente séria quis muito esta máquina.
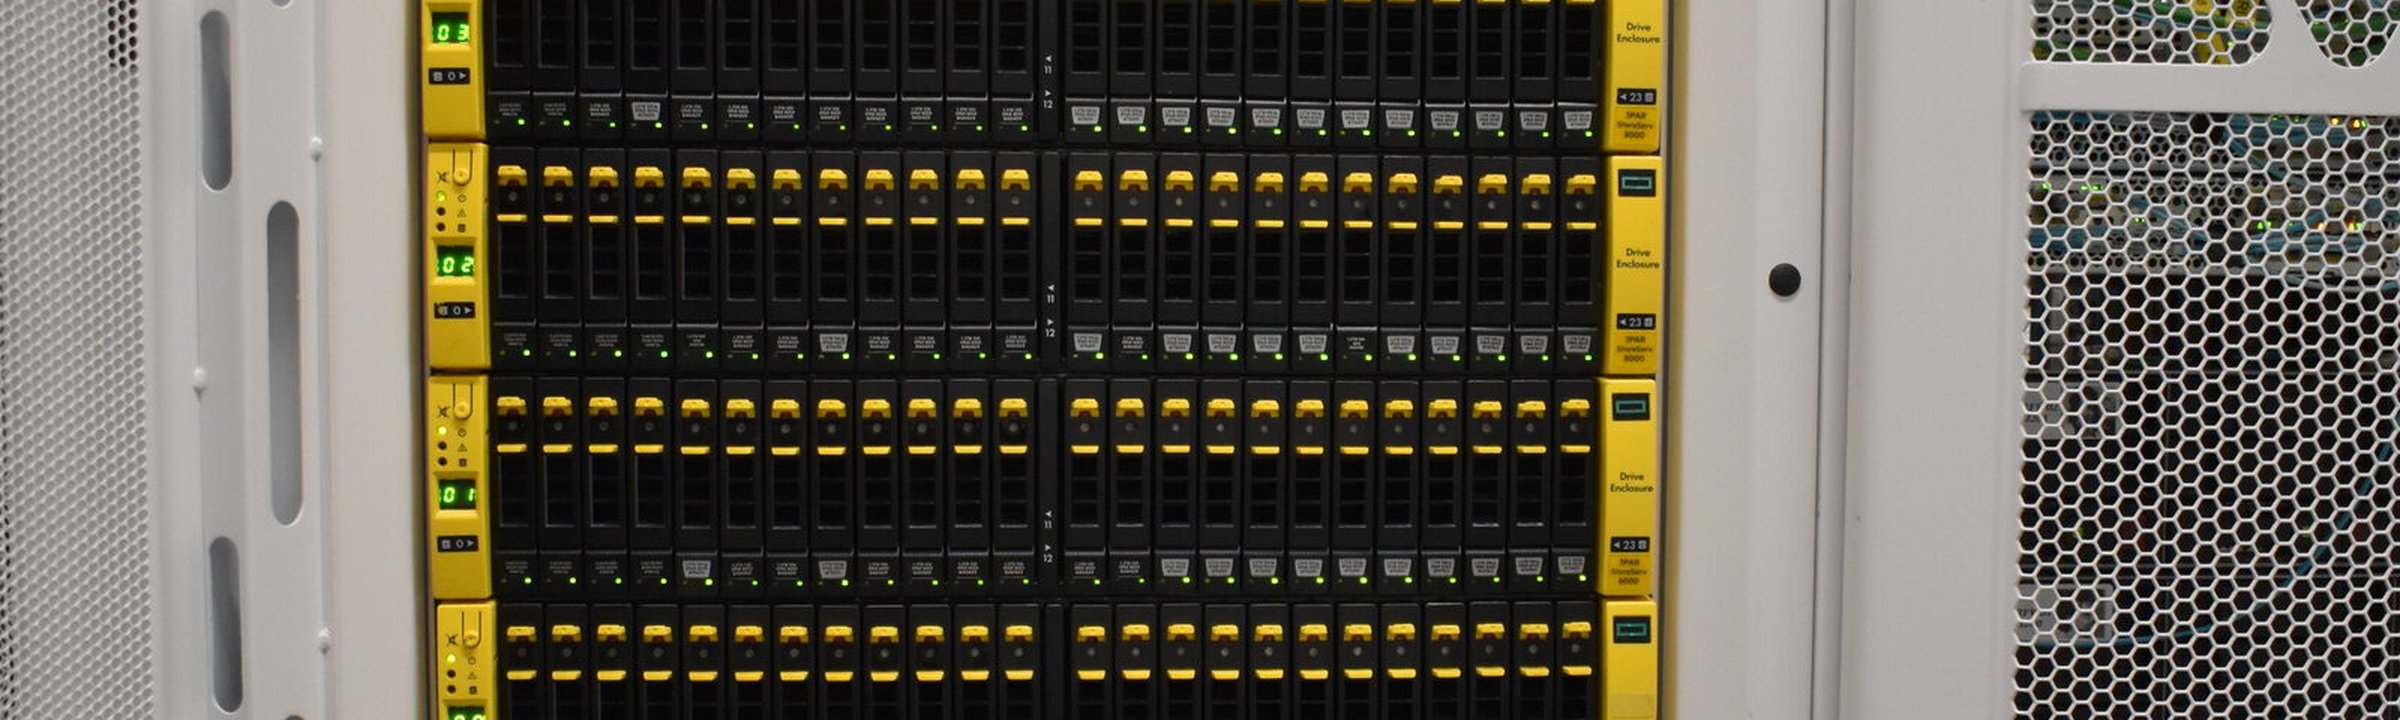
A ideia que tornou a 3PAR famosa é o chunklet, o termo oficial no documento de arquitetura da HPE. O sistema operativo corta cada disco em chunklets de 1 GiB e constrói o RAID a partir deles em vez de a partir de discos inteiros, de modo que cada volume acaba distribuído por todos os discos, atrás de todos os controladores e de todas as portas. Duas coisas resultam daí. Desempenho: não há disco quente, porque nenhum volume vive num disco em particular. E rebuilds: a capacidade de reserva está espalhada por todo o array em vez de estacionada num disco de reserva inativo, por isso um rebuild são muitos discos a ajudar ao mesmo tempo em vez de um único disco a beber por uma palhinha.
Cada controlador transporta também o Thin Express ASIC da HPE, de quinta geração no 8450, ao lado da CPU, a fazer em silício o trabalho em que os arrays de software queimam núcleos: detetar e descartar fluxos de zeros inline, calcular hashes de blocos para dedupe, calcular a paridade RAID e carimbar checksums de ponta a ponta, da porta do host até ao disco. Esse chip é grande parte da razão pela qual o array move block I/O sem drama.
Dois a quatro nós controladores num backplane passivo full-mesh
Cada disco cortado em chunklets de 1 GiB, cada volume distribuído por todos
Capacidade de reserva espalhada pelo array, não estacionada num disco inativo
Thin Express ASIC, 5.ª geração, a fazer RAID e checksums em silício
- morre um controlador, configuração de quatro nós
- a write cache volta a espelhar-se nos nós sobreviventes, sem arrastamento em write-through
- cai uma porta ou um caminho
- o próprio array desloca a porta, o host não dá por nada
- morre um disco
- rebuild muitos-para-muitos a partir de reservas espalhadas pelo array
Estas são afirmações da HPE, do documento de arquitetura, não resultados do nosso laboratório. A que merece ser sublinhada é a primeira: o próprio documento da HPE assinala que os arrays de dois controladores caem em cache write-through quando um controlador morre, o que é uma forma educada de dizer que ficam de rastos. Um 3PAR de quatro nós mantém a write cache espelhada e continua. É essa a diferença entre uma falha de controlador que aparece no seu gráfico de latência e uma que não aparece.
545.164
IOPS SPC-1 a 0,80 ms de resposta média, medidos num 8450 no benchmark de storage padrão do setor
Uma nota honesta sobre esse número. As brochuras da HPE referem a família 8000 a escalar para lá de um milhão de IOPS nas configurações de topo, e os 3PAR maiores vão ainda mais alto. Os 545 mil são o que um 8450 registou de facto no benchmark independente, com a tabela de preços anexada: 23 cêntimos por IOPS SPC-1, o mais barato dos dez arrays mais rápidos da lista na altura. O medido vence a brochura, por isso o número medido é o que citamos.
Uma década em produção significa que o firmware está assente, os modos de falha estão documentados, as peças são abundantes, e nada do que esta máquina faz surpreende os engenheiros que a dominaram. É essa a nossa doutrina numa frase, e tem artigo próprio: compre a máquina séria.
Só nos desviamos quando o trabalho o merece
Normalização sem cláusula de saída é dogma, por isso aqui fica a nossa: só nos desviamos quando um trabalho o merece genuinamente. A versão geral deste argumento, incluindo porque é que uma base conhecida é o que torna seguro projetar uma verdadeira exceção, cobre as nossas decisões de rede, computação e fabric a par do storage em temos opiniões fortes sobre hardware. Este é o capítulo do storage.
Se está a avaliar um fornecedor, as perguntas sobre storage que vale a pena fazer, incluindo as que a maioria dos fornecedores não consegue responder, estão em o segredo sujo do seu fornecedor é o storage.
Respostas diretas
Normalizar num único fabricante de storage não é um risco de lock-in?+
É uma dependência que escolhemos de olhos abertos. Seja qual for a plataforma que um fornecedor opera, está preso à capacidade dele de a operar, e um menu de cinco fabricantes espalha essa mesma dependência por cinco plataformas sem manter a profundidade de nenhuma. Preferimos estar ligados a uma plataforma que conseguimos diagnosticar ao nível do firmware do que ser livres de escolher entre plataformas que conhecemos superficialmente.
O que muda usar uma única família de arrays?+
Cada incidente, peça sobresselente e runbook acrescenta ao conhecimento da equipa sobre a mesma plataforma. O argumento aqui é a profundidade operacional: engenheiros no quadro que conseguem ler o interior do array e reconhecer os seus modos de falha.
O que significa «dominado» na prática?+
Runbooks para uma máquina conhecida, e uma rotação de prevenção em que a pessoa que atende já trabalhou as falhas desta plataforma. Quando o storage se porta mal, é essa a diferença entre um diagnóstico em curso e um ticket aberto no fabricante em seu nome.
Faça as suas perguntas sobre storage às pessoas que operam o array
Os engenheiros de storage e de fabric que operam a nossa SAN no dia a dia são as mesmas pessoas que respondem. Pergunte-lhes do que a sua carga de trabalho precisa por baixo.
Fale com um engenheiroChegou ao fim.
Ponha a leitura em prática
O que executa?
Fale-nos da carga de trabalho, do tráfego e dos requisitos de recuperação. Comece pelo configurador de servidores ou discuta os detalhes com um engenheiro.
Escrito pelos engenheiros que constroem e operam a infraestrutura que descreve.Fale com um engenheiro