

Tenemos opiniones sobre el hardware para que usted no tenga que tenerlas.
Estandarizar las decisiones aburridas de infraestructura es el servicio. Hace de su carga de trabajo la única variable que queda en la sala.
En este artículo 4 secciones
- Estandarizamos las capas que nunca deberían ser cara o cruz: storage HPE 3PAR all-flash, Brocade Fibre Channel doble, red propia, cómputo propio.
- Estandarizar no es rigidez. Nos desviamos solo cuando su trabajo se lo gana, y construimos la excepción porque la base se conoce al dedillo.
- Un stack bien entendido ve sus fallos corregidos más rápido que diez improvisados. Por eso esto se nota en su uptime.
Abra un formulario típico de pedido de servidor y cuente las decisiones que le pide tomar. Clase de storage. Nivel de RAID. Bonding de tarjetas de red. Backplane. Hipervisor. Destino de backup. Modo de replicación. Cada una es una bifurcación, y cada bifurcación que le entregan son deberes.
h2 (#choice-is-a-cost): Elegir es un coste
Un configurador largo parece generoso, pero cada elección en él es suya. Elige la clase de storage, y si los IOPS resultan equivocados para su base de datos, es su elección. Cada opción que selecciona pasa a ser suya de explicar cuando salta la alerta a las 3 de la madrugada.
Nosotros pensamos que eso está al revés. La infraestructura bajo su aplicación no es el lugar donde debería expresar individualidad. Es el lugar donde quiere la menor cantidad de sorpresas. Por eso tomamos esas decisiones una vez, deliberadamente, y respaldamos cada una de ellas. Lo que usted configura con nosotros es su carga de trabajo. Todo lo que hay debajo, ya lo dejamos resuelto.
Las decisiones que quitamos de su plato son las que fallan en silencio durante meses y después todas a la vez. Estandarizarlas no es inflexibilidad por nuestra parte. Es asumir un riesgo que nos corresponde a nosotros poner en precio.
h2 (#what-we-standardized): Qué estandarizamos, y por qué
h3 (#storage): Storage: HPE 3PAR all-flash
El block storage vive en HPE 3PAR all-flash, activo-activo dentro de la sede con Peer Persistence, y replicado a una segunda sede. No es una clase a la que usted asciende. El storage bueno es el único storage. Puede verlo en la página de private cloud, y el muro de discos está en las fotos de nuestra página sobre nosotros, porque es nuestro muro, no el de un banco de imágenes.
h3 (#fabric): Fabric: Brocade Fibre Channel doble
El storage llega al cómputo a través de Brocade Fibre Channel doble, con multipath. Los fabrics Brocade llevan más de una década en la doctrina y nunca se fueron.
h3 (#network): Red: la nuestra
Su tráfico viaja por nuestra propia red: nuestro propio sistema autónomo, peering bilateral en GR-IX, Cisco ASR 9000 series en el edge y Nexus 9000 leaf-spine debajo, con EVPN/VXLAN tallando un fabric real por tenant sobre nuestro propio silicio.
h3 (#compute): Cómputo: nuestros propios servidores
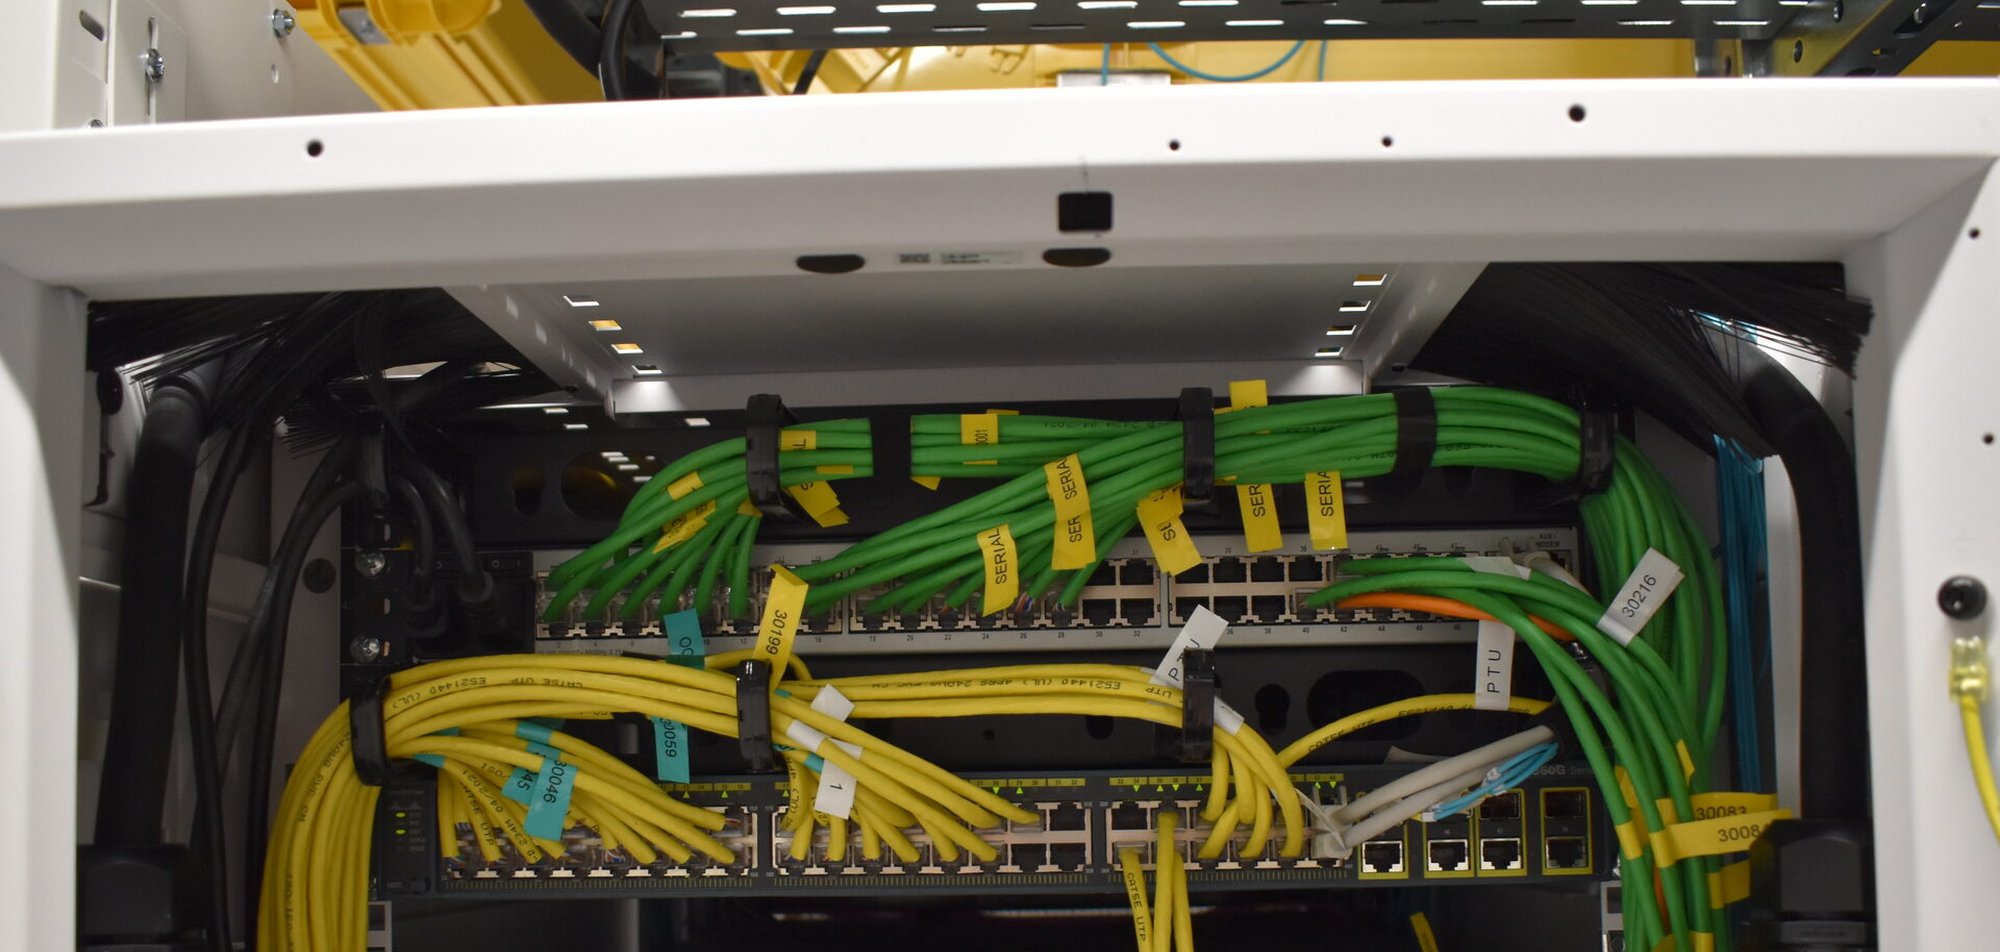
Las máquinas son nuestras: cómputo HPE y Dell en una jaula que construimos y etiquetamos nosotros mismos. Ser dueños del equipamiento es lo que nos permite respaldar la fiabilidad que vendemos, y el nuestro es nuestro desde 2004.
- RED PROPIA
- nuestro propio sistema autónomo, del edge al spine
- PEERING EN GR-IX
- bilateral, en el punto de intercambio
- FEDERACIÓN HPE 3PAR
- all-flash, activo-activo en la sede, replicado a una segunda sede
- FABRIC POR TENANT
- EVPN/VXLAN, aislado por tenant
h2 (#deviate-when-earned): Nos desviamos solo cuando su trabajo se lo gana
Nada de esto significa que la respuesta sea siempre la misma máquina. Significa que el punto de partida lo es. La estandarización es lo que hace posible una excepción real: como sabemos exactamente cómo se comporta la base, podemos decir con precisión dónde la abandona su carga de trabajo y construir la desviación a propósito, no a ciegas. Cuatro sockets cuando el trabajo necesita cuatro. Un private cloud a medida cuando el objetivo de fiabilidad se lo gana. La excepción se diseña, no se improvisa, y eso solo es cierto cuando la regla es sólida.
h2 (#shows-up-in-uptime): Por qué esto se nota en su uptime
La fiabilidad no es un componente que se compra. Es lo que ocurre cuando un fallo se encuentra con un stack que el ingeniero de guardia ya entiende.
Salta una alerta a las 3 de la madrugada. ¿Qué está mirando el ingeniero de guardia?
Un primer encuentro, cada vez
Cada cliente improvisó un stack distinto, así que cada fallo es un primer encuentro, y los primeros encuentros son lentos.
Un fallo que ya ha arreglado antes
El mismo fabric, storage y red bajo todos. El ingeniero ha visto exactamente esta clase de fallo. La superficie es familiar, así que la solución es rápida.
Respuestas directas
¿Puedo traer mi propia preferencia de hardware?+
Puede decirnos qué necesita el trabajo y lo construiremos para ello, hasta la máquina de referencia y más allá. Lo que no puede hacer es rebajar las piezas que estandarizamos para recortar coste, porque esas son las piezas que fallan sin avisar y se llevan su uptime con ellas. Nos desviamos cuando la carga de trabajo se lo gana, no cuando recorta una esquina.
¿Alguna vez usan storage que no sea 3PAR?+
La federación 3PAR es la base para todo lo que necesita fiabilidad real, y es lo que fotografiamos y publicamos. Si una carga de trabajo de verdad no necesita block storage federado, se lo diremos y le daremos un precio sin él en lugar de venderle storage que no usará. La respuesta honesta a veces apunta hacia abajo.
¿Mi máquina se comparte con alguien?+
En hardware dedicado, no. El número de serie está en su factura, y sus núcleos son sus núcleos. En un private cloud, el fabric de su tenant está aislado con EVPN/VXLAN. En cualquier caso, el aislamiento es real, no un ajuste.
Entonces, ¿qué decido yo en realidad?+
Su carga de trabajo: cuán grande es el trabajo, cómo crece y qué objetivo de fiabilidad tiene que cumplir. Esa es la única bifurcación que siempre fue suya. El asistente de dimensionamiento dedicado le propone algo menor si apunta demasiado alto, y la vía del private cloud existe para cuando el objetivo de fiabilidad se lo gana.
Tenemos opiniones sobre el hardware por una razón: para que usted nunca tenga que tenerlas. Dimensione su carga de trabajo y deje el resto resuelto. La vía del private cloud está ahí cuando el objetivo de fiabilidad se lo gana, y la genealogía detrás de todo esto está en la página sobre nosotros.
Vea el metal en el que nos estandarizamos.
La configuración de referencia, el hardware que hay detrás y el precio que es el mismo el año que viene.
Vea el metalHa llegado al final.
Ponga la lectura a trabajar
¿Qué está ejecutando?
Cuéntenos la carga de trabajo, el tráfico y los requisitos de recuperación. Empiece por el configurador de servidores o repase los detalles con un ingeniero.
Escrito por los ingenieros que construyen y operan la infraestructura que describe.Hable con un ingeniero