

¿Qué es en realidad el Hypertext Transfer Protocol (HTTP)?
HTTP desde la primera línea de petición hasta HTTP/2: métodos, cabeceras, códigos de estado, keep-alive y qué significa cada uno para un servidor que usted opera.
La creación de la World Wide Web se perfeccionó a lo largo de los años aproximadamente de 1988 a 1991.
Originalmente, los mecanismos de HTTP se diseñaron para permitir a científicos de todo el mundo compartir una plataforma de investigación y colaboración. Como resultado, la web mundial ha puesto herramientas de publicación, aprendizaje y colaboración al alcance de cualquiera con una conexión a Internet.
(hr)
Los componentes originales de la invención de Tim Berners-Lee siguen en uso hoy. De hecho, algunos servidores web modernos todavía entienden la especificación HTTP original (aunque hoy se considera obsoleta):
Componentes básicos de la World Wide Web:
- un servidor web
- un user agent
- representación textual
- tipos de medios (Media Types)
- un protocolo que permite la transferencia de documentos, HTTP
| La W.W.W. actual | |
|---|---|
| servidor web | IIS, Apache, NGiNX |
| user agent | CuRL, Chrome, Firefox, lectores RSS |
| datos textuales | UTF-8, ASCII, JSON, HTML, XML, CSS |
| tipos de medios | datos textuales, imágenes, vídeo, animaciones |
| especificaciones HTTP | HTTP/1.1 (RFC 9112), HTTP/2 (RFC 9113) y HTTP/3 (RFC 9114), con semántica compartida en el RFC 9110 |
Dos entidades principales tienen la tarea de definir la evolución del HTTP moderno:
- W3C World Wide Web Consortium El W3C se ocupa de la funcionalidad de los servidores web, de las necesidades futuras de especificación, de los user agents (o navegadores web), de HTML, XML, vídeo, imágenes y tecnologías de entrega de contenidos. Más o menos, el W3C se ocupa de los efectos de HTTP en la capa de aplicación.
- IETF Internet Engineering Task Force La IETF se ocupa de cómo HTTP funcionará y operará a un nivel técnico más bajo. HTTP funciona encima de tecnologías subyacentes como IPv4, TCP, UDP, Ethernet y muchos otros protocolos de capas inferiores. Todos los protocolos inferiores trabajan juntos para llevar los datos del user agent al servidor web, y de vuelta al user agent.
Tomado del sitio web de cada uno, el W3C y la IETF se describen con sus propias palabras:
- El World Wide Web Consortium (W3C) es una comunidad internacional donde las organizaciones miembro, un personal a tiempo completo y el público trabajan juntos para desarrollar estándares web. (https://www.w3.org/Consortium/)
- El objetivo de la IETF es hacer que Internet funcione mejor. La misión de la IETF es hacer que Internet funcione mejor produciendo documentos técnicos relevantes y de alta calidad que influyen en la forma en que las personas diseñan, usan y gestionan Internet. (https://www.ietf.org)
¿Cómo se definen estándares como HTTP? (h2, anchor section01)
Cuando un protocolo de Internet como HTTP se adopta o se revisa, los estándares se definen en documentos llamados RFC.
RFC significa Request For Comments.
Todo protocolo de comunicación de datos reconocido que se acepta para uso generalizado en Internet se define en una serie de documentos RFC. Tecnologías como HTTP, IPv4, TLS, PKI, SNMP, POP3 e incluso Ethernet no son tecnologías propiedad de Microsoft, Apple o Google.
Los estándares definidos en un RFC están pensados para adoptarse como medio de comunicación entre plataformas de múltiples fabricantes. Toda tecnología (en su núcleo) documentada en un RFC puede ser implementada, perfeccionada para su uso e incluso añadida a productos por cualquier persona o fabricante sin regalías ni patentes.
Un RFC suele ser un documento bastante árido disponible en texto ASCII, siguiendo la tradición de ser legible en cualquier plataforma. Un RFC también da por supuesto que el lector domina los conceptos técnicos.
- Las especificaciones HTTP vigentes: RFC 9110 HTTP Semantics, RFC 9112 HTTP/1.1, RFC 9113 HTTP/2 y RFC 9114 HTTP/3
(hr)
HTTP es el acrónimo de Hyper Text Transfer Protocol. HTTP es un protocolo stateless de la capa de aplicación diseñado para comunicar intercambios de información entre sistemas a través de Internet. Como tal, HTTP define un conjunto de reglas que permiten tanto la transferencia como el acceso a documentos remotos. HTTP también se ha usado para transferir información de otras formas, como SSDP, que usa UDP y direccionamiento multicast (adoptado como HTTPU) para transferencias de información.
¿Qué NO es HTTP?
HTTP y la web mundial no son Internet. HTTP es un protocolo que impulsa una porción extremadamente popular de Internet conocida como la web mundial.
HTTP opera por encima de los protocolos de comunicación de red subyacentes en el modelo TCP/IP. TCP/IP es un mecanismo para transferir datos, información de entramado y datos de la capa de aplicación a través de Internet. HTTP es un estándar de la capa de aplicación especializado en transferir un tipo concreto de datos. HTTP/1.1 y HTTP/2 corren sobre TCP, mientras que HTTP/3 corre sobre QUIC, que está construido sobre UDP.
TCP/IP es una suite de protocolos de comunicación de datos desarrollada por el Departamento de Defensa de los EE. UU. A veces se hace referencia a TCP/IP como «el modelo de red del DoD».
En sus primeros años, Internet y TCP/IP fueron donados por los laboratorios de DARPA al mundo académico. Tras perfeccionarse para uso académico, Internet fue adoptada por consumidores y empresas hasta convertirse en lo que hoy conocemos como Internet. Fue durante el periodo de transición del uso académico al primer uso público cuando se introdujeron HTTP y la web mundial.
| TCP/IP | Protocolos por capa |
|---|---|
| Capa de aplicación | HTTP: web mundial · FTP: protocolo de transferencia de archivos · POP3 e IMAP: correo entrante · SMTP: correo saliente · HTML: marcado para mostrar páginas web · JPEG: formato gráfico para mostrar imágenes |
| Capa de transporte | TCP: comunicación orientada a conexión entre hosts · UDP: comunicación sin conexión entre hosts (QUIC, que usa HTTP/3, corre sobre él) |
| Capa de Internet | IPv4: direccionamiento para redes remotas · IPv6: direccionamiento para redes remotas · BGP: enrutamiento del tráfico entre proveedores de Internet · OSPF: enrutamiento del tráfico en redes internas · ICMP: estructura para transmitir diagnósticos |
| Capa de enlace | Ethernet medio físico y señalización para la transferencia de datos de bajo nivel · Token Ring competidor de Ethernet que ya rara vez se ve · 802.11 especificaciones para comunicaciones inalámbricas · Bluetooth especificación para conectar dispositivos de forma inalámbrica · Frame Relay especificaciones físicas y de datos para redes de área extensa |
La tabla anterior es una representación de cómo encaja HTTP en Internet y en TCP/IP.
(hr)
Especificaciones de HTTP (h2, anchor section02)
Principalmente, HTTP sirve para comunicar transferencias de documentos entre un user agent y un servidor web.
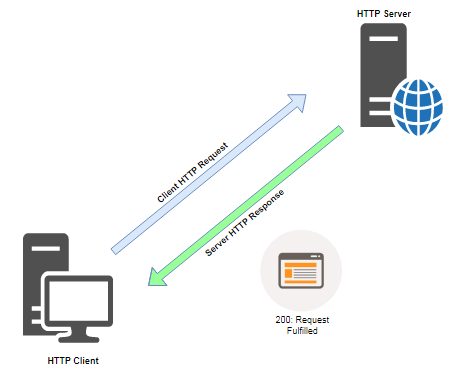
Los intercambios HTTP suelen consistir en que el user agent solicita una serie de documentos a un servidor web. Cuando el servidor web recibe una petición HTTP, la analiza. Finalmente, el servidor web devuelve un documento y un código de estado, o puede denegar una petición devolviendo un código de estado con el motivo del rechazo.
- Para detalles sobre por qué un servidor web puede denegar una petición de un cliente, consulte la sección de códigos de estado HTTP 400
Lectura relacionada: Guía completa de los códigos de estado HTTP: serie 400
User-Agent es un término rimbombante para una aplicación que solicita recursos HTTP a un servidor web. Lo más habitual es que los user agents se conozcan como navegadores web. Sin embargo, los lectores RSS, los bots de web scraping, las arañas web y las bibliotecas HTTP como CURL también son user agents.
Servidor web es un daemon que normalmente corre en el puerto 80 (HTTP) y en el puerto 443 (HTTPS), con el propósito concreto de recuperar documentos de una porción designada del sistema de archivos del servidor para entregarlos a un user agent.
Los tres servidores web de alta carga más comunes en Internet hoy son Apache, Nginx (pronunciado Engine-X) e IIS (de Microsoft).
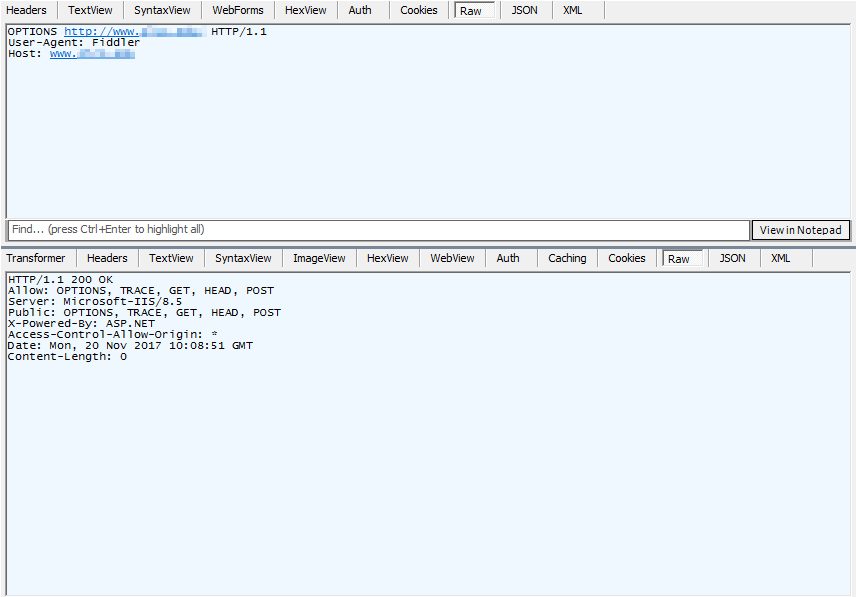
Veamos una petición HTTP simple con una aplicación user agent llamada Fiddler.
Fiddler es un proxy de depuración HTTP para APIs y aplicaciones web. Las herramientas para desarrolladores integradas en todo navegador moderno muestran gran parte de la misma información.
(hr)
Métodos de petición HTTP (h2, anchor section03)
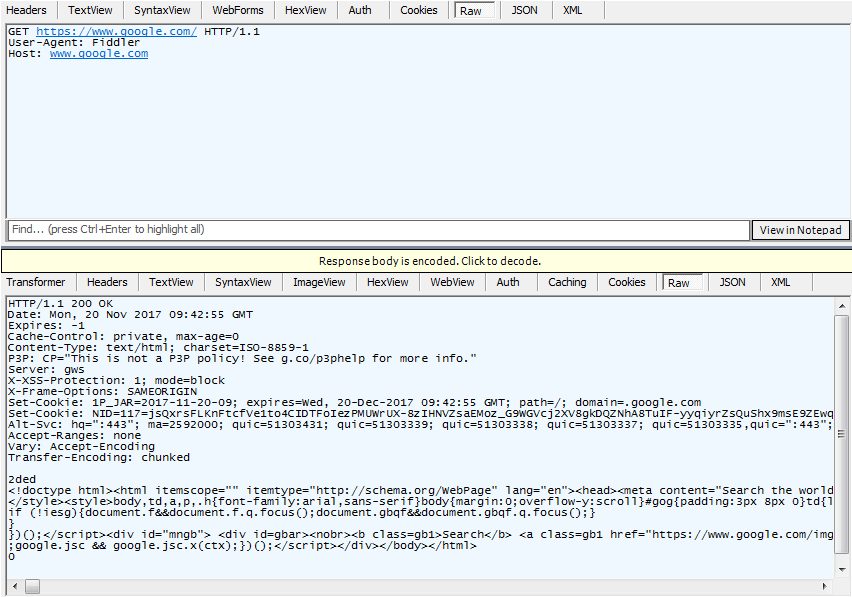
Tal como se muestra en el primer diagrama de un intercambio de petición/respuesta HTTP, el user agent solicita un documento y después un servidor web satisface una petición HTTP válida.
Como se ve en la parte superior de la ventana de Fiddler, Fiddler, el user agent, envió tres líneas de datos:
- GET especifica archivo y ruta
- User-Agent identifica el software cliente
- HOST especifica el host donde se encuentra el contenido
El método de petición es GET en esta petición. Aprenderemos otros métodos de petición HTTP en esta guía.
La cadena User-Agent: Una cadena User-Agent es la forma en que el software del cliente web se identifica ante el servidor web. Las APIs y los sitios web a menudo conceden o deniegan privilegios de acceso y ajustes de presentación según la cadena User-Agent del cliente.
Los crawlers bien educados se identifican con honestidad en su cadena User-Agent y siguen las reglas que un sitio publica en su archivo robots.txt.
| Algunos ejemplos de cadenas User-Agent (los números de versión cambian con cada versión): | |
|---|---|
| Chrome en Windows 7 | Mozilla/5.0 (Windows NT 6.1; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/62.0.3202.94 Safari/537.36 |
| Internet Explorer 11 | Mozilla/5.0 (Windows NT 6.1; WOW64; Trident/7.0; rv:11.0) like Gecko |
| Googlebot | Mozilla/5.0 (Linux; Android 6.0.1; Nexus 5X Build/MMB29P) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/41.0.2272.96 Mobile Safari/537.36 (compatible; Googlebot/2.1; +http://www.google.com/bot.html) |
| Play Station 4 | Mozilla/5.0 (PlayStation 4 4.71) AppleWebKit/601.2 (KHTML, like Gecko) |
Host
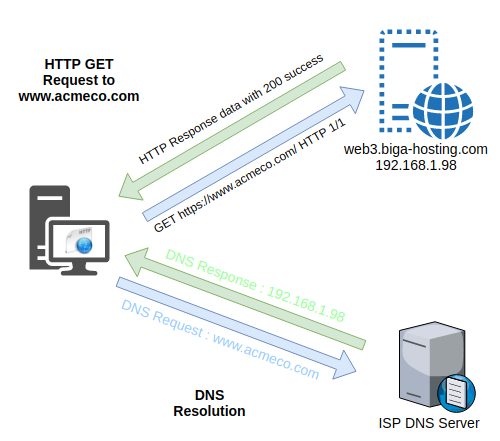
La cabecera Host especifica el servidor (y el dominio) que posee el documento solicitado. Desde HTTP/1.1 la cabecera Host es obligatoria (HTTP/2 y HTTP/3 llevan la misma información en el campo :authority). Es obligatoria porque muchos sitios web comparten un servidor y una dirección IP, una disposición llamada name-based virtual hosting, y el servidor necesita la cabecera Host para saber a qué sitio va dirigida una petición.
Una dirección IP de host 192.168.1.98 puede tener el nombre DNS externo web3.biga-hosting.com. Este servidor llamado web3.biga-hosting.com puede alojar cientos de dominios. A su vez, la cabecera Host de HTTP informará al servidor de a qué dominio alojado va destinada una petición. Varios dominios virtuales pueden tener la misma dirección IPv4 192.168.1.98 (el DNS inverso normalmente apuntará a web3.biga-hosting.com).
(hr)
Anatomía de HTTP
Esta sección profundizará un poco más en el funcionamiento interno del protocolo HTTP. Los temas tratados para dar una visión general de HTTP incluyen:
- Conceptos de URI y URL
- Verbos HTTP: GET, POST, PUT, DELETE, HEAD, TRACE, OPTIONS
- Tipos de medios
- Características comunes de HTTP: stateless, sin cifrado incorporado, autenticación HTTP
(hr)
Conceptos de URI y URL (h2, anchor section04)
De todos los conceptos que rodean a HTTP, descifrar los términos URI y URL es sencillo y sin embargo sigue confundiendo tanto a estudiantes como a algunos desarrolladores. Para confundir aún más un concepto simple, el término URI se ha perfeccionado y documentado en estándares que permiten que el término URL sea sinónimo de URI.
URI es el acrónimo de Uniform Resource Identifier. URL es el acrónimo de Uniform Resource Locator.
Definamos cada uno en los términos más simples posibles, con una analogía. En nuestro escenario digamos que URI equivale al término automóvil. Una URL es un tipo concreto de URI. Así que digamos que URL equivale a un «turismo» pero no a un camión ni a una furgoneta.
Sin embargo, se aconseja usar siempre el término URI si la diferencia tiene alguna importancia.
Para entender mejor el concepto de URI, digamos ahora que queremos localizar un libro. Pero no sabemos dónde está el libro. No podríamos usar una URL, ya que una URL es específica de un host. Podríamos, en cambio, usar un URN:
urn:isbn:0451450523Cuando se usa un URN como el anterior, una aplicación web subyacente se encarga de la lógica de negocio de localizar el documento solicitado.
Digamos en nuestra analogía que un URN es una furgoneta, otro tipo concreto de automóvil. Un URI define un URN y una URL. Un URN identifica un recurso concreto, en nuestro ejemplo un libro. Mientras que una URL identifica la ubicación y otros medios de acceso a un recurso.
Anatomía de una URL
Una URL, también llamada Uniform Resource Locator, es el URI más común en uso en la web mundial. Es lo que escribimos en la barra de direcciones de un navegador web para llegar a https://www.google.com.
Veamos una URL más compleja y desglosemos cada parte:
http://admin:password@web5.acmeco.com:8080/admin-docs/2017/ins/infrastructure.xlsxEs sintácticamente válida, pero muestra algo que nunca debería hacer.
La forma user:password en una URL está obsoleta (RFC 3986), y los navegadores modernos la eliminan o la bloquean. Las credenciales en una URL acaban en los logs del servidor, en el historial del navegador y en las cabeceras Referer. Nunca ponga credenciales, con hash o sin él, en una URL.
| Credenciales en la URL | |
|---|---|
| esquema | http:// |
| credenciales | admin:password |
| recurso/host | web5.acmeco.com |
| puerto | 8080 |
| ruta | /admin-docs/2017/ins/ |
| documento | infrastructure.xlsx |
http://www.acmeco.com/ también es una URL válida.
La barra final le dice al servidor web que queremos el documento por defecto del webroot. Tradicionalmente este documento se llama index.html, pero el administrador del servidor puede cambiarlo por cualquier otro.
Otra URL válida puede ser: mailto:user@example.com. En lugar de solicitar un documento, esta URL abre el cliente de correo por defecto, listo para escribir a esa dirección.
Algunos esquemas de protocolo válidos en una URL son: https://, http://, ftp://, file://, mailto:, tel:, y probablemente alguno más. http y https son, sin embargo, los protocolos más usados en la web mundial.
Query strings
Existe otra forma común de especificar una URL que se usa ampliamente en la web mundial. Se llama query string. Un query string se usa normalmente junto con una aplicación web de backend o un script CGI.
Un ejemplo se añade a nuestra petición GET anterior, accediendo directamente a la búsqueda de Google:
https://www.google.com/search?q=euro+vps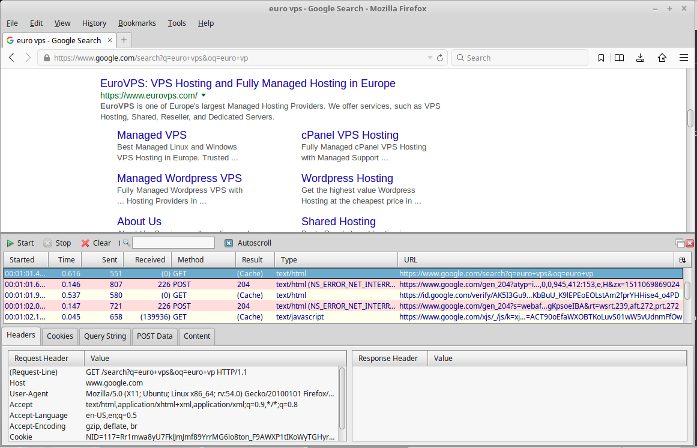
Los query strings se usan normalmente para pasar parámetros a un script de backend. El query string lo codifica el navegador web, se entrega a un servidor web, lo decodifica el servidor web o la aplicación y, finalmente, lo procesa la aplicación web.
Es sabido que los query strings han sido explotados pasando parámetros maliciosos en intentos de manipular la funcionalidad de una aplicación web.
https://www.acmeco.com/auth/auth.php?user=acmeuser&password=EXAMPLELo anterior es un ejemplo de lo que nunca hay que hacer. Las credenciales, con hash o sin él, nunca deben viajar en una URL: acaban en los logs HTTP, en el historial del navegador y en las cabeceras Referer. Envíelas en el cuerpo de un POST por HTTPS, o en una cabecera Authorization.
(hr)
Verbos HTTP (h2, anchor section05)
Ahora que tenemos una buena idea de qué es una URL y de cómo se usan los query strings, presentaremos los verbos que se usan en las peticiones HTTP. Los verbos HTTP más usados son:
- POST y GET
- PUT
- DELETE
- HEAD
- TRACE
- OPTIONS
- CONNECT
1. POST y GET
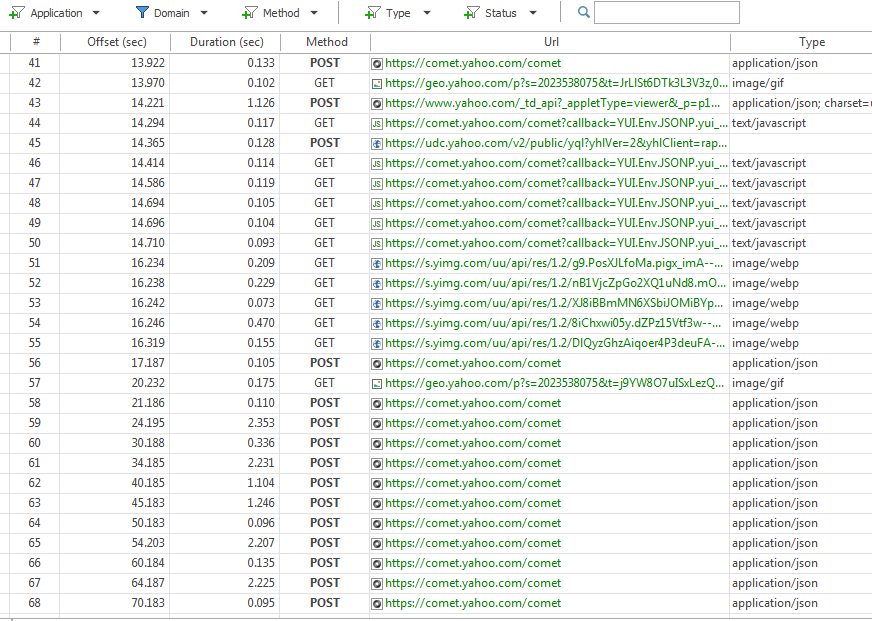
GET es el método por defecto cuando se escribe un sitio web en la barra de direcciones de un navegador o se hace clic en un hipervínculo. Cuando se solicita una página web, el navegador puede en realidad hacer varias peticiones GET o POST para descargar todos los recursos que componen una página web, como imágenes, hojas de estilo, scripts del lado del cliente, recursos tipográficos y más:
Hipervínculo es el nombre técnico del enlace a páginas web secundarias. Cuando el usuario hace clic en un enlace (o hipervínculo), el navegador envía una petición GET para la página enlazada
Peticiones POST
Los dos métodos de petición más usados son GET y POST. Ya hemos desglosado una petición GET. Examinemos pues una petición POST.
¿Y si quisiéramos subir un archivo de 1GB a través de un script PHP o asp? Naturalmente, una URL no puede contener una cadena binaria de 1GB. En ese escenario usaríamos el método POST.
POST se parece a GET en que POST puede pasar parámetros como un query string. Sin embargo, los datos POST no se añaden a una URL como ocurre con el query string.
En cambio, los datos POST viajan en el cuerpo de la petición HTTP, después de las cabeceras. POST se usa sobre todo con datos de formularios HTML.
El método POST se usa habitualmente cuando se necesitan las siguientes características:
- subida de archivos
- mantener los datos sensibles fuera de la URL
- hay que enviar cadenas de datos más largas
- hay que usar esquemas de codificación distintos
- no puede cachearse (si hay una preocupación de seguridad)
Comparemos con algunas ventajas del método GET con un query string añadido a la URL
- puede guardarse como marcador
- puede cachearse
- los resultados de la consulta pueden compartirse con un enlace
2. PUT
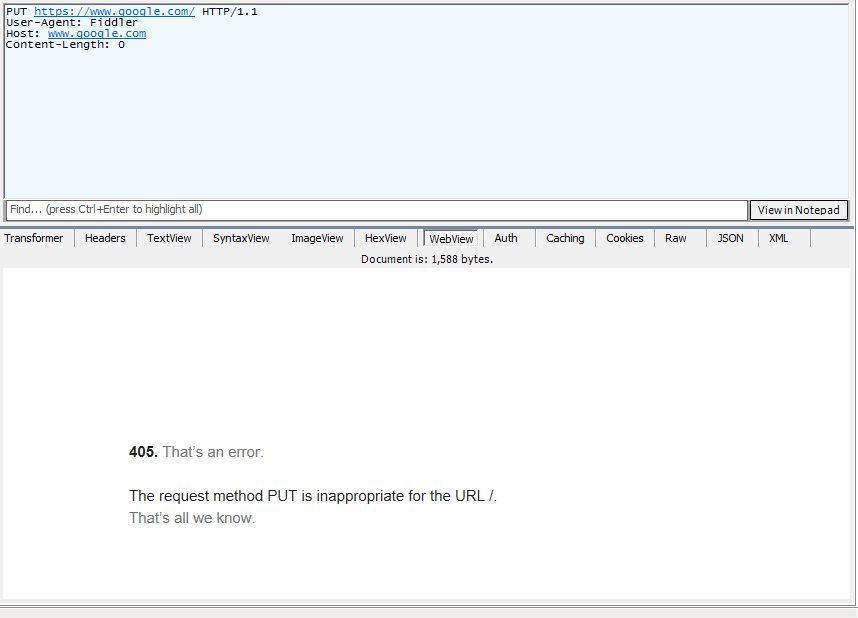
El método PUT se usa sobre todo en APIs web RESTful. PUT crea o sustituye el recurso en el URI dado en la petición, mientras que POST pide al servidor que procese los datos, a menudo creando un nuevo recurso en un URI que elige el servidor.
PUT suele estar desactivado por defecto en las instalaciones de servidores web.
Dejar PUT activado podría permitir a los atacantes subir y ejecutar archivos en el servidor web.
3. DELETE
Como PUT, el método DELETE se usa sobre todo en APIs RESTful. Usar DELETE debería ejecutar una acción de borrado sobre un objeto URI:
DELETE http://acmeco.com/customers/{customer-id}
DELETE está desactivado por defecto en la mayoría de las instalaciones de servidores web. Activar DELETE cuando no se necesita podría ser un riesgo de seguridad, al permitir a los atacantes borrar documentos de un sitio web.
4. HEAD
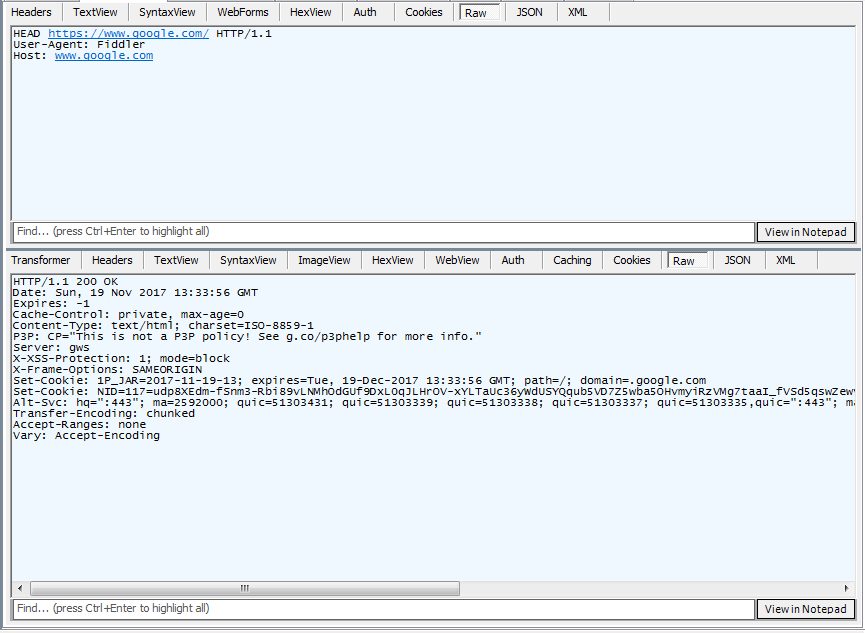
El método HEAD es parecido a GET pero devuelve solo cabeceras, sin contenido. HEAD se usa habitualmente para comprobar si un documento cacheado se ha actualizado. Si el documento es más nuevo que la versión cacheada, se descargará y cacheará el documento completo.
5. TRACE
TRACE es un método de diagnóstico y normalmente está desactivado en la mayoría de los servidores web. Muchos investigadores de seguridad han descubierto posibles vulnerabilidades con los métodos TRACE. El riesgo supera con mucho la utilidad de TRACE la mayoría de las veces.
6. OPTIONS
OPTIONS pregunta al servidor qué métodos y características admite para un recurso. No lo desactive: los navegadores envían una petición OPTIONS como preflight de CORS antes de muchas llamadas a API entre orígenes distintos, y bloquearla rompe esas aplicaciones. En su lugar, permita solo los métodos que su aplicación realmente necesita, y desactive TRACE.
7. CONNECT
CONNECT lo usan los proxies y no debería estar activado en un servidor web corriente. Cuando está activado y mal configurado, CONNECT puede permitir conexiones que reenvían peticiones a otros servidores. Esas conexiones reenviadas pueden usarse para ataques o para descargar archivos ilegales.
Por defecto, la mayoría del software de servidor web tiene CONNECT desactivado.
El uso legítimo de CONNECT es tunelizar conexiones HTTPS y otras conexiones TLS a través de un forward proxy.
(hr)
Tipos de medios (h2, anchor section06)
Un tipo de medio (Media Type) define los archivos según su naturaleza y formato para su presentación o procesamiento. La cabecera Content-Type se usa en una respuesta HTTP y permite a un navegador web mostrar el texto de la respuesta, cargar un plugin para un tipo de archivo admitido, o simplemente descargar un archivo para verlo en otra aplicación.
Originalmente el Media Type se implementó para los adjuntos de correo y se bautizó como MIME Types. MIME significa Multipurpose Internet Mail Extension.
Algunos Media Types pueden llevar el prefijo «x-» o «vnd». La «x» significa que un Media Type no está oficialmente registrado por la IANA (Internet Assigned Numbers Authority). La parte «vnd» significa que un Media Type es específico de un fabricante (por ejemplo application/vnd.ms-excel).
Ver los Media Types en Firefox
- escriba «about:config» en la barra de direcciones.
- en el cuadro de búsqueda de la configuración escriba «mime»
image: src /blog/wp-content/uploads/2017/12/rNTzwB7-e1513109426632.jpg (unchanged); alt: Configuración de MIME Type de Firefox en Linux
En una plataforma Linux vemos que Firefox usa el archivo /etc/mime.types
Veamos una porción del archivo /etc/mime.types:
$ head -n 40 /etc/mime.types | grep -v "^#" application/activemessage application/andrew-inset ez application/annodex anx application/applefile application/atom+xml atom application/atomcat+xml atomcat application/atomicmail application/atomserv+xml atomsrv application/batch-SMTP application/bbolin lin application/beep+xml application/cals-1840 application/commonground application/cu-seeme cu application/cybercash $ wc -l /etc/mime.types 835 /etc/mime.typesComo se ve, este sistema reconoce más de 800 mime types concretos. En esencia, esto le dice a Firefox qué extensiones están asociadas a determinados tipos de archivo.
NOTA: Los Media Types son distintos de las «aplicaciones por defecto» del sistema operativo. Aunque el concepto es parecido, los mime types se usan para aplicaciones conscientes de Internet, mientras que un sistema operativo mantiene un registro separado de tipos de archivo y sus visores asociados.
Cuando se hace una petición GET de una hoja de Excel, la cabecera Content-Type devuelve application/vnd.ms-excel. Así el navegador web sabe que el archivo no debe mostrarse como texto en la ventana del navegador. En cambio, el archivo se carga en un plugin visor o se descarga para verlo más tarde en otra aplicación.
Un servidor web Unix o Linux también usa /etc/mime.types para la cabecera Content-Type. Además, hay que definir un handler para un lenguaje de scripting como php, para que los archivos PHP se ejecuten en lugar de enviarse al navegador como texto. En RHEL, el /etc/httpd/conf.d/php.conf de Apache los entrega a PHP-FPM:
<FilesMatch \.(php|phar)$> SetHandler "proxy:unix:/run/php-fpm/www.sock|fcgi://localhost" </FilesMatch>Arriba: los archivos que terminan en .php (y .phar) se pasan al servicio PHP-FPM a través de su socket en lugar de servirse como archivos planos.
Si alguna vez ha hecho clic en un enlace y su navegador le ha mostrado un gráfico u otros datos binarios como ASCII, o le ha pedido descargar una página web, significa que los mime types del navegador o del servidor estaban mal configurados.
Para resolver el problema, mire la cabecera Content-Type en las herramientas para desarrolladores de su navegador (pestaña Network):
image: src /blog/wp-content/uploads/2017/12/FTSurmm-e1513109444640.jpg (unchanged); alt: Cabecera Content-Type en HTTPFox
Vemos que en una respuesta del servidor se especificó el content-type correcto. Si el navegador nos pidiera guardar la imagen solicitada con la petición GET, sabríamos que el mime type del navegador para image/jpeg necesita reconfigurarse.
Las configuraciones incorrectas del scripting del lado del servidor o de los mime types binarios pueden provocar problemas de seguridad en el servidor o en el cliente.
La IANA (Internet Assigned Numbers Authority) tiene la tarea de mantener un registro oficial de los media types a través del proceso RFC.
(hr)
Características de HTTP
En esta sección hablaremos de las características del protocolo HTTP. Los conceptos más importantes que hay que conocer al trabajar con HTTP son:
- HTTP es stateless
- HTTP no ofrece cifrado incorporado
¿Qué es un protocolo stateless?
HTTP es stateless por diseño: cada petición lleva todo lo que el servidor necesita para responderla. HTTP no es, sin embargo, connectionless. HTTP/1.1 y HTTP/2 mantienen abiertas las conexiones TCP y las reutilizan para muchas peticiones, y HTTP/3 hace lo mismo sobre QUIC.
Stateless significa simplemente que las transacciones HTTP las solicita un user agent y después las responde el servidor web. Si un cliente no cachea los recursos solicitados, debe emitir de nuevo el mismo método para volver a obtener el recurso. Un servidor web HTTP no tiene una tabla de estado en la que buscar comunicaciones anteriores con un user agent.
Cookies HTTP: las cookies pueden ayudar a un servidor web a referirse a interacciones HTTP anteriores con un user agent. El protocolo en sí sigue siendo stateless: cada petición se sostiene por sí sola, incluso cuando viaja por una conexión que se reutiliza.
La mayoría de los lenguajes de programación de backend, como el framework Django de Python, PHP y ASP .Net, ofrecen bibliotecas para mantener el estado de la aplicación con frameworks de sesiones incorporados. Este enfoque añade estado a una aplicación web, pero está abstraído a un nivel superior al de HTTP.
HTTP no proporciona cifrado
HTTP en sí no proporciona mecanismos de cifrado incorporados. El cifrado se deja a otros protocolos que definen HTTPS. HTTPS usa Transport Layer Security o TLS, el sucesor de SSL.
TLS funciona con muchos protocolos, no solo con HTTP. HTTPS está diseñado para transportar datos de contenido HTTP y cabeceras HTTP por conexiones TLS seguras. SSL lo desarrolló originalmente Netscape en la década de 1990. La IETF estandarizó después a su sucesor como TLS. Todas las versiones de SSL son ya obsoletas. Las vigentes son TLS 1.2 y TLS 1.3.
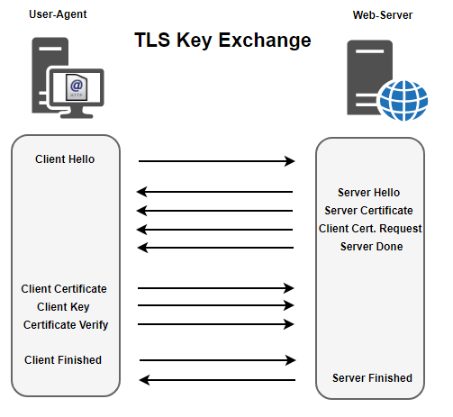
El lector atento puede preguntarse: «Entonces, ¿HTTPS es stateful? ¿No? Cada sesión tiene una clave, ¿no?». Las claves las guarda el cliente, sí. Pero TLS sigue funcionando en una capa inferior al núcleo HTTP de HTTPS. Las interacciones con el servidor web siguen usando los mismos métodos HTTP: GET, POST, PUT y DELETE.
(hr)
Autenticación HTTP (h2, anchor section07)
La autenticación, a diferencia del cifrado, está incorporada en HTTP. HTTP admite varios tipos de autenticación, entre ellos:
- Basic
- Bearer
- Digest
- HOBA
- Mutual
- Negotiate
- OAuth
- SCRAM-SHA1
- SCRAM-SHA256
- vapid
Basic Authentication
El método de autenticación HTTP más común con diferencia es la Basic Authentication. La Basic Authentication es común porque es sencilla de implementar, no porque sea segura. Otros esquemas de autenticación son más seguros, y la Basic Authentication solo debe usarse por HTTPS.
El mayor problema de seguridad de la Basic Authentication es que las credenciales se envían en texto claro. Aunque las credenciales se codifican en Base-64, la codificación no es cifrado, en el mejor de los casos es ofuscación. Las credenciales pueden verse comprometidas fácilmente cuando no se usa TLS o cuando el tráfico TLS cae víctima de un ataque man-in-the-middle.
Carencias de la Basic Authentication:
- codifica las credenciales solo en BASE 64
- las credenciales se guardan en la caché del navegador, dejando otro vector de ataque
- las credenciales pueden almacenarse permanentemente en el navegador
- servidores proxy maliciosos pueden llegar a registrar las credenciales
- las credenciales van en la cabecera HTTP
La BASIC Authentication sigue teniendo un propósito. Sin embargo, es importante reconocer los límites de ese propósito. La Basic Authentication solo es buena para el control de acceso. El control de acceso sirve simplemente para controlar el acceso a los recursos. La Basic Authentication no es buena para proteger datos. Especialmente información sensible que, de exponerse, podría traducirse en pérdida de ingresos o pérdida de privacidad.
Al implementar un esquema de autenticación HTTP, piense en la Basic Authentication como un código de acceso que permite la entrada autorizada a un edificio u oficina solo cuando el personal de seguridad está presente. Fuera del horario laboral, las mismas puertas se cierran con un mecanismo más seguro para proteger el edificio.
- el control de acceso es el acceso cómodo para el personal autorizado
- la seguridad mantiene la propiedad a salvo de los atacantes
A continuación, una ilustración de una petición/respuesta de Basic Authentication:
images: src /blog/wp-content/uploads/2017/12/fvNIZLj-e1513109471712.jpg and /blog/wp-content/uploads/2017/12/Svu1sFi-e1513109482792.jpg (unchanged); alts: Basic Authentication 1, Basic Authentication 2
- El user agent hace una petición de un documento
- El servidor web responde con el código HTTP 401: Authorization Required
- El user agent repite la petición con credenciales
- El servidor web permite o deniega el acceso según la validez de las credenciales
Como demostración de las carencias de la Basic Authentication, intente averiguar las credenciales a partir de la cadena codificada en BASE64 que se muestra.
Autenticación con Bearer Token
La autenticación con Bearer Token es popular entre los proveedores de frameworks de autenticación. La Bearer Authentication también puede desplegarse como solución independiente, caso por caso.
La Bearer Authentication se basa en tokens y se usa tanto en OAuth como en OpenID. Normalmente OAuth se usa para autorización mientras que OpenID es para autenticación. Sin embargo, existen varias zonas grises que difuminan los límites entre autenticación y autorización en cada framework.
- OpenID proporciona autenticación federada o servicios de inicio de sesión
- OAuth proporciona autorización delegada
GitHub proporciona una guía OAuth para desarrolladores de aplicaciones de terceros que quieran acceder a recursos de GitHub en nombre de un usuario final. Guía de OAuth App de GitHub
Grandes proveedores de identidad como Google ofrecen inicio de sesión a través de OpenID Connect, el estándar OpenID vigente, que está construido sobre OAuth 2.0.
Inicio de sesión con OpenID Connect con una cuenta de Google:
image: src /blog/wp-content/uploads/2017/12/BMtbtwA.jpg (unchanged); alt: Proveedor de autenticación Google Open ID
Digest Authentication
La Digest Authentication es más segura que la Basic Authentication. Sin embargo, la Digest Authentication sigue siendo insuficiente para proteger material sensible en Internet. La Digest Authentication no cifra las credenciales, les aplica un hash, y si esos hashes se capturan, un atacante puede lanzar un ataque offline de fuerza bruta o de diccionario.
Tanto el esquema Digest como el Basic se consideran débiles en el panorama general de la seguridad de los datos. Cada uno tiene defectos y cada uno ha sido atacado con éxito. Cuando se necesita algo más que control de acceso o autorización básicos, hay que desplegar un esquema de autenticación más seguro.
Otros esquemas de autenticación basados en HTTP
NTLM, conocido como NT Lan Manager Authentication, es una tecnología de Microsoft con plugins para muchos productos, sistemas operativos y servicios de terceros.
En dominios Windows la opción preferida es Negotiate, que usa Kerberos y recurre a NTLM solo cuando debe. Microsoft está retirando NTLM progresivamente. Con Kerberos, los usuarios del dominio que ya han iniciado sesión pueden acceder a los recursos autorizados sin volver a introducir sus credenciales.
Los mayores inconvenientes de la autenticación con NTLM son:
- puede ser engorrosa de implementar en plataformas distintas de Windows
- puede perder muchas características de seguridad si se despliega fuera de un Windows Domain
- NTLM es tan seguro como la red corporativa
- las versiones antiguas de NTLM se consideran inseguras
SCRAM-SHA1 y SCRAM-SHA256
SCRAM es el acrónimo de Salted Challenge Response Authentication Mechanism
Cuando hay que autenticar a empleados internos, la autenticación SCRAM junto con OpenLDAP puede ser una buena solución para entornos con equipos de varios fabricantes.
SCRAM puede ser más complejo de desplegar que NTLM en un Windows Domain. Pero SCRAM puede ser una opción excelente en una red con clientes Linux, MacOS Server, Windows y Unix, e incluso a través de Internet.
Lectura relacionada: Guía completa de los códigos de estado HTTP: serie 300
Del archivo del blog de EuroVPS, publicado por primera vez el 12 de diciembre de 2017.
Todas las notas de campo