

O que é afinal o Hypertext Transfer Protocol (HTTP)?
O HTTP da primeira linha de pedido até ao HTTP/2: métodos, cabeçalhos, códigos de estado, keep-alive e o que cada um significa para um servidor que opera.
A criação da World Wide Web foi aperfeiçoada ao longo dos anos de cerca de 1988 a 1991.
Originalmente, os mecanismos do HTTP foram concebidos para permitir que cientistas de todo o mundo partilhassem uma plataforma de investigação e colaboração. Como se veio a verificar, a world wide web pôs ferramentas de publicação, aprendizagem e colaboração ao alcance de qualquer pessoa com uma ligação à Internet.
(hr)
Os componentes originais por trás da invenção de Tim Berners-Lee continuam em uso hoje. Na verdade, alguns web servers modernos ainda compreendem a especificação HTTP original (embora hoje seja considerada obsoleta):
Componentes básicos da World Wide Web:
- um web server
- um user agent
- apresentação textual
- tipos de média (Media Types)
- um protocolo que permite a transferência de documentos, o HTTP
| A W.W.W. de hoje | |
|---|---|
| web server | IIS, Apache, NGiNX |
| user agent | CuRL, Chrome, Firefox, RSS Readers |
| dados textuais | UTF-8, ASCII, JSON, HTML, XML, CSS |
| tipos de média | dados textuais, imagens, vídeo, animações |
| especificações HTTP | HTTP/1.1 (RFC 9112), HTTP/2 (RFC 9113) e HTTP/3 (RFC 9114), com semântica comum no RFC 9110 |
Duas entidades principais estão encarregadas de definir a evolução do HTTP moderno:
- W3C World Wide Web Consortium O W3C ocupa-se da funcionalidade dos web servers, das necessidades futuras de especificação, dos user agents (ou web browsers), do HTML, do XML, do vídeo, das imagens e das tecnologias de distribuição de conteúdos. Grosso modo, o W3C ocupa-se dos efeitos do HTTP na camada de aplicação.
- IETF Internet Engineering Task Force A IETF ocupa-se de como o HTTP funciona e opera a um nível técnico mais baixo. O HTTP trabalha por cima de tecnologias subjacentes como IPv4, TCP, UDP, Ethernet e muitos outros protocolos de camadas inferiores. Todos os protocolos inferiores trabalham em conjunto para levar os dados do user agent ao web server, e de volta ao user agent.
Retirado do website de cada um, o W3C e a IETF descrevem-se nas suas próprias palavras:
- O World Wide Web Consortium (W3C) é uma comunidade internacional onde organizações membros, uma equipa a tempo inteiro e o público trabalham em conjunto para desenvolver normas da Web. (https://www.w3.org/Consortium/)
- O objetivo da IETF é fazer a Internet funcionar melhor. A missão da IETF é fazer a Internet funcionar melhor produzindo documentos técnicos relevantes e de alta qualidade que influenciam a forma como as pessoas concebem, usam e gerem a Internet. (https://www.ietf.org)
Como se definem normas como o HTTP? (h2, anchor section01)
Quando um protocolo da Internet como o HTTP é adotado ou revisto, as normas são definidas em documentos chamados RFC.
RFC significa Request For Comments.
Todos os protocolos de comunicação de dados reconhecidos e aceites para uso generalizado na Internet são definidos numa série de documentos RFC. Tecnologias como HTTP, IPv4, TLS, PKI, SNMP, POP3 e até a Ethernet não são tecnologias que pertençam à Microsoft, à Apple ou à Google.
As normas definidas num RFC destinam-se a ser adotadas como meio de permitir a comunicação entre plataformas de vários fabricantes. Cada tecnologia (no seu núcleo) documentada num RFC pode ser implementada, aperfeiçoada para uso e até acrescentada a produtos por qualquer pessoa ou fabricante, sem royalties nem patentes.
Um RFC é normalmente um documento bastante seco, disponível em texto ASCII, seguindo a tradição de ser legível em qualquer plataforma. Um RFC também presume que o leitor domina conceitos técnicos.
- As especificações HTTP atuais: RFC 9110 HTTP Semantics, RFC 9112 HTTP/1.1, RFC 9113 HTTP/2 e RFC 9114 HTTP/3
(hr)
HTTP é o acrónimo de Hyper Text Transfer Protocol. O HTTP é um protocolo stateless da camada de aplicação concebido para comunicar trocas de informação entre sistemas através da Internet. Como tal, o HTTP define um conjunto de regras que permitem tanto a transferência como o acesso a documentos remotos. O HTTP também tem sido usado para transferir informação de outras formas, como o SSDP, que usa UDP e endereçamento multicast (adotado como HTTPU) para transferências de informação.
O que o HTTP NÃO é?
O HTTP e a world wide web não são a Internet. O HTTP é um protocolo que alimenta uma parte extremamente popular da Internet, conhecida como a world wide web.
O HTTP opera acima dos protocolos subjacentes de comunicação de rede no modelo TCP/IP. O TCP/IP é um mecanismo para transferir dados, enquadrar informação e dados da camada de aplicação através da Internet. O HTTP é uma norma da camada de aplicação especializada na transferência de um certo tipo de dados. O HTTP/1.1 e o HTTP/2 correm sobre TCP, enquanto o HTTP/3 corre sobre QUIC, que é construído sobre UDP.
O TCP/IP é uma suite de protocolos de comunicação de dados desenvolvida pelo Departamento de Defesa dos EUA. O TCP/IP é por vezes referido como «o modelo de rede do DoD».
Nos seus primeiros anos, a Internet e o TCP/IP foram doados pelos laboratórios da DARPA à academia. Depois de aperfeiçoada para uso académico, a Internet foi adotada por consumidores e empresas até se tornar aquilo que hoje conhecemos como Internet. Foi durante o período de transição da academia para o uso público inicial que o HTTP e a world wide web foram introduzidos.
| TCP/IP | Protocolos por camada |
|---|---|
| Camada de aplicação | HTTP: world wide web · FTP: protocolo de transferência de ficheiros · POP3 e IMAP: e-mail recebido · SMTP: e-mail enviado · HTML: marcação para apresentar páginas web · JPEG: formato gráfico para apresentar imagens |
| Camada de transporte | TCP: comunicação orientada à ligação entre hosts · UDP: comunicação sem ligação entre hosts (o QUIC, usado pelo HTTP/3, corre por cima dele) |
| Camada de Internet | IPv4: endereçamento para redes remotas · IPv6: endereçamento para redes remotas · BGP: encaminhamento de tráfego entre fornecedores de Internet · OSPF: encaminhamento de tráfego em redes internas · ICMP: estrutura para transmitir diagnósticos |
| Camada de ligação | Ethernet meio físico e sinalização para transferência de dados de baixo nível · Token Ring concorrente da Ethernet, hoje raramente visto · 802.11 especificações para comunicações sem fios · Bluetooth especificação para ligar dispositivos sem fios · Frame Relay especificações físicas e de dados para redes de área alargada |
A tabela acima é uma representação de como o HTTP se enquadra na Internet e no TCP/IP.
(hr)
Especificações do HTTP (h2, anchor section02)
Em primeiro lugar, o HTTP serve para comunicar transferências de documentos entre um user agent e um web server.
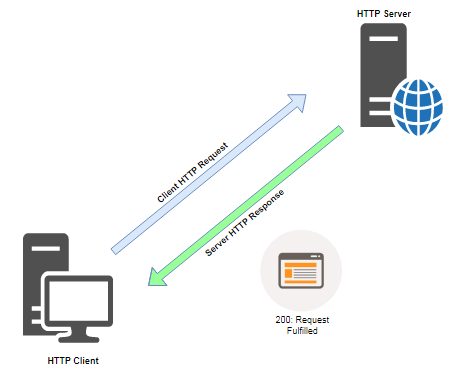
As trocas HTTP consistem normalmente no user agent a pedir uma série de documentos a um web server. Quando um pedido HTTP é recebido pelo web server, este analisa-o. Por fim, o web server ou devolve um documento e um código de estado, ou pode recusar um pedido devolvendo um código de estado que explica porque foi recusado.
- Para detalhes sobre porque é que um web server pode recusar um pedido de um cliente, consulte a secção dos códigos de estado HTTP 400
Artigo relacionado: Guia completo dos códigos de estado HTTP: série 400
User-Agent é um termo pomposo para uma aplicação que pede recursos HTTP a um web server. Mais frequentemente, os user agents são conhecidos como web browsers. No entanto, RSS Readers, bots de web scraping, web spiders e bibliotecas HTTP como o CURL também são user agents.
Web Server é um daemon que normalmente corre na porta 80 (HTTP) e na porta 443 (HTTPS), com o propósito específico de obter documentos de uma parte designada do sistema de ficheiros do servidor para entrega a um user agent.
Os três web servers de alta carga mais comuns na Internet hoje são o Apache, o Nginx (pronuncia-se Engine-X) e o IIS (da Microsoft).
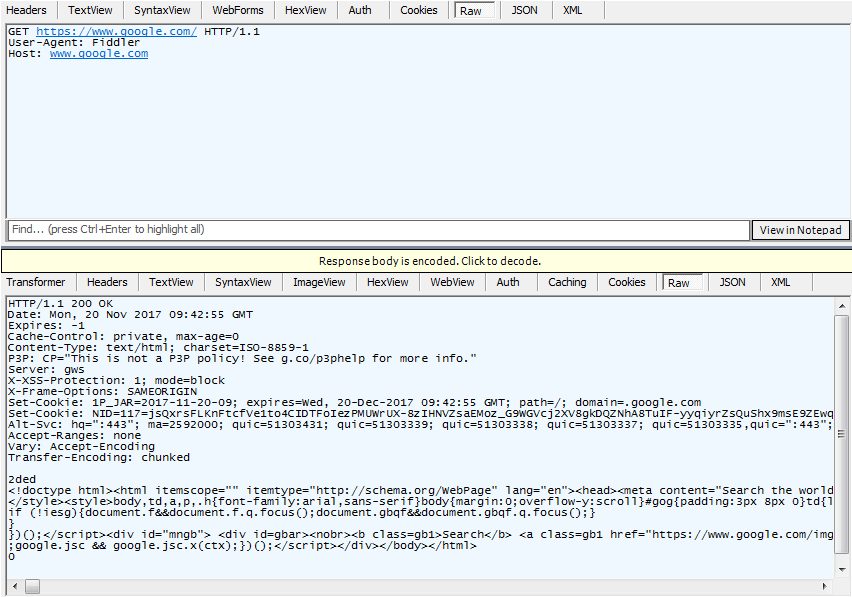
Vejamos um pedido HTTP simples com uma aplicação user agent chamada Fiddler.
O Fiddler é um proxy de debugging HTTP para APIs e aplicações web. As ferramentas de programador incluídas em todos os browsers modernos mostram grande parte da mesma informação.
(hr)
Métodos de pedido HTTP (h2, anchor section03)
Tal como se vê no primeiro diagrama de uma troca de pedido/resposta HTTP, o user agent pede um documento e depois um web server satisfaz um pedido HTTP válido.
Como se vê na parte superior da janela do Fiddler, o Fiddler, o user agent, enviou três linhas de dados:
- O GET especifica o ficheiro e o caminho
- O User-Agent identifica o software do cliente
- O HOST especifica o host onde o conteúdo está localizado
O método de pedido é GET neste pedido. Vamos aprender outros métodos de pedido HTTP neste guia.
A string User-Agent: Uma string User-Agent é a forma como o software do cliente web se identifica perante o web server. As APIs e os websites concedem ou recusam muitas vezes privilégios de acesso e definições de apresentação com base na string User-Agent do cliente.
Os crawlers bem comportados identificam-se honestamente na sua string User-Agent e seguem as regras que um website publica no seu ficheiro robots.txt.
| Alguns exemplos de strings User-Agent (os números de versão mudam a cada lançamento): | |
|---|---|
| Chrome em Windows 7 | Mozilla/5.0 (Windows NT 6.1; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/62.0.3202.94 Safari/537.36 |
| Internet Explorer 11 | Mozilla/5.0 (Windows NT 6.1; WOW64; Trident/7.0; rv:11.0) like Gecko |
| Googlebot | Mozilla/5.0 (Linux; Android 6.0.1; Nexus 5X Build/MMB29P) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/41.0.2272.96 Mobile Safari/537.36 (compatible; Googlebot/2.1; +http://www.google.com/bot.html) |
| Play Station 4 | Mozilla/5.0 (PlayStation 4 4.71) AppleWebKit/601.2 (KHTML, like Gecko) |
Host
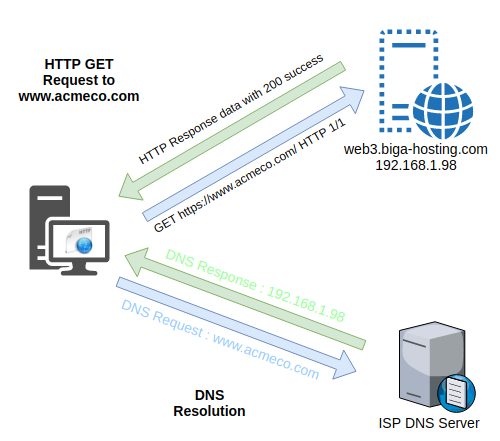
O cabeçalho Host especifica o servidor (e o domínio) que possui o documento pedido. Desde o HTTP/1.1 o cabeçalho Host é obrigatório (o HTTP/2 e o HTTP/3 transportam a mesma informação no campo :authority). É obrigatório porque muitos websites partilham um servidor e um endereço IP, uma disposição chamada name-based virtual hosting, e o servidor precisa do cabeçalho Host para saber a que website se destina um pedido.
Um endereço IP de host 192.168.1.98 pode ter o nome DNS externo web3.biga-hosting.com. Este servidor chamado web3.biga-hosting.com pode alojar centenas de domínios. Por sua vez, o cabeçalho Host do HTTP informa o servidor de a que domínio alojado se destina um pedido. Vários domínios virtuais podem ter o mesmo endereço IPv4 192.168.1.98 (o reverse DNS aponta normalmente para web3.biga-hosting.com).
(hr)
Dissecar o HTTP
Esta secção vai aprofundar um pouco mais o funcionamento interno do protocolo HTTP. Os temas discutidos para uma visão geral do HTTP incluem:
- Conceitos de URI e URL
- Verbos HTTP: GET, POST, PUT, DELETE, HEAD, TRACE, OPTIONS
- Tipos de média
- Características comuns do HTTP: stateless, sem encriptação incorporada, autenticação HTTP
(hr)
Conceitos de URI e URL (h2, anchor section04)
De todos os conceitos em torno do HTTP, decifrar os termos URI e URL é simples e, no entanto, continua a confundir tanto estudantes como alguns programadores. Para confundir ainda mais um conceito simples, o termo URI foi aperfeiçoado e documentado em normas que permitem que o termo URL seja sinónimo de URI.
URI é o acrónimo de Uniform Resource Identifier. URL é o acrónimo de Uniform Resource Locator.
Definamos cada um nos termos mais simples possíveis, com uma analogia. No nosso cenário, digamos que URI é análogo ao termo automóvel. Um URL é um tipo específico de URI. Digamos então que URL é análogo a um «carro ligeiro», mas não a um camião ou a uma carrinha.
No entanto, aconselha-se a usar sempre o termo URI se a diferença tiver alguma importância.
Para compreender melhor o conceito de URI, digamos agora que queremos localizar um livro. Mas não sabemos onde o livro está. Não poderíamos usar um URL, uma vez que um URL é específico de um host. Poderíamos, porém, usar um URN:
urn:isbn:0451450523Quando se usa um URN como o acima, uma aplicação web subjacente fica encarregada da lógica de negócio de localizar o documento pedido.
Digamos, na nossa analogia, que um URN é uma carrinha, outro tipo específico de automóvel. Um URI define um URN e um URL. Um URN identifica um recurso específico, no nosso exemplo um livro. Já um URL identifica a localização e outros meios de acesso a um recurso.
Dissecar um URL
Um URL, também conhecido como Uniform Resource Locator, é o URI mais comum em uso na world wide web. É o que escrevemos na barra de endereços de um web browser para chegar a https://www.google.com.
Vejamos um URL mais complexo e decomponhamos cada parte:
http://admin:password@web5.acmeco.com:8080/admin-docs/2017/ins/infrastructure.xlsxÉ sintaticamente válido, mas mostra algo que nunca se deve fazer.
A forma user:password num URL está descontinuada (RFC 3986), e os browsers modernos removem-na ou bloqueiam-na. As credenciais num URL acabam nos logs do servidor, no histórico do browser e nos cabeçalhos Referer. Nunca ponha credenciais, com hash ou sem ele, num URL.
| Credenciais num URL | |
|---|---|
| scheme | http:// |
| credenciais | admin:password |
| recurso/host | web5.acmeco.com |
| porta | 8080 |
| caminho | /admin-docs/2017/ins/ |
| documento | infrastructure.xlsx |
O http://www.acmeco.com/ também é um URL válido.
A barra no fim diz ao web server que queremos o documento predefinido na webroot. Tradicionalmente este documento chama-se index.html, mas pode ser alterado para qualquer coisa pelo administrador do servidor.
Outro URL válido pode ser: mailto:user@example.com. Em vez de pedir um documento, este URL abre o cliente de e-mail predefinido, pronto para escrever para esse endereço.
Alguns schemes de protocolo de URL válidos são: https://, http://, ftp://, file://, mailto:, tel:, e provavelmente mais alguns. O http e o https são, no entanto, os protocolos mais usados na world wide web.
Query strings
Existe outra forma comum de especificar um URL, muito usada na world wide web. Chama-se query string. Uma query string é normalmente usada em conjunto com uma aplicação web de backend ou um script CGI.
Um exemplo é acrescentado ao nosso pedido GET anterior, acedendo diretamente à pesquisa da Google:
https://www.google.com/search?q=euro+vps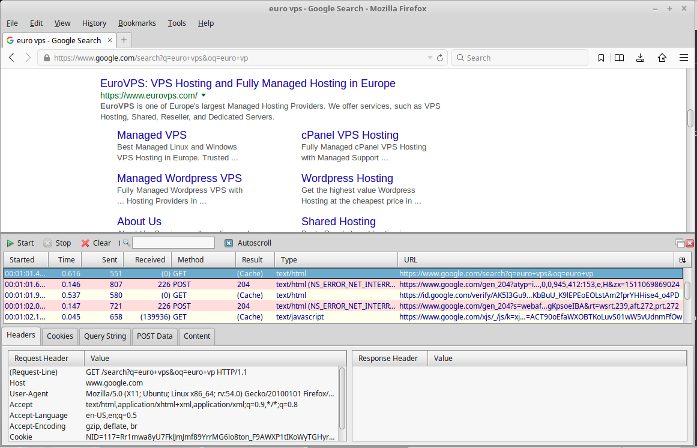
As query strings são normalmente usadas para passar parâmetros a um script de backend. A query string é codificada pelo web browser, entregue a um web server, descodificada pelo web server ou pela aplicação e, por fim, processada pela aplicação web.
As query strings são conhecidas por terem sido exploradas com a passagem de parâmetros maliciosos em tentativas de manipular a funcionalidade de uma aplicação web.
https://www.acmeco.com/auth/auth.php?user=acmeuser&password=EXAMPLEAcima está um exemplo do que nunca se deve fazer. As credenciais, com hash ou sem ele, nunca devem viajar num URL: acabam nos logs HTTP, no histórico do browser e nos cabeçalhos Referer. Envie-as no corpo de um POST por HTTPS, ou num cabeçalho Authorization.
(hr)
Verbos HTTP (h2, anchor section05)
Agora que temos uma boa ideia do que é um URL e de como se usam as query strings, vamos apresentar os verbos usados nos pedidos HTTP. Os verbos HTTP mais usados são:
- POST e GET
- PUT
- DELETE
- HEAD
- TRACE
- OPTIONS
- CONNECT
1. POST e GET
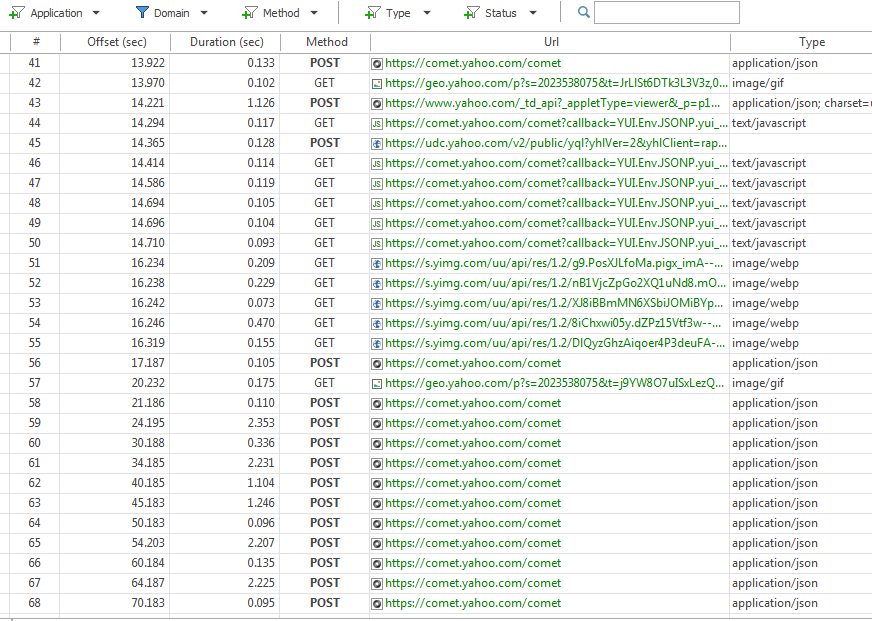
O GET é o método predefinido quando se escreve um website na barra de endereços de um browser ou se clica numa hiperligação. Quando uma página web é pedida, o browser pode na realidade fazer vários pedidos GET ou POST ao descarregar todos os recursos que compõem uma página web, incluindo imagens, stylesheets, scripts do lado do cliente, recursos tipográficos e mais:
Hiperligação é o termo técnico para a ligação a páginas web secundárias. Quando o utilizador clica numa ligação (ou hiperligação), o browser envia um pedido GET para a página ligada
Pedidos POST
Os dois métodos de pedido mais usados são o GET e o POST. Já decompusemos um pedido GET. Examinemos então um pedido POST.
E se quiséssemos carregar um ficheiro de 1GB através de um script PHP ou asp? Naturalmente, um URL não consegue conter uma string binária de 1GB. Neste cenário usaríamos o método POST.
O POST é semelhante ao GET no sentido em que pode passar parâmetros como uma query string. No entanto, os dados POST não são acrescentados a um URL como acontece com a query string.
Em vez disso, os dados POST viajam no corpo do pedido HTTP, depois dos cabeçalhos. O POST é mais frequentemente usado com dados de formulários HTML.
O método POST é normalmente usado quando são necessárias as seguintes características:
- carregamento de ficheiros
- manter dados sensíveis fora do URL
- é preciso enviar strings de dados mais longas
- é preciso usar esquemas de codificação diferentes
- não pode ser colocado em cache (se houver uma preocupação de segurança)
Comparemos com algumas vantagens do método GET com uma query string acrescentada ao URL
- pode ser guardado como marcador
- pode ser colocado em cache
- os resultados de uma consulta podem ser partilhados com uma ligação
2. PUT
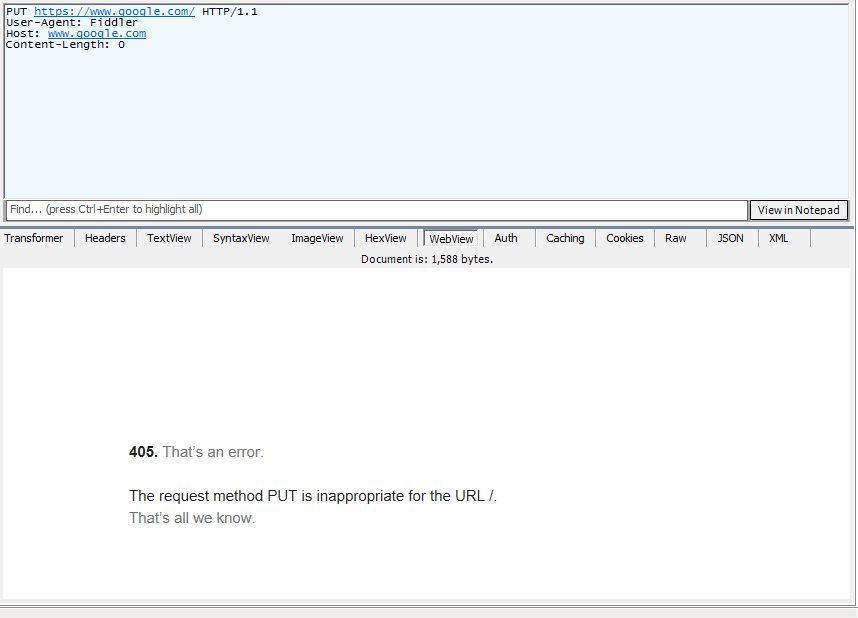
O método PUT é mais frequentemente usado em web APIs RESTful. O PUT cria ou substitui o recurso no URI indicado no pedido, enquanto o POST pede ao servidor que processe os dados, muitas vezes criando um novo recurso num URI escolhido pelo servidor.
O PUT está normalmente desativado por omissão nas instalações de web server.
Deixar o PUT ativado poderia potencialmente permitir a atacantes carregar e executar ficheiros no web server.
3. DELETE
Tal como o PUT, o método DELETE é mais frequentemente usado em APIs RESTful. Usar o DELETE deve executar uma ação de eliminação sobre um objeto URI:
DELETE http://acmeco.com/customers/{customer-id}
O DELETE está desativado por omissão na maioria das instalações de web server. Ativar o DELETE quando não é necessário pode ser um risco de segurança, permitindo a atacantes eliminar documentos de um website.
4. HEAD
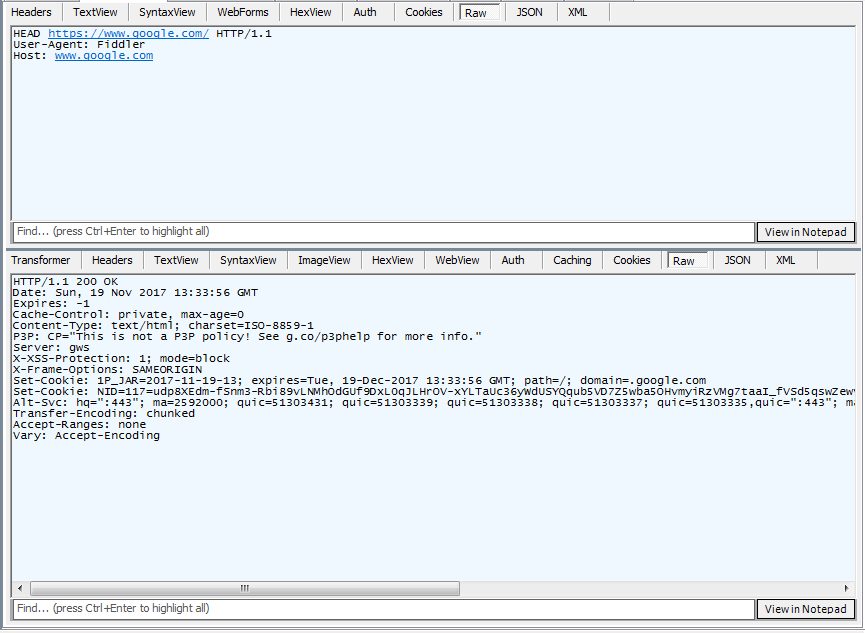
O método HEAD é semelhante ao GET, mas devolve apenas cabeçalhos, sem conteúdo. O HEAD é normalmente usado para verificar se um documento em cache foi atualizado. Se o documento for mais recente do que a versão em cache, o documento inteiro é descarregado e colocado em cache.
5. TRACE
O TRACE é um método de diagnóstico e está normalmente desativado na maioria dos web servers. Muitos investigadores de segurança descobriram potenciais vulnerabilidades com os métodos TRACE. Na maioria das vezes, o risco supera de longe a utilidade do TRACE.
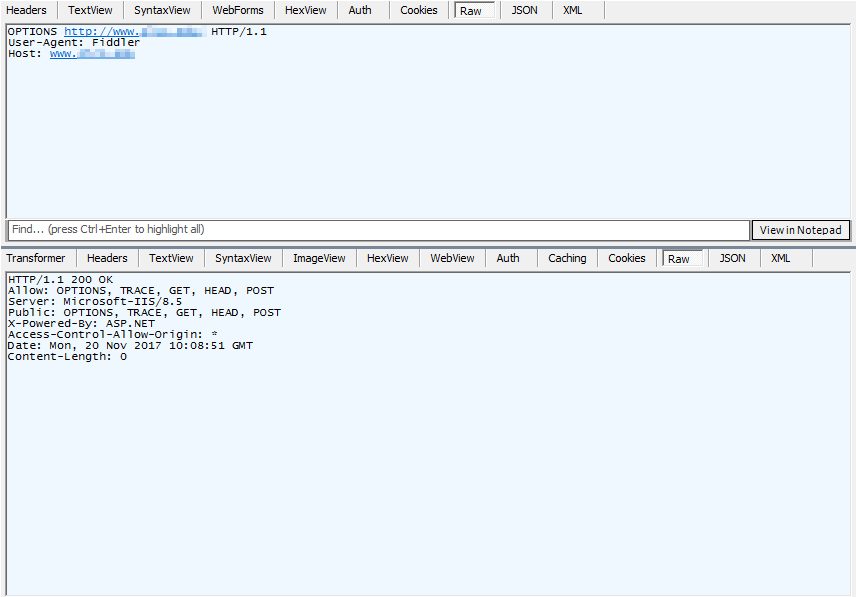
6. OPTIONS
O OPTIONS pergunta ao servidor que métodos e funcionalidades suporta para um recurso. Não o desative: os browsers enviam um pedido OPTIONS como CORS preflight antes de muitas chamadas de API entre origens diferentes, e bloqueá-lo estraga essas aplicações. Em vez disso, permita apenas os métodos de que a sua aplicação realmente precisa, e desative o TRACE.
7. CONNECT
O CONNECT é usado por proxies e não deve estar ativado num web server comum. Quando ativado e mal configurado, o CONNECT pode permitir ligações que encaminham pedidos para outros servidores. Essas ligações encaminhadas podem ser usadas para ataques ou para descarregar ficheiros ilegais.
Por omissão, a maioria do software de web server tem o CONNECT desativado.
A utilização legítima do CONNECT é o túnel de ligações HTTPS e outras ligações TLS através de um forward proxy.
(hr)
Tipos de média (h2, anchor section06)
Um tipo de média (Media Type) define os ficheiros com base na sua natureza e formato, para apresentação ou processamento. O cabeçalho Content-Type é usado numa resposta HTTP e permite a um web browser apresentar o texto da resposta, carregar um plugin para um tipo de ficheiro suportado, ou simplesmente descarregar um ficheiro para visualização noutra aplicação.
Originalmente o Media Type foi implementado para anexos de e-mail e batizado de MIME Types. MIME significa Multipurpose Internet Mail Extension.
Alguns Media Types podem ter o prefixo «x-» ou «vnd». O «x» significa que um Media Type não está oficialmente registado pela IANA (Internet Assigned Numbers Authority). A parte «vnd» significa que um Media Type é específico de um fabricante (por exemplo application/vnd.ms-excel).
Ver os Media Types no Firefox
- escreva «about:config» na barra de endereços.
- na caixa de pesquisa de configurações escreva «mime»
image: src /blog/wp-content/uploads/2017/12/rNTzwB7-e1513109426632.jpg (unchanged); alt: Configuração de MIME Types do Firefox em Linux
Numa plataforma Linux vemos que o Firefox usa o ficheiro /etc/mime.types
Vejamos uma parte do ficheiro /etc/mime.types:
$ head -n 40 /etc/mime.types | grep -v "^#"
application/activemessage
application/andrew-inset			ez
application/annodex				anx
application/applefile
application/atom+xml				atom
application/atomcat+xml				atomcat
application/atomicmail
application/atomserv+xml			atomsrv
application/batch-SMTP
application/bbolin				lin
application/beep+xml
application/cals-1840
application/commonground
application/cu-seeme				cu
application/cybercash
$ wc -l /etc/mime.types
835 /etc/mime.types
Como se vê, mais de 800 mime types específicos são reconhecidos por este sistema. No essencial, isto diz ao Firefox quais as extensões associadas a certos tipos de ficheiro.
NOTA: Os Media Types são diferentes das «aplicações predefinidas» do sistema operativo. Embora semelhantes em conceito, os mime types são usados por aplicações que conhecem a Internet, enquanto um sistema operativo mantém um registo separado de tipos de ficheiro e dos visualizadores associados.
Quando é feito um pedido GET por uma folha de cálculo Excel, o cabeçalho Content-Type devolve application/vnd.ms-excel. Assim o web browser sabe que o ficheiro não deve ser apresentado como texto na janela do browser. Em vez disso, o ficheiro é carregado num plugin de visualização ou descarregado para visualização posterior noutra aplicação.
Um web server Unix ou Linux também usa o /etc/mime.types para o cabeçalho Content-Type. Além disso, tem de ser definido um handler para uma linguagem de scripting como o php, para que os ficheiros PHP sejam executados em vez de enviados para o browser como texto. Em RHEL, o /etc/httpd/conf.d/php.conf do Apache entrega-os ao PHP-FPM:
<FilesMatch \.(php|phar)$>
    SetHandler "proxy:unix:/run/php-fpm/www.sock|fcgi://localhost"
</FilesMatch>
Acima: os ficheiros terminados em .php (e .phar) são passados ao serviço PHP-FPM através do seu socket, em vez de serem servidos como ficheiros simples.
Se alguma vez clicou numa ligação e o browser lhe apresentou um gráfico ou outros dados binários como ASCII, ou lhe pediu para descarregar uma página web, isso significa que os mime types do browser ou do servidor estavam mal configurados.
Para diagnosticar, veja o cabeçalho Content-Type nas ferramentas de programador do seu browser (separador Network):
image: src /blog/wp-content/uploads/2017/12/FTSurmm-e1513109444640.jpg (unchanged); alt: Cabeçalho Content-Type no HTTPFox
Vemos que o content-type correto foi especificado numa resposta do servidor. Se o browser estivesse a pedir para guardar a imagem pedida pelo pedido GET, saberíamos que o mime type do browser para image/jpeg precisa de ser reconfigurado.
Configurações incorretas de server-side scripting ou de mime types binários podem levar a problemas de segurança no servidor ou no cliente.
A IANA (Internet Assigned Numbers Authority) está encarregada de manter um mapeamento oficial dos media types através do processo RFC.
(hr)
Características do HTTP
Nesta secção vamos discutir características do protocolo HTTP. Os conceitos mais importantes a conhecer quando se trabalha com HTTP são:
- O HTTP é stateless
- O HTTP não oferece encriptação incorporada
O que é um protocolo stateless?
O HTTP é stateless por conceção: cada pedido transporta tudo o que o servidor precisa para lhe responder. O HTTP não é, porém, connectionless. O HTTP/1.1 e o HTTP/2 mantêm ligações TCP abertas e reutilizam-nas para muitos pedidos, e o HTTP/3 faz o mesmo sobre QUIC.
Stateless significa simplesmente que as transações HTTP são pedidas por um user agent e depois respondidas pelo web server. Se um cliente não fizer cache dos recursos pedidos, tem de emitir de novo o mesmo método para voltar a obter o recurso. Um web server HTTP não tem uma tabela de estado onde consultar comunicações anteriores com um user agent.
HTTP Cookies: os cookies podem ajudar um web server a referenciar interações HTTP passadas com um user agent. O protocolo em si continua stateless: cada pedido vale por si, mesmo quando viaja por uma ligação que é reutilizada.
A maioria das linguagens de programação de backend, como a framework Django do Python, o PHP e o ASP .Net, oferece bibliotecas para manter o estado da aplicação com frameworks de sessões incorporadas. Esta abordagem acrescenta estado a uma aplicação web, mas é abstraída a um nível superior ao do HTTP.
O HTTP não fornece encriptação
O HTTP em si não fornece mecanismos de encriptação incorporados. A encriptação é deixada a outros protocolos que definem o HTTPS. O HTTPS usa o Transport Layer Security, ou TLS, o sucessor do SSL.
O TLS funciona com muitos protocolos, não só com o HTTP. O HTTPS é concebido para transportar dados de conteúdo HTTP e cabeçalhos HTTP por ligações TLS seguras. O SSL foi originalmente desenvolvido nos anos 1990 pela Netscape. A IETF normalizou mais tarde o seu sucessor como TLS. Todas as versões do SSL estão agora obsoletas. As atuais são o TLS 1.2 e o TLS 1.3.
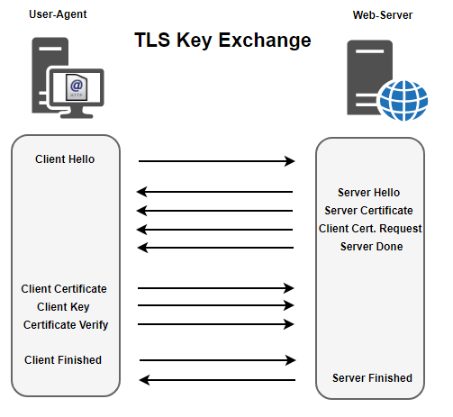
O leitor atento pode perguntar-se: «Então o HTTPS é stateful? Certo? Cada sessão tem uma chave? Certo?». As chaves são guardadas pelo cliente, sim. Mas o TLS continua a funcionar a uma camada inferior à do núcleo HTTP do HTTPS. As interações com o web server continuam a usar os mesmos métodos HTTP: GET, POST, PUT e DELETE.
(hr)
Autenticação HTTP (h2, anchor section07)
A autenticação, ao contrário da encriptação, está incorporada no HTTP. O HTTP suporta vários tipos de autenticação, entre os quais:
- Basic
- Bearer
- Digest
- HOBA
- Mutual
- Negotiate
- OAuth
- SCRAM-SHA1
- SCRAM-SHA256
- vapid
Basic Authentication
O método de autenticação HTTP de longe mais comum é a Basic Authentication. A Basic Authentication é comum porque é simples de implementar, não porque seja segura. Outros esquemas de autenticação são mais seguros, e a Basic Authentication só deve ser usada por HTTPS.
O maior problema de segurança da Basic Authentication é que as credenciais são enviadas em texto claro. Embora as credenciais sejam codificadas em Base-64, codificação não é encriptação, é no máximo ofuscação. As credenciais podem ser facilmente comprometidas quando não se usa TLS ou quando o tráfego TLS é vítima de um ataque man-in-the-middle.
Fraquezas da Basic Authentication:
- codifica as credenciais apenas em BASE 64
- as credenciais ficam em cache no browser, deixando mais um vetor de ataque
- as credenciais podem ser guardadas permanentemente no browser
- proxy servers maliciosos podem potencialmente registar as credenciais
- as credenciais estão no cabeçalho HTTP
A BASIC Authentication continua a servir um propósito. No entanto, é importante reconhecer os limites desse propósito. A Basic Authentication só é boa para controlo de acesso. O controlo de acesso destina-se simplesmente a controlar o acesso a recursos. A Basic Authentication não é boa para proteger dados. Especialmente informação sensível que, se exposta, pode equivaler a perda de receitas ou a perda de privacidade.
Ao implementar um esquema de autenticação HTTP, pense na Basic Authentication como um código de entrada que permite a entrada autorizada num edifício ou escritório apenas quando o pessoal de segurança está presente. Fora do horário de expediente, as mesmas portas são trancadas com um mecanismo mais seguro para proteger o edifício.
- o controlo de acesso é o acesso cómodo para pessoal autorizado
- a segurança mantém a propriedade protegida de atacantes
Abaixo está uma ilustração de um pedido/resposta de Basic Authentication:
images: src /blog/wp-content/uploads/2017/12/fvNIZLj-e1513109471712.jpg and /blog/wp-content/uploads/2017/12/Svu1sFi-e1513109482792.jpg (unchanged); alts: Basic Authentication 1, Basic Authentication 2
- O user agent faz um pedido de um documento
- O web server responde com o código HTTP 401: Authorization Required
- O user agent repete o pedido com credenciais
- O web server permite ou recusa o acesso com base na validade das credenciais
Como demonstração das fraquezas da Basic Authentication, tente descobrir as credenciais a partir da string codificada em BASE64 ilustrada.
Autenticação com Bearer Token
A autenticação com Bearer Token é popular entre os fornecedores de frameworks de autenticação. A Bearer Authentication também pode ser implementada como solução autónoma, caso a caso.
A Bearer Authentication baseia-se em tokens e é usada tanto no OAuth como no OpenID. Tipicamente o OAuth é usado para autorização, enquanto o OpenID é para autenticação. No entanto, existem várias zonas cinzentas que esbatem as fronteiras entre autenticação e autorização em cada framework.
- O OpenID fornece autenticação federada ou serviços de início de sessão
- O OAuth fornece autorização delegada
O GitHub fornece um guia de OAuth para programadores de aplicações de terceiros que queiram aceder a recursos do GitHub em nome de um utilizador final. Guia de OAuth App do GitHub
Grandes fornecedores de identidade como a Google oferecem início de sessão através do OpenID Connect, a norma OpenID atual, construída sobre o OAuth 2.0.
Início de sessão com OpenID Connect com uma conta Google:
image: src /blog/wp-content/uploads/2017/12/BMtbtwA.jpg (unchanged); alt: Fornecedor de autenticação Google Open ID
Digest Authentication
A Digest Authentication é mais segura do que a Basic Authentication. No entanto, a Digest Authentication continua a ser inadequada para proteger material sensível na Internet. A Digest Authentication não encripta as credenciais, faz o hash delas, e se esses hashes forem capturados um atacante pode lançar um ataque offline de brute force ou de dicionário.
Tanto o esquema Digest como o Basic são considerados fracos no panorama geral da segurança de dados. Cada um tem falhas e cada um já foi atacado com sucesso. Quando é preciso mais do que controlo de acesso ou autorização básicos, tem de ser implementado um esquema de autenticação mais seguro.
Outros esquemas de autenticação baseados em HTTP
O NTLM, conhecido como NT Lan Manager Authentication, é uma tecnologia da Microsoft com plugins para muitos produtos, sistemas operativos e serviços de terceiros.
Em domínios Windows a escolha preferida é o Negotiate, que usa Kerberos e só recorre ao NTLM quando tem de o fazer. A Microsoft está a descontinuar gradualmente o NTLM. Com Kerberos, os utilizadores do domínio que já iniciaram sessão podem aceder a recursos autorizados sem voltar a introduzir as credenciais.
As maiores desvantagens da autenticação baseada em NTLM são:
- pode ser incómoda de implementar em plataformas que não sejam Windows
- pode perder muitas funcionalidades de segurança se for implementada fora de um domínio Windows
- o NTLM é apenas tão seguro quanto a rede empresarial
- as versões mais antigas do NTLM são consideradas inseguras
SCRAM-SHA1 e SCRAM-SHA256
SCRAM é o acrónimo de Salted Challenge Response Authentication Mechanism
Quando é preciso autenticar colaboradores internos, a autenticação SCRAM em conjunto com OpenLDAP pode ser uma boa solução para ambientes com equipamento de vários fabricantes.
O SCRAM pode ser mais sofisticado de implementar do que o NTLM num domínio Windows. Mas o SCRAM pode ser uma excelente escolha numa rede com clientes Linux, MacOS Server, Windows e Unix, e até através da Internet.
Artigo relacionado: Guia completo dos códigos de estado HTTP: série 300
Do arquivo do blog da EuroVPS, publicado pela primeira vez em 12 de dezembro de 2017.
Todas as notas de campo