

Qu'est-ce donc que le Hypertext Transfer Protocol (HTTP) ?
HTTP, de la première ligne de requête jusqu'à HTTP/2 : méthodes, en-têtes, codes d'état, keep-alive et ce que chacun signifie pour un serveur que vous exploitez.
La création du World Wide Web s'est affinée au cours des années 1988 à 1991 environ.
À l'origine, les mécanismes de HTTP ont été conçus pour permettre à des scientifiques du monde entier de partager une plateforme de recherche et de collaboration. Il s'est avéré que le World Wide Web a mis des outils de publication, d'apprentissage et de collaboration à la portée de quiconque dispose d'une connexion Internet.
(hr)
Les composants d'origine de l'invention de Tim Berners-Lee sont toujours en usage aujourd'hui. De fait, certains serveurs web modernes comprennent encore la spécification HTTP d'origine (bien qu'elle soit considérée comme obsolète aujourd'hui) :
Composants de base du World Wide Web :
- un serveur web
- un user agent
- un affichage textuel
- des types de médias (Media Types)
- un protocole permettant le transfert de documents, HTTP
| Le W.W.W. d'aujourd'hui | |
|---|---|
| web server | IIS, Apache, NGiNX |
| user agent | CuRL, Chrome, Firefox, RSS Readers |
| données textuelles | UTF-8, ASCII, JSON, HTML, XML, CSS |
| types de médias | données textuelles, images, vidéo, animations |
| spécifications HTTP | HTTP/1.1 (RFC 9112), HTTP/2 (RFC 9113) et HTTP/3 (RFC 9114), avec une sémantique commune dans la RFC 9110 |
Deux entités principales sont chargées de définir l'évolution du HTTP moderne :
- W3C World Wide Web Consortium Le W3C s'occupe du fonctionnement des serveurs web, des besoins futurs en spécifications, des user agents (ou navigateurs web), de HTML, de XML, de la vidéo, des images et des technologies de diffusion de contenu. Pour l'essentiel, le W3C s'occupe des effets de HTTP sur la couche application.
- IETF Internet Engineering Task Force L'IETF s'occupe de la façon dont HTTP fonctionnera à un niveau technique plus bas. HTTP s'appuie sur des technologies sous-jacentes comme IPv4, TCP, UDP, Ethernet et bien d'autres protocoles de couches inférieures. Tous les protocoles inférieurs travaillent ensemble pour acheminer les données du user agent au serveur web, et retour au user agent.
Tirées de leurs sites respectifs, le W3C et l'IETF se décrivent avec leurs propres mots :
- Le World Wide Web Consortium (W3C) est une communauté internationale où des organisations membres, une équipe à plein temps et le public travaillent ensemble à développer les standards du Web. (https://www.w3.org/Consortium/)
- L'objectif de l'IETF est de faire mieux fonctionner Internet. La mission de l'IETF est de faire mieux fonctionner Internet en produisant des documents techniques pertinents et de haute qualité qui influencent la façon dont les gens conçoivent, utilisent et gèrent Internet. (https://www.ietf.org)
Comment des standards comme HTTP sont-ils définis ? (h2, anchor section01)
Quand un protocole Internet comme HTTP est adopté ou révisé, les standards sont définis dans des documents appelés RFC.
RFC signifie Request For Comments.
Chaque protocole de communication de données reconnu, accepté pour un usage général sur Internet, est défini dans une série de documents RFC. Des technologies comme HTTP, IPv4, TLS, PKI, SNMP, POP3 et même Ethernet ne sont pas des technologies appartenant à Microsoft, Apple ou Google.
Les standards définis dans une RFC sont destinés à être adoptés comme moyen de communication entre les plateformes de plusieurs constructeurs. Chaque technologie (dans son cœur) documentée dans une RFC peut être implémentée, affinée pour l'usage, et même ajoutée à des produits par toute personne ou tout constructeur, sans redevances ni brevets.
Une RFC est en général un document plutôt sec, disponible en texte ASCII, fidèle à la tradition d'être lisible sur toute plateforme. Une RFC suppose aussi que le lecteur maîtrise les concepts techniques.
- Les spécifications HTTP en vigueur : RFC 9110 HTTP Semantics, RFC 9112 HTTP/1.1, RFC 9113 HTTP/2 et RFC 9114 HTTP/3
(hr)
HTTP est l'acronyme de Hyper Text Transfer Protocol. HTTP est un protocole de couche application sans état conçu pour la communication d'échanges d'informations entre systèmes à travers Internet. À ce titre, HTTP définit un ensemble de règles permettant à la fois le transfert et l'accès à des documents distants. HTTP a aussi servi à transférer des informations d'autres manières, comme SSDP, qui utilise UDP et l'adressage multicast (adopté sous le nom HTTPU) pour des transferts d'informations.
Ce que HTTP n'est PAS
HTTP et le World Wide Web ne sont pas Internet. HTTP est un protocole qui fait fonctionner une portion extrêmement populaire d'Internet, connue sous le nom de World Wide Web.
HTTP opère au-dessus des protocoles de communication réseau sous-jacents du modèle TCP/IP. TCP/IP est un mécanisme de transfert de données, de tramage de l'information et de données de couche application à travers Internet. HTTP est un standard de niveau application spécialisé dans le transfert d'un certain type de données. HTTP/1.1 et HTTP/2 fonctionnent sur TCP, tandis que HTTP/3 fonctionne sur QUIC, lui-même bâti sur UDP.
TCP/IP est une suite de protocoles de communication de données développée par le Department of Defense des États-Unis. TCP/IP est parfois appelé « le modèle réseau du DoD ».
Dans ses premières années, Internet et TCP/IP ont été cédés par les laboratoires de la DARPA au monde universitaire. Après avoir été affiné pour l'usage universitaire, Internet a été adopté par les consommateurs et les entreprises pour devenir ce que nous connaissons aujourd'hui comme Internet. C'est pendant la période de transition de l'université vers les premiers usages publics que HTTP et le World Wide Web ont été introduits.
| TCP/IP | Protocoles de la couche |
|---|---|
| Couche application | HTTP : World Wide Web · FTP : protocole de transfert de fichiers · POP3 et IMAP : courrier entrant · SMTP : courrier sortant · HTML : balisage pour l'affichage des pages web · JPEG : format graphique pour l'affichage des images |
| Couche transport | TCP : communication en mode connecté entre hôtes · UDP : communication en mode non connecté entre hôtes (QUIC, utilisé par HTTP/3, fonctionne par-dessus) |
| Couche Internet | IPv4 : adressage pour les réseaux distants · IPv6 : adressage pour les réseaux distants · BGP : routage du trafic entre fournisseurs Internet · OSPF : routage du trafic sur les réseaux internes · ICMP : structure pour relayer les diagnostics |
| Couche liaison | Ethernet support physique et signalisation pour le transfert de données de bas niveau · Token Ring concurrent d'Ethernet que l'on ne rencontre plus guère · 802.11 spécifications pour les communications sans fil · Bluetooth spécification pour la connexion sans fil d'appareils · Frame Relay spécifications physiques et de données pour les réseaux étendus |
Le tableau ci-dessus est une représentation de la place de HTTP dans Internet et dans TCP/IP.
(hr)
Spécifications de HTTP (h2, anchor section02)
Avant tout, HTTP sert à communiquer des transferts de documents entre un user agent et un serveur web.
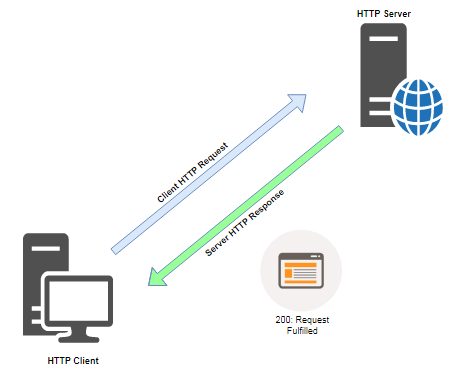
Les échanges HTTP consistent en général en un user agent qui demande une série de documents à un serveur web. Quand une requête HTTP est reçue par le serveur web, celui-ci l'analyse. Enfin, le serveur web renvoie soit un document et un code d'état, soit peut refuser une requête en renvoyant un code d'état indiquant pourquoi elle a été refusée.
- Pour les détails sur les raisons pour lesquelles un serveur web peut refuser une requête client, reportez-vous à la section des codes d'état HTTP 400
Lecture associée : Guide complet des codes d'état HTTP : série 400
User-Agent est un terme pompeux pour une application qui demande des ressources HTTP à un serveur web. Le plus souvent, les user agents sont connus sous le nom de navigateurs web. Cependant, les lecteurs RSS, les bots de web scraping, les web spiders et les bibliothèques HTTP comme CURL sont aussi des user agents.
Serveur web est un daemon qui tourne communément sur le port 80 (HTTP) et le port 443 (HTTPS), dont le but précis est de récupérer des documents dans une portion désignée du système de fichiers du serveur pour les livrer à un user agent.
Les trois serveurs web à forte charge les plus courants sur Internet aujourd'hui sont Apache, Nginx (prononcé Engine-X) et IIS (de Microsoft).
Regardons une requête HTTP simple avec une application user agent appelée Fiddler.
Fiddler est un proxy de débogage HTTP pour les API et les applications web. Les outils de développement intégrés à chaque navigateur moderne montrent une grande partie des mêmes informations.
(hr)
Méthodes de requête HTTP (h2, anchor section03)
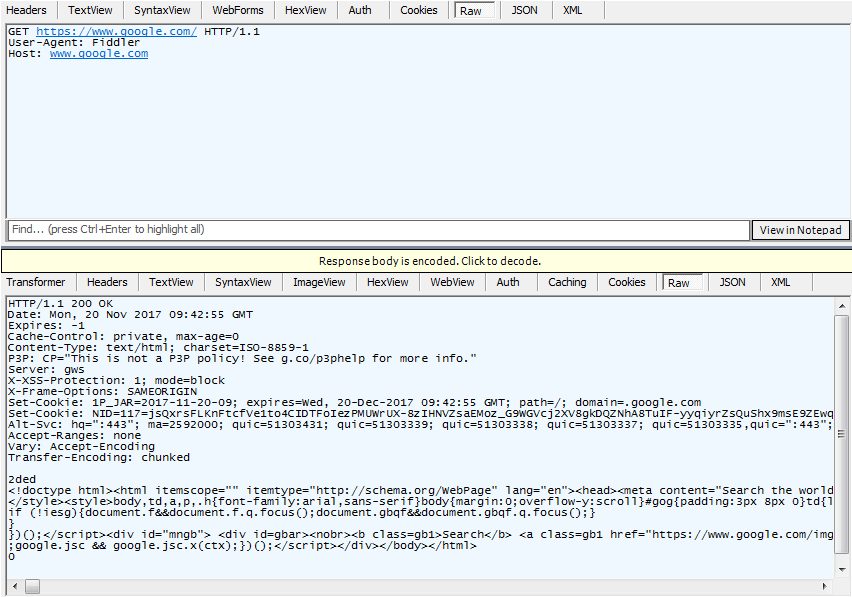
Comme le montre le premier schéma d'un échange requête/réponse HTTP, le user agent demande un document, puis un serveur web satisfait une requête HTTP valide.
Comme on le voit dans la partie supérieure de la fenêtre de Fiddler, Fiddler, le user agent, a envoyé trois lignes de données :
- GET précise le fichier et le chemin
- User-Agent identifie le logiciel client
- HOST précise l'hôte où se trouve le contenu
La méthode de requête est GET dans cette requête. Nous découvrirons d'autres méthodes de requête HTTP dans ce guide.
La chaîne User-Agent : une chaîne User-Agent est la façon dont le logiciel client web s'identifie auprès du serveur web. Les API et les sites web accordent ou refusent souvent des droits d'accès et des réglages d'affichage en fonction de la chaîne User-Agent du client.
Les crawlers bien élevés s'identifient honnêtement dans leur chaîne User-Agent et suivent les règles qu'un site publie dans son fichier robots.txt.
| Quelques exemples de chaînes User-Agent (les numéros de version changent à chaque publication) : | |
|---|---|
| Chrome sur Windows 7 | Mozilla/5.0 (Windows NT 6.1; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/62.0.3202.94 Safari/537.36 |
| Internet Explorer 11 | Mozilla/5.0 (Windows NT 6.1; WOW64; Trident/7.0; rv:11.0) like Gecko |
| Googlebot | Mozilla/5.0 (Linux; Android 6.0.1; Nexus 5X Build/MMB29P) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/41.0.2272.96 Mobile Safari/537.36 (compatible; Googlebot/2.1; +http://www.google.com/bot.html) |
| Play Station 4 | Mozilla/5.0 (PlayStation 4 4.71) AppleWebKit/601.2 (KHTML, like Gecko) |
Host
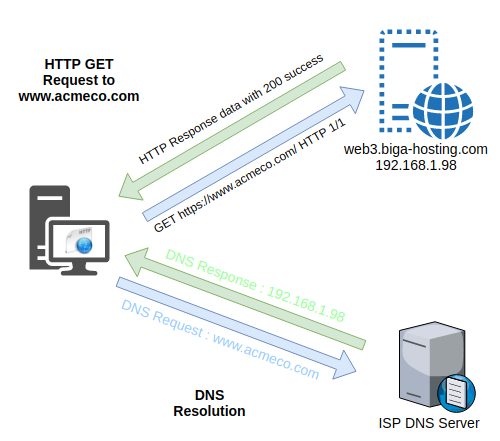
L'en-tête Host précise le serveur (et le domaine) qui détient le document demandé. Depuis HTTP/1.1, l'en-tête Host est obligatoire (HTTP/2 et HTTP/3 transportent la même information dans le champ :authority). Il est obligatoire parce que de nombreux sites web partagent un serveur et une adresse IP, une disposition appelée name-based virtual hosting, et le serveur a besoin de l'en-tête Host pour savoir à quel site une requête est destinée.
Une adresse IP d'hôte 192.168.1.98 peut avoir un nom DNS externe web3.biga-hosting.com. Ce serveur nommé web3.biga-hosting.com peut héberger des centaines de domaines. À son tour, l'en-tête Host de HTTP indiquera au serveur à quel domaine hébergé une requête est destinée. Plusieurs domaines virtuels peuvent avoir la même adresse IPv4 192.168.1.98 (le reverse DNS pointera en général vers web3.biga-hosting.com).
(hr)
Anatomie de HTTP
Cette section creusera un peu plus les mécanismes internes du protocole HTTP. Les sujets abordés pour une vue d'ensemble de HTTP comprennent :
- Les notions d'URI et d'URL
- Les verbes HTTP : GET, POST, PUT, DELETE, HEAD, TRACE, OPTIONS
- Les types de médias
- Les caractéristiques communes de HTTP : sans état, pas de chiffrement intégré, authentification HTTP
(hr)
Les notions d'URI et d'URL (h2, anchor section04)
De toutes les notions qui entourent HTTP, le décryptage des termes URI et URL est simple, et pourtant il embrouille encore les étudiants et même certains développeurs. Pour compliquer encore une notion simple, le terme URI a été affiné et documenté dans des standards qui permettent au terme URL d'être synonyme d'URI.
URI est l'acronyme de Uniform Resource Identifier. URL est l'acronyme de Uniform Resource Locator.
Définissons chacun dans les termes les plus simples possible, avec une analogie. Dans notre scénario, disons que URI correspond au terme automobile. Une URL est un type précis d'URI. Disons donc que URL correspond à une « voiture », mais pas à un camion ni à une camionnette.
Il est toutefois conseillé de toujours utiliser le terme URI si la différence a une importance quelconque.
Pour mieux comprendre la notion d'URI, disons maintenant que nous voulons localiser un livre. Mais nous ne savons pas où le livre se trouve. Nous ne pourrions pas utiliser une URL, puisqu'une URL est propre à un hôte. Nous pourrions, en revanche, utiliser un URN :
urn:isbn:0451450523Quand un URN comme celui ci-dessus est utilisé, une application web sous-jacente est chargée de la logique métier de localisation du document demandé.
Disons dans notre analogie qu'un URN est une camionnette, un autre type précis d'automobile. Un URI définit un URN et une URL. Un URN identifie une ressource précise, dans notre exemple un livre. Tandis qu'une URL identifie un emplacement et d'autres moyens d'accéder à une ressource.
Anatomie d'une URL
Une URL, autrement dit un Uniform Resource Locator, est l'URI le plus courant en usage sur le World Wide Web. C'est ce que nous saisissons dans la barre d'adresse d'un navigateur web pour aller sur https://www.google.com.
Regardons une URL plus complexe et décomposons chacune de ses parties :
http://admin:password@web5.acmeco.com:8080/admin-docs/2017/ins/infrastructure.xlsxElle est syntaxiquement valide, mais elle montre quelque chose que vous ne devez jamais faire.
La forme user:password dans une URL est dépréciée (RFC 3986), et les navigateurs modernes la retirent ou la bloquent. Des identifiants dans une URL finissent dans les logs des serveurs, l'historique du navigateur et les en-têtes Referer. Ne mettez jamais d'identifiants, hachés ou non, dans une URL.
| Identifiants dans une URL | |
|---|---|
| scheme | http:// |
| identifiants | admin:password |
| ressource/hôte | web5.acmeco.com |
| port | 8080 |
| chemin | /admin-docs/2017/ins/ |
| document | infrastructure.xlsx |
http://www.acmeco.com/ est aussi une URL valide.
La barre oblique finale indique au serveur web que nous voulons le document par défaut du webroot. Traditionnellement, ce document s'appelle index.html, mais l'administrateur du serveur peut le changer en n'importe quoi.
Une autre URL valide peut être : mailto:user@example.com. Au lieu de demander un document, cette URL ouvre le client de messagerie par défaut, prêt à écrire à cette adresse.
Quelques schémas de protocole d'URL valides sont : https://, http://, ftp://, file://, mailto:, tel:, et probablement quelques autres. http et https sont toutefois les protocoles les plus utilisés sur le World Wide Web.
Query strings
Il existe une autre façon courante de spécifier une URL, largement utilisée sur le World Wide Web. Elle s'appelle query string. Une query string est en général utilisée en association avec une application web backend ou un script CGI.
Un exemple est ajouté à notre requête GET précédente, en accédant directement à la recherche Google :
https://www.google.com/search?q=euro+vps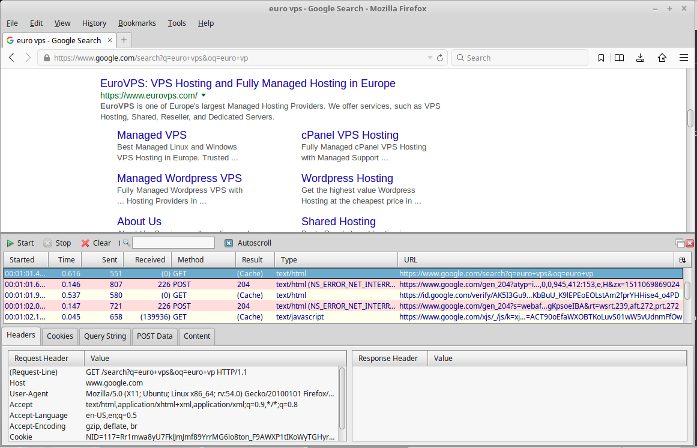
Les query strings servent en général à passer des paramètres à un script backend. La query string est encodée par le navigateur web, livrée à un serveur web, décodée par le serveur web ou l'application, puis enfin traitée par l'application web.
Les query strings sont connues pour avoir été exploitées en passant de mauvais paramètres dans des tentatives de manipulation du fonctionnement d'une application web.
https://www.acmeco.com/auth/auth.php?user=acmeuser&password=EXAMPLECi-dessus, un exemple de ce qu'il ne faut jamais faire. Les identifiants, hachés ou non, ne doivent jamais voyager dans une URL : ils finissent dans les logs HTTP, l'historique du navigateur et les en-têtes Referer. Envoyez-les dans le corps d'un POST via HTTPS, ou dans un en-tête Authorization.
(hr)
Les verbes HTTP (h2, anchor section05)
Maintenant que nous avons une bonne idée de ce qu'est une URL et de l'usage des query strings, nous allons présenter les verbes utilisés dans les requêtes HTTP. Les verbes HTTP les plus utilisés sont :
- POST et GET
- PUT
- DELETE
- HEAD
- TRACE
- OPTIONS
- CONNECT
1. POST et GET
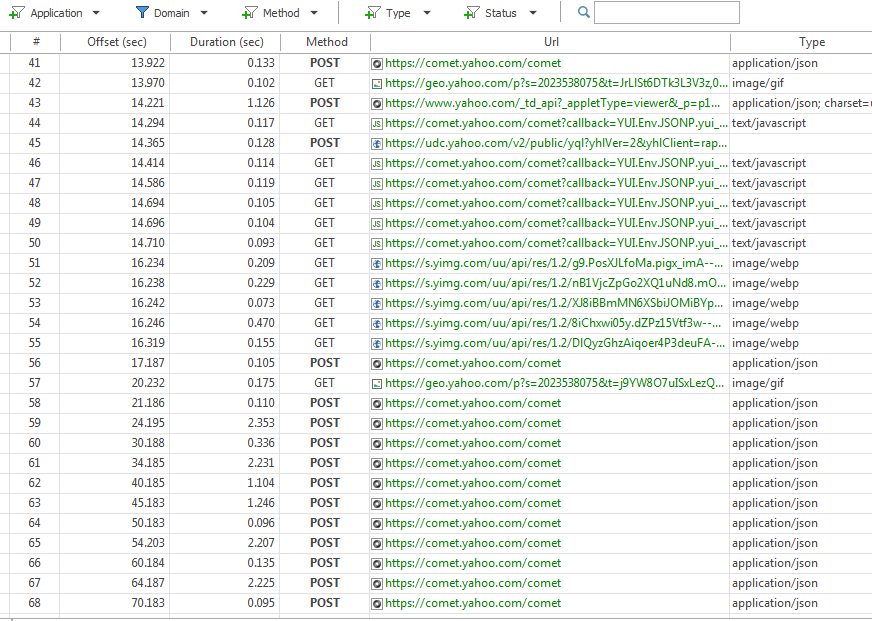
GET est la méthode par défaut quand vous saisissez un site web dans la barre d'adresse d'un navigateur ou cliquez sur un hyperlien. Quand une page web est demandée, le navigateur peut en réalité faire plusieurs requêtes GET ou POST en téléchargeant toutes les ressources qui composent une page web, comme les images, les feuilles de style, les scripts côté client, les ressources typographiques et d'autres :
Hyperlien est le terme technique pour le lien vers des pages web secondaires. Quand l'utilisateur clique sur un lien (ou hyperlien), le navigateur envoie une requête GET pour la page liée
Requêtes POST
Les deux méthodes de requête les plus utilisées sont GET et POST. Nous avons déjà décomposé une requête GET. Examinons donc une requête POST.
Et si nous voulions téléverser un fichier de 1GB via un script PHP ou asp ? Naturellement, une URL ne peut pas contenir une chaîne binaire de 1GB. Dans ce scénario, nous utiliserions la méthode POST.
POST ressemble à GET en ce que POST peut passer des paramètres comme une query string. Cependant, les données POST ne sont pas ajoutées à une URL comme avec la query string.
Au lieu de cela, les données POST voyagent dans le corps de la requête HTTP, après les en-têtes. POST est le plus souvent utilisé avec les données de formulaires HTML.
La méthode POST est communément utilisée quand les caractéristiques suivantes sont nécessaires :
- téléversements de fichiers
- garder les données sensibles hors de l'URL
- des chaînes de données plus longues doivent être envoyées
- des schémas d'encodage différents doivent être utilisés
- ne peut pas être mise en cache (si la sécurité est un sujet)
Comparons avec quelques avantages de la méthode GET avec une query string ajoutée à l'URL
- peut être enregistrée comme favori
- peut être mise en cache
- les résultats d'une recherche peuvent être partagés par un lien
2. PUT
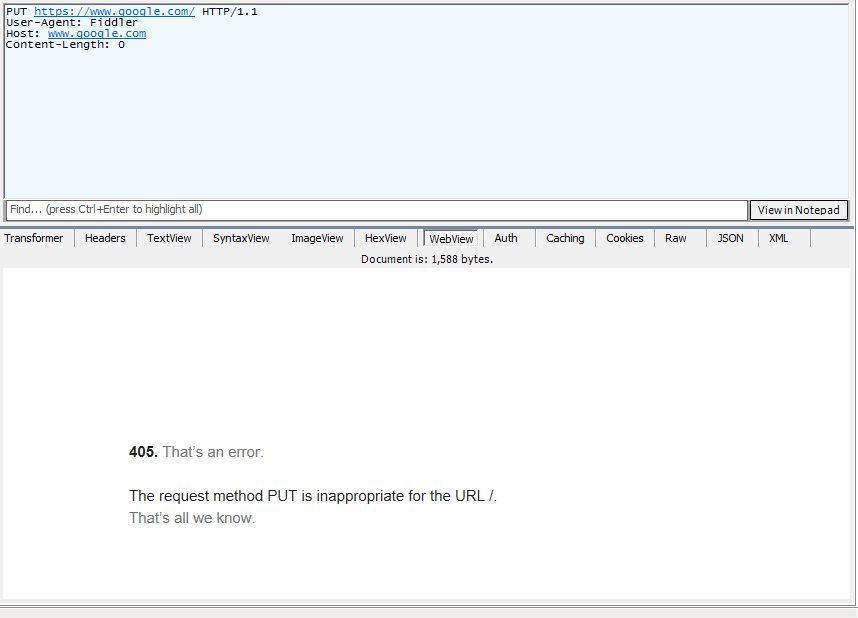
La méthode PUT est le plus souvent utilisée dans les API web RESTful. PUT crée ou remplace la ressource à l'URI donnée dans la requête, tandis que POST demande au serveur de traiter les données, en créant souvent une nouvelle ressource à une URI que le serveur choisit.
PUT est en général désactivé par défaut dans les installations de serveurs web.
Laisser PUT activé pourrait permettre à des attaquants de téléverser et d'exécuter des fichiers sur le serveur web.
3. DELETE
Comme PUT, la méthode DELETE est le plus souvent utilisée dans les API RESTful. L'usage de DELETE devrait exécuter une action de suppression sur un objet URI :
DELETE http://acmeco.com/customers/{customer-id}
DELETE est désactivé par défaut dans la plupart des installations de serveurs web. Activer DELETE quand il n'est pas nécessaire pourrait être un risque de sécurité, permettant à des attaquants de supprimer des documents d'un site web.
4. HEAD
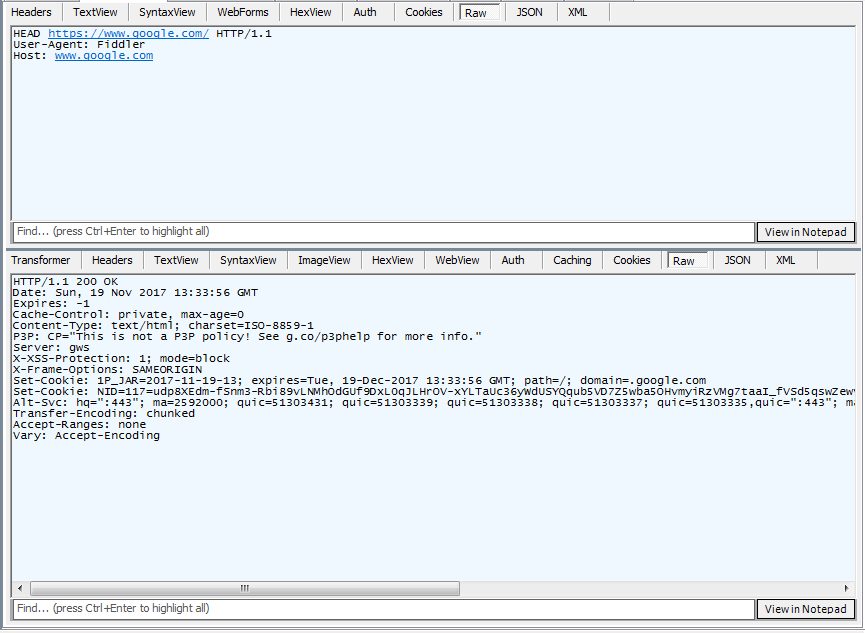
La méthode HEAD ressemble à GET mais ne renvoie que les en-têtes, sans contenu. HEAD sert communément à vérifier si un document en cache a été mis à jour. Si le document est plus récent que la version en cache, le document entier sera téléchargé et mis en cache.
5. TRACE
TRACE est une méthode de diagnostic et sera en général désactivée sur la plupart des serveurs web. De nombreux chercheurs en sécurité ont découvert des vulnérabilités potentielles liées aux méthodes TRACE. Le risque l'emporte de loin sur l'utilité de TRACE la plupart du temps.
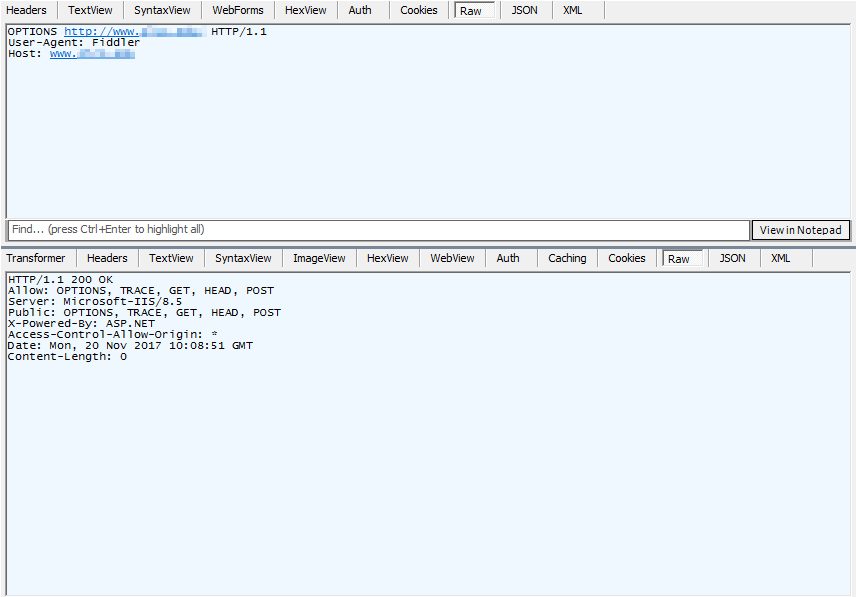
6. OPTIONS
OPTIONS demande au serveur quelles méthodes et quelles fonctionnalités il prend en charge pour une ressource. Ne le désactivez pas : les navigateurs envoient une requête OPTIONS en preflight CORS avant de nombreux appels d'API entre origines différentes, et le bloquer casse ces applications. Autorisez plutôt uniquement les méthodes dont votre application a réellement besoin, et désactivez TRACE.
7. CONNECT
CONNECT est utilisé par les proxies et ne devrait pas être activé sur un serveur web ordinaire. Quand il est activé et mal configuré, CONNECT peut permettre des connexions qui relaient des requêtes vers d'autres serveurs. Ces connexions relayées peuvent servir à des attaques ou au téléchargement de fichiers illégaux.
Par défaut, la plupart des logiciels de serveur web ont CONNECT désactivé.
L'usage légitime de CONNECT est de tunneliser des connexions HTTPS et d'autres connexions TLS à travers un forward proxy.
(hr)
Les types de médias (h2, anchor section06)
Un type de média (Media Type) définit les fichiers d'après leur nature et leur format pour l'affichage ou le traitement. L'en-tête Content-Type est utilisé dans une réponse HTTP pour permettre à un navigateur web d'afficher le texte de la réponse, de charger un plugin pour un type de fichier pris en charge, ou simplement de télécharger un fichier pour l'ouvrir dans une autre application.
À l'origine, le Media Type a été implémenté pour les pièces jointes des e-mails et baptisé MIME Types. MIME signifie Multipurpose Internet Mail Extension.
Certains Media Types peuvent être préfixés par « x- » ou « vnd ». Le « x » signifie qu'un Media Type n'est pas officiellement enregistré par l'IANA (Internet Assigned Numbers Authority). La partie « vnd » signifie qu'un Media Type est propre à un éditeur (par exemple application/vnd.ms-excel).
Voir les Media Types dans Firefox
- saisissez « about:config » dans la barre d'adresse.
- dans le champ de recherche des préférences, saisissez « mime »
image: src /blog/wp-content/uploads/2017/12/rNTzwB7-e1513109426632.jpg (unchanged); alt: Configuration des MIME Types de Firefox sous Linux
Sur une plateforme Linux, nous voyons que Firefox utilise le fichier /etc/mime.types
Regardons une portion du fichier /etc/mime.types :
$ head -n 40 /etc/mime.types | grep -v "^#" application/activemessage application/andrew-inset ez application/annodex anx application/applefile application/atom+xml atom application/atomcat+xml atomcat application/atomicmail application/atomserv+xml atomsrv application/batch-SMTP application/bbolin lin application/beep+xml application/cals-1840 application/commonground application/cu-seeme cu application/cybercash $ wc -l /etc/mime.types 835 /etc/mime.typesComme on le voit, plus de 800 mime types précis sont reconnus par ce système. En substance, cela renseigne Firefox sur les extensions associées à certains types de fichiers.
NOTE : les Media Types sont différents des « applications par défaut » du système d'exploitation. Bien que proches dans le concept, les mime types servent aux applications connectées à Internet, tandis qu'un système d'exploitation tient un registre séparé des types de fichiers et des visionneuses associées.
Quand une requête GET est faite pour une feuille Excel, l'en-tête Content-Type renvoie application/vnd.ms-excel. Le navigateur web sait ainsi que le fichier ne doit pas être affiché comme du texte dans la fenêtre du navigateur. Le fichier est au contraire soit chargé dans un plugin de visualisation, soit téléchargé pour être ouvert plus tard dans une autre application.
Un serveur web Unix ou Linux utilise lui aussi /etc/mime.types pour l'en-tête Content-Type. De plus, un handler doit être défini pour un langage de script comme php, afin que les fichiers PHP soient exécutés plutôt qu'envoyés au navigateur comme du texte. Sur RHEL, le fichier /etc/httpd/conf.d/php.conf d'Apache les confie à PHP-FPM :
<FilesMatch \.(php|phar)$> SetHandler "proxy:unix:/run/php-fpm/www.sock|fcgi://localhost" </FilesMatch>Ci-dessus : les fichiers se terminant par .php (et .phar) sont transmis au service PHP-FPM par son socket, au lieu d'être servis comme des fichiers ordinaires.
Si vous avez déjà cliqué sur un lien et que votre navigateur a affiché un graphique ou d'autres données binaires en ASCII, ou vous a proposé de télécharger une page web, cela signifie que les mime types du navigateur ou du serveur étaient mal configurés.
Pour diagnostiquer, regardez l'en-tête Content-Type dans les outils de développement de votre navigateur (onglet Network) :
image: src /blog/wp-content/uploads/2017/12/FTSurmm-e1513109444640.jpg (unchanged); alt: En-tête Content-Type dans HTTPFox
Nous voyons que le bon content-type a été précisé dans une réponse du serveur. Si le navigateur proposait d'enregistrer l'image demandée par la requête GET, nous saurions que le mime type du navigateur pour image/jpeg doit être reconfiguré.
Des configurations incorrectes du scripting côté serveur ou des mime types binaires peuvent conduire à des problèmes de sécurité sur le serveur ou le client.
L'IANA (Internet Assigned Numbers Authority) est chargée de tenir une correspondance officielle des media types via le processus RFC.
(hr)
Les caractéristiques de HTTP
Dans cette section, nous aborderons des caractéristiques du protocole HTTP. Les notions les plus importantes à connaître quand on travaille avec HTTP sont :
- HTTP est sans état
- HTTP n'offre pas de chiffrement intégré
Qu'est-ce qu'un protocole sans état ?
HTTP est sans état par conception : chaque requête transporte tout ce dont le serveur a besoin pour y répondre. HTTP n'est pourtant pas sans connexion. HTTP/1.1 et HTTP/2 gardent des connexions TCP ouvertes et les réutilisent pour de nombreuses requêtes, et HTTP/3 fait de même sur QUIC.
Sans état signifie simplement que les transactions HTTP sont demandées par un user agent, puis que le serveur web y répond. Si un client ne met pas en cache les ressources demandées, il doit émettre à nouveau la même méthode pour obtenir de nouveau la ressource. Un serveur web HTTP n'a pas de table d'état où rechercher les communications précédentes avec un user agent.
Cookies HTTP : les cookies peuvent aider un serveur web à se référer à des interactions HTTP passées avec un user agent. Le protocole lui-même reste sans état : chaque requête se tient seule, même quand elle voyage sur une connexion réutilisée.
La plupart des langages de programmation backend, comme le framework Django de Python, PHP et ASP .Net, offrent des bibliothèques pour maintenir l'état de l'application avec des frameworks de sessions intégrés. Cette approche ajoute bien de l'état à une application web, mais elle est abstraite à un niveau supérieur à HTTP.
HTTP ne fournit pas de chiffrement
HTTP lui-même ne fournit pas de mécanismes de chiffrement intégrés. Le chiffrement est laissé à d'autres protocoles qui définissent HTTPS. HTTPS utilise Transport Layer Security, ou TLS, le successeur de SSL.
TLS fonctionne avec de nombreux protocoles, pas seulement HTTP. HTTPS est conçu pour transporter des données de contenu HTTP et des en-têtes HTTP sur des connexions TLS sécurisées. SSL a été développé à l'origine dans les années 1990 par Netscape. L'IETF a plus tard standardisé son successeur sous le nom de TLS. Toutes les versions de SSL sont désormais obsolètes. TLS 1.2 et TLS 1.3 sont les versions en vigueur.
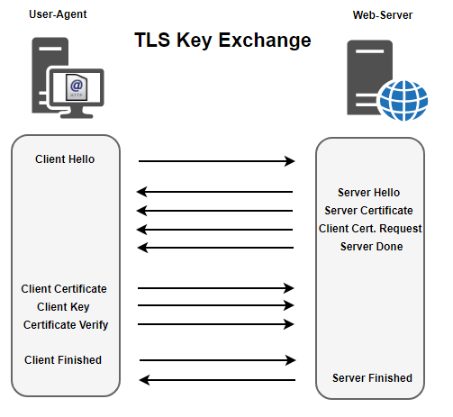
Le lecteur attentif pourrait se demander : « Alors HTTPS est avec état ? N'est-ce pas ? Chaque session a bien une clé ? N'est-ce pas ? ». Les clés sont mises en cache par le client, oui. Mais TLS fonctionne toujours à une couche inférieure au cœur HTTP de HTTPS. Les interactions avec le serveur web utilisent toujours les mêmes méthodes HTTP : GET, POST, PUT et DELETE.
(hr)
Authentification HTTP (h2, anchor section07)
L'authentification, contrairement au chiffrement, est intégrée à HTTP. HTTP prend en charge plusieurs types d'authentification, parmi lesquels :
- Basic
- Bearer
- Digest
- HOBA
- Mutual
- Negotiate
- OAuth
- SCRAM-SHA1
- SCRAM-SHA256
- vapid
Basic Authentication
La méthode d'authentification HTTP de loin la plus courante est la Basic Authentication. La Basic Authentication est courante parce qu'elle est simple à implémenter, pas parce qu'elle est sûre. D'autres schémas d'authentification sont plus sûrs, et la Basic Authentication ne doit jamais être utilisée autrement que sur HTTPS.
Le plus grand problème de sécurité de la Basic Authentication est que les identifiants sont envoyés en clair. Bien que les identifiants soient encodés en Base-64, l'encodage n'est pas du chiffrement, c'est au mieux de l'obscurcissement. Les identifiants peuvent facilement être compromis quand TLS n'est pas utilisé ou quand le trafic TLS est victime d'une attaque man-in-the-middle.
Faiblesses de la Basic Authentication :
- n'encode les identifiants qu'en BASE 64
- les identifiants sont mis en cache dans le navigateur, ce qui laisse un autre vecteur d'attaque
- les identifiants peuvent être stockés de façon permanente dans le navigateur
- des serveurs proxy malveillants peuvent potentiellement journaliser les identifiants
- les identifiants se trouvent dans l'en-tête HTTP
La BASIC Authentication a tout de même son utilité. Il est cependant important d'en reconnaître les limites. La Basic Authentication n'est bonne que pour le contrôle d'accès. Le contrôle d'accès vise simplement à contrôler l'accès à des ressources. La Basic Authentication n'est pas bonne pour la sécurisation des données. En particulier des informations sensibles dont l'exposition pourrait se traduire par une perte de revenus ou une perte de confidentialité.
Quand vous implémentez un schéma d'authentification HTTP, pensez à la Basic Authentication comme à un code d'entrée qui autorise l'accès à un bâtiment ou à un bureau uniquement quand le personnel de sécurité est présent. Après les heures de bureau, les mêmes portes sont verrouillées par un mécanisme plus sûr pour sécuriser le bâtiment.
- le contrôle d'accès est l'accès commode pour le personnel autorisé
- la sécurité garde les biens à l'abri des attaquants
Ci-dessous, une illustration d'une requête/réponse Basic Authentication :
images: src /blog/wp-content/uploads/2017/12/fvNIZLj-e1513109471712.jpg and /blog/wp-content/uploads/2017/12/Svu1sFi-e1513109482792.jpg (unchanged); alts: Basic Authentication 1, Basic Authentication 2
- Le user agent fait une requête pour un document
- Le serveur web répond avec le code HTTP 401 : Authorization Required
- Le user agent répète la requête avec des identifiants
- Le serveur web autorise ou refuse l'accès selon la validité des identifiants
Pour illustrer les faiblesses de la Basic Authentication, essayez de retrouver les identifiants à partir de la chaîne encodée en BASE64 représentée.
Authentification par Bearer Token
L'authentification par Bearer Token est populaire parmi les fournisseurs de frameworks d'authentification. La Bearer Authentication peut aussi être déployée comme solution autonome, au cas par cas.
La Bearer Authentication repose sur des tokens et est utilisée dans les frameworks OAuth et OpenID. Typiquement, OAuth sert à l'autorisation tandis qu'OpenID sert à l'authentification. Il existe cependant plusieurs zones grises qui brouillent les frontières entre authentification et autorisation dans chaque framework.
- OpenID fournit des services d'authentification fédérée ou de connexion
- OAuth fournit une autorisation déléguée
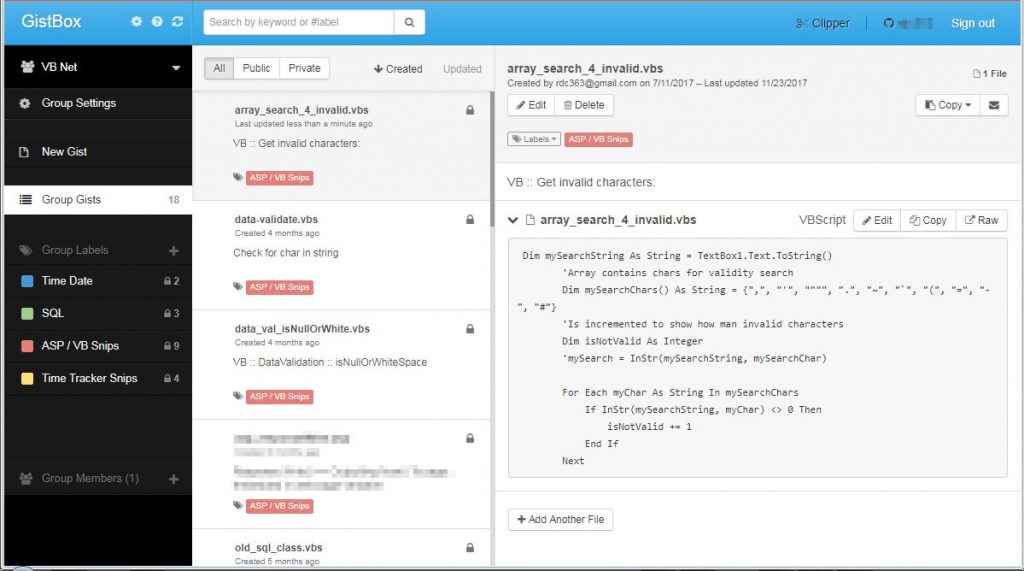
GitHub fournit un guide OAuth pour les développeurs d'applications tierces souhaitant accéder aux ressources GitHub au nom d'un utilisateur final. Guide OAuth App de GitHub
Les grands fournisseurs d'identité comme Google proposent la connexion via OpenID Connect, le standard OpenID en vigueur, bâti sur OAuth 2.0.
Connexion avec OpenID Connect avec un compte Google :
image: src /blog/wp-content/uploads/2017/12/BMtbtwA.jpg (unchanged); alt: Fournisseur d'authentification Google Open ID
Digest Authentication
La Digest Authentication est plus sûre que la Basic Authentication. Cependant, la Digest Authentication reste insuffisante pour sécuriser du contenu sensible sur Internet. La Digest Authentication ne chiffre pas les identifiants, elle les hache, et si ces hachés sont capturés, un attaquant peut lancer une attaque hors ligne par force brute ou par dictionnaire.
Les schémas Digest et Basic sont tous deux considérés comme faibles dans le grand tableau de la sécurité des données. Chacun a des défauts et chacun a été attaqué avec succès. Quand il faut plus qu'un contrôle d'accès ou une autorisation de base, un schéma d'authentification plus sûr doit être déployé.
Autres schémas d'authentification basés sur HTTP
NTLM, connu sous le nom de NT Lan Manager Authentication, est une technologie de Microsoft avec des plugins pour de nombreux produits, systèmes d'exploitation et services tiers.
Dans les domaines Windows, le choix préféré est Negotiate, qui utilise Kerberos et ne se rabat sur NTLM que lorsqu'il le faut. Microsoft retire progressivement NTLM. Avec Kerberos, les utilisateurs du domaine déjà connectés peuvent accéder aux ressources autorisées sans ressaisir leurs identifiants.
Les plus gros inconvénients de l'authentification NTLM sont :
- elle peut être lourde à implémenter sur des plateformes autres que Windows
- elle peut perdre beaucoup de fonctions de sécurité si elle est déployée hors d'un domaine Windows
- NTLM n'est sûr que dans la mesure où le réseau d'entreprise l'est
- les anciennes versions de NTLM sont considérées comme non sûres
SCRAM-SHA1 et SCRAM-SHA256
SCRAM est l'acronyme de Salted Challenge Response Authentication Mechanism
Quand il faut authentifier des employés internes, l'authentification SCRAM associée à OpenLDAP peut être une bonne solution pour les environnements multi-constructeurs.
SCRAM peut être plus sophistiqué à déployer que NTLM pour un domaine Windows. Mais SCRAM peut être un excellent choix sur un réseau avec des clients Linux, MacOS Server, Windows et Unix, et même à travers Internet.
Lecture associée : Guide complet des codes d'état HTTP : série 300
Extrait des archives du blog EuroVPS, publié pour la première fois le 12 décembre 2017.
Toutes les notes de terrain