

Was ist eigentlich das Hypertext Transfer Protocol (HTTP)?
HTTP von der ersten Anfragezeile bis HTTP/2: Methoden, Header, Statuscodes, Keep-Alive und was jedes davon für einen Server bedeutet, den Sie betreiben.
Die Entstehung des World Wide Web wurde in den Jahren von etwa 1988 bis 1991 ausgearbeitet.
Ursprünglich wurden die Mechanismen von HTTP entworfen, damit Wissenschaftler aus aller Welt eine gemeinsame Plattform für Forschung und Zusammenarbeit nutzen konnten. Wie sich herausstellte, hat das World Wide Web Werkzeuge zum Veröffentlichen, Lernen und Zusammenarbeiten in die Hände jedes Menschen mit einem Internetanschluss gelegt.
(hr)
Die ursprünglichen Bausteine hinter der Erfindung von Tim Berners-Lee sind bis heute in Gebrauch. Tatsächlich verstehen manche modernen Webserver noch immer die ursprüngliche HTTP-Spezifikation (auch wenn sie heute als überholt gilt):
Grundbausteine des World Wide Web:
- ein Webserver
- ein User Agent
- Textdarstellung
- Medientypen (Media Types)
- ein Protokoll, das die Übertragung von Dokumenten erlaubt: HTTP
| Das W.W.W. von heute | |
|---|---|
| Webserver | IIS, Apache, NGiNX |
| User Agent | CuRL, Chrome, Firefox, RSS-Reader |
| Textdaten | UTF-8, ASCII, JSON, HTML, XML, CSS |
| Medientypen | Textdaten, Bilder, Video, Animationen |
| HTTP-Spezifikationen | HTTP/1.1 (RFC 9112), HTTP/2 (RFC 9113) und HTTP/3 (RFC 9114), mit gemeinsamer Semantik in RFC 9110 |
Zwei Gremien sind in erster Linie damit betraut, die Weiterentwicklung des modernen HTTP zu definieren:
- W3C World Wide Web Consortium Das W3C befasst sich mit der Funktionalität von Webservern, künftigen Anforderungen an Spezifikationen, User Agents (oder Webbrowsern), HTML, XML, Video, Bildern und Technologien zur Auslieferung von Inhalten. Mehr oder weniger befasst sich das W3C mit den Auswirkungen von HTTP auf der Anwendungsschicht.
- IETF Internet Engineering Task Force Die IETF befasst sich damit, wie HTTP auf einer tieferen technischen Ebene arbeitet und funktioniert. HTTP arbeitet auf darunterliegenden Technologien wie IPv4, TCP, UDP, Ethernet und vielen weiteren Protokollen der unteren Schichten. Alle unteren Protokolle arbeiten zusammen, um Daten vom User Agent zum Webserver und zurück zum User Agent zu bringen.
Von der jeweiligen Website übernommen, beschreiben sich W3C und IETF mit ihren eigenen Worten:
- Das World Wide Web Consortium (W3C) ist eine internationale Gemeinschaft, in der Mitgliedsorganisationen, hauptamtliche Mitarbeiter und die Öffentlichkeit gemeinsam Webstandards entwickeln. (https://www.w3.org/Consortium/)
- Das Ziel der IETF ist es, das Internet besser funktionieren zu lassen. Die Aufgabe der IETF ist es, das Internet besser funktionieren zu lassen, indem sie hochwertige, relevante technische Dokumente erstellt, die beeinflussen, wie Menschen das Internet entwerfen, nutzen und verwalten. (https://www.ietf.org)
Wie werden Standards wie HTTP definiert? (h2, anchor section01)
Wenn ein Internetprotokoll wie HTTP eingeführt oder überarbeitet wird, werden die Standards in Dokumenten definiert, die RFC heißen.
RFC steht für Request For Comments.
Jedes anerkannte Datenkommunikationsprotokoll, das für die allgemeine Nutzung im Internet akzeptiert wird, ist in einer Reihe von RFC-Dokumenten definiert. Technologien wie HTTP, IPv4, TLS, PKI, SNMP, POP3 und selbst Ethernet sind keine Technologien, die Microsoft, Apple oder Google gehören.
Die in einem RFC definierten Standards sollen als Mittel übernommen werden, das die Kommunikation über die Plattformen vieler Hersteller hinweg erlaubt. Jede Technologie (in ihrem Kern), die in einem RFC dokumentiert ist, kann von jeder Person und jedem Hersteller implementiert, für den Einsatz verfeinert und sogar in Produkte aufgenommen werden, frei von Lizenzgebühren oder Patenten.
Ein RFC ist in der Regel ein eher trockenes Dokument, das als ASCII-Text vorliegt, der Tradition folgend, auf jeder Plattform lesbar zu sein. Ein RFC setzt außerdem voraus, dass der Leser mit technischen Konzepten vertraut ist.
- Die aktuellen HTTP-Spezifikationen: RFC 9110 HTTP Semantics, RFC 9112 HTTP/1.1, RFC 9113 HTTP/2 und RFC 9114 HTTP/3
(hr)
HTTP ist die Abkürzung für Hyper Text Transfer Protocol. HTTP ist ein zustandsloses (stateless) Protokoll der Anwendungsschicht, entworfen für den Austausch von Informationen zwischen Systemen über das Internet. Als solches definiert HTTP einen Satz von Regeln, die sowohl die Übertragung von als auch den Zugriff auf entfernte Dokumente erlauben. HTTP wurde auch für die Übertragung von Informationen auf anderen Wegen genutzt, etwa in SSDP, das UDP und Multicast-Adressierung (als HTTPU übernommen) für Informationsübertragungen verwendet.
Was HTTP NICHT ist
HTTP und das World Wide Web sind nicht das Internet. HTTP ist ein Protokoll, das einen außerordentlich populären Teil des Internets antreibt, bekannt als das World Wide Web.
HTTP arbeitet oberhalb der darunterliegenden Netzwerkkommunikationsprotokolle im TCP/IP-Modell. TCP/IP ist ein Mechanismus für die Übertragung von Daten, die Rahmung von Informationen und Daten der Anwendungsschicht über das Internet. HTTP ist ein Standard der Anwendungsebene, der auf die Übertragung einer bestimmten Art von Daten spezialisiert ist. HTTP/1.1 und HTTP/2 laufen über TCP, während HTTP/3 über QUIC läuft, das auf UDP aufbaut.
TCP/IP ist eine Suite von Datenkommunikationsprotokollen, die vom Verteidigungsministerium der USA entwickelt wurde. TCP/IP wird gelegentlich als «das Netzwerkmodell des DoD» bezeichnet.
In seinen frühen Jahren wurden das Internet und TCP/IP von den DARPA-Laboren an die Wissenschaft übergeben. Nachdem es für den akademischen Gebrauch ausgereift war, wurde das Internet von Verbrauchern und Unternehmen übernommen und wurde zu dem, was wir heute als Internet kennen. In der Übergangszeit von der akademischen zur frühen öffentlichen Nutzung wurden HTTP und das World Wide Web eingeführt.
| TCP/IP | Protokolle der Schicht |
|---|---|
| Anwendungsschicht | HTTP: World Wide Web · FTP: Dateiübertragungsprotokoll · POP3 und IMAP: eingehende E-Mail · SMTP: ausgehende E-Mail · HTML: Auszeichnung für die Darstellung von Webseiten · JPEG: Grafikformat für die Darstellung von Bildern |
| Transportschicht | TCP: verbindungsorientierte Kommunikation zwischen Hosts · UDP: verbindungslose Kommunikation zwischen Hosts (QUIC, das HTTP/3 verwendet, läuft darauf) |
| Internetschicht | IPv4: Adressierung für entfernte Netzwerke · IPv6: Adressierung für entfernte Netzwerke · BGP: Routing des Datenverkehrs zwischen Internetanbietern · OSPF: Routing des Datenverkehrs in internen Netzwerken · ICMP: Struktur für die Übermittlung von Diagnosen |
| Sicherungsschicht | Ethernet physisches Medium und Signalisierung für die Datenübertragung auf unterer Ebene · Token Ring Konkurrent von Ethernet, heute kaum noch anzutreffen · 802.11 Spezifikationen für drahtlose Kommunikation · Bluetooth Spezifikation für die drahtlose Verbindung von Geräten · Frame Relay physische und Datenspezifikationen für Weitverkehrsnetze |
Die obige Tabelle ist eine Darstellung davon, wie sich HTTP in das Internet und in TCP/IP einfügt.
(hr)
Spezifikationen für HTTP (h2, anchor section02)
In erster Linie dient HTTP der Übertragung von Dokumenten zwischen einem User Agent und einem Webserver.
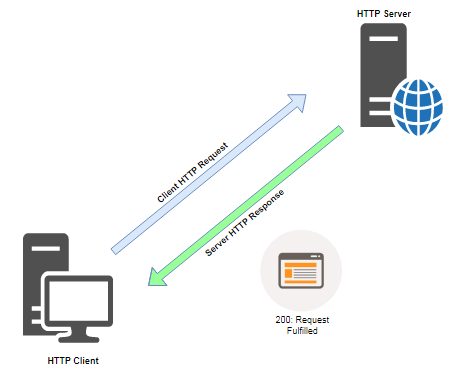
HTTP-Austausche bestehen üblicherweise darin, dass der User Agent eine Reihe von Dokumenten von einem Webserver anfordert. Wenn der Webserver eine HTTP-Anfrage erhält, analysiert er sie. Schließlich liefert der Webserver entweder ein Dokument und einen Statuscode zurück, oder er kann eine Anfrage ablehnen, indem er einen Statuscode zurückgibt, der den Grund der Ablehnung nennt.
- Einzelheiten dazu, warum ein Webserver eine Client-Anfrage ablehnen kann, finden Sie im Abschnitt zu den HTTP-Statuscodes 400
Verwandter Artikel: Vollständiger Leitfaden zu HTTP-Statuscodes: 400er-Serie
User-Agent ist ein hochtrabender Begriff für eine Anwendung, die HTTP-Ressourcen von einem Webserver anfordert. Am häufigsten kennt man User Agents als Webbrowser. Aber auch RSS-Reader, Web-Scraping-Bots, Web-Spider und HTTP-Bibliotheken wie CURL sind User Agents.
Webserver ist ein Daemon, der üblicherweise auf Port 80 (HTTP) und Port 443 (HTTPS) läuft und eigens dafür bestimmt ist, Dokumente aus einem festgelegten Teil des Dateisystems des Servers abzurufen und an einen User Agent auszuliefern.
Die drei häufigsten Webserver für hohe Last im Internet sind heute Apache, Nginx (ausgesprochen Engine-X) und IIS (von Microsoft).
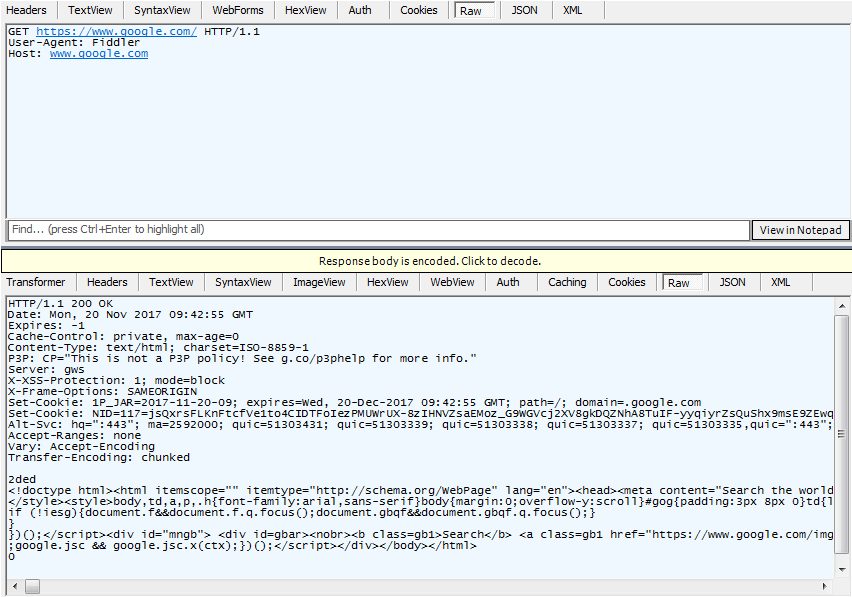
Sehen wir uns eine einfache HTTP-Anfrage mit einer User-Agent-Anwendung namens Fiddler an.
Fiddler ist ein HTTP-Debugging-Proxy für APIs und Webanwendungen. Die Entwicklerwerkzeuge, die in jedem modernen Browser eingebaut sind, zeigen einen Großteil derselben Informationen.
(hr)
HTTP-Anfragemethoden (h2, anchor section03)
Genau wie im ersten Diagramm eines HTTP-Anfrage/Antwort-Austauschs dargestellt, fordert der User Agent ein Dokument an, und dann erfüllt ein Webserver eine gültige HTTP-Anfrage.
Wie im oberen Teil des Fiddler-Fensters zu sehen, hat Fiddler, der User Agent, drei Zeilen Daten gesendet:
- GET gibt Datei und Pfad an
- User-Agent identifiziert die Client-Software
- HOST gibt den Host an, auf dem der Inhalt liegt
Die Anfragemethode ist in dieser Anfrage GET. Weitere HTTP-Anfragemethoden lernen wir in diesem Leitfaden kennen.
Der User-Agent-String: Ein User-Agent-String ist die Art, wie sich die Web-Client-Software gegenüber dem Webserver zu erkennen gibt. APIs und Websites gewähren oder verweigern Zugriffsrechte und Darstellungseinstellungen oft anhand des User-Agent-Strings des Clients.
Anständige Crawler geben sich in ihrem User-Agent-String ehrlich zu erkennen und halten sich an die Regeln, die eine Website in ihrer Datei robots.txt veröffentlicht.
| Einige Beispiele für User-Agent-Strings (die Versionsnummern ändern sich mit jeder Veröffentlichung): | |
|---|---|
| Chrome unter Windows 7 | Mozilla/5.0 (Windows NT 6.1; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/62.0.3202.94 Safari/537.36 |
| Internet Explorer 11 | Mozilla/5.0 (Windows NT 6.1; WOW64; Trident/7.0; rv:11.0) like Gecko |
| Googlebot | Mozilla/5.0 (Linux; Android 6.0.1; Nexus 5X Build/MMB29P) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/41.0.2272.96 Mobile Safari/537.36 (compatible; Googlebot/2.1; +http://www.google.com/bot.html) |
| Play Station 4 | Mozilla/5.0 (PlayStation 4 4.71) AppleWebKit/601.2 (KHTML, like Gecko) |
Host
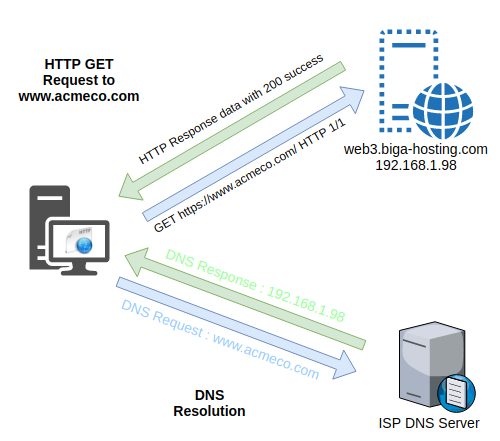
Der Host-Header gibt den Server (und die Domain) an, der das angeforderte Dokument besitzt. Seit HTTP/1.1 ist der Host-Header Pflicht (HTTP/2 und HTTP/3 übermitteln dieselbe Information im Feld :authority). Er ist Pflicht, weil sich viele Websites einen Server und eine IP-Adresse teilen, eine Anordnung, die namensbasiertes virtuelles Hosting heißt, und der Server den Host-Header braucht, um zu wissen, für welche Website eine Anfrage bestimmt ist.
Eine Host-IP-Adresse 192.168.1.98 kann den externen DNS-Namen web3.biga-hosting.com tragen. Dieser Server mit dem Namen web3.biga-hosting.com kann Hunderte von Domains beherbergen. Der HTTP-Host-Header wiederum teilt dem Server mit, für welche der gehosteten Domains eine Anfrage bestimmt ist. Mehrere virtuelle Domains können dieselbe IPv4-Adresse 192.168.1.98 haben (das Reverse DNS zeigt üblicherweise auf web3.biga-hosting.com).
(hr)
HTTP im Detail
Dieser Abschnitt geht etwas tiefer auf das Innenleben des HTTP-Protokolls ein. Die Themen, die für einen Überblick über HTTP behandelt werden, umfassen:
- Die Konzepte URI und URL
- HTTP-Verben: GET, POST, PUT, DELETE, HEAD, TRACE, OPTIONS
- Medientypen
- Gemeinsame Eigenschaften von HTTP: stateless, keine eingebaute Verschlüsselung, HTTP-Authentifizierung
(hr)
Die Konzepte URI und URL (h2, anchor section04)
Von allen Konzepten rund um HTTP ist die Entschlüsselung der Begriffe URI und URL einfach und verwirrt dennoch sowohl Studierende als auch manche Entwickler. Um ein einfaches Konzept noch weiter zu verwirren, wurde der Begriff URI in Standards verfeinert und dokumentiert, die es erlauben, den Begriff URL synonym zu URI zu verwenden.
URI ist die Abkürzung für Uniform Resource Identifier. URL ist die Abkürzung für Uniform Resource Locator.
Definieren wir beide so einfach wie möglich, mit einer Analogie. In unserem Szenario sagen wir, URI entspricht dem Begriff Automobil. Eine URL ist eine bestimmte Art von URI. Sagen wir also, URL entspricht einem «PKW», aber nicht einem Lastwagen oder Lieferwagen.
Es empfiehlt sich jedoch, immer den Begriff URI zu verwenden, wenn der Unterschied in irgendeiner Weise von Bedeutung ist.
Um das Konzept der URI weiter zu verstehen, sagen wir nun, wir wollen ein Buch finden. Aber wir wissen nicht, wo sich das Buch befindet. Eine URL könnten wir nicht verwenden, da eine URL hostspezifisch ist. Wir könnten jedoch eine URN verwenden:
urn:isbn:0451450523Wenn eine URN wie die obige verwendet wird, ist eine darunterliegende Webanwendung mit der Geschäftslogik betraut, das angeforderte Dokument zu finden.
Sagen wir in unserer Analogie, eine URN ist ein Lieferwagen, eine weitere bestimmte Art von Automobil. Eine URI definiert eine URN und eine URL. Eine URN identifiziert eine bestimmte Ressource, in unserem Beispiel ein Buch. Eine URL dagegen identifiziert den Ort und weitere Mittel für den Zugriff auf eine Ressource.
Eine URL im Detail
Eine URL, auch Uniform Resource Locator genannt, ist die am häufigsten verwendete URI im World Wide Web. Sie ist das, was wir in die Adresszeile eines Webbrowsers eingeben, um zu https://www.google.com zu gelangen.
Sehen wir uns eine komplexere URL an und zerlegen wir jeden Teil:
http://admin:password@web5.acmeco.com:8080/admin-docs/2017/ins/infrastructure.xlsxSie ist syntaktisch gültig, zeigt aber etwas, das Sie niemals tun sollten.
Die Form user:password in einer URL ist veraltet (RFC 3986), und moderne Browser entfernen oder blockieren sie. Zugangsdaten in einer URL landen in Server-Logs, im Browserverlauf und in Referer-Headern. Schreiben Sie niemals Zugangsdaten, gehasht oder nicht, in eine URL.
| Zugangsdaten in einer URL | |
|---|---|
| Schema | http:// |
| Zugangsdaten | admin:password |
| Ressource/Host | web5.acmeco.com |
| Port | 8080 |
| Pfad | /admin-docs/2017/ins/ |
| Dokument | infrastructure.xlsx |
http://www.acmeco.com/ ist ebenfalls eine gültige URL.
Der angehängte Schrägstrich sagt dem Webserver, dass wir das Standarddokument im Webroot wollen. Traditionell heißt dieses Dokument index.html, der Administrator des Servers kann es aber auf einen beliebigen Namen ändern.
Eine weitere gültige URL kann sein: mailto:user@example.com. Statt ein Dokument anzufordern, öffnet diese URL das Standard-E-Mail-Programm, bereit zum Schreiben an diese Adresse.
Einige gültige URL-Protokollschemata sind: https://, http://, ftp://, file://, mailto:, tel:, und wahrscheinlich noch ein paar mehr. http und https sind jedoch die am häufigsten verwendeten Protokolle im World Wide Web.
Query-Strings
Es gibt eine weitere gängige Art, eine URL anzugeben, die im World Wide Web häufig genutzt wird. Sie heißt Query-String. Ein Query-String wird üblicherweise in Verbindung mit einer Backend-Webanwendung oder einem CGI-Skript verwendet.
Ein Beispiel wird an unsere vorherige GET-Anfrage angehängt und greift direkt auf die Google-Suche zu:
https://www.google.com/search?q=euro+vps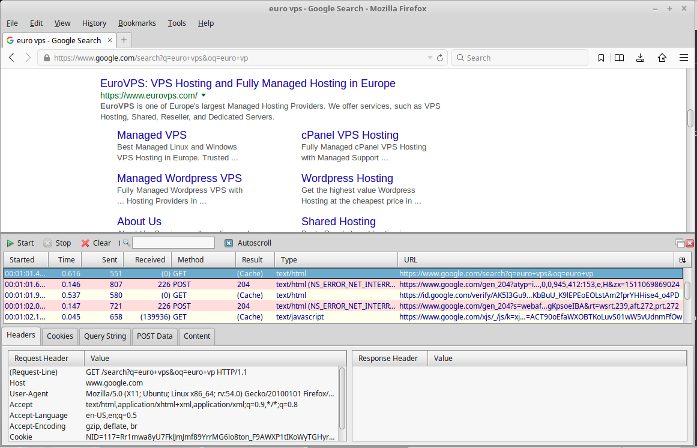
Query-Strings werden üblicherweise verwendet, um Parameter an ein Backend-Skript zu übergeben. Der Query-String wird vom Webbrowser kodiert, dann an einen Webserver übermittelt, vom Webserver oder der Anwendung dekodiert und schließlich von der Webanwendung verarbeitet.
Query-Strings wurden bekanntermaßen ausgenutzt, indem schädliche Parameter übergeben wurden, um die Funktionalität einer Webanwendung zu manipulieren.
https://www.acmeco.com/auth/auth.php?user=acmeuser&password=EXAMPLEOben steht ein Beispiel dafür, was man niemals tun sollte. Zugangsdaten, gehasht oder nicht, dürfen niemals in einer URL reisen: Sie landen in HTTP-Logs, im Browserverlauf und in Referer-Headern. Senden Sie sie im Body eines POST über HTTPS oder in einem Authorization-Header.
(hr)
HTTP-Verben (h2, anchor section05)
Nachdem wir nun eine gute Vorstellung davon haben, was eine URL ist und wie Query-Strings verwendet werden, stellen wir die Verben vor, die in HTTP-Anfragen verwendet werden. Die am häufigsten verwendeten HTTP-Verben sind:
- POST und GET
- PUT
- DELETE
- HEAD
- TRACE
- OPTIONS
- CONNECT
1. POST und GET
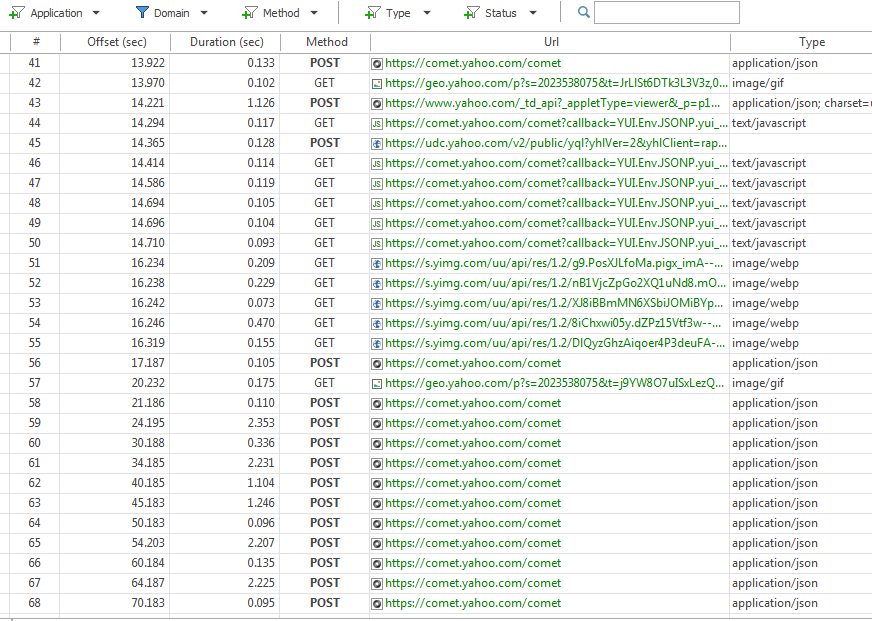
GET ist die Standardmethode, wenn Sie eine Website in die Adresszeile eines Browsers eingeben oder auf einen Hyperlink klicken. Wenn eine Webseite angefordert wird, kann der Browser tatsächlich mehrere GET- oder POST-Anfragen stellen und dabei alle Ressourcen herunterladen, aus denen eine Webseite besteht, darunter Bilder, Stylesheets, clientseitige Skripte, Schriftressourcen und mehr:
Hyperlink ist die technische Bezeichnung für die Verknüpfung mit weiteren Webseiten. Wenn der Nutzer auf einen Link (oder Hyperlink) klickt, sendet der Browser eine GET-Anfrage für die verlinkte Seite
POST-Anfragen
Die beiden am häufigsten verwendeten Anfragemethoden sind GET und POST. Eine GET-Anfrage haben wir bereits zerlegt. Untersuchen wir also eine POST-Anfrage.
Was wäre, wenn wir eine 1GB große Datei über ein PHP- oder asp-Skript hochladen wollten? Natürlich kann eine URL keinen binären String von 1GB aufnehmen. In diesem Szenario würden wir die POST-Methode verwenden.
POST ähnelt GET darin, dass POST Parameter wie ein Query-String übergeben kann. Allerdings werden POST-Daten nicht wie beim Query-String an eine URL angehängt.
Stattdessen reisen POST-Daten im Body der HTTP-Anfrage, nach den Headern. POST wird am häufigsten mit Daten aus HTML-Formularen verwendet.
Die POST-Methode wird üblicherweise verwendet, wenn die folgenden Eigenschaften gebraucht werden:
- Datei-Uploads
- sensible Daten aus der URL heraushalten
- es müssen längere Datenstrings gesendet werden
- es müssen andere Kodierungsschemata verwendet werden
- darf nicht gecacht werden (bei Sicherheitsbedenken)
Vergleichen wir das mit einigen Vorteilen der GET-Methode mit an die URL angehängtem Query-String
- kann als Lesezeichen gespeichert werden
- kann gecacht werden
- Abfrageergebnisse können per Link geteilt werden
2. PUT
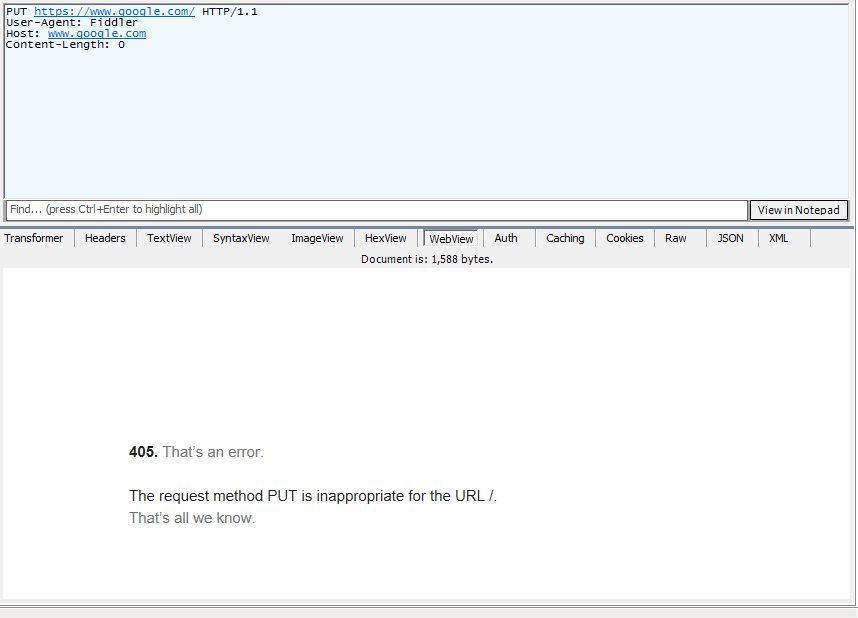
Die PUT-Methode wird am häufigsten in RESTful-Web-APIs verwendet. PUT erzeugt oder ersetzt die Ressource an der in der Anfrage angegebenen URI, während POST den Server bittet, die Daten zu verarbeiten, wobei oft eine neue Ressource an einer URI entsteht, die der Server wählt.
PUT ist in Webserver-Installationen in der Regel standardmäßig deaktiviert.
PUT aktiviert zu lassen, könnte Angreifern potenziell erlauben, Dateien auf den Webserver hochzuladen und auszuführen.
3. DELETE
Wie PUT wird die DELETE-Methode am häufigsten in RESTful APIs verwendet. Die Verwendung von DELETE sollte eine Löschaktion auf einem URI-Objekt ausführen:
DELETE http://acmeco.com/customers/{customer-id}
DELETE ist in den meisten Webserver-Installationen standardmäßig deaktiviert. DELETE zu aktivieren, wenn es nicht gebraucht wird, könnte ein Sicherheitsrisiko sein und Angreifern erlauben, Dokumente von einer Website zu löschen.
4. HEAD
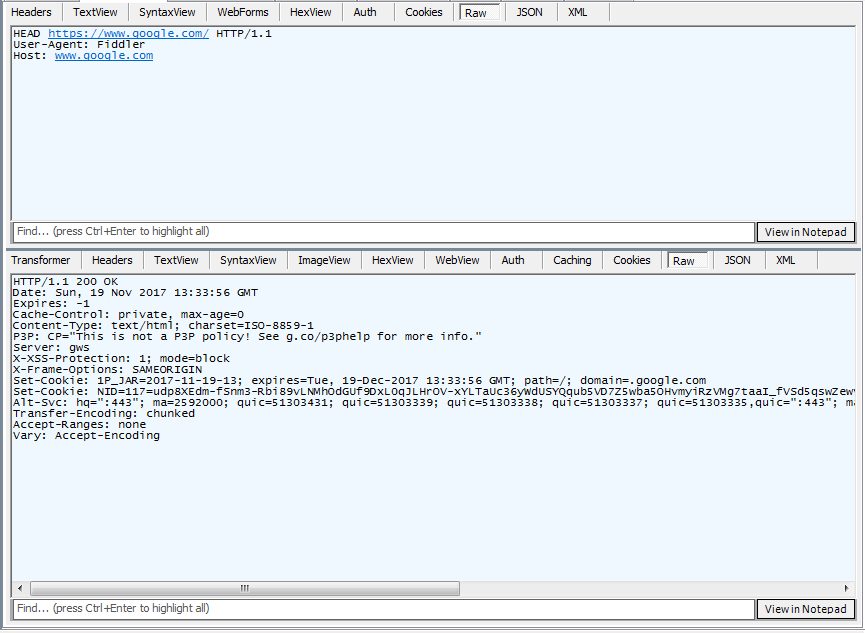
Die HEAD-Methode ähnelt GET, liefert aber nur Header ohne Inhalt zurück. HEAD wird üblicherweise verwendet, um zu prüfen, ob ein gecachtes Dokument aktualisiert wurde. Ist das Dokument neuer als die gecachte Version, wird das gesamte Dokument heruntergeladen und gecacht.
5. TRACE
TRACE ist eine Diagnosemethode und ist auf den meisten Webservern in der Regel deaktiviert. Viele Sicherheitsforscher haben mögliche Schwachstellen in Verbindung mit TRACE-Methoden entdeckt. Das Risiko überwiegt den Nutzen von TRACE in den meisten Fällen bei weitem.
6. OPTIONS
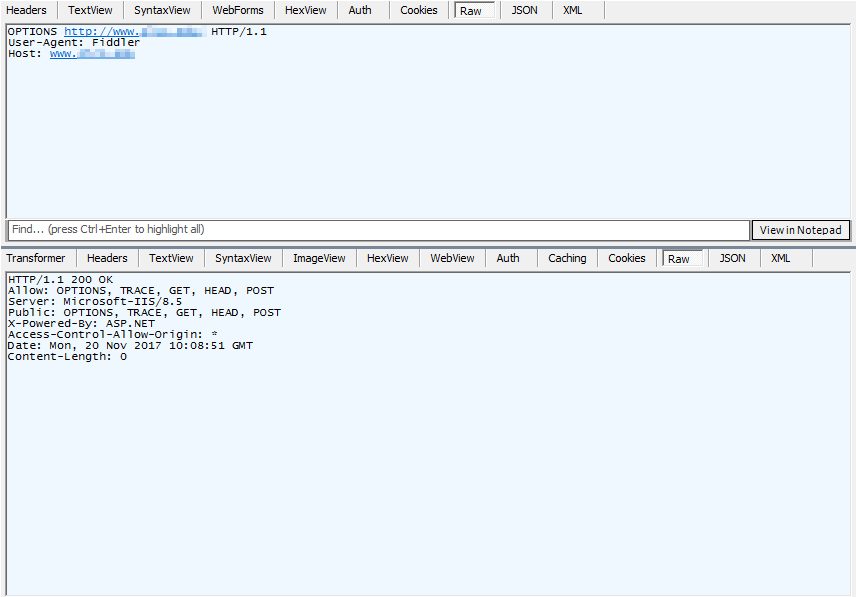
OPTIONS fragt den Server, welche Methoden und Funktionen er für eine Ressource unterstützt. Deaktivieren Sie es nicht: Browser senden vor vielen Cross-Origin-API-Aufrufen eine OPTIONS-Anfrage als CORS-Preflight, und sie zu blockieren bringt diese Anwendungen zum Scheitern. Erlauben Sie stattdessen nur die Methoden, die Ihre Anwendung tatsächlich braucht, und deaktivieren Sie TRACE.
7. CONNECT
CONNECT wird von Proxys verwendet und sollte auf einem gewöhnlichen Webserver nicht aktiviert sein. Wenn es aktiviert und falsch konfiguriert ist, kann CONNECT Verbindungen erlauben, die Anfragen an andere Server weiterleiten. Diese weitergeleiteten Verbindungen können für Angriffe oder zum Herunterladen illegaler Dateien genutzt werden.
Standardmäßig hat die meiste Webserver-Software CONNECT deaktiviert.
Die legitime Verwendung von CONNECT ist das Tunneln von HTTPS- und anderen TLS-Verbindungen durch einen Forward Proxy.
(hr)
Medientypen (h2, anchor section06)
Ein Medientyp (Media Type) definiert Dateien anhand ihrer Art und ihres Formats für die Darstellung oder Verarbeitung. Der Content-Type-Header wird in einer HTTP-Antwort verwendet und erlaubt einem Webbrowser, den Text der Antwort anzuzeigen, ein Plugin für einen unterstützten Dateityp zu laden oder eine Datei einfach zum Betrachten in einer anderen Anwendung herunterzuladen.
Ursprünglich wurde der Media Type für E-Mail-Anhänge eingeführt und MIME Types genannt. MIME steht für Multipurpose Internet Mail Extension.
Manche Media Types tragen das Präfix «x-» oder «vnd». Das «x» bedeutet, dass ein Media Type nicht offiziell bei der IANA (Internet Assigned Numbers Authority) registriert ist. Der Teil «vnd» bedeutet, dass ein Media Type herstellerspezifisch ist (zum Beispiel application/vnd.ms-excel).
Media Types in Firefox anzeigen
- geben Sie «about:config» in die Adresszeile ein.
- geben Sie in das Suchfeld der Einstellungen «mime» ein
image: src /blog/wp-content/uploads/2017/12/rNTzwB7-e1513109426632.jpg (unchanged); alt: MIME-Type-Konfiguration von Firefox unter Linux
Auf einer Linux-Plattform sehen wir, dass Firefox die Datei /etc/mime.types verwendet
Sehen wir uns einen Ausschnitt unserer Datei /etc/mime.types an:
$ head -n 40 /etc/mime.types | grep -v "^#" application/activemessage application/andrew-inset ez application/annodex anx application/applefile application/atom+xml atom application/atomcat+xml atomcat application/atomicmail application/atomserv+xml atomsrv application/batch-SMTP application/bbolin lin application/beep+xml application/cals-1840 application/commonground application/cu-seeme cu application/cybercash $ wc -l /etc/mime.types 835 /etc/mime.typesWie zu sehen, erkennt dieses System über 800 einzelne MIME Types. Im Kern sagt das Firefox, welche Dateiendungen mit bestimmten Dateitypen verknüpft sind.
HINWEIS: Media Types sind etwas anderes als die «Standardanwendungen» des Betriebssystems. Vom Konzept her ähnlich, werden MIME Types von internetfähigen Anwendungen verwendet, während ein Betriebssystem ein eigenes Verzeichnis von Dateitypen und den zugehörigen Anzeigeprogrammen führt.
Wenn eine GET-Anfrage für eine Excel-Tabelle gestellt wird, liefert der Content-Type-Header application/vnd.ms-excel zurück. Daran erkennt der Webbrowser, dass die Datei nicht als Text im Browserfenster angezeigt werden soll. Stattdessen wird die Datei entweder in ein Anzeige-Plugin geladen oder zum späteren Betrachten in einer anderen Anwendung heruntergeladen.
Ein Unix- oder Linux-Webserver verwendet ebenfalls /etc/mime.types für den Content-Type-Header. Zusätzlich muss für eine Skriptsprache wie php ein Handler gesetzt werden, damit PHP-Dateien ausgeführt statt als Text an den Browser gesendet werden. Unter RHEL übergibt sie die Apache-Datei /etc/httpd/conf.d/php.conf an PHP-FPM:
<FilesMatch \.(php|phar)$> SetHandler "proxy:unix:/run/php-fpm/www.sock|fcgi://localhost" </FilesMatch>Oben: Dateien, die auf .php (und .phar) enden, werden über den Socket an den PHP-FPM-Dienst übergeben, statt als gewöhnliche Dateien ausgeliefert zu werden.
Wenn Sie jemals auf einen Link geklickt haben und Ihr Browser eine Grafik oder andere Binärdaten als ASCII angezeigt hat, oder Sie aufgefordert wurden, eine Webseite herunterzuladen, dann waren die MIME Types des Browsers oder des Servers falsch konfiguriert.
Zur Fehlersuche sehen Sie sich den Content-Type-Header in den Entwicklerwerkzeugen Ihres Browsers an (Reiter Netzwerk):
image: src /blog/wp-content/uploads/2017/12/FTSurmm-e1513109444640.jpg (unchanged); alt: Content-Type-Header in HTTPFox
Wir sehen, dass in einer Server-Antwort der richtige Content-Type angegeben wurde. Würde der Browser anbieten, das mit der GET-Anfrage angeforderte Bild zu speichern, wüssten wir, dass der MIME Type des Browsers für image/jpeg neu konfiguriert werden muss.
Fehlerhafte Konfigurationen von serverseitigem Scripting oder binären MIME Types können zu Sicherheitsproblemen auf dem Server oder beim Client führen.
Die IANA (Internet Assigned Numbers Authority) ist damit betraut, über den RFC-Prozess eine offizielle Zuordnung der Media Types zu führen.
(hr)
Eigenschaften von HTTP
In diesem Abschnitt besprechen wir Eigenschaften des HTTP-Protokolls. Die wichtigsten Konzepte, die Sie bei der Arbeit mit HTTP kennen sollten, sind:
- HTTP ist stateless
- HTTP bietet keine eingebaute Verschlüsselung
Was ist ein zustandsloses Protokoll?
HTTP ist von seinem Entwurf her stateless: Jede Anfrage trägt alles in sich, was der Server braucht, um sie zu beantworten. HTTP ist jedoch nicht verbindungslos. HTTP/1.1 und HTTP/2 halten TCP-Verbindungen offen und verwenden sie für viele Anfragen wieder, und HTTP/3 tut dasselbe über QUIC.
Stateless bedeutet einfach, dass HTTP-Transaktionen von einem User Agent angefordert und dann vom Webserver beantwortet werden. Wenn ein Client angeforderte Ressourcen nicht cacht, muss er dieselbe Methode erneut ausführen, um die Ressource wieder zu erhalten. Ein HTTP-Webserver hat keine Zustandstabelle, in der er frühere Kommunikation mit einem User Agent nachschlagen könnte.
HTTP-Cookies: Cookies können einem Webserver helfen, auf frühere HTTP-Interaktionen mit einem User Agent Bezug zu nehmen. Das Protokoll selbst bleibt stateless: Jede Anfrage steht für sich, auch wenn sie über eine wiederverwendete Verbindung reist.
Die meisten Backend-Programmiersprachen, etwa Pythons Django-Framework, PHP und ASP .Net, bieten Bibliotheken, um den Anwendungszustand mit eingebauten Session-Frameworks zu halten. Dieser Ansatz macht eine Webanwendung zustandsbehaftet, ist aber auf einer höheren Ebene als HTTP abstrahiert.
HTTP bietet keine Verschlüsselung
HTTP selbst bietet keine eingebauten Verschlüsselungsmechanismen. Die Verschlüsselung bleibt anderen Protokollen überlassen, die HTTPS definieren. HTTPS verwendet Transport Layer Security oder TLS, den Nachfolger von SSL.
TLS arbeitet mit vielen Protokollen, nicht nur mit HTTP. HTTPS ist dafür entworfen, HTTP-Inhaltsdaten und HTTP-Header über gesicherte TLS-Verbindungen zu transportieren. SSL wurde ursprünglich in den 1990er-Jahren von Netscape entwickelt. Die IETF hat seinen Nachfolger später als TLS standardisiert. Alle Versionen von SSL sind inzwischen überholt. Aktuell sind TLS 1.2 und TLS 1.3.
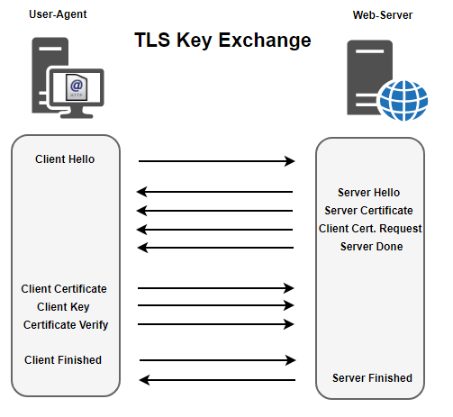
Der aufmerksame Leser mag sich fragen: «Also ist HTTPS zustandsbehaftet? Richtig? Jede Session hat einen Schlüssel? Richtig?». Die Schlüssel werden vom Client zwischengespeichert, ja. Aber TLS arbeitet weiterhin auf einer tieferen Schicht als der HTTP-Kern von HTTPS. Die Interaktionen mit dem Webserver verwenden weiterhin dieselben HTTP-Methoden: GET, POST, PUT und DELETE.
(hr)
HTTP-Authentifizierung (h2, anchor section07)
Die Authentifizierung ist, anders als die Verschlüsselung, in HTTP eingebaut. HTTP unterstützt mehrere Arten der Authentifizierung, darunter:
- Basic
- Bearer
- Digest
- HOBA
- Mutual
- Negotiate
- OAuth
- SCRAM-SHA1
- SCRAM-SHA256
- vapid
Basic Authentication
Die mit Abstand häufigste Methode der HTTP-Authentifizierung ist die Basic Authentication. Basic Authentication ist verbreitet, weil sie einfach zu implementieren ist, nicht weil sie sicher ist. Andere Authentifizierungsschemata sind sicherer, und Basic Authentication darf ausschließlich über HTTPS verwendet werden.
Das größte Sicherheitsproblem der Basic Authentication ist, dass die Zugangsdaten im Klartext gesendet werden. Zwar werden die Zugangsdaten Base-64-kodiert, aber Kodierung ist keine Verschlüsselung, bestenfalls ist es Verschleierung. Zugangsdaten können leicht kompromittiert werden, wenn kein TLS verwendet wird oder wenn der TLS-Datenverkehr einem Man-in-the-Middle-Angriff zum Opfer fällt.
Schwächen der Basic Authentication:
- kodiert die Zugangsdaten lediglich in BASE 64
- die Zugangsdaten werden im Browser zwischengespeichert, was einen weiteren Angriffsvektor hinterlässt
- die Zugangsdaten können dauerhaft im Browser gespeichert werden
- bösartige Proxy-Server können die Zugangsdaten potenziell protokollieren
- die Zugangsdaten stehen im HTTP-Header
BASIC Authentication erfüllt nach wie vor einen Zweck. Es ist jedoch wichtig, die Grenzen dieses Zwecks anzuerkennen. Basic Authentication taugt nur zur Zugriffskontrolle. Zugriffskontrolle dient lediglich dazu, den Zugriff auf Ressourcen zu steuern. Basic Authentication taugt nicht zur Absicherung von Daten. Insbesondere nicht für sensible Informationen, deren Offenlegung Umsatzverluste oder einen Verlust an Privatsphäre bedeuten kann.
Wenn Sie ein HTTP-Authentifizierungsschema implementieren, stellen Sie sich Basic Authentication wie einen Zahlencode vor, der den autorisierten Zutritt zu einem Gebäude oder Büro nur erlaubt, solange das Sicherheitspersonal vor Ort ist. Nach Geschäftsschluss werden dieselben Türen mit einem sichereren Mechanismus verschlossen, um das Gebäude zu sichern.
- Zugriffskontrolle ist bequemer Zugang für autorisiertes Personal
- Sicherheit hält Eigentum vor Angreifern geschützt
Unten ist eine Darstellung einer Anfrage und Antwort mit Basic Authentication:
images: src /blog/wp-content/uploads/2017/12/fvNIZLj-e1513109471712.jpg and /blog/wp-content/uploads/2017/12/Svu1sFi-e1513109482792.jpg (unchanged); alts: Basic Authentication 1, Basic Authentication 2
- Der User Agent stellt eine Anfrage für ein Dokument
- Der Webserver antwortet mit dem HTTP-Code 401: Authorization Required
- Der User Agent wiederholt die Anfrage mit Zugangsdaten
- Der Webserver erlaubt oder verweigert den Zugriff je nach Gültigkeit der Zugangsdaten
Als Demonstration der Schwächen der Basic Authentication versuchen Sie, die Zugangsdaten aus dem abgebildeten BASE64-kodierten String zu ermitteln.
Authentifizierung mit Bearer Token
Die Authentifizierung mit Bearer Token ist bei Anbietern von Authentifizierungs-Frameworks beliebt. Bearer Authentication kann auch als eigenständige Lösung pro Instanz eingesetzt werden.
Bearer Authentication basiert auf Tokens und wird sowohl in OAuth als auch in OpenID verwendet. Typischerweise dient OAuth der Autorisierung, während OpenID der Authentifizierung dient. Es gibt jedoch etliche Grauzonen, die die Grenzen zwischen Authentifizierung und Autorisierung in beiden Frameworks verwischen.
- OpenID bietet föderierte Authentifizierung oder Anmeldedienste
- OAuth bietet delegierte Autorisierung
GitHub stellt einen OAuth-Leitfaden für Entwickler von Drittanwendungen bereit, die im Auftrag eines Endnutzers auf GitHub-Ressourcen zugreifen möchten. GitHub OAuth App Guide
Große Identitätsanbieter wie Google bieten die Anmeldung über OpenID Connect an, den aktuellen OpenID-Standard, der auf OAuth 2.0 aufbaut.
Anmeldung mit OpenID Connect über ein Google-Konto:
image: src /blog/wp-content/uploads/2017/12/BMtbtwA.jpg (unchanged); alt: Google als Open-ID-Authentifizierungsanbieter
Digest Authentication
Digest Authentication ist sicherer als Basic Authentication. Dennoch reicht Digest Authentication nicht aus, um sensibles Material im Internet abzusichern. Digest Authentication verschlüsselt die Zugangsdaten nicht, sie hasht sie, und wenn diese Hashes abgefangen werden, kann ein Angreifer offline einen Brute-Force- oder Wörterbuchangriff starten.
Sowohl das Digest- als auch das Basic-Schema gelten im Gesamtbild der Datensicherheit als schwach. Beide haben Mängel, und beide wurden erfolgreich angegriffen. Wenn mehr als einfache Zugriffskontrolle oder Autorisierung gebraucht wird, muss ein sichereres Authentifizierungsschema eingesetzt werden.
Weitere HTTP-basierte Authentifizierungsschemata
NTLM, bekannt als NT Lan Manager Authentication, ist eine Technologie von Microsoft mit Plugins für viele Produkte, Betriebssysteme und Dienste von Drittanbietern.
In Windows-Domänen ist Negotiate die bevorzugte Wahl; es verwendet Kerberos und greift nur dann auf NTLM zurück, wenn es muss. Microsoft stellt NTLM schrittweise ein. Mit Kerberos können bereits angemeldete Domänenbenutzer auf autorisierte Ressourcen zugreifen, ohne ihre Zugangsdaten erneut einzugeben.
Die größten Nachteile der NTLM-basierten Authentifizierung sind:
- sie kann auf anderen Plattformen als Windows umständlich zu implementieren sein
- sie kann außerhalb einer Windows-Domäne viele Sicherheitsfunktionen einbüßen
- NTLM ist nur so sicher wie das Unternehmensnetzwerk
- ältere Versionen von NTLM gelten als unsicher
SCRAM-SHA1 und SCRAM-SHA256
SCRAM ist die Abkürzung für Salted Challenge Response Authentication Mechanism
Wenn interne Mitarbeiter authentifiziert werden müssen, kann SCRAM-Authentifizierung in Verbindung mit OpenLDAP eine gute Lösung für Umgebungen mit Geräten vieler Hersteller sein.
SCRAM kann aufwendiger einzurichten sein als NTLM für eine Windows-Domäne. Aber SCRAM kann eine ausgezeichnete Wahl in einem Netzwerk mit Linux-, MacOS-Server-, Windows- und Unix-Clients sein, und sogar über das Internet.
Verwandter Artikel: Vollständiger Leitfaden zu HTTP-Statuscodes: 300er-Serie
Aus dem Blog-Archiv von EuroVPS, erstmals veröffentlicht am 12. Dezember 2017.
Alle Notizen aus der Praxis