

Що таке Hypertext Transfer Protocol (HTTP) насправді?
HTTP від першого рядка запиту до HTTP/2: методи, заголовки, коди стану, keep-alive і що кожне з них означає для сервера, який ви ведете.
Створення World Wide Web відточувалося приблизно з 1988 до 1991 року.
Спочатку механізми HTTP були спроєктовані, щоб дати науковцям з усього світу спільну платформу для досліджень і співпраці. Як виявилося, всесвітня павутина дала інструменти публікації, навчання та співпраці в руки кожному, хто має підключення до Інтернету.
(hr)
Початкові компоненти винаходу Tim Berners-Lee використовуються й сьогодні. Більше того, деякі сучасні веб-сервери досі розуміють початкову специфікацію HTTP (хоч сьогодні вона й вважається застарілою):
Базові компоненти World-Wide-Web:
- веб-сервер
- user agent
- текстове відображення
- типи медіа
- протокол, що дозволяє передавати документи, HTTP
| Сучасний W.W.W. | |
|---|---|
| веб-сервер | IIS, Apache, NGiNX |
| user agent | CuRL, Chrome, Firefox, читачі RSS |
| текстові дані | UTF-8, ASCII, JSON, HTML, XML, CSS |
| типи медіа | текстові дані, зображення, відео, анімації |
| специфікації HTTP | HTTP/1.1 (RFC 9112), HTTP/2 (RFC 9113) і HTTP/3 (RFC 9114), зі спільною семантикою в RFC 9110 |
Дві основні організації відповідають за визначення розвитку сучасного HTTP:
- W3C World Wide Web Consortium. W3C опікується функціональністю веб-серверів, майбутніми потребами специфікацій, user agent (тобто браузерами), HTML, XML, відео, зображеннями та технологіями доставлення вмісту. Загалом W3C цікавить вплив HTTP на прикладний рівень.
- IETF Internet Engineering TaskForce. IETF опікується тим, як HTTP працюватиме й функціонуватиме на нижчому технічному рівні. HTTP працює поверх базових технологій, таких як IPv4, TCP, UDP, Ethernet та багатьох інших протоколів нижчих рівнів. Усі нижчі протоколи працюють разом, щоб доставити дані від user-agent до веб-сервера й назад до user agent.
Узято із сайту кожної з них; W3C та IETF описують себе власними словами:
- The World Wide Web Consortium (W3C) is an international community where Member organizations, a full-time staff, and the public work together to develop Web standards. (https://www.w3.org/Consortium/)
- The goal of the IETF is to make the Internet work better. The mission of the IETF is to make the Internet work better by producing high quality, relevant technical documents that influence the way people design, use, and manage the Internet. (https://www.ietf.org)
Як визначаються стандарти на кшталт HTTP?
Коли інтернет-протокол на кшталт HTTP ухвалюється або переглядається, стандарти визначаються в документах, які називаються RFC.
RFC розшифровується як Request For Comments.
Кожен визнаний протокол передачі даних, прийнятий для масового використання в Інтернеті, визначається в серії документів RFC. Такі технології, як HTTP, IPv4, TLS, PKI, SNMP, POP3 і навіть Ethernet, не належать Microsoft, Apple чи Google.
Стандарти, визначені в RFC, призначені для впровадження як засіб зв'язку між платформами різних виробників. Кожну технологію (у своїй основі), задокументовану в RFC, може реалізувати, допрацювати для використання і навіть додати до продуктів будь-яка особа чи виробник без роялті й патентів.
RFC зазвичай є доволі сухим документом у текстовому форматі ASCII, за традицією читабельним на будь-якій платформі. RFC також припускає, що читач володіє технічними поняттями.
- Чинні специфікації HTTP: RFC 9110 HTTP Semantics, RFC 9112 HTTP/1.1, RFC 9113 HTTP/2 і RFC 9114 HTTP/3
(hr)
HTTP є акронімом від Hyper Text Transfer Protocol. HTTP є stateless-протоколом прикладного рівня, спроєктованим для обміну інформацією між системами через Інтернет. Як такий, HTTP визначає набір правил, що дозволяють і передачу, і доступ до віддалених документів. HTTP також використовувався для передачі інформації іншими способами, наприклад SSDP, який використовує UDP і multicast-адресацію (прийнято як HTTPU).
Чим HTTP НЕ є?
HTTP і всесвітня павутина не є Інтернетом. HTTP є протоколом, на якому працює надзвичайно популярна частина Інтернету, відома як всесвітня павутина.
HTTP працює над базовими протоколами мережевого зв'язку в моделі TCP/IP. TCP/IP є механізмом передачі даних, кадрування інформації та даних прикладного рівня через Інтернет. HTTP є стандартом прикладного рівня, що спеціалізується на передачі певного типу даних. HTTP/1.1 і HTTP/2 працюють поверх TCP, тоді як HTTP/3 працює поверх QUIC, побудованого на UDP.
TCP/IP є набором протоколів передачі даних, розробленим Міністерством оборони США. TCP/IP іноді називають «мережевою моделлю DoD».
У перші роки Інтернет і TCP/IP були передані з лабораторій DARPA академічному середовищу. Після доопрацювання для академічного використання Інтернет перейняли споживачі та корпорації, і він став тим, що ми знаємо як Інтернет сьогодні. Саме в період переходу від академічного до раннього публічного використання з'явилися HTTP і всесвітня павутина.
| TCP/IP | Протоколи рівня |
|---|---|
| Прикладний рівень | HTTP: всесвітня павутина; FTP: протокол передачі файлів; POP3 та IMAP: вхідна пошта; SMTP: вихідна пошта; HTML: розмітка для відображення вебсторінок; JPEG: графічний формат для відображення зображень |
| Транспортний рівень | TCP: зв'язок між хостами з установленням з'єднання; UDP: зв'язок між хостами без установлення з'єднання (QUIC, який використовує HTTP/3, працює поверх нього) |
| Рівень Інтернету | IPv4: адресація для віддалених мереж; IPv6: адресація для віддалених мереж; BGP: маршрутизація трафіку між інтернет-провайдерами; OSPF: маршрутизація трафіку у внутрішніх мережах; ICMP: структура для передачі діагностики |
| Канальний рівень | Ethernet: фізика та сигналізація для передачі даних на нижньому рівні; Token Ring: конкурент Ethernet, якого вже майже не видно; 802.11: специфікації бездротового зв'язку; Bluetooth: специфікація бездротового підключення пристроїв; Frame Relay: фізичні та інформаційні специфікації для глобальних мереж |
Таблиця вище показує, як HTTP вписується в Інтернет і TCP/IP.
(hr)
Специфікації HTTP
Передусім HTTP призначений для передачі документів між user agent і веб-сервером.
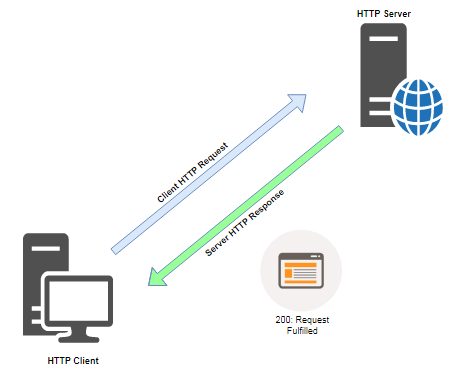
Обмін HTTP зазвичай полягає в тому, що user agent запитує серію документів у веб-сервера. Отримавши HTTP-запит, веб-сервер його аналізує. Зрештою веб-сервер або повертає документ і код стану, або може відхилити запит, повернувши код стану з причиною відмови.
- Деталі того, чому веб-сервер може відхилити запит клієнта, дивіться в розділі про коди стану HTTP 400
- Related reading: Повний посібник з кодів стану HTTP. Серія 400
User-Agent є модним терміном для застосунку, який запитує HTTP-ресурси у веб-сервера. Найчастіше user agent відомі як браузери. Проте читачі RSS, боти веб-скрейпінгу, веб-павуки та HTTP-бібліотеки на кшталт CURL теж є user-agent.
Веб-сервер є демоном, який зазвичай працює на порту 80 (HTTP) і порту 443 (HTTPS) і призначений саме для отримання документів з визначеної частини файлової системи сервера та доставлення їх user agent.
Трьома найпоширенішими високонавантаженими веб-серверами в Інтернеті сьогодні є Apache, Nginx (вимовляється Engine-X) та IIS (від Microsoft).
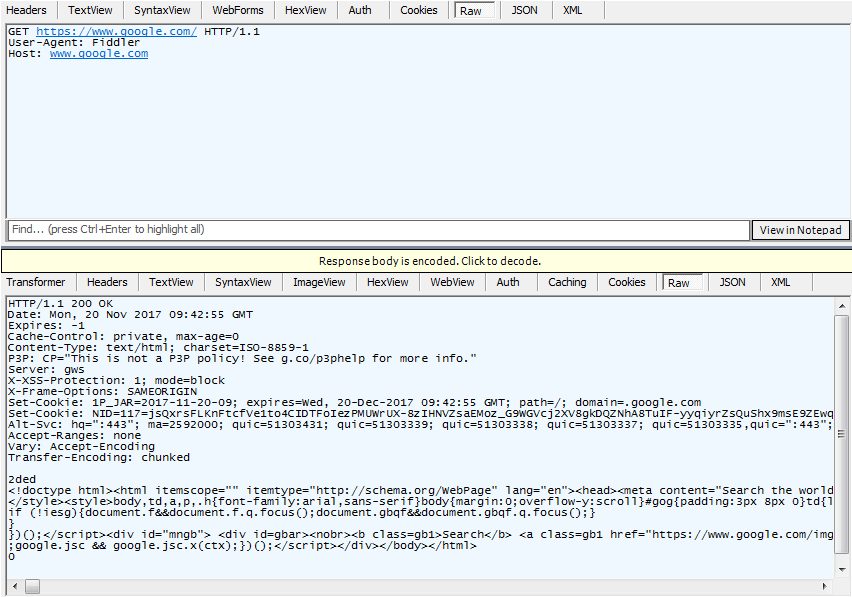
Подивімося на простий HTTP-запит за допомогою застосунку user-agent під назвою Fiddler.
Fiddler є налагоджувальним HTTP-proxy для API та веб-застосунків; інструменти розробника, вбудовані в кожен сучасний браузер, показують значну частину тієї самої інформації.
(hr)
Методи запитів HTTP
Як показано на першій діаграмі обміну HTTP-запитом і відповіддю, user-agent запитує документ, а веб-сервер виконує коректний HTTP-запит.
У верхній частині вікна Fiddler видно, що Fiddler, user-agent, надіслав три рядки даних:
- GET вказує файл і шлях
- User-Agent ідентифікує клієнтське програмне забезпечення
- HOST вказує хост, на якому розміщено вміст
Метод запиту в цьому запиті є GET. Про інші методи HTTP-запитів ми дізнаємося далі в цьому вступі.
Рядок User-Agent: Рядок User-Agent є способом, яким клієнтське веб-програмне забезпечення представляється веб-серверу. API та сайти часто надають або відмовляють у доступі та налаштуваннях відображення на основі рядка User-Agent клієнта.
Добропорядні краулери чесно представляються у своєму рядку User-Agent і дотримуються правил, які сайт публікує у файлі robots.txt.
| Кілька прикладів рядків User-Agent (номери версій змінюються з кожним випуском): | |
|---|---|
| Chrome на Windows 7 | Mozilla/5.0 (Windows NT 6.1; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/62.0.3202.94 Safari/537.36 |
| Internet Explorer 11 | Mozilla/5.0 (Windows NT 6.1; WOW64; Trident/7.0; rv:11.0) like Gecko |
| Googlebot | Mozilla/5.0 (Linux; Android 6.0.1; Nexus 5X Build/MMB29P) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/41.0.2272.96 Mobile Safari/537.36 (compatible; Googlebot/2.1; +http://www.google.com/bot.html) |
| Play Station 4 | Mozilla/5.0 (PlayStation 4 4.71) AppleWebKit/601.2 (KHTML, like Gecko) |
Host
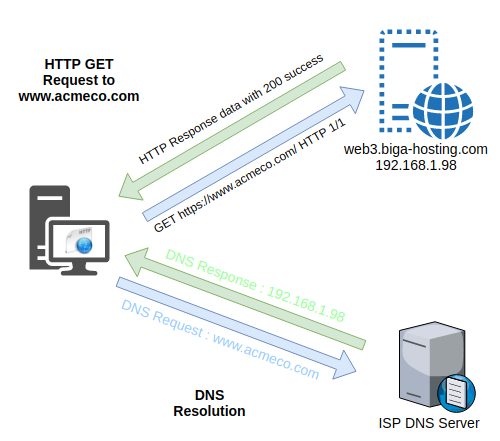
Заголовок Host вказує сервер (і домен), який володіє запитаним документом. Починаючи з HTTP/1.1 заголовок Host є обов'язковим (HTTP/2 і HTTP/3 несуть ту саму інформацію в полі :authority). Він обов'язковий, бо багато сайтів ділять один сервер і одну IP-адресу, що називається віртуальним хостингом за іменем, і серверу потрібен заголовок Host, щоб знати, для якого сайту призначено запит.
IP-адреса хоста 192.168.1.98 може мати зовнішнє DNS-ім'я web3.biga-hosting.com. Цей сервер з іменем web3.biga-hosting.com може хостити сотні доменів. Своєю чергою HTTP-заголовок host дасть серверу знати, якому з розміщених доменів адресовано запит. Кілька віртуальних доменів можуть мати ту саму IPv4-адресу 192.168.1.98 (зворотний DNS зазвичай вказуватиме на web3.biga-hosting.com).
(hr)
Розбираємо HTTP
Цей розділ трохи глибше занурюється у внутрішню роботу протоколу HTTP. Теми огляду HTTP, які ми обговоримо:
- Поняття URI та URL
- Дієслова HTTP: - GET - POST - PUT - DELETE - HEAD - TRACE - OPTIONS
- Типи медіа
- Поширені характеристики HTTP: - stateless - без вбудованого шифрування - автентифікація HTTP
(hr)
Поняття URI та URL
З усіх понять, що стосуються HTTP, розшифровка термінів URI та URL проста, але досі плутає і студентів, і навіть деяких розробників. На додачу до плутанини простого поняття, термін URI було уточнено й задокументовано в стандартах так, що термін URL став синонімом URI.
URI є акронімом від Uniform Resource Identifier. URL є акронімом від Uniform Resource Locator.
Визначмо кожен якомога простіше, за допомогою аналогії. У нашому сценарії скажімо, що URI є аналогом терміна «автомобіль». URL є конкретним типом URI. Тож скажімо, що URL є аналогом «легковика», але не вантажівки чи фургона.
Утім, радимо завжди використовувати термін URI, якщо різниця має хоч якесь значення.
Щоб краще зрозуміти поняття URI, скажімо тепер, що ми хочемо знайти книжку. Але не знаємо, де вона? Ми не могли б використати URL, бо URL прив'язаний до хоста. Проте ми могли б використати URN:
urn:isbn:0451450523Коли використовується URN, як показано, базовий веб-застосунок бере на себе бізнес-логіку пошуку запитаного документа.
Скажімо, у нашій аналогії URN є фургоном, ще одним конкретним типом автомобіля. URI визначає і URN, і URL. URN ідентифікує конкретний ресурс, у нашому прикладі книжку. А URL ідентифікує розташування та інші засоби доступу до ресурсу.
Розбираємо URL
URL, також відомий як Uniform Resource Locator, є найпоширенішим URI у всесвітній павутині. Саме його ми вводимо в адресний рядок браузера, щоб відкрити https://www.google.com.
Погляньмо на складніший URL і розберімо кожну частину:
http://admin:password@web5.acmeco.com:8080/admin-docs/2017/ins/infrastructure.xlsxВін синтаксично коректний, але показує те, чого ніколи не слід робити.
Форма user:password в URL є застарілою (RFC 3986), і сучасні браузери її вирізають або блокують. Облікові дані в URL потрапляють у журнали сервера, історію браузера та заголовки Referer. Ніколи не кладіть облікові дані, хешовані чи ні, в URL.
| Облікові дані в URL | |
|---|---|
| схема | http:// |
| облікові дані | admin:password |
| ресурс/хост | web5.acmeco.com |
| порт | 8080 |
| шлях | /admin-docs/2017/ins/ |
| документ | infrastructure.xlsx |
http://www.acmeco.com/ також є коректним URL.
Коса риска в кінці каже веб-серверу, що ми хочемо типовий документ у веб-корені. Традиційно цей документ називається index.html, але адміністратор сервера може змінити його на що завгодно.
Ще один коректний URL: mailto:user@example.com. Замість запитувати документ, цей URL відкриває типовий поштовий клієнт, готовий написати на цю адресу.
Деякі коректні схеми протоколів URL: https://, http://, ftp://, file://, mailto:, tel: і, мабуть, ще кілька. Проте http і https є найуживанішими протоколами у всесвітній павутині.
Рядки запиту
Існує ще один поширений спосіб задати URL, який широко використовується у всесвітній павутині. Він називається рядком запиту. Рядок запиту зазвичай використовується разом із серверним веб-застосунком або CGI-скриптом.
Приклад додано до нашого попереднього запиту GET, який звертається напряму до пошуку Google:
https://www.google.com/search?q=euro+vps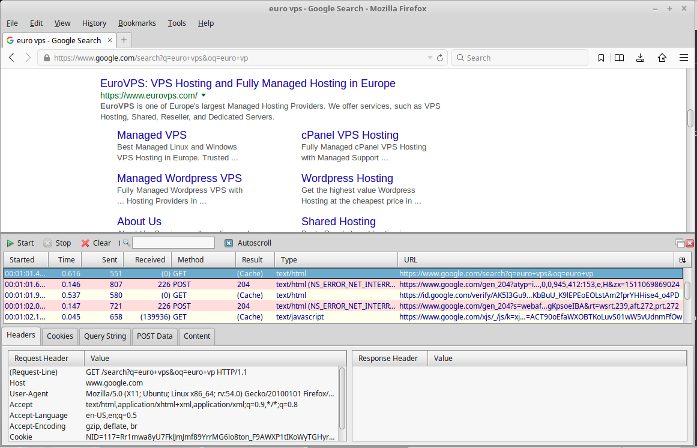
Рядки запиту зазвичай використовуються для передачі параметрів серверному скрипту. Рядок запиту кодується браузером, потім доставляється веб-серверу, декодується веб-сервером або застосунком і, нарешті, обробляється веб-застосунком.
Відомо, що рядки запиту експлуатували, передаючи некоректні параметри у спробах маніпулювати функціональністю веб-застосунку.
https://www.acmeco.com/auth/auth.php?user=acmeuser&password=EXAMPLEВище приклад того, чого ніколи не слід робити. Облікові дані, хешовані чи ні, ніколи не повинні подорожувати в URL: вони потрапляють у журнали HTTP, історію браузера та заголовки Referer. Надсилайте їх у тілі POST через HTTPS або в заголовку Authorization.
(hr)
Дієслова HTTP
Тепер, коли ми добре розуміємо, що таке URL і як використовуються рядки запиту, представимо дієслова, які використовуються в HTTP-запитах. Найуживаніші дієслова HTTP:
- POST і GET
- PUT
- DELETE
- HEAD
- TRACE
- OPTIONS
- CONNECT
1. POST і GET
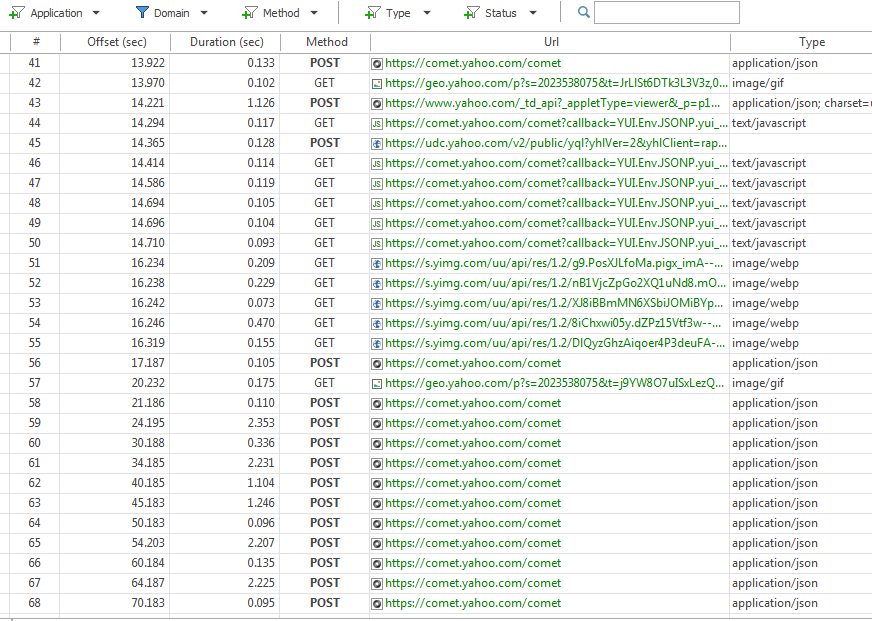
GET є типовим методом, коли ви вводите адресу сайту в адресний рядок браузера або натискаєте гіперпосилання. Коли запитується вебсторінка, браузер насправді може зробити кілька запитів GET або POST, завантажуючи всі ресурси, з яких складається сторінка: зображення, таблиці стилів, клієнтські скрипти, шрифти тощо:
Гіперпосилання є технічною назвою посилання на вторинні вебсторінки. Коли користувач натискає на посилання (або гіперпосилання), браузер надсилає запит GET на пов'язану сторінку
Запити POST
Двома найуживанішими методами запиту є GET і POST. Запит GET ми вже розібрали. Тож розгляньмо запит POST.
Що як ми хочемо завантажити файл в 1GB через PHP- або asp-скрипт? Природно, URL не може вмістити бінарний рядок в 1GB. У цьому сценарії ми використали б метод POST.
POST схожий на GET тим, що POST може передавати параметри, як рядок запиту. Проте дані POST не додаються до URL, як у рядку запиту.
Натомість дані POST подорожують у тілі HTTP-запиту, після заголовків. POST найчастіше використовується з даними HTML-форм.
Метод POST зазвичай використовується, коли потрібні такі можливості:
- завантаження файлів
- тримати чутливі дані поза URL
- потрібно надіслати довші рядки даних
- потрібно використати інші схеми кодування
- не може кешуватися (якщо це питання безпеки)
Порівняймо з деякими перевагами методу GET з рядком запиту, доданим до URL:
- можна зберегти як закладку
- можна кешувати
- результатами запиту можна поділитися посиланням
2. PUT
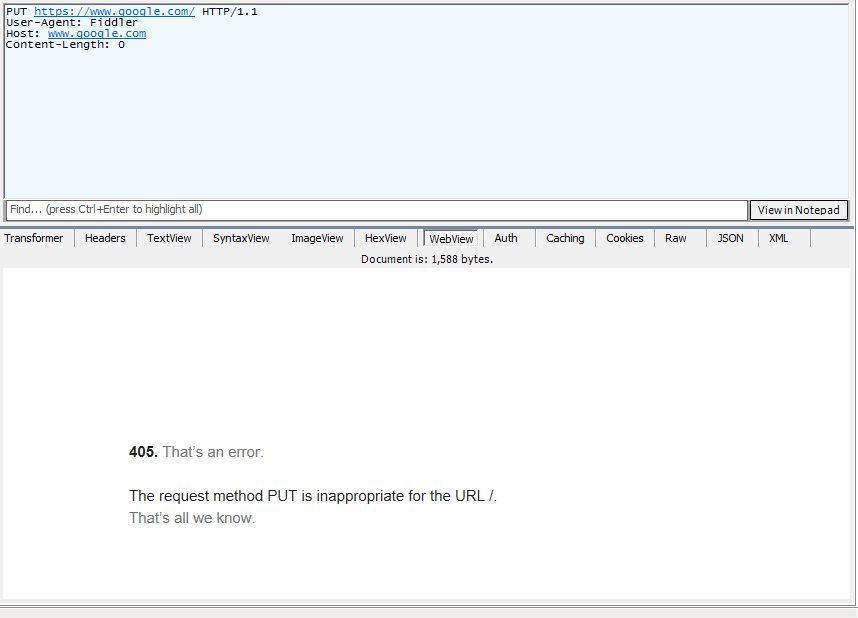
Метод PUT найчастіше використовується в RESTful веб-API. PUT створює або замінює ресурс за URI, вказаним у запиті, тоді як POST просить сервер обробити дані, часто створюючи новий ресурс за URI, який обирає сервер.
PUT зазвичай типово вимкнений в інсталяціях веб-серверів.
Увімкнений PUT потенційно може дати зловмисникам змогу завантажувати й виконувати файли на веб-сервері.
3. DELETE
Як і PUT, метод DELETE найчастіше використовується в RESTful API. Використання DELETE має виконати дію видалення над об'єктом URI:
DELETE http://acmeco.com/customers/{customer-id}
DELETE типово вимкнений у більшості інсталяцій веб-серверів. Увімкнення DELETE без потреби може бути ризиком безпеки, дозволяючи зловмисникам видаляти документи із сайту.
4. HEAD
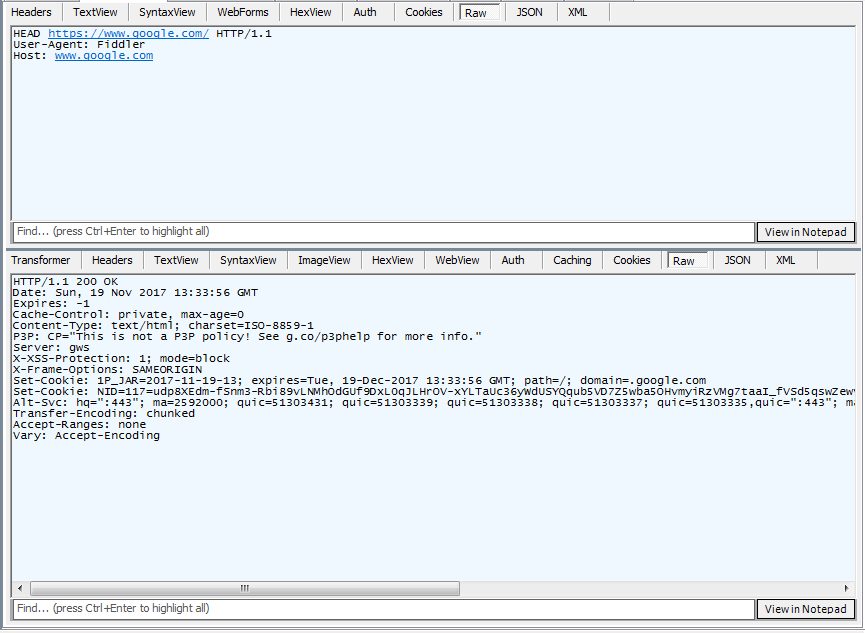
Метод HEAD схожий на GET, але повертає лише заголовки без вмісту. HEAD зазвичай використовують, щоб перевірити, чи оновився кешований документ. Якщо документ новіший за кешовану версію, весь документ буде завантажено й закешовано.
5. TRACE
TRACE є діагностичним методом і зазвичай вимкнений на більшості веб-серверів. Багато дослідників безпеки виявили потенційні вразливості в методах TRACE. Ризик здебільшого значно переважає користь від TRACE.
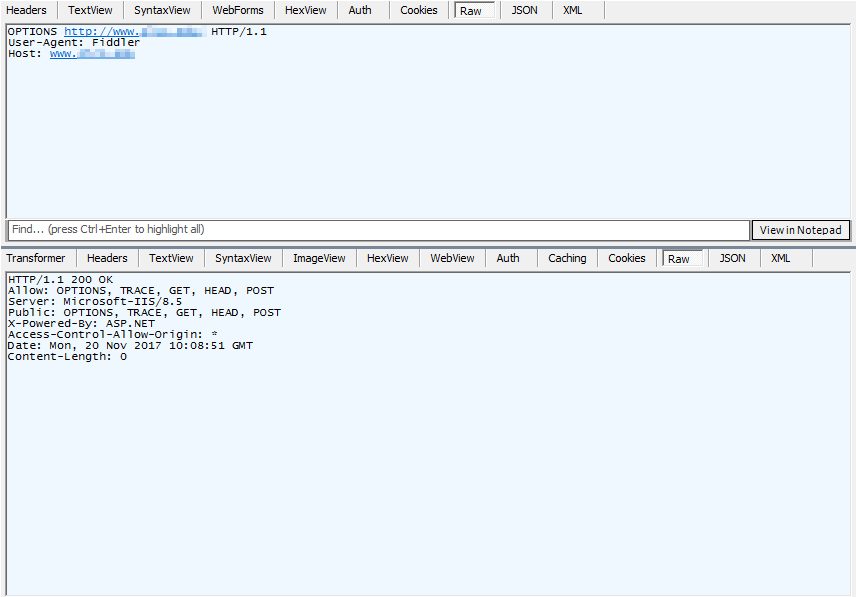
6. OPTIONS
OPTIONS запитує в сервера, які методи та можливості він підтримує для ресурсу. Не вимикайте його: браузери надсилають запит OPTIONS як preflight CORS перед багатьма крос-доменними викликами API, і його блокування ламає ці застосунки. Натомість дозволяйте лише методи, які справді потрібні вашому застосунку, і вимкніть TRACE.
7. CONNECT
CONNECT використовується proxy-серверами і не повинен бути увімкнений на звичайному веб-сервері. Увімкнений і неправильно налаштований CONNECT може дозволити з'єднанням проксіювати запити до інших серверів. Ці проксійовані з'єднання можуть використовуватися для атак або завантаження нелегальних файлів.
Типово більшість програмного забезпечення веб-серверів має CONNECT вимкненим.
Легітимне використання CONNECT: тунелювання HTTPS та інших TLS-з'єднань через прямий proxy.
(hr)
Типи медіа
Тип медіа визначає файли за природою та форматом для відображення або обробки. Заголовок Content-Type використовується в HTTP-відповіді, дозволяючи браузеру відобразити текст відповіді, завантажити плагін для підтримуваного типу файлу або просто завантажити файл для перегляду в іншому застосунку.
Спочатку тип медіа було впроваджено для вкладень електронної пошти й названо типами MIME. MIME розшифровується як Multipurpose Internet Mail Extension.
Деякі типи медіа можуть мати префікс «x-» або «vnd». «x» означає, що тип медіа офіційно не зареєстрований IANA (Internet Assigned Numbers Authority). Частина «vnd» означає, що тип медіа специфічний для виробника (наприклад application/vnd.ms-excel).
Перегляд типів медіа у Firefox
- введіть «about:config» в адресному рядку.
- у полі пошуку налаштувань введіть «mime»
image: src /blog/wp-content/uploads/2017/12/rNTzwB7-e1513109426632.jpg (unchanged); alt: Налаштування типів MIME у Firefox на Linux
На платформі Linux ми бачимо, що Firefox використовує файл /etc/mime.types
Погляньмо на частину нашого файлу /etc/mime.types:
$ head -n 40 /etc/mime.types | grep -v "^#"
application/activemessage
application/andrew-inset			ez
application/annodex				anx
application/applefile
application/atom+xml				atom
application/atomcat+xml				atomcat
application/atomicmail
application/atomserv+xml			atomsrv
application/batch-SMTP
application/bbolin				lin
application/beep+xml
application/cals-1840
application/commonground
application/cu-seeme				cu
application/cybercash
$ wc -l /etc/mime.types
835 /etc/mime.types
Як видно, ця система розпізнає понад 800 конкретних типів mime. По суті, це каже Firefox про розширення, пов'язані з певними типами файлів.
ПРИМІТКА: типи медіа відрізняються від «типових програм» операційної системи. Хоч ідея схожа, типи mime використовуються інтернет-застосунками, тоді як операційна система веде окремий облік типів файлів і пов'язаних переглядачів.
Коли робиться запит GET на електронну таблицю Excel, заголовок Content-Type повертає application/vnd.ms-excel. Своєю чергою браузер знає, що файл не слід показувати як текст у вікні браузера. Натомість файл або завантажується у плагін-переглядач, або зберігається для подальшого перегляду в іншому застосунку.
Веб-сервер Unix або Linux також використовує /etc/mime.types для заголовка Content-Type. Крім того, для скриптової мови на кшталт php має бути налаштований обробник, щоб PHP-файли виконувалися, а не надсилалися браузеру як текст. У RHEL файл Apache /etc/httpd/conf.d/php.conf передає їх PHP-FPM:
<FilesMatch \.(php|phar)$>
    SetHandler "proxy:unix:/run/php-fpm/www.sock|fcgi://localhost"
</FilesMatch>
Вище: файли із закінченням .php (і .phar) передаються службі PHP-FPM через її сокет замість віддаватися як звичайні файли.
Якщо ви колись натискали посилання, а браузер показував графіку чи інші бінарні дані як ASCII або пропонував завантажити вебсторінку, це означає, що типи mime браузера або сервера були налаштовані неправильно.
Для усунення несправності подивіться на заголовок Content-Type в інструментах розробника браузера (вкладка Network):
image: src /blog/wp-content/uploads/2017/12/FTSurmm-e1513109444640.jpg (unchanged); alt: Заголовок Content-Type у HTTPFox
Ми бачимо, що у відповіді сервера вказано правильний content-type. Якби браузер пропонував зберегти запитане зображення із запиту get, ми б знали, що тип mime браузера для image/jpeg потрібно переналаштувати.
Неправильні налаштування серверних скриптів або бінарних типів mime можуть призвести до проблем безпеки на сервері чи клієнті.
IANA (Internet Assigned Numbers Authority) відповідає за ведення офіційного реєстру типів медіа зі статусом RFC.
(hr)
Характеристики HTTP (h2, class anchor-holder)
У цьому розділі ми обговоримо характеристики протоколу HTTP. Найважливіші поняття, які слід знати, працюючи з HTTP:
- HTTP є stateless
- HTTP не пропонує вбудованого шифрування
Що таке stateless-протокол?
HTTP є stateless за задумом: кожен запит несе все, що потрібно серверу, щоб на нього відповісти. Проте HTTP не є протоколом без з'єднання. HTTP/1.1 і HTTP/2 тримають TCP-з'єднання відкритими й повторно використовують їх для багатьох запитів, а HTTP/3 робить те саме поверх QUIC.
Stateless просто означає, що HTTP-транзакції запитує user-agent, а відповідає на них веб-сервер. Якщо клієнт не кешує запитані ресурси, він має знову видати той самий метод, щоб отримати ресурс. HTTP веб-сервер не має таблиці станів, щоб подивитися попередні взаємодії з user-agent.
Cookies HTTP: cookies можуть допомогти веб-серверу посилатися на минулі HTTP-взаємодії з user-agent. Сам протокол залишається stateless: кожен запит самостійний, навіть коли подорожує повторно використаним з'єднанням.
Більшість серверних мов програмування, як-от фреймворк Django для Python, PHP і ASP .Net, пропонують бібліотеки для підтримки стану застосунку з вбудованими механізмами сесій. Цей підхід додає веб-застосунку stateful-поведінку, але абстрагований на вищому рівні, ніж HTTP.
HTTP не забезпечує шифрування
Сам HTTP не надає вбудованих механізмів шифрування. Шифрування залишено іншим протоколам, що визначають HTTPS. HTTPS використовує Transport Layer Security, або TLS, наступник SSL.
TLS працює з багатьма протоколами, не лише з HTTP. HTTPS спроєктований для перенесення даних вмісту HTTP і заголовків HTTP через захищені TLS-з'єднання. SSL спочатку розробила Netscape у 1990-х. Пізніше IETF стандартизувала його наступника як TLS. Усі версії SSL нині застарілі; актуальними є TLS 1.2 і TLS 1.3.
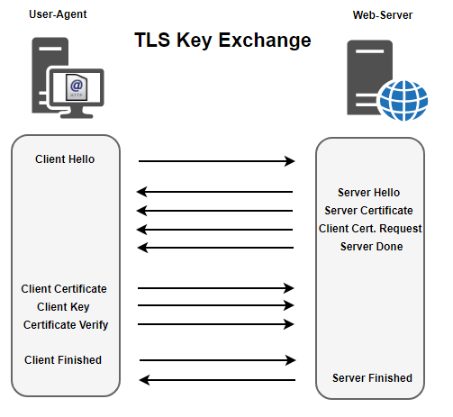
Уважний читач може спитати: «Тож HTTPS є stateful? Так? Кожна сесія має ключ? Так?». Так, ключі кешуються клієнтом. Але TLS усе ще працює на нижчому рівні, ніж HTTP-ядро HTTPS. Взаємодія з веб-сервером досі використовує ті самі методи HTTP: GET, POST, PUT і DELETE.
(hr)
Автентифікація HTTP
Автентифікація, на відміну від шифрування, вбудована в HTTP. HTTP підтримує кілька типів автентифікації, зокрема:
- Basic
- Bearer
- Digest
- HOBA
- Mutual
- Negotiate
- OAuth
- SCRAM-SHA1
- SCRAM-SHA256
- vapid
Basic Authentication
Безумовно найпоширенішим методом автентифікації HTTP є Basic Authentication. Basic Authentication поширена, бо її просто реалізувати, а не тому, що вона безпечна. Інші схеми автентифікації безпечніші, а Basic Authentication слід використовувати лише через HTTPS.
Найбільша проблема безпеки Basic Authentication полягає в тому, що облікові дані надсилаються відкритим текстом. Хоч облікові дані кодуються в Base-64, кодування не є шифруванням, у найкращому разі це обфускація. Облікові дані легко скомпрометувати, коли не використовується TLS або коли TLS-трафік стає жертвою атаки «людина посередині».
Недоліки Basic Authentication:
- кодує облікові дані лише в BASE 64
- облікові дані кешуються в браузері, залишаючи ще один вектор атаки
- облікові дані можуть зберігатися в браузері постійно
- шахрайські proxy-сервери потенційно можуть логувати облікові дані
- облікові дані містяться в HTTP-заголовку
BASIC Authentication усе ж має своє призначення. Проте важливо визнати межі цього призначення. Basic Authentication годиться лише для контролю доступу. Контроль доступу призначений просто для керування доступом до ресурсів. Basic Authentication не годиться для захисту даних. Особливо чутливої інформації, розкриття якої може обернутися втратою доходу або приватності.
Впроваджуючи схему автентифікації HTTP, думайте про Basic Authentication як про кодовий замок, що дозволяє авторизований вхід у будівлю чи офіс лише тоді, коли на місці є охорона. Після робочих годин ті самі двері замикаються надійнішим механізмом, щоб захистити будівлю.
- контроль доступу є зручним доступом для авторизованого персоналу
- безпека тримає майно захищеним від зловмисників
Нижче ілюстрація запиту й відповіді Basic Authentication:
image: src /blog/wp-content/uploads/2017/12/fvNIZLj-e1513109471712.jpg (unchanged); alt: Basic Authentication 1
image: src /blog/wp-content/uploads/2017/12/Svu1sFi-e1513109482792.jpg (unchanged); alt: Basic Authentication 2
- User-Agent робить запит документа
- Веб-сервер відповідає HTTP-кодом 401: Authorization Required
- User-Agent повторює запит з обліковими даними
- Веб-сервер дозволяє або відхиляє доступ залежно від дійсності облікових даних
Як демонстрацію недоліків Basic Authentication спробуйте з'ясувати облікові дані із зображеного рядка в кодуванні BASE64.
Автентифікація на основі bearer-токенів
Автентифікація на основі bearer-токенів популярна серед постачальників фреймворків автентифікації. Bearer Authentication також можна розгорнути як окреме рішення для конкретного екземпляра.
Bearer Authentication базується на токенах і використовується у фреймворках OAuth і OpenID. Зазвичай OAuth використовується для авторизації, а OpenID для автентифікації. Проте існує кілька сірих зон, що розмивають межі між автентифікацією та авторизацією в кожному фреймворку.
- OpenID надає федеративну автентифікацію або послуги входу
- OAuth надає делеговану авторизацію
GitHub надає посібник з OAuth для розробників сторонніх застосунків, які хочуть отримувати доступ до ресурсів GitHub від імені кінцевого користувача. Посібник GitHub з OAuth App
Великі постачальники ідентичності, такі як Google, пропонують вхід через OpenID Connect, чинний стандарт OpenID, побудований на OAuth 2.0.
Вхід через OpenID Connect з обліковим записом Google:
image: src /blog/wp-content/uploads/2017/12/BMtbtwA.jpg (unchanged); alt: Google як постачальник автентифікації Open ID
Digest Authentication
Digest Authentication безпечніша за Basic Authentication. Проте Digest Authentication усе ще недостатня для захисту чутливих матеріалів в Інтернеті. Digest Authentication не шифрує облікові дані, вона їх хешує, і якщо ці хеші перехоплено, зловмисник може запустити офлайн-атаку перебором або за словником.
Обидві схеми автентифікації, Digest і Basic, вважаються слабкими в загальній картині безпеки даних. Кожна має вади, і кожну успішно атакували. Коли потрібно більше, ніж базовий контроль доступу чи авторизація, слід розгорнути безпечнішу схему автентифікації.
Інші схеми автентифікації на основі HTTP
NTLM, відома як NT Lan Manager Authentication, є технологією Microsoft із плагінами для багатьох сторонніх продуктів, операційних систем і служб.
У доменах Windows бажаним вибором є Negotiate, який використовує Kerberos і повертається до NTLM лише коли мусить; Microsoft поступово виводить NTLM з ужитку. З Kerberos користувачі домену, які вже увійшли, можуть отримувати доступ до дозволених ресурсів, не вводячи облікові дані знову.
Найбільші недоліки автентифікації на основі NTLM:
- її може бути незручно впроваджувати на платформах, відмінних від Windows
- може втратити багато функцій безпеки, якщо розгорнута поза доменом Windows
- NTLM настільки ж безпечна, наскільки безпечна корпоративна мережа
- старіші версії NTLM вважаються небезпечними
SCRAM-SHA1 і SCRAM-SHA256
SCRAM є акронімом від Salted Challenge Response Authentication Mechanism
Коли потрібно автентифікувати внутрішніх співробітників, автентифікація SCRAM у поєднанні з OpenLDAP може бути гарним рішенням для середовищ з обладнанням різних виробників.
SCRAM може бути складнішим у розгортанні, ніж NTLM для домену Windows. Але SCRAM може бути чудовим вибором у мережі з клієнтами Linux, MacOS Server, Windows і Unix і навіть через Інтернет.
- Related reading: Повний посібник з кодів стану HTTP. Серія 300
З архіву блогу EuroVPS, уперше опубліковано 12 грудня 2017 р..
Усі нотатки з практики