

Temos opinião sobre hardware para que não precise de a ter.
Normalizar as decisões aborrecidas de infraestrutura é o serviço. Faz do que executa a única variável que resta na sala.
Neste artigo 4 secções
- Normalizámos as camadas que nunca deviam ser decididas ao acaso: storage HPE 3PAR all-flash, Brocade Fibre Channel duplo, a nossa própria rede, a nossa própria computação.
- Normalização não é rigidez. Só nos desviamos quando o seu trabalho o merece, e construímos a exceção porque a base é conhecida de cor.
- Uma stack bem compreendida resolve as avarias mais depressa do que dez improvisadas. É por isso que isto se vê no seu uptime.
Abra um formulário de encomenda de servidor típico e conte as decisões que lhe pede para tomar. Escalão de storage. Nível de RAID. Bonding das placas de rede. Backplane. Hypervisor. Destino do backup. Modo de replicação. Cada uma é uma bifurcação, e cada bifurcação que lhe é entregue é trabalho de casa.
h2 (#choice-is-a-cost): A escolha é um custo
Um configurador longo parece generoso, mas cada escolha nele é sua. Escolhe o escalão de storage, e se os IOPS se revelarem errados para a sua base de dados, a escolha foi sua. Cada opção que seleciona passa a ser sua para explicar quando o alarme dispara às 3 da manhã.
Achamos que isso está ao contrário. A infraestrutura por baixo da sua aplicação não é onde devia estar a expressar individualidade. É onde quer o menor número de surpresas. Por isso tomámos essas decisões uma vez, deliberadamente, e respondemos por cada uma delas. O que configura connosco é o que executa. Tudo o que está por baixo, já o resolvemos.
As decisões que tirámos do seu prato são as que falham silenciosamente durante meses e depois todas de uma vez. Normalizá-las não é inflexibilidade da nossa parte. É assumirmos um risco que nos cabe a nós avaliar.
h2 (#what-we-standardized): O que normalizámos, e porquê
h3 (#storage): Storage: HPE 3PAR all-flash
O block storage vive em HPE 3PAR all-flash, active-active dentro do site com Peer Persistence, e replicado para um segundo site. Não é um escalão para o qual se faz upgrade. O bom storage é o único storage. Pode vê-lo na página de private cloud, e a parede de discos está nas fotografias da nossa página sobre nós, porque é a nossa parede, não a de um banco de imagens.
h3 (#fabric): Fabric: Brocade Fibre Channel duplo
O storage chega à computação por Brocade Fibre Channel duplo, com multipath. Os fabrics Brocade fazem parte da doutrina há mais de uma década e nunca saíram.
h3 (#network): Rede: a nossa
O seu tráfego viaja na nossa própria rede: o nosso próprio sistema autónomo, peering bilateral no GR-IX, Cisco ASR 9000 series no edge e Nexus 9000 leaf-spine por baixo, com EVPN/VXLAN a talhar um fabric real por tenant no nosso próprio silício.
h3 (#compute): Computação: os nossos próprios servidores
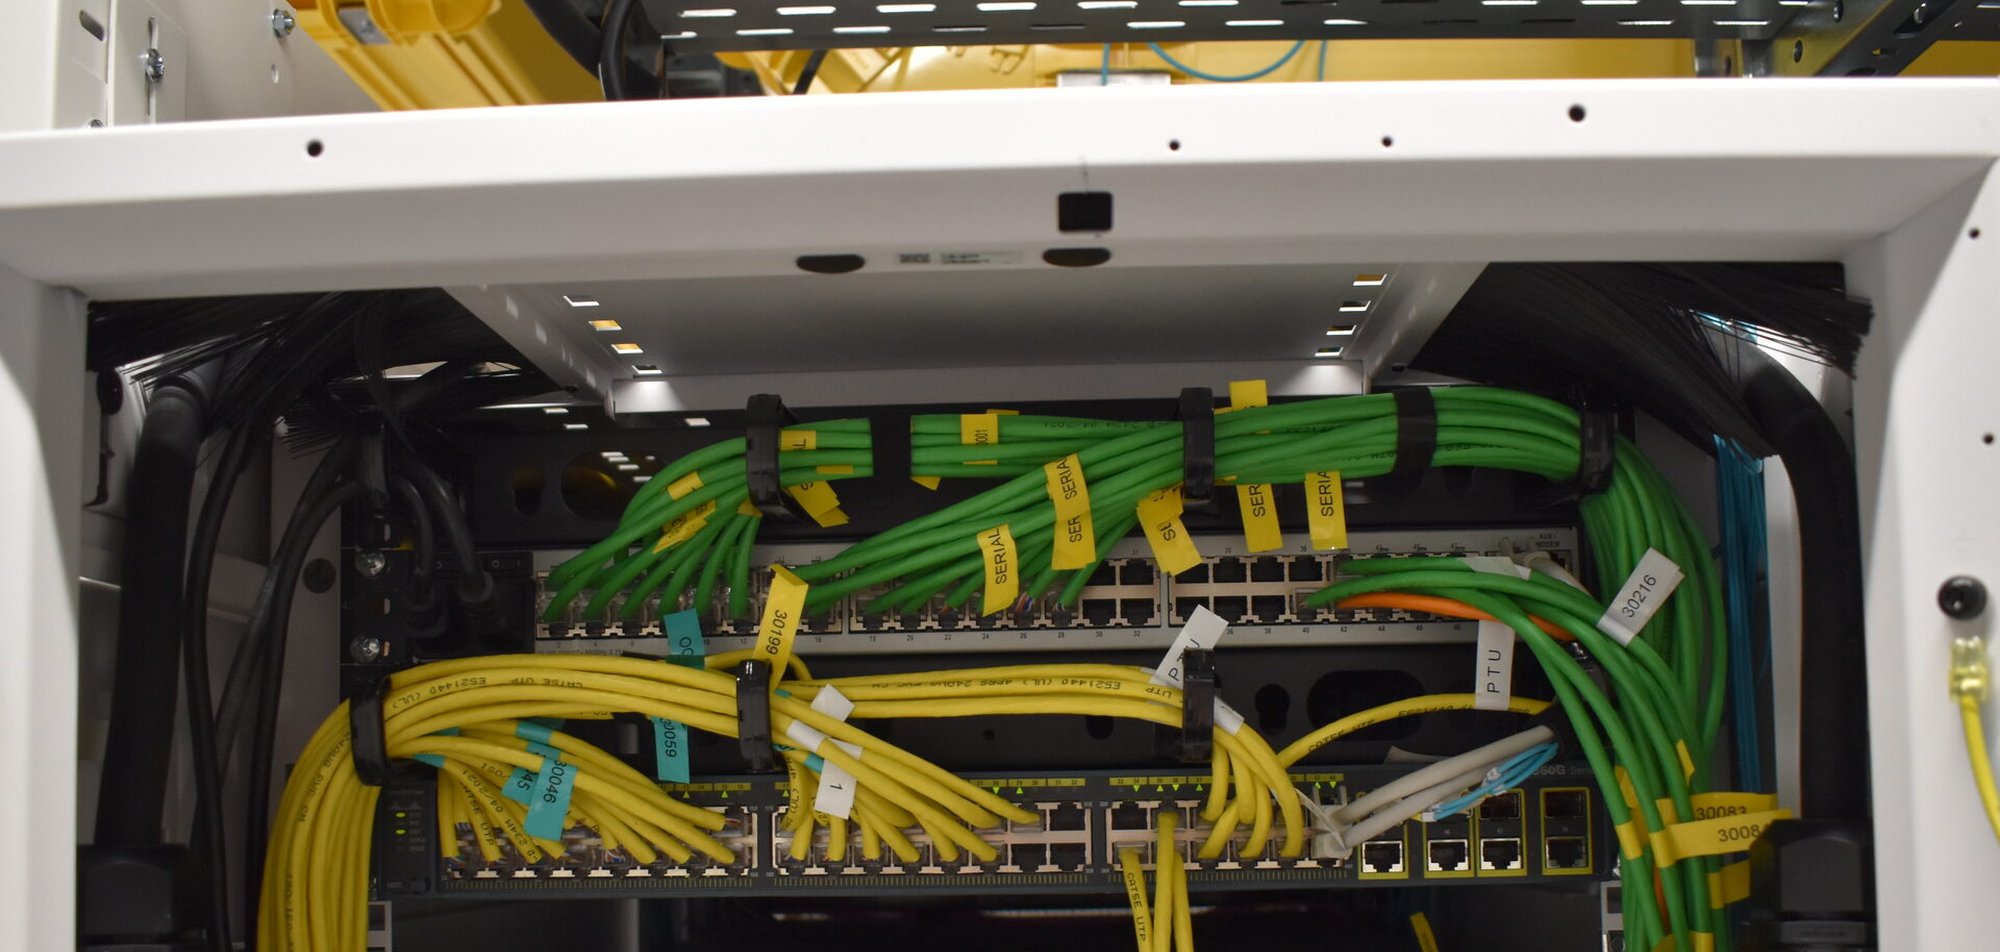
As máquinas são nossas: computação HPE e Dell numa cage que construímos e etiquetamos nós próprios. Ser donos do equipamento é o que nos permite responder pela fiabilidade que vendemos, e o nosso pertence-nos desde 2004.
- REDE PRÓPRIA
- o nosso próprio sistema autónomo, do edge ao spine
- PEERING NO GR-IX
- bilateral, no exchange
- HPE 3PAR FEDERATION
- all-flash, active-active dentro do site, replicado para um segundo site
- FABRIC POR TENANT
- EVPN/VXLAN, isolado por tenant
h2 (#deviate-when-earned): Só nos desviamos quando o seu trabalho o merece
Nada disto significa que a resposta é sempre a mesma máquina. Significa que o ponto de partida é. A normalização é o que torna possível uma exceção a sério: porque sabemos exatamente como a base se comporta, conseguimos dizer com precisão onde o que executa a deixa para trás e construir o desvio de propósito, não às cegas. Quatro sockets quando o trabalho precisa de quatro. Uma private cloud à medida quando o objetivo de fiabilidade o merece. A exceção é projetada, não improvisada, e isso só é verdade quando a regra é sólida.
h2 (#shows-up-in-uptime): Porque é que isto se vê no seu uptime
A fiabilidade não é um componente que se compra. É o que acontece quando uma avaria encontra uma stack que o engenheiro de prevenção já compreende.
Um alarme dispara às 3 da manhã. Para o que está a olhar o engenheiro de prevenção?
Um primeiro encontro, de cada vez
Cada cliente improvisou uma stack diferente, por isso cada avaria é um primeiro encontro, e os primeiros encontros são lentos.
Uma avaria que já resolveu antes
O mesmo fabric, storage e rede por baixo de todos. O engenheiro já viu exatamente esta classe de avaria. A superfície é familiar, por isso a correção é rápida.
Respostas diretas
Posso trazer a minha própria preferência de hardware?+
Pode dizer-nos o que o trabalho precisa e construiremos para isso, até à máquina de referência e para lá dela. O que não pode fazer é reduzir as partes que normalizámos para cortar custos, porque essas são as partes que falham sem aviso e levam o seu uptime com elas. Desviamo-nos quando o que executa o merece, não quando corta um canto.
Alguma vez operam storage que não seja 3PAR?+
A 3PAR federation é a base para tudo o que precisa de fiabilidade a sério, e é o que fotografamos e publicamos. Se uma carga de trabalho genuinamente não precisa de federated block storage, dizemo-lo e apresentamos um preço sem ele em vez de lhe vender storage que não vai usar. A resposta honesta às vezes aponta para baixo.
A minha máquina é partilhada com alguém?+
Em hardware dedicado, não. O número de série está na sua fatura, e os seus núcleos são os seus núcleos. Numa private cloud, o fabric do seu tenant está isolado por EVPN/VXLAN. De qualquer das formas, o isolamento é real, não uma definição.
Então o que é que eu decido, afinal?+
O que executa: qual o tamanho do trabalho, como cresce e que objetivo de fiabilidade tem de atingir. Essa é a única bifurcação que sempre foi sua. O assistente de dimensionamento de dedicated propõe-lhe algo mais pequeno se estiver a apontar demasiado alto, e o caminho da private cloud existe para quando o objetivo de fiabilidade o merece.
Temos opinião sobre hardware por uma razão: para que nunca precise de a ter. Dimensione o que executa e deixe o resto resolvido. O caminho da private cloud está lá quando o objetivo de fiabilidade o merece, e o pedigree por trás de tudo isto está na página sobre nós.
Veja o metal que normalizámos.
A configuração de referência, o hardware por trás dela, e o preço que é o mesmo no próximo ano.
Ver o metalChegou ao fim.
Ponha a leitura em prática
O que executa?
Fale-nos da carga de trabalho, do tráfego e dos requisitos de recuperação. Comece pelo configurador de servidores ou discuta os detalhes com um engenheiro.
Escrito pelos engenheiros que constroem e operam a infraestrutura que descreve.Fale com um engenheiro