

Qué comprobar en un servidor nuevo antes de que lleve producción
Comprobaciones de aceptación para un servidor dedicado nuevo: memoria, discos, caché RAID, detección de flash, enlaces agregados, doble alimentación y acceso remoto, con comandos.
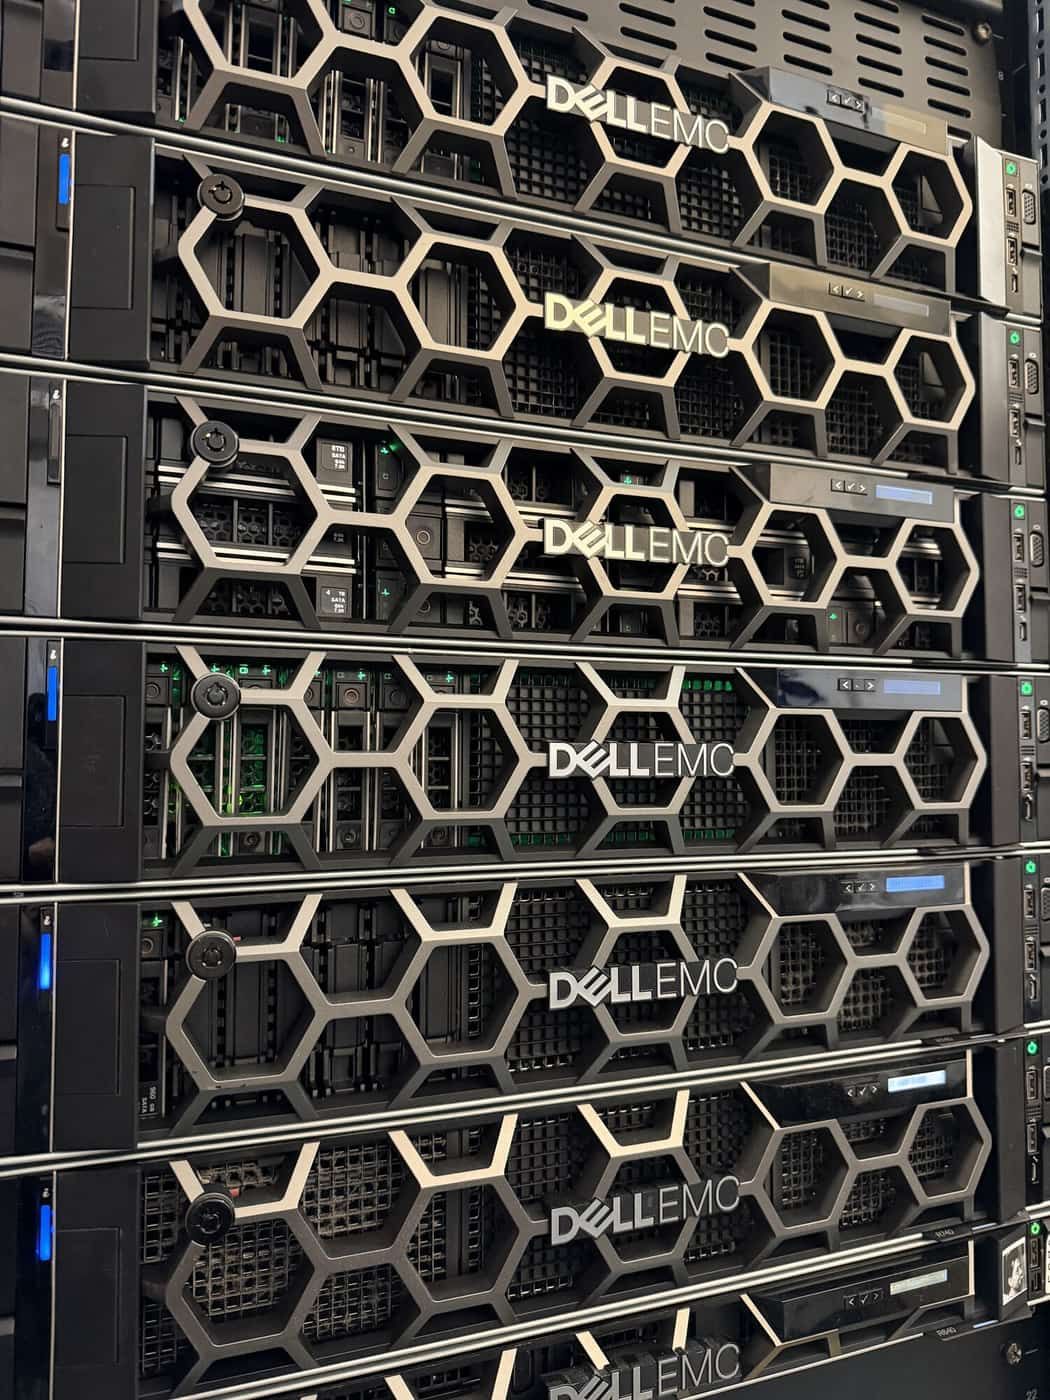
Un servidor dedicado nuevo suele llegar con un sistema operativo, un inicio de sesión y una suposición: que todo lo que pagó está presente, sano y configurado para usarse. La mayoría de las veces eso es casi cierto. La distancia entre casi y del todo es de donde salen las bases de datos lentas, los enlaces de red ociosos y las caídas sorpresa. Esta es la comprobación de aceptación que creemos que todo servidor merece antes de llevar producción, con los comandos para hacerla usted mismo.
Por qué se saltan las pruebas de aceptación
Un servidor que arranca parece terminado. El sistema operativo no se queja de un módulo de memoria que no ve, de una caché RAID que funciona sin su batería, ni de un bond que envía cada paquete por un solo enlace. Cada uno de estos es invisible en el uso normal y caro después, y cada uno lleva minutos comprobarlo el primer día. Tras la puesta en producción, las mismas comprobaciones necesitan una ventana de mantenimiento.
Memoria: toda, equilibrada, sin errores
Confirme que el sistema ve cada módulo que pidió, y que están en una disposición equilibrada entre los canales de memoria de cada procesador. Una disposición desequilibrada funciona, pero más despacio de lo que debería.
dmidecode -t memory | grep -E 'Size|Locator' | grep -v 'No Module'
free -h
ras-mc-ctl --errors
Los errores de memoria corregidos en los primeros días de vida de un servidor son una razón para sustituir un módulo ahora, mientras es fácil, no una curiosidad que observar.
Discos y la controladora RAID
Lea la salud de cada unidad, incluidas las escondidas tras una controladora RAID por hardware, y el estado de la caché de escritura de la controladora:
smartctl -a /dev/sda
smartctl -a -d megaraid,0 /dev/sda    # a drive behind a MegaRAID-family controller
storcli64 /c0 show all                # Dell PERC and LSI family
ssacli ctrl all show config detail    # HPE Smart Array
Busque contadores distintos de cero de sectores reasignados, pendientes o errores de medio en cualquier unidad. Una unidad nueva con un error corregido es una unidad cuya propia corrección de errores ya está trabajando duro. En la controladora, confirme que la unidad lógica es el nivel RAID que pidió, que la caché está en modo write-back y que el módulo de batería o de caché respaldada por flash informa que está sano. Una controladora que ha caído a write-through por culpa de su batería puede hacer que un array de SSD se sienta como disco giratorio.
Después mida el rendimiento en el volumen vacío antes de que contenga datos, con una herramienta como fio, para tener una referencia con la que comparar más adelante.
¿Se trata la flash como flash?
Las controladoras RAID por hardware muchas veces no pasan al kernel el indicador de estado sólido, así que un volumen construido con SSD se informa como disco giratorio y recibe ajustes afinados para medios giratorios:
lsblk -d -o NAME,ROTA,SCHED,MODEL
cat /sys/block/sda/queue/read_ahead_kb
Si ROTA dice 1 en un volumen que sabe que es flash, confirme primero el tipo de medio desde la controladora, y después corríjalo con una regla udev para que sobreviva a los reinicios:
# /etc/udev/rules.d/60-ssd-tunings.rules
ACTION=="add|change", KERNEL=="sda", ATTR{queue/rotational}="0"
ACTION=="add|change", KERNEL=="sda", ATTR{queue/scheduler}="mq-deadline"
ACTION=="add|change", KERNEL=="sda", ATTR{queue/read_ahead_kb}="16"
ACTION=="add|change", KERNEL=="sda", ATTR{queue/nr_requests}="1024"
udevadm control --reload && udevadm trigger --action=change /sys/block/sdaNo aplique esto a un volumen sobre discos duros. Una lectura anticipada corta conviene a la flash y perjudica las lecturas secuenciales de medios giratorios.
Red: dos enlaces, ambos funcionando
Un servidor con dos puertos agregados muchas veces está usando uno de ellos. El hash de transmisión por defecto del driver de bonding de Linux solo mira direcciones MAC, y en un datacenter, donde un host habla con un puñado de MAC de pasarelas y de pares, eso puede poner casi todos los flujos en el mismo enlace.
cat /proc/net/bonding/bond0
ethtool -S <first port> | grep -E 'tx_packets|rx_packets'
ethtool -S <second port> | grep -E 'tx_packets|rx_packets'
Compruebe que ambos miembros están arriba, que LACP se ha asociado con el switch, y que la política de hash es la que pretendía. Bajo carga, los contadores de ambos miembros deberían crecer a ritmos similares. Para la mayoría de los servidores, hacer el hash sobre direcciones IP y puertos reparte el tráfico mucho mejor:
nmcli con mod bond0 bond.options "mode=802.3ad,miimon=100,lacp_rate=slow,xmit_hash_policy=layer3+4"Iguale el lado del switch, para que el tráfico se reparta de la misma forma en ambas direcciones. Después desconecte un cable, confirme que el servidor sigue accesible, vuelva a conectarlo, y repítalo con el otro.
Alimentación, hora y acceso remoto
ipmitool sdr type "Power Supply"
chronyc tracking
getenforce
Ambas fuentes de alimentación deberían estar presentes y alimentadas, y deberían alimentarse de acometidas eléctricas distintas. Un servidor con dos fuentes enchufadas a la misma acometida tiene un único punto de fallo con pasos adicionales. Confirme que la controladora fuera de banda (iLO, iDRAC o IPMI) es accesible en su red de gestión y tiene licencia para la consola remota que necesitará. Si SELinux forma parte de su estándar, confirme que está en enforcing antes de instalar la primera aplicación, no después.
Escríbalo
La última comprobación es la documentación: número de serie, posición en el rack, cada puerto con su dirección MAC y a qué se conecta, cada dirección IP, ambas acometidas eléctricas y los identificadores de los cables.
Cómo lo hacemos nosotros
Nuestros servidores dedicados son plataformas HPE ProLiant y Dell PowerEdge, con gestión fuera de banda en una red aislada. Cada construcción RAID recibe una pasada de salud de las unidades y una prueba de rendimiento antes de entregarse. La flash detrás de una controladora RAID recibe el ajuste anterior, según el tipo de medio leído de las unidades. Cada bond hace el hash sobre direcciones y puertos, igualado en el switch. Comprobamos los contadores por puerto para demostrar que ambos enlaces llevan tráfico.
Si tiene un servidor ya en producción que nunca pasó esta comprobación, no es demasiado tarde, y con gusto la recorremos con usted.
CTA
Related
Relacionado: Servidores bare metal en HPE y Dell · Ingeniería de rendimiento y capacidad · Storage SAN enterprise en HPE 3PAR, all-flash
Publicado el 28 de septiembre de 2026.
Todas las notas de campo