

Was wir tun · Storage und Compute: Disaster Recovery und standortübergreifende Replikate
Für kritische Systeme halten wir eine laufend aktualisierte Kopie an einem zweiten Standort vor, sodass die Wiederherstellung ein Failover ist und kein Restore, und wir entwerfen den Replikationspfad, die Firewall-Haltung rundherum und das Monitoring, das uns in dem Moment alarmiert, in dem die Kopie zurückfällt.
Was es ist
Ein Wiederherstellungskonzept, das zum bestellten Dienst passt. Ein kleiner, einfacher Dienst bekommt solide Backups und einen getesteten Weg zurück. Eine Plattform, die nicht ausfallen darf, bekommt Live-Replikate in einem anderen Rechenzentrum, zwischen Arrays replizierten Storage und ein Frontend, das weiterliefert, während das Backend sich erholt. Recovery Point und Recovery Time folgen dem Dienst, und wir schreiben Ihre fest.
Wie wir es bauen
Live-Datenbankreplikate an einem zweiten Standort. Eine Produktionsdatenbank repliziert kontinuierlich, per globaler Transaktions-ID, auf ein schreibgeschütztes Replikat in einem anderen Rechenzentrum über unser verschlüsseltes privates Backbone.
Pull-only, an der Firewall durchgesetzt. Die geschützte Seite pusht nie. Die Replikations- und Backup-Systeme greifen in die Produktion hinein und holen, was sie brauchen, und Backups laufen über unser physisch getrenntes (air-gapped) Out-of-Band-Netz, nie über ein Produktionssegment; die Produktion hat keinen Netzwerkpfad zu ihnen und keine Zugangsdaten für sie. Nur unser Managementnetz darf die Recovery-Systeme erreichen, alles andere wird auf den Firewall-Appliances explizit verweigert, nicht nur auf den Hosts.
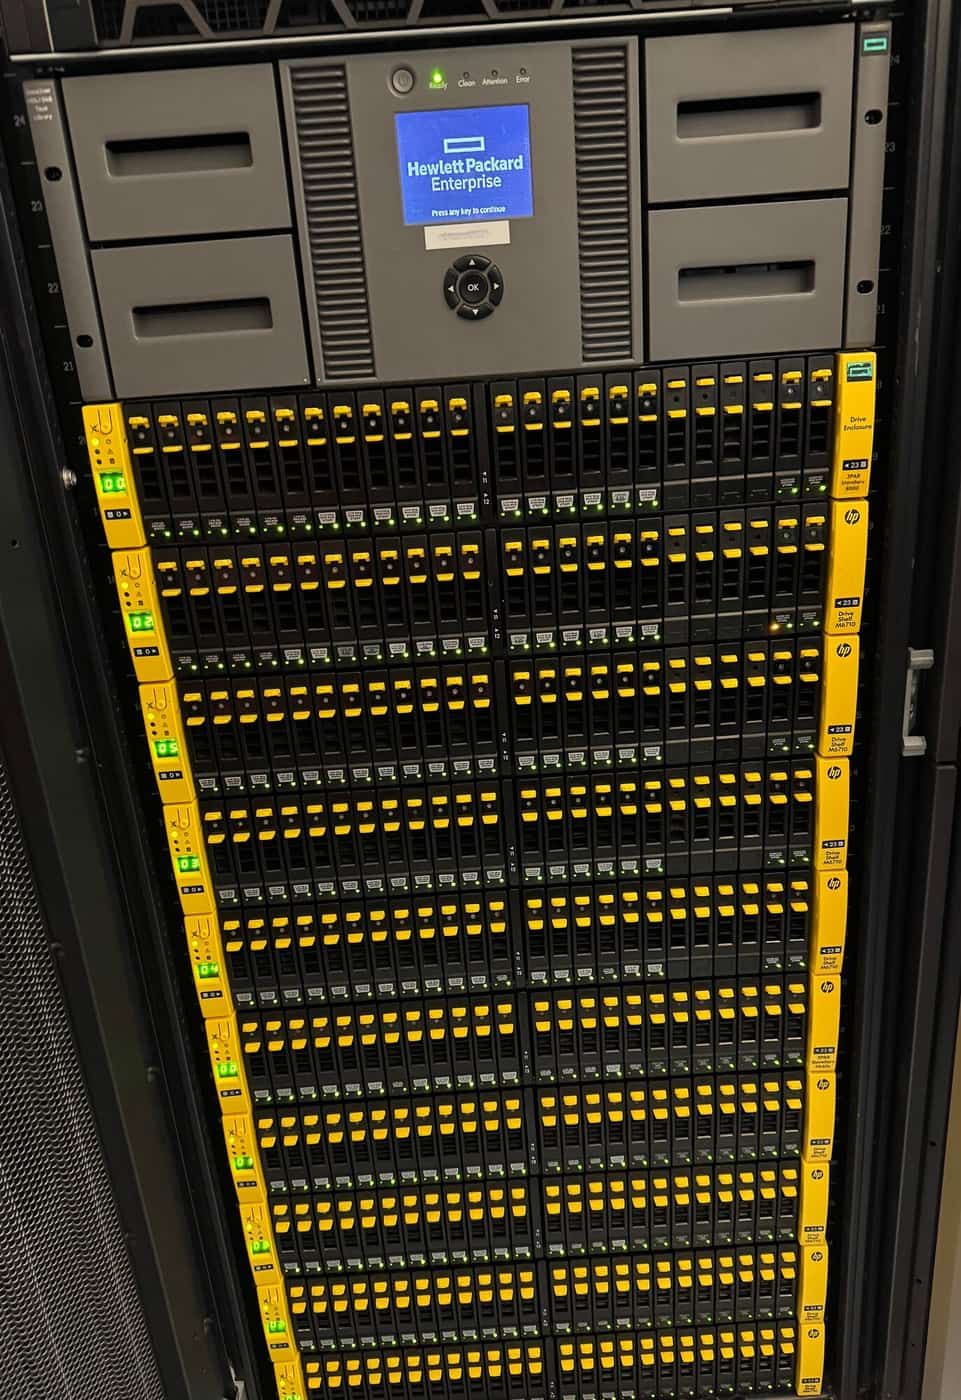
Storage zwischen Ländern repliziert. Darunter können Volumes Array zu Array zwischen HPE 3PAR Arrays in Athen und Amsterdam replizieren, über dedizierte Ports, sodass eine Block-Kopie Ihrer Plattform im anderen Rechenzentrum bereits existiert. Innerhalb jedes Standorts halten geclusterte Systeme jedes Mitglied auf einem anderen physischen Array.
EU-Daten bleiben in der EU. Replikate und Backups von in der EU gehosteten Daten bleiben innerhalb unserer EU-Infrastruktur.
Verschlüsselt im Ruhezustand, mit Zertifikat gelöscht. Verschlüsselung im Ruhezustand ist standardmäßig verfügbar. Laufwerke, die außer Dienst gehen, werden mit Blancco bereinigt, und wir bewahren das PDF-Löschzertifikat für jede Platte auf, die wir löschen.
Wachsam bei Drift. Der Zustand der Replikation wird alle paar Minuten geprüft, und jede Zustandsänderung, ob unterbrochen, verzögert oder wiederhergestellt, löst einen Alarm bei den diensthabenden Ingenieuren aus.
Weiterliefern durch einen Backend-Ausfall. Für öffentliche Webauftritte ist die Cache-Schicht so konfiguriert, dass sie Inhalte weiter ausliefert, wenn die Anwendungsschicht ausfällt, damit ein Backend-Fehler kein öffentlicher Ausfall wird, während wir wiederherstellen.
Die Backups unter allem
Wir sichern virtuelle Maschinen, Bare-Metal-Server unter Linux und Windows, SQL-Server sowie cPanel- und Plesk-Knoten mit Veeam, und Linux-Datei- und Datenbankdaten mit einem deduplizierenden Backup-Hub, der per SSH mit eingeschränkten, Append-only-Schlüsseln abholt. Repositories laufen auf XFS mit Fast Cloning und einer gehärteten Repository-Stufe, die die Kopieraufträge empfängt. Zeitpläne werden aus gemessenen Laufzeiten gesetzt, damit große Aufträge nie kollidieren, die Abdeckung wird gegen das laufende Inventar geprüft, nicht dem Auftragsstatus geglaubt, und Restores werden regelmäßig getestet, bis zu wöchentlich.
Wovor es Sie schützt
- Vor dem Verlust Ihres primären Datenbank-Hosts oder Ihres primären Standorts.
- Vor Ransomware oder einem Eindringling, der Ihre Backups vom kompromittierten Server aus löscht.
- Vor Replikat-Drift: der Zustand jedes Replikats wird alle paar Minuten geprüft.
- Davor, dass ein Anwendungsausfall zu einem öffentlichen Ausfall wird.
- Vor Lücken in der Backup-Abdeckung: jede Maschine, die gesichert sein sollte, ist es, und wir prüfen das gegen das, was läuft.
In der Praxis
Eine Nachrichtenseite lieferte weiter, mit abgeschaltetem Backend. Für einen Nachrichtenverlag haben wir die Cache-Schicht so konfiguriert, dass sie bei Fehlern einen ganzen Tag lang veraltete Inhalte ausliefert, und es dann bewiesen: das Backend wurde absichtlich als ausgefallen markiert, und die gecachten Seiten kamen bei den Lesern normal an.
Ein Datenbankcluster, entworfen für den Verlust eines Arrays. Für einen Analytics-Kunden liegt das Datenvolume jedes Clustermitglieds auf einem anderen physischen Array, sodass der Verlust eines ganzen Arrays ein Replikat kostet und die Datenbank ohne jedes Failover weiterliefert.
Warum EuroVPS
- Pull-only-Backup und -Replikation, an der Firewall durchgesetzt, ohne Ausnahmen.
- Wiederherstellung pro Dienst entworfen und dokumentiert.
- Replikate und Backups auf Aktualität überwacht, nicht angenommen.
- Array-zu-Array-Replikation zwischen Athen und Amsterdam, mit EU-Daten innerhalb der EU.
- Design ausgerichtet an ISO 27001, NIS2 und den NIST-Leitlinien zum Schutz von Netzgrenzen.
Häufige Fragen
- Welche RPO und RTO bekomme ich? Das hängt vom bestellten Dienst ab. Basisdienste bekommen Backups und einen definierten Restore-Pfad; Dienste mit standortübergreifender Abdeckung bekommen Live-Replikate und Failover. Wir schreiben Ihre fest.
- Warum Pull-only? Könnte die Produktion zum Backup pushen, könnte ein Angreifer auf der Produktion das Backup erreichen. Mit Pull-only existiert dieser Pfad nicht.
- Kann mein Replikat in einem anderen Land liegen? Ja. Athen und Amsterdam replizieren zueinander, Array zu Array und Datenbank zu Datenbank, über unser eigenes privates Netz. In der EU gehostete Daten bleiben innerhalb unserer EU-Infrastruktur.
- Testen Sie Restores? Ja, regelmäßig, bis zu wöchentlich, und wir prüfen die Abdeckung gegen das, was tatsächlich läuft, nicht gegen das, was der Backup-Auftrag meldet.
- Sind meine Daten im Ruhezustand verschlüsselt? Ja, standardmäßig. Und wenn ein Laufwerk außer Dienst geht, wird es mit Blancco bereinigt, mit einem Löschzertifikat, das für diese Platte aufbewahrt wird.
- closing line: Wiederherstellung wird vor dem schlechten Tag entworfen, nicht währenddessen. Sprechen Sie mit einem Ingenieur darüber, was Ihre Dienste brauchen.
- CTA: Mit einem Ingenieur sprechen
Ihr nächster Infrastrukturpartner
Sehen wir uns Ihre Umgebung an.
Erzählen Sie uns, was Sie heute betreiben und was besser werden muss. Ein Ingenieur sieht Ihre Anfrage durch und hilft Ihnen, den nächsten Schritt zu planen.
+357 222 32280
Beginnen wir mit Ihrer Umgebung.
Ein wenig Kontext hilft uns, das richtige Gespräch zu beginnen.