

Ce que nous faisons · Données et web: Constructions de plateformes haute disponibilité
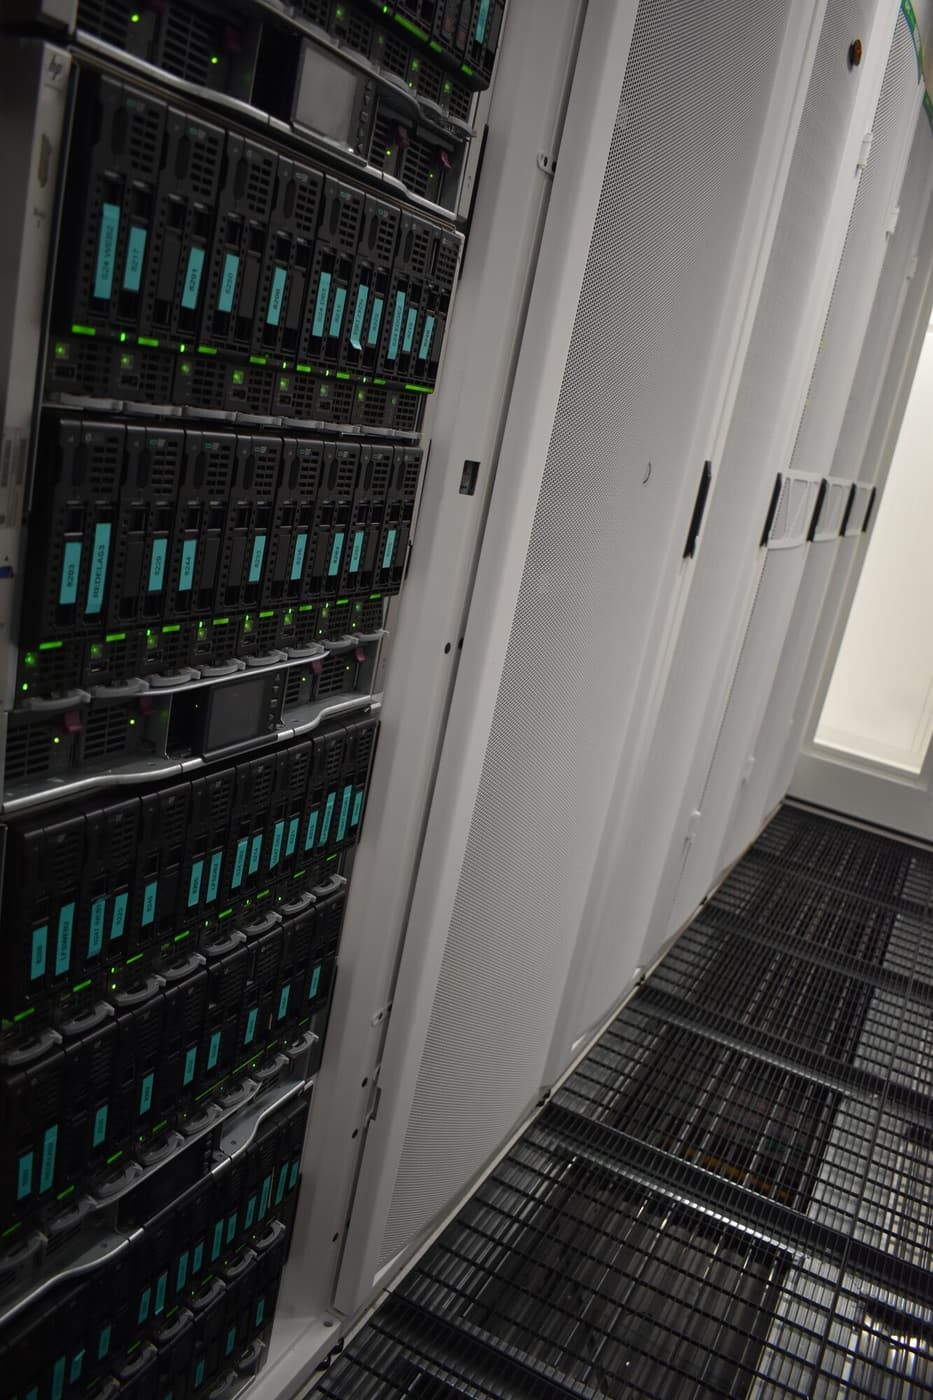
Nous concevons et construisons des plateformes complètes (edge, application, base de données, cache, streaming et analytique) de sorte que n'importe quel hôte, n'importe quelle baie de stockage ou n'importe quel châssis puisse tomber tandis que chaque service continue de tourner. Puis nous le prouvons, tier par tier, avant votre mise en production.
De quoi il s'agit
Une plateforme entière conçue comme un seul système, plutôt qu'une collection de serveurs qui se trouvent se parler. Nous partons de la forme réelle de votre charge de travail : combien elle lit et écrit, comment elle croît, ce qui ne doit jamais s'arrêter. Nous la livrons sur notre private cloud OLVM, sur bare metal ou sur OpenShift (OKD), à Athènes ou Amsterdam chez Digital Realty, ou à Toronto.
Comment nous le construisons
Dimensionnée pour la charge. Les hôtes sont choisis pour la tâche : mono-socket là où la charge est limitée par la mémoire et les E/S, mémoire peuplée pour la pleine bande passante. Les VM ne reçoivent jamais plus de cœurs qu'un socket CPU n'en possède, parce qu'une VM à cheval sur deux sockets paie une pénalité de mémoire distante à chaque accès et tourne souvent moins vite qu'une plus petite.
Chaque tier à quorum est à trois, et réparti. Les tiers base de données, cache, coordination, streaming et load balancer comptent chacun trois membres avec une anti-affinity stricte, un par hôte. Le disque de données de chaque membre se trouve sur une baie de stockage différente. Perdre un hôte coûte un réplica ; perdre une baie coûte un réplica ; le quorum tient dans les deux cas.
Des composants éprouvés pour chaque rôle :
- Données transactionnelles sur Percona XtraDB Cluster, avec routage ProxySQL et une adresse flottante.
- Analytique sur ClickHouse, répliqué trois fois avec des nœuds de coordination Keeper dédiés.
- Cache sur Valkey avec failover Sentinel.
- Streaming sur Redpanda, avec un facteur de réplication de trois.
- Edge sur HAProxy avec keepalived en disposition VRRP croisée, les deux adresses actives.
- Tier applicatif sans état et extensible horizontalement.
Sur OpenShift. Nous construisons OKD et OpenShift sur bare metal avec un plan de contrôle à trois nœuds sur des serveurs indépendants et Rook-Ceph pour le stockage partagé, de sorte que le contenu web vit sur un stockage répliqué plutôt que sur un unique serveur NFS. Le quorum des moniteurs Ceph est dimensionné pour que deux pannes d'hôte simultanées laissent le stockage intact. Les bases Galera tournent en StatefulSets avec anti-affinity entre châssis et un PodDisruptionBudget, de sorte que les mises à jour de la plateforme et les redémarrages glissants ne peuvent jamais casser le quorum de la base. Les adresses des load balancers viennent de MetalLB sur de vrais VLAN.
Testée, puis vérifiée par quelqu'un d'autre. Chaque tier est testé en failover avant la livraison : nous arrêtons le writer, le primaire du cache, un edge, un hôte. La construction est ensuite vérifiée depuis une autre machine que celle qui l'a bâtie, face à la plateforme réelle plutôt qu'aux notes de construction.
Ce dont il vous protège
- Une plateforme où une base de données, un cache ou un nœud d'analytique est un point unique de défaillance.
- Une baie de stockage ou un châssis blade qui emporte toute la plateforme avec lui.
- Des mises à jour glissantes de Kubernetes qui cassent le quorum de la base.
- Des VM dimensionnées à cheval sur les frontières NUMA, qui coûtent plus et tournent moins vite.
- Découvrir pour la première fois comment le failover se comporte pendant une vraie panne.
En pratique
Une plateforme d'analytique construite pour la panne. Pour l'activité d'analytique d'un client, nous avons bâti six tiers sur des hôtes séparés et des baies all-flash séparées : ClickHouse avec des Keepers dédiés, Percona XtraDB Cluster avec ProxySQL et keepalived, Valkey avec Sentinel, Redpanda, un edge HAProxy à double adresse et un tier applicatif sans état. À la livraison, nous avons mesuré le failover de l'edge à environ cinq secondes dans chaque sens, la promotion du cache à environ sept secondes, et la perte du writer absorbée par ProxySQL avec l'application toujours en écriture.
OpenShift sur bare metal, prêt pour la production. Avant qu'une plateforme OKD ou OpenShift ne reçoive des charges de clients, une revue de pré-production vérifie le quorum du stockage face à deux pannes d'hôte simultanées et met en place des PodDisruptionBudgets pour les charges de chaque tenant avant même que la première maintenance de nœud ne soit planifiée.
Pourquoi EuroVPS
- Nous concevons les domaines de panne à travers les hôtes, les baies et les châssis, pas seulement « deux de tout ».
- Chaque tier est testé en failover et les temps mesurés vous sont remis.
- Une seule équipe possède le matériel, le stockage, le réseau et la plateforme.
- Un dimensionnement conscient de NUMA comme règle maison.
- PodDisruptionBudgets et anti-affinity sont notre standard sur Kubernetes dès la première construction, pas quelque chose ajouté plus tard.
Questions fréquentes
- Machines virtuelles ou OpenShift ? Cela dépend de votre équipe et de votre application. Les stacks traditionnelles tournent à merveille sur des VM ; les équipes qui livrent déjà des conteneurs tirent le plus d'OpenShift. Nous vous aidons à décider.
- Pouvez-vous construire selon notre propre architecture de référence ? Oui. Nous la passons en revue selon nos règles de domaines de panne et proposons des changements là où une panne unique pourrait encore faire tomber un tier.
- Qui exploite la plateforme après la livraison ? Nous pouvons tout exploiter, l'infrastructure seule, ou la remettre à votre équipe avec documentation et support.
- Combien de temps prend une construction ? Une plateforme multi-tiers complète prend typiquement des semaines plutôt que des jours, la plupart consacrées aux décisions de conception et aux tests.
- Testez-vous avec notre application ? Oui. Les tests de failover tournent avec votre application connectée, pour que les résultats reflètent ce que vos utilisateurs verraient.
Vous construisez quelque chose qui doit rester en ligne ? Parler à un ingénieur.
Votre prochain partenaire d'infrastructure
Examinons votre environnement.
Dites-nous ce que vous faites tourner aujourd'hui et ce qui doit s'améliorer. Un ingénieur examinera votre demande et vous aidera à planifier la suite.
+357 222 32280
Commençons par votre environnement.
Un peu de contexte nous aide à démarrer la bonne conversation.