

O que fazemos · Dados e web: Construção de plataformas de alta disponibilidade
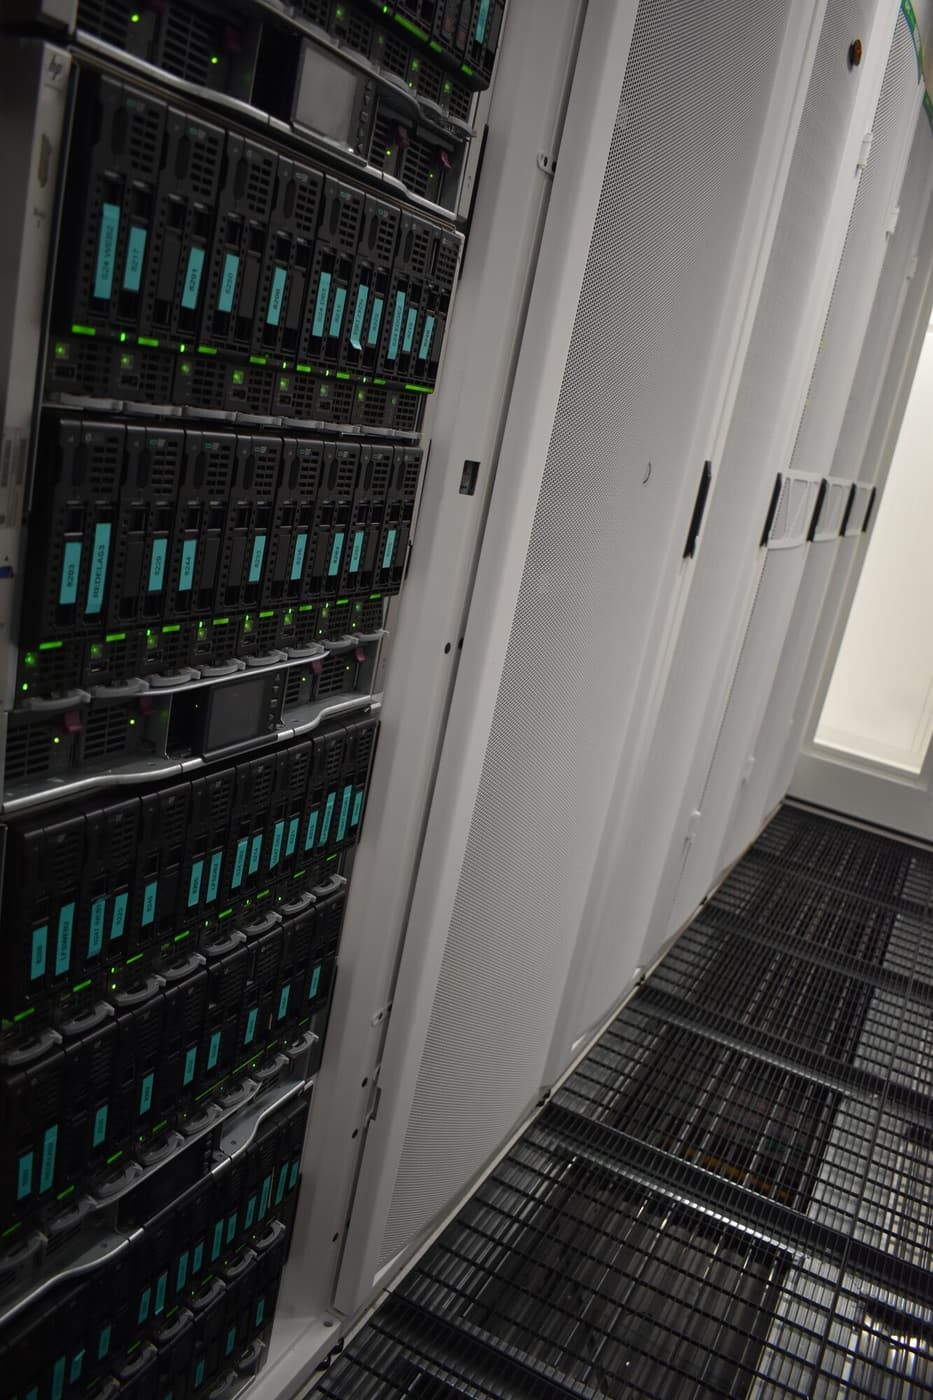
Desenhamos e construímos plataformas completas (edge, aplicação, base de dados, cache, streaming e analytics) de modo a que qualquer host, qualquer array de storage ou qualquer chassis possa falhar individualmente e todos os serviços continuem a correr. Depois provamo-lo, camada a camada, antes de entrar em produção.
O que é
Uma plataforma inteira concebida como um único sistema, e não como um conjunto de servidores que por acaso falam uns com os outros. Partimos da forma real do que executa: quanto lê e escreve, como cresce, o que nunca pode parar. Entregamo-la na nossa private cloud OLVM, em bare metal ou em OpenShift (OKD), em Atenas ou Amesterdão no Digital Realty, ou em Toronto.
Como o construímos
Dimensionada à carga de trabalho. Os hosts são escolhidos para a função: socket único onde a carga é limitada por memória e I/O, memória totalmente povoada para largura de banda completa. As VM nunca recebem mais núcleos do que um socket de CPU tem, porque uma VM que se estende por dois sockets paga uma penalização de memória remota em cada acesso e corre muitas vezes mais devagar do que uma mais pequena.
Cada camada com quorum é de três, e distribuída. As camadas de base de dados, cache, coordenação, streaming e load balancer correm cada uma com três membros e anti-affinity rígida, um por host. O disco de dados de cada membro fica num array de storage diferente. Perder um host custa uma réplica; perder um array custa uma réplica; o quorum mantém-se em ambos os casos.
Componentes comprovados para cada função:
- Dados transacionais em Percona XtraDB Cluster, com encaminhamento ProxySQL e um endereço flutuante.
- Analytics em ClickHouse, com replicação tripla e nós de coordenação Keeper dedicados.
- Cache em Valkey com failover por Sentinel.
- Streaming em Redpanda, com um replication factor de três.
- Edge em HAProxy com keepalived numa disposição VRRP cruzada, com ambos os endereços ativos.
- Camada de aplicação stateless e escalável horizontalmente.
Em OpenShift. Construímos OKD e OpenShift em bare metal com um control plane de três nós em servidores independentes e Rook-Ceph para storage partilhado, para que o conteúdo web viva em storage replicado e não num único servidor NFS. O quorum dos monitors Ceph é dimensionado para que duas falhas de host simultâneas deixem o storage intacto. As bases de dados Galera correm como StatefulSets com anti-affinity entre chassis e um PodDisruptionBudget, para que as atualizações da plataforma e os reinícios rolantes nunca possam quebrar o quorum da base de dados. Os endereços de load balancer vêm do MetalLB em VLAN reais.
Testada, e depois verificada por outra pessoa. Cada camada é testada em failover antes da entrega: paramos o writer, o primário da cache, um edge, um host. A construção é depois verificada a partir de uma máquina diferente daquela que a construiu, contra a plataforma em produção e não contra as notas de construção.
Do que o protege
- Uma plataforma em que uma base de dados, uma cache ou um nó de analytics é um single point of failure.
- Um array de storage ou um chassis de blades que leva a plataforma inteira consigo.
- Atualizações rolantes do Kubernetes que quebram o quorum da base de dados.
- VM dimensionadas para lá das fronteiras NUMA, que custam mais e correm mais devagar.
- Descobrir como o failover se comporta pela primeira vez durante uma falha real.
Na prática
Uma plataforma de analytics construída para a falha. Para o negócio de analytics de um cliente construímos seis camadas em hosts separados e arrays all-flash separados: ClickHouse com Keepers dedicados, Percona XtraDB Cluster com ProxySQL e keepalived, Valkey com Sentinel, Redpanda, um edge HAProxy de endereço duplo e uma camada de aplicação stateless. Na entrega medimos o failover do edge em cerca de cinco segundos em cada sentido, a promoção da cache em cerca de sete segundos, e a perda do writer absorvida pelo ProxySQL com a aplicação a continuar a escrever.
OpenShift em bare metal, pronto para produção. Antes de uma plataforma OKD ou OpenShift receber cargas de clientes, uma revisão de pré-produção verifica o quorum do storage contra duas falhas de host simultâneas e coloca PodDisruptionBudgets para as cargas de cada tenant antes de a primeira manutenção de nó ser sequer agendada.
Porquê a EuroVPS
- Desenhamos failure domains entre hosts, arrays e chassis, não apenas «dois de tudo».
- Cada camada é testada em failover e os tempos são-lhe entregues.
- Uma única equipa é dona do hardware, do storage, da rede e da plataforma.
- Dimensionamento consciente de NUMA como regra da casa.
- PodDisruptionBudgets e anti-affinity são o nosso padrão em Kubernetes desde a primeira construção, não algo acrescentado mais tarde.
Perguntas frequentes
- Máquinas virtuais ou OpenShift? Depende da sua equipa e da sua aplicação. As stacks tradicionais correm muito bem em VM; as equipas que já entregam containers ganham mais com o OpenShift. Ajudamos a decidir.
- Podem construir segundo a nossa própria arquitetura de referência? Sim. Analisamo-la face às nossas regras de failure domains e sugerimos alterações onde uma única falha ainda pudesse derrubar uma camada.
- Quem opera a plataforma depois da entrega? Podemos operá-la por inteiro, apenas a infraestrutura, ou entregá-la à sua equipa com documentação e suporte.
- Quanto tempo demora uma construção? Uma plataforma multicamada completa demora normalmente semanas e não dias, a maior parte gasta em decisões de desenho e testes.
- Testam com a nossa aplicação? Sim. Os testes de failover correm com a sua aplicação ligada, para que os resultados reflitam o que os seus utilizadores veriam.
A construir algo que tem de se manter de pé? Fale com um engenheiro.
O seu próximo parceiro de infraestrutura
Vamos analisar a sua infraestrutura.
Diga-nos o que executa hoje e o que precisa de melhorar. Um engenheiro vai analisar o seu pedido e ajudar a planear o passo seguinte.
+357 222 32280
Comecemos pela sua infraestrutura.
Um pouco de contexto ajuda-nos a começar a conversa certa.