

Cosa facciamo · Dati e web: Costruzione di piattaforme ad alta disponibilità
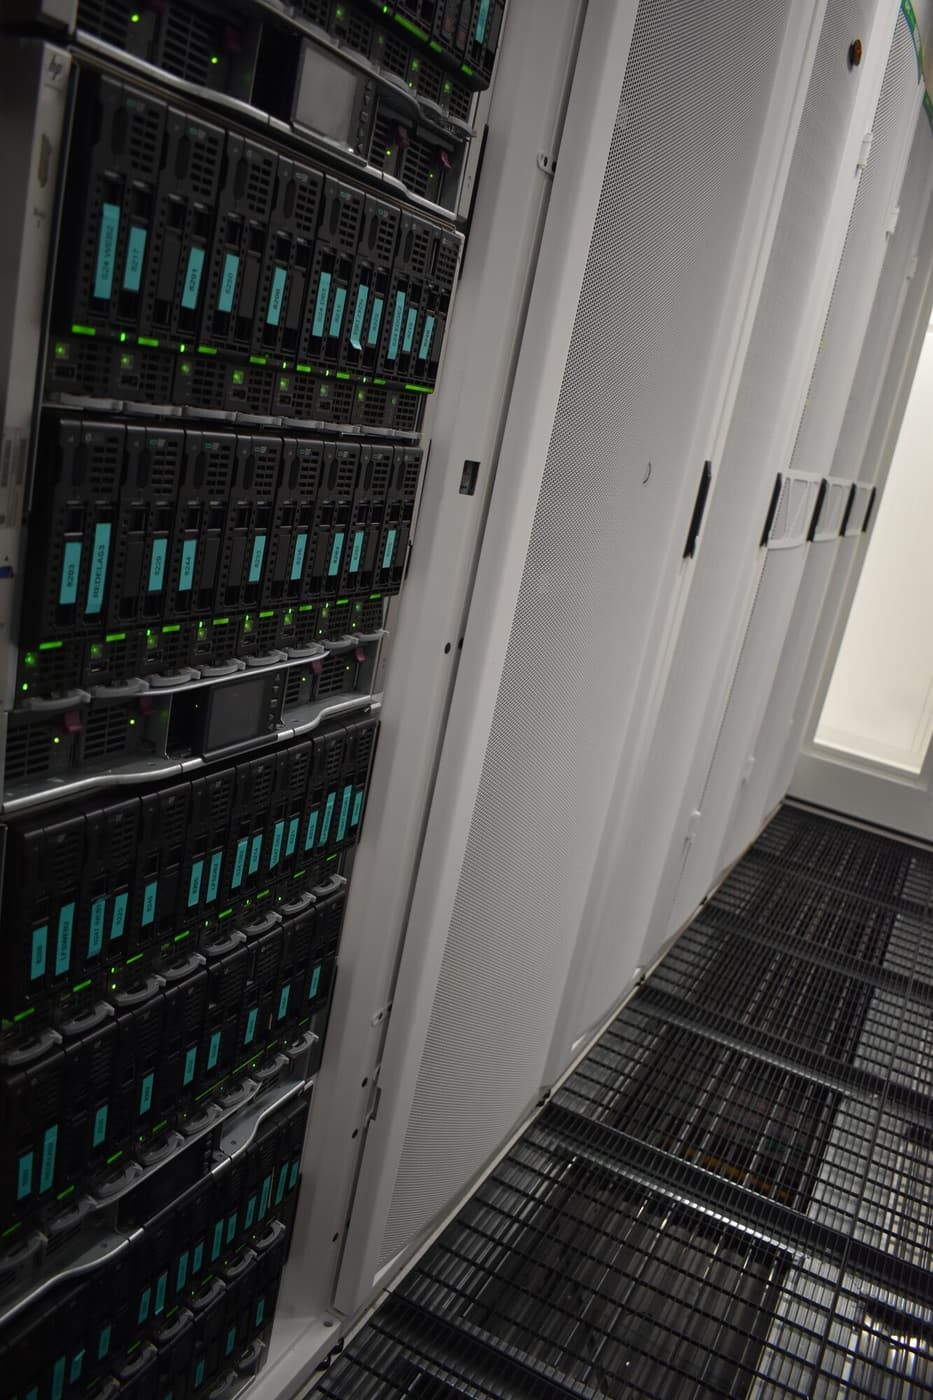
Progettiamo e costruiamo piattaforme complete (edge, applicazione, database, cache, streaming e analytics) in modo che qualsiasi singolo host, qualsiasi singolo array di storage o qualsiasi singolo chassis possa guastarsi e ogni servizio continui a girare. Poi lo dimostriamo, livello per livello, prima che andiate in produzione.
Cos'è
Un'intera piattaforma progettata come un unico sistema, invece di una collezione di server che per caso si parlano. Partiamo dalla forma reale del vostro carico di lavoro: quanto legge e scrive, come cresce, che cosa non deve mai fermarsi. La consegniamo sul nostro private cloud OLVM, su bare metal o su OpenShift (OKD), ad Atene o Amsterdam presso Digital Realty, oppure a Toronto.
Come lo costruiamo
Dimensionata sul carico di lavoro. Gli host vengono scelti per il compito: socket singolo dove il carico è limitato da memoria e I/O, memoria popolata per la piena banda. Le VM non ricevono mai più core di quanti ne abbia un singolo socket CPU, perché una VM che si estende su più socket paga una penalità di memoria remota a ogni accesso e spesso gira più lenta di una più piccola.
Ogni livello a quorum è tre, e distribuito. I livelli database, cache, coordinamento, streaming e load balancer girano ciascuno con tre membri in anti-affinity rigida, uno per host. Il disco dati di ogni membro sta su un array di storage diverso. Perdere un host costa una replica; perdere un array costa una replica; il quorum regge in entrambi i casi.
Componenti collaudati per ogni compito:
- Dati transazionali su Percona XtraDB Cluster, con instradamento ProxySQL e un indirizzo floating.
- Analytics su ClickHouse, replicato in tre copie con nodi Keeper dedicati al coordinamento.
- Cache su Valkey con failover Sentinel.
- Streaming su Redpanda, con fattore di replica tre.
- Edge su HAProxy con keepalived in configurazione VRRP incrociata, entrambi gli indirizzi attivi.
- Livello applicativo stateless e scalabile orizzontalmente.
Su OpenShift. Costruiamo OKD e OpenShift su bare metal con un control plane a tre nodi su server indipendenti e Rook-Ceph per lo storage condiviso, così i contenuti web vivono su storage replicato invece che su un singolo server NFS. Il quorum dei monitor Ceph è dimensionato perché due guasti simultanei di host lascino lo storage intatto. I database Galera girano come StatefulSet con anti-affinity tra chassis e un PodDisruptionBudget, così aggiornamenti di piattaforma e riavvii a rotazione non possono mai rompere il quorum del database. Gli indirizzi dei load balancer arrivano da MetalLB su VLAN reali.
Testata, poi verificata da qualcun altro. Ogni livello viene testato in failover prima della consegna: fermiamo il writer, il primario della cache, un edge, un host. La build viene poi verificata da una macchina diversa da quella che l'ha costruita, contro la piattaforma viva e non contro gli appunti di build.
Da cosa vi protegge
- Una piattaforma in cui un database, una cache o un nodo di analytics è un single point of failure.
- Un array di storage o uno chassis blade che si porta via l'intera piattaforma.
- Rolling update di Kubernetes che rompono il quorum del database.
- VM dimensionate a cavallo dei confini NUMA, che costano di più e girano più lente.
- Scoprire come si comporta il failover per la prima volta durante un guasto reale.
In pratica
Una piattaforma di analytics costruita per il guasto. Per l'attività di analytics di un cliente abbiamo costruito sei livelli su host separati e array all-flash separati: ClickHouse con Keeper dedicati, Percona XtraDB Cluster con ProxySQL e keepalived, Valkey con Sentinel, Redpanda, un edge HAProxy a doppio indirizzo e un livello applicativo stateless. Alla consegna abbiamo misurato il failover dell'edge in circa cinque secondi in ciascuna direzione, la promozione della cache in circa sette secondi, e la perdita del writer assorbita da ProxySQL con l'applicazione che continuava a scrivere.
OpenShift su bare metal, pronto per la produzione. Prima che una piattaforma OKD o OpenShift prenda carichi dei clienti, una revisione di pre-produzione controlla il quorum dello storage contro due guasti simultanei di host e mette in atto i PodDisruptionBudget per i carichi di ogni tenant, prima ancora che venga pianificata la prima manutenzione di un nodo.
Perché EuroVPS
- Progettiamo i failure domain tra host, array e chassis, non solo «due di tutto».
- Ogni livello viene testato in failover e i tempi vi vengono consegnati.
- Un solo team possiede hardware, storage, rete e piattaforma.
- Dimensionamento NUMA-aware come regola di casa.
- PodDisruptionBudget e anti-affinity sono il nostro standard su Kubernetes fin dalla prima build, non qualcosa aggiunto dopo.
Domande frequenti
- Macchine virtuali o OpenShift? Dipende dal vostro team e dalla vostra applicazione. Gli stack tradizionali girano benissimo su VM; i team che già rilasciano container traggono il massimo da OpenShift. Vi aiutiamo a decidere.
- Potete costruire secondo la nostra architettura di riferimento? Sì. La rivediamo rispetto alle nostre regole sui failure domain e suggeriamo modifiche dove un singolo guasto potrebbe ancora fermare un livello.
- Chi gestisce la piattaforma dopo la consegna? Possiamo gestirla tutta, solo l'infrastruttura, oppure consegnarla al vostro team con documentazione e assistenza.
- Quanto dura una build? Una piattaforma multilivello completa richiede tipicamente settimane e non giorni, per lo più spese in decisioni di progetto e test.
- Testate con la nostra applicazione? Sì. I test di failover girano con la vostra applicazione collegata, così i risultati riflettono quello che vedrebbero i vostri utenti.
State costruendo qualcosa che deve restare in piedi? Parla con un ingegnere.
Il vostro prossimo partner per l'infrastruttura
Guardiamo la vostra infrastruttura.
Raccontateci cosa fate girare oggi e cosa deve migliorare. Un ingegnere esaminerà la vostra richiesta e vi aiuterà a pianificare il passo successivo.
+357 222 32280
Partiamo dalla vostra infrastruttura.
Un po' di contesto ci aiuta a iniziare la conversazione giusta.