

Що ми робимо · Дані та web: Побудова платформ високої доступності
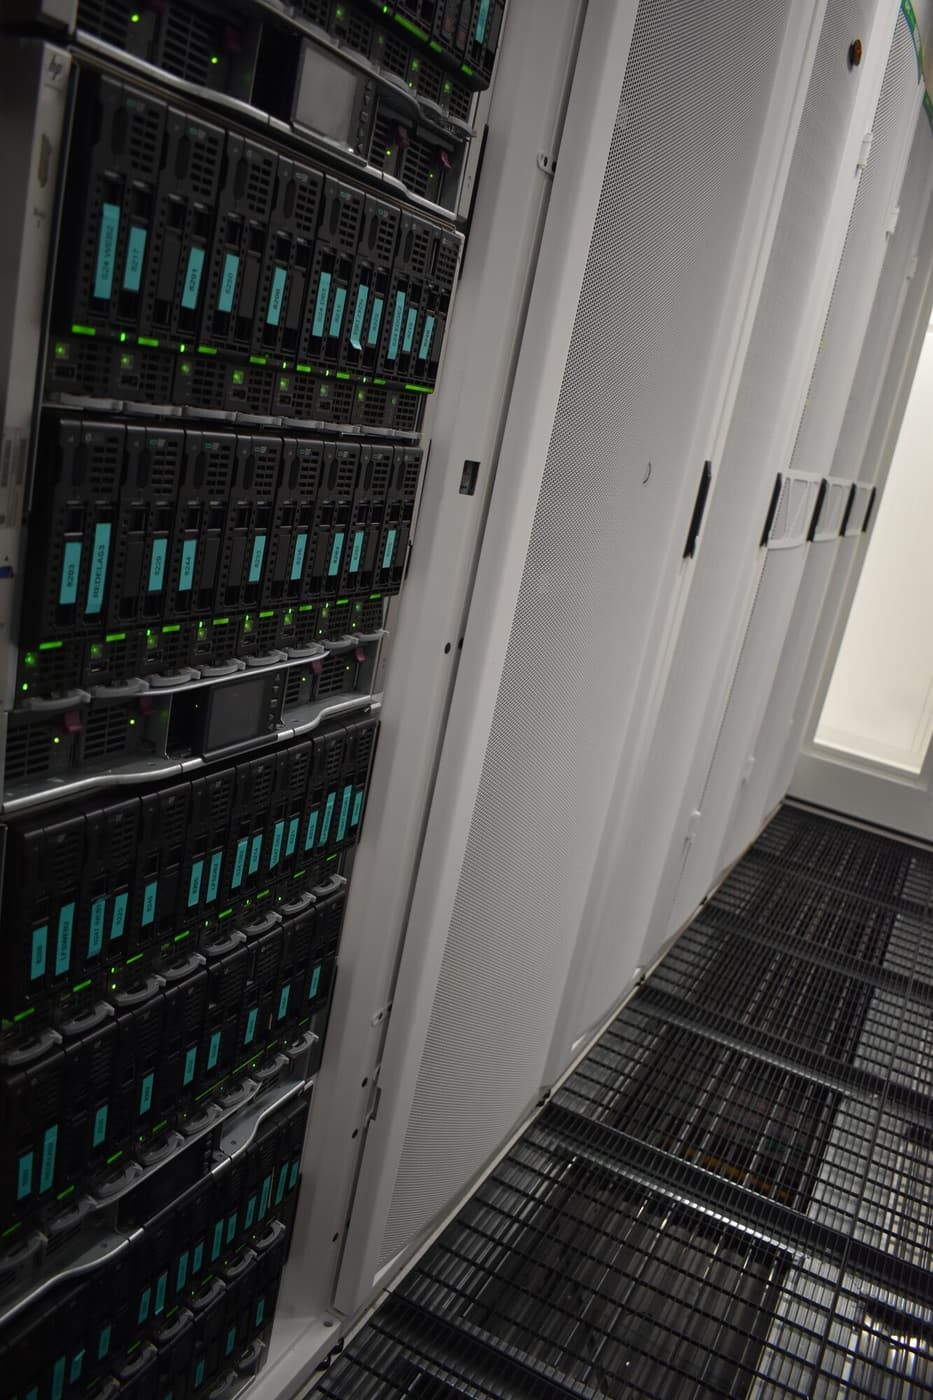
Ми проєктуємо й будуємо повні платформи (edge, застосунки, бази даних, кеш, стримінг і аналітика) так, щоб будь-який окремий хост, будь-який окремий масив сховища чи будь-яке окреме шасі могли відмовити, а кожен сервіс продовжував працювати. Потім ми це доводимо, рівень за рівнем, до вашого запуску.
Що це
Ціла платформа, спроєктована як одна система, а не набір серверів, які випадково спілкуються між собою. Ми виходимо з реальної форми вашого навантаження: скільки воно читає і пише, як зростає, що ніколи не має зупинятися. Ми постачаємо її на нашому private cloud на OLVM, на bare metal або на OpenShift (OKD), в Афінах чи Амстердамі в Digital Realty або в Торонто.
Як ми це будуємо
Розмір під навантаження. Хости обираються під завдання: один сокет там, де навантаження обмежене пам’яттю та I/O, пам’ять заповнена для повної пропускної здатності. VM ніколи не отримують більше ядер, ніж має один сокет CPU, бо VM, що охоплює кілька сокетів, платить штраф віддаленої пам’яті при кожному зверненні й часто працює повільніше за меншу.
Кожен рівень із кворумом має три члени, розподілені. Рівні бази даних, кешу, координації, стримінгу та балансувальника працюють по три члени кожен із жорсткою anti-affinity, по одному на хост. Диск із даними кожного члена лежить на іншому масиві сховища. Втрата хоста коштує одну репліку; втрата масиву коштує одну репліку; кворум зберігається в обох випадках.
Перевірені компоненти для кожної роботи:
- Транзакційні дані на Percona XtraDB Cluster, з маршрутизацією ProxySQL і плаваючою адресою.
- Аналітика на ClickHouse, реплікована втричі, з виділеними вузлами координації Keeper.
- Кеш на Valkey з failover через Sentinel.
- Стримінг на Redpanda, з фактором реплікації три.
- Edge на HAProxy з keepalived у перехресній схемі VRRP, обидві адреси активні.
- Рівень застосунків без стану та з горизонтальним масштабуванням.
В OpenShift. Ми будуємо OKD та OpenShift на bare metal із control plane на трьох вузлах на незалежних серверах і Rook-Ceph для спільного сховища, тож web-контент живе на реплікованому сховищі, а не на єдиному сервері NFS. Кворум моніторів Ceph розрахований так, що дві одночасні відмови хостів залишають сховище неушкодженим. Бази даних Galera працюють як StatefulSet із anti-affinity між шасі та PodDisruptionBudget, тому оновлення платформи й поступові перезавантаження ніколи не можуть зламати кворум бази даних. Адреси балансувальників надходять від MetalLB на справжніх VLAN.
Протестовано, потім перевірено кимось іншим. Кожен рівень проходить тест failover перед передачею: ми зупиняємо writer, основний вузол кешу, edge, хост. Потім збірку перевіряють з іншої машини, ніж та, що її будувала, на живій платформі, а не за нотатками збірки.
Від чого це вас захищає
- Платформа, де одна база даних, один кеш або один вузол аналітики є єдиною точкою відмови.
- Масив сховища або blade-шасі, що забирає всю платформу із собою.
- Поступові оновлення Kubernetes, що ламають кворум бази даних.
- VM, розміри яких перетинають межі NUMA і які коштують більше, а працюють повільніше.
- Дізнатися, як поводиться failover, уперше під час справжньої відмови.
На практиці
Аналітична платформа, побудована з розрахунком на відмови. Для аналітичного бізнесу клієнта ми побудували шість рівнів на окремих хостах та окремих all-flash масивах: ClickHouse з виділеними Keeper, Percona XtraDB Cluster із ProxySQL і keepalived, Valkey із Sentinel, Redpanda, edge на HAProxy з двома адресами та рівень застосунків без стану. При передачі ми виміряли failover edge приблизно за п’ять секунд у кожному напрямку, підвищення кешу приблизно за сім секунд, а втрату writer поглинув ProxySQL, поки застосунок продовжував писати.
OpenShift на bare metal, готовий до продуктиву. Перш ніж платформа OKD або OpenShift прийме навантаження клієнтів, передпродуктивний огляд перевіряє кворум сховища проти двох одночасних відмов хостів і встановлює PodDisruptionBudget для навантажень кожного tenant ще до того, як буде заплановано перше обслуговування вузла.
Чому EuroVPS
- Ми проєктуємо домени відмов між хостами, масивами та шасі, а не просто «всього по два».
- Кожен рівень проходить тест failover, а виміряні часи передаються вам.
- Одна команда відповідає за обладнання, сховище, мережу та платформу.
- Розміри з урахуванням NUMA як домашнє правило.
- PodDisruptionBudget та anti-affinity є нашим стандартом у Kubernetes з першої збірки, а не чимось доданим згодом.
Часті запитання
- Віртуальні машини чи OpenShift? Залежить від вашої команди та вашого застосунку. Традиційні стеки чудово працюють на VM; команди, які вже постачають контейнери, найбільше виграють від OpenShift. Ми допомагаємо вам вирішити.
- Чи можете ви будувати за нашою власною референсною архітектурою? Так. Ми звіряємо її з нашими правилами доменів відмов і пропонуємо зміни там, де одна відмова все ще могла б вивести з ладу рівень.
- Хто експлуатує платформу після передачі? Ми можемо експлуатувати все, лише інфраструктуру, або передати її вашій команді з документацією та підтримкою.
- Скільки триває побудова? Повна багаторівнева платформа зазвичай займає тижні, а не дні, і більшість цього часу йде на проєктні рішення та тестування.
- Чи тестуєте ви з нашим застосунком? Так. Тести failover виконуються з підключеним вашим застосунком, тож результати відображають те, що побачили б ваші користувачі.
Будуєте щось, що мусить залишатися в роботі? Поговоріть з інженером.
Ваш наступний партнер з інфраструктури
Погляньмо на вашу інфраструктуру.
Розкажіть, що ви запускаєте сьогодні і що потребує покращення. Інженер розгляне ваш запит і допоможе спланувати наступний крок.
+357 222 32280
Почнімо з вашої інфраструктури.
Трохи контексту допомагає нам почати правильну розмову.