

Was wir tun · Daten und Web: Hochverfügbare Plattform-Builds
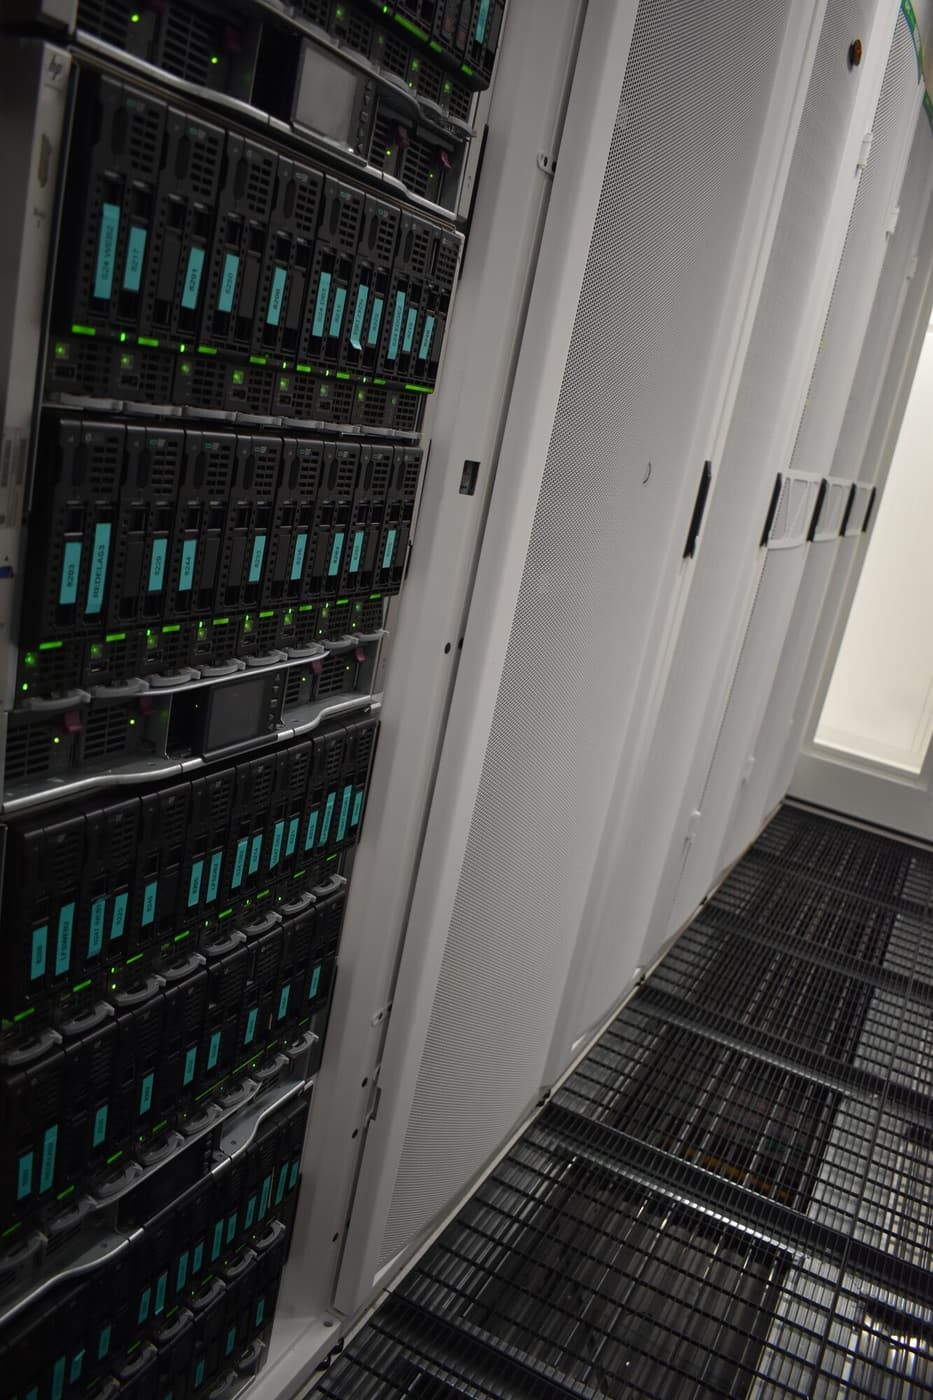
Wir entwerfen und bauen komplette Plattformen (Edge, Anwendung, Datenbank, Cache, Streaming und Analytics) so, dass jeder einzelne Host, jedes einzelne Storage-Array oder jedes einzelne Chassis ausfallen kann und jeder Dienst weiterläuft. Dann beweisen wir es, Ebene für Ebene, bevor Sie live gehen.
Was es ist
Eine ganze Plattform als ein System entworfen, statt einer Sammlung von Servern, die zufällig miteinander sprechen. Wir arbeiten von der realen Form Ihrer Workload aus: wie viel sie liest und schreibt, wie sie wächst, was nie stehen bleiben darf. Wir liefern sie auf unserer OLVM Private Cloud, auf Bare Metal oder auf OpenShift (OKD), in Athen oder Amsterdam bei Digital Realty oder in Toronto.
Wie wir es bauen
Auf die Workload dimensioniert. Hosts werden für die Aufgabe gewählt: ein Sockel, wo die Workload durch Arbeitsspeicher und I/O begrenzt ist, Speicher so bestückt, dass die volle Bandbreite zur Verfügung steht. VMs bekommen nie mehr Kerne, als ein CPU-Sockel hat, denn eine VM über Sockel hinweg zahlt bei jedem Zugriff einen Aufschlag für entfernten Speicher und läuft oft langsamer als eine kleinere.
Jede Quorum-Ebene ist dreifach und verteilt. Datenbank-, Cache-, Koordinations-, Streaming- und Load-Balancer-Ebenen laufen jeweils mit drei Mitgliedern und harter Anti-Affinity, eines pro Host. Die Datenplatte jedes Mitglieds liegt auf einem anderen Storage-Array. Ein Host-Verlust kostet ein Replikat; ein Array-Verlust kostet ein Replikat; das Quorum hält so oder so.
Bewährte Komponenten für jede Aufgabe:
- Transaktionale Daten auf Percona XtraDB Cluster, mit ProxySQL-Routing und einer Floating-Adresse.
- Analytics auf ClickHouse, dreifach repliziert mit dedizierten Keeper-Koordinationsknoten.
- Cache auf Valkey mit Sentinel-Failover.
- Streaming auf Redpanda, mit Replikationsfaktor drei.
- Edge auf HAProxy mit keepalived in einer gekreuzten VRRP-Anordnung, beide Adressen aktiv.
- Anwendungsebene zustandslos und horizontal skalierbar.
Auf OpenShift. Wir bauen OKD und OpenShift auf Bare Metal mit einer Control Plane aus drei Knoten auf unabhängigen Servern und Rook-Ceph als Shared Storage, sodass Web-Inhalte auf repliziertem Storage liegen statt auf einem einzelnen NFS-Server. Das Ceph-Monitor-Quorum ist so dimensioniert, dass zwei gleichzeitige Host-Ausfälle den Storage intakt lassen. Galera-Datenbanken laufen als StatefulSets mit Anti-Affinity über Chassis hinweg und einem PodDisruptionBudget, sodass Plattform-Updates und rollierende Reboots das Datenbank-Quorum nie brechen können. Load-Balancer-Adressen kommen von MetalLB auf echten VLANs.
Getestet, dann von jemand anderem verifiziert. Jede Ebene wird vor der Übergabe auf Failover getestet: Wir stoppen den Writer, den Cache-Primary, einen Edge, einen Host. Der Build wird anschließend von einer anderen Maschine aus verifiziert als der, die ihn gebaut hat, gegen die laufende Plattform statt gegen die Build-Notizen.
Wovor es Sie schützt
- Eine Plattform, in der eine Datenbank, ein Cache oder ein Analytics-Knoten ein Single Point of Failure ist.
- Ein Storage-Array oder ein Blade-Chassis, das die ganze Plattform mit sich nimmt.
- Rolling Updates von Kubernetes, die das Datenbank-Quorum brechen.
- VMs, die über NUMA-Grenzen dimensioniert sind und mehr kosten, aber langsamer laufen.
- Zum ersten Mal während eines echten Ausfalls zu erfahren, wie sich das Failover verhält.
In der Praxis
Eine Analytics-Plattform, für den Ausfall gebaut. Für das Analytics-Geschäft eines Kunden haben wir sechs Ebenen über getrennte Hosts und getrennte All-Flash-Arrays gebaut: ClickHouse mit dedizierten Keepern, Percona XtraDB Cluster mit ProxySQL und keepalived, Valkey mit Sentinel, Redpanda, einen HAProxy-Edge mit zwei Adressen und eine zustandslose Anwendungsebene. Bei der Übergabe haben wir gemessen: Der Edge schaltete in jede Richtung in etwa fünf Sekunden um, die Cache-Beförderung dauerte etwa sieben Sekunden, und den Verlust des Writers fing ProxySQL ab, während die Anwendung weiter schrieb.
OpenShift auf Bare Metal, bereit für die Produktion. Bevor eine OKD- oder OpenShift-Plattform Kunden-Workloads übernimmt, prüft eine Vorproduktionsabnahme das Storage-Quorum gegen zwei gleichzeitige Host-Ausfälle und richtet PodDisruptionBudgets für die Workloads jedes Tenants ein, bevor die erste Knotenwartung je geplant wird.
Warum EuroVPS
- Wir entwerfen Failure Domains über Hosts, Arrays und Chassis hinweg, nicht nur «alles doppelt».
- Jede Ebene wird auf Failover getestet, und die Zeiten werden Ihnen übergeben.
- Ein Team verantwortet Hardware, Storage, Netzwerk und Plattform.
- NUMA-bewusste Dimensionierung als Hausregel.
- PodDisruptionBudgets und Anti-Affinity sind auf Kubernetes vom ersten Build an unser Standard, nichts, das später ergänzt wird.
Häufige Fragen
- Virtuelle Maschinen oder OpenShift? Das hängt von Ihrem Team und Ihrer Anwendung ab. Klassische Stacks laufen hervorragend auf VMs; Teams, die bereits Container ausliefern, profitieren am meisten von OpenShift. Wir helfen Ihnen bei der Entscheidung.
- Können Sie nach unserer eigenen Referenzarchitektur bauen? Ja. Wir prüfen sie gegen unsere Failure-Domain-Regeln und schlagen Änderungen vor, wo ein einzelner Ausfall noch eine Ebene herunterreißen könnte.
- Wer betreibt die Plattform nach der Übergabe? Wir können alles betreiben, nur die Infrastruktur, oder sie mit Dokumentation und Support an Ihr Team übergeben.
- Wie lange dauert ein Build? Eine komplette mehrschichtige Plattform dauert in der Regel Wochen statt Tage, das meiste davon für Designentscheidungen und Tests.
- Testen Sie mit unserer Anwendung? Ja. Failover-Tests laufen mit angebundener Anwendung, damit die Ergebnisse dem entsprechen, was Ihre Nutzer sehen würden.
Bauen Sie etwas, das oben bleiben muss? Sprechen Sie mit einem Ingenieur.
Ihr nächster Infrastrukturpartner
Sehen wir uns Ihre Umgebung an.
Erzählen Sie uns, was Sie heute betreiben und was besser werden muss. Ein Ingenieur sieht Ihre Anfrage durch und hilft Ihnen, den nächsten Schritt zu planen.
+357 222 32280
Beginnen wir mit Ihrer Umgebung.
Ein wenig Kontext hilft uns, das richtige Gespräch zu beginnen.